

Raksts sastāv no divām daļām:
- Īss dažu arhitektūru apraksts tīklos, kas atklāj objektus attēlā un attēlu segmentācijā ar visiem saprotamākajiem resursu saišu piemēriem. Centos izvēlēties video skaidrojumus, vēlams krievu valodā.
- Otrā daļa ir centiens apzināt neironu tīklu arhitektūru attīstības virzienus. Un tehnoloģijas, kas balstītas uz tām.
Attēls 1 – Izprast neironu tīklu arhitektūras nav viegli
Viss sākās ar to, ka izveidoju divas demonstrācijas lietotnes attēlu klasifikācijai un objektu atklāšanai Android telefonā:
- , kad dati tiek apstrādāti serverī un pārsūtīti uz tālruni. Attēlu klasifikācija (image classification) trīs lāču veidiem: brūnais, melnais un mīkstais.
- , kad dati tiek apstrādāti pašā telefonā. Objektu atklāšana (object detection) trīs veidiem: lazdu rieksts, vīģes un dateles.
Ir atšķirība starp attēlu klasifikācijas uzdevumiem, objektu atklāšanu attēlā un . Tāpēc radās nepieciešamība uzzināt, kuras neironu tīklu arhitektūras atklāj objektus attēlos un kuras var veikt segmentāciju. Atradu šādas arhitektūras piemērus ar visiem saprotamākajiem resursu saišu piemēriem:
- R-CNN arhitektūru sērija (Regions with Convolution Neural Networks features): R-CNN, Fast R-CNN, , . Lai atklātu objektu attēlā, izmantojot Region Proposal Network (RPN) mehānismu, izdalās ierobežoti reģioni (bounding boxes). Sākotnēji RPN vietā tika izmantots lēnāks mehānisms Selective Search. Pēc tam izdalītie ierobežotie reģioni tiek iesniegti parastai neironu tīklam klasifikācijai. R-CNN arhitektūrā ir skaidri “for” cikli ierobežoto reģionu pārlūkošanai, kopumā līdz 2000 iterācijām caur iekšējo AlexNet tīklu. Skaitlis skaidri “for” ciklu palēnina attēlu apstrādes ātrumu. Skaitlis skaidri “for” ciklu, iterāciju pa iekšējo neironu tīklu, samazinās ar katru jauno arhitektūras versiju, un tiek veikti desmitiem citu izmaiņu ātruma palielināšanai un uzdevuma atklāšanai, lai nomainītu objektu atklāšanu uz to segmentāciju Mask R-CNN.
- (You Only Look OYOLO (You Only Look Once) – pirmā neironu tīkls, kas reāllaikā atpazina objektus mobilajās ierīcēs. Izšķirošā iezīme: objekti tiek diferencēti vienā pagriezienā (svarīgi tikai vienu reizi apskatīt). Tātad YOLO arhitektūrā nav skaidru "for" cilpu, kā rezultātā tīkls darbojas ātri. Piemēram, šāda analoģija: NumPy operācijās ar matricām arī nav skaidru "for" cilpu, kuras NumPy realizē zemākās arhitektūras līmeņos, izmantojot programmēšanas valodu C. YOLO izmanto iepriekš noteiktu logu režģi. Lai vienu un to pašu objektu noteiktu vairākkārt, tiek izmantots logu pārklājuma koeficients (IoU, Ikrustojums osavienojums). Šī arhitektūra darbojas plašā diapazonā un ir augsta Urobustuma Vienotais
- (SMultiBox Sdetektors) – tiek izmantoti visefektīvākie YOLO arhitektūras "haiki" (piemēram, non-maximum suppression) un pievieno jaunas, lai neironu tīkls strādātu ātrāk un precīzāk. Izšķirošā iezīme: objektu diferencēšana vienā pagriezienā, izmantojot iepriekš noteiktu logu režģi (default box) uz attēlu piramīdas. Attēlu piramīda ir kodēta konvolūcijas tenzoros, veicot secīgas konvolūcijas un puliģa operācijas (vai maksimālās pārvaldības procesā telpiskā dimensija samazinās). Tādā veidā var noteikt gan lielus, gan mazus objektus vienā tīkla pagriezienā. DMobileSSD (
- NetV2 +Mobilais) – divu neironu tīklu arhitektūru kombinācija. Pirmais tīkls SSDMobileNetV2 . Otrais tīkls SSD nosaka objektu atrašanās vietu attēlā. SqueezeNet
- DeepLab
- (Semantic Image Segmentation with Deep Convolutional Nets) – objektu segmentācija attēlā. Raksturīga architektūras iezīme ir izsviesta (dilated convolution) konvolūcija, kas saglabā telpisko izšķirtspēju. Pēc tam seko rezultātu pēcapstrādes posms, izmantojot grafisko varbūtības modeli (conditional random field), kas ļauj noņemt nelielus troksnīšus segmentācijā un uzlabot attēla kvalitāti. Zem draudīgā nosaukuma «grafiskais varbūtības modelis» slēpjas parasts Gausa filtrs, kas ir aptuveni aprēķināts piecās punktos.
- Centos saprast ierīci (Single-Shot Refinement Neural Network for Object Detection), bet maz ko sapratu.
- Tāpat arī skatījos, kā darbojas «uzmanības» (attention) tehnoloģija: , , . Raksturīga arhitektūras «uzmanība» iezīme ir automātiska paaugstinātās uzmanības reģionu izcelšana attēlā (RoI, Regions of Interest) ar neironu tīkla, kas saucas Attention Unit. Paaugstinātas uzmanības reģioni līdzīgi ierobežotiem reģioniem (bounding boxes), taču atšķirībā no tiem nav fiksēti attēlā un var būt miglaini. Pēc tam no paaugstinātas uzmanības reģioniem tika izcelti iezīmes (fichas), kuras «iegūst» atkārtojamiem neironu tīkliem ar arhitektūrām . Atkārtojamie neironu tīkli spēj analizēt attiecības iezīmēs secībā. Atkārtojamie neironu tīkli sākotnēji tika izmantoti tekstu tulkošanai citās valodās, bet tagad arī attēla tulkošanai un .
Pētot šīs arhitektūras es sapratu, ka neko nesaprotu. Un jautājums nav par to, ka manam neironu tīklam ir problēmas ar uzmanības mehānismu. Šo visu arhitektūru radīšana līdzinās kaut kādam milzīgam hackathon, kur autori sacenšas hackošanā. Hacks (hack) – ātrs risinājums grūtai programmatūras problēmai. Tas ir, starp visām šīm arhitektūrām nav redzamas un saprotamas loģiskas saiknes. Viss, kas tās vieno – ir visveiksmīgāko hacks kopums, ko tās aizņemas viena no otras, plus kopīga visām (atgriezeniskā izplatīšana, backpropagation). Nav ! Nav skaidrs, ko mainīt un kā optimizēt esošos sasniegumus.
Kā rezultāts loģiskās saiknes trūkumam starp hākiem, tos ir ārkārtīgi grūti atcerēties un pielietot praksē. Tas ir fragmentēts zināšanas. Labākajā gadījumā tiek iegaumēti daži interesanti un negaidīti momenti, bet lielākā daļa no saprastā un nesaprastā iznīkst atmiņā jau pēc dažām dienām. Būtu labi, ja pēc nedēļas atcerētos vismaz arhitektūras nosaukumu. Bet rakstu lasīšanai un apskatu video skatīšanai tika patērētas stundas un pat dienas darba laika!
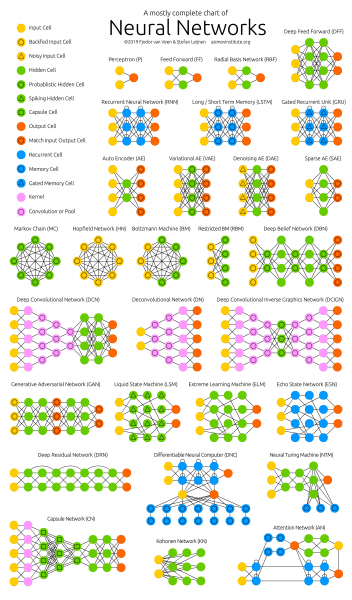
Attēls 2 –
Vairums zinātnisko rakstu autoru, manuprāt, dara visu iespējamo, lai pat šīs fragmentētās zināšanas netiktu saprastas no lasītāja. Bet darbības vārdu formas desmit rindās teikumos ar formulām, kas ņemtas ‘no griestiem’ – tas ir atsevišķas raksta tēma (problēma ).
Tāpēc radās nepieciešamība sistematizēt informāciju par neironu tīkliem un tādējādi uzlabot izpratnes un atcerēšanās kvalitāti. Tāpēc galvenā tēma atsevišķo tehnoloģiju un mākslīgo neironu tīklu arhitektūru izpētē ir kļuvusi šāda uzdevums: u zakot, kur tas viss virzās, nevis kāda konkrēta neironu tīkla uzbūve.
Kur viss tas virzās. Galvenie rezultāti:
- Sākuma skaits mašīnmācības uzņēmumos pēdējo divu gadu laikā . Iespējamā iemesls: ‘neironu tīkli vairs nav kas jauns’.
- Ikviens spēs izveidot funkcionējošu neironu tīklu vienkāršai uzdevuma risināšanai. Lai to izdarītu, viņš paņems gatavu modeli no ‘modeļu zooloģiskā dārza’ (model zoo) un apmācīs pēdējo neironu tīkla slāni () uz gataviem datiem no vai no bez maksas .
- Lieli neironu tīklu ražotāji sāka veidot ‘modeļu zooloģiskos dārzus’ (model zoo). Ar to palīdzību var ātri izveidot komerciālu lietojumprogrammu: TensorFlow, PyTorch, Caffe2, Chainer un .
- Neironu tīkli, kas darbojas reālā laikā (real-time) mobilajās ierīcēs. No 10 līdz 50 kadriem sekundē.
- Neironu tīklu pielietojums telefonos (TF Lite), pārlūkos (TF.js) un (IoT, Iinterneta of Tlietas). Īpaši telefonos, kuri jau atbalsta neironu tīklus uz ‘dzelzs’ līmeņa (neiroakseleratori).
- „Katram ierīcēm, apģērba priekšmetiem un iespējams pat pārtikai būs IP-v6 adrese un tās sazināsies savā starpā“ – .
- Arvien pieaug publicējumu skaits mašīnmācīšanās jomā, kas sāka (dubultojas reizi divos gados) no 2015. gada. Acīmredzot ir nepieciešamas neironu tīklos balstītas sistēmas rakstu analīzei.
- Populāras kļūst šādas tehnoloģijas:
- PyTorch – popularitāte strauji pieaug un, šķiet, apsteidz TensorFlow.
- Automātiska hiperpārparametru izvēle AutoML – popularitāte pieaug pakāpeniski.
- Pakāpeniska precizitātes samazināšanās un izpildes ātruma palielināšanās: , algoritmi , neprecīza (salīdzinoša) aprēķināšana, kvantizācija (kad neironu tīkla svars tiek pārveidots par veseliem skaitļiem un kvantizēts), neironu akseleratori.
- Tulkojums un .
- Izveide , tagad jau reālā laikā.
- Galvenais DL – ir daudz datu, bet tos savākt un anotēt nav viegli. Tāpēc attīstās automātiskā anotācija () neironu tīklu lietošanai, izmantojot neironu tīklus.
- Ar neironu tīkliem datorzinātne pēkšņi kļuvusi eksperiments zinātne un radās .
- IT nauda un neironu tīklu popularitāte radās vienlaikus, kad aprēķini kļuva par tirgus vērtību. Ekonomika no zeltu un valūtu kļūst zelta-vice-aprēķināšanas. Skatiet manu rakstu par un IT naudas rašanās iemeslu.
Pakāpeniski parādās jauna (Mašīnmācīšanās un dziļā mācīšanās), kas balstās uz programmas izpratni kā apmācītu neironu tīklu modeļu kopumu.
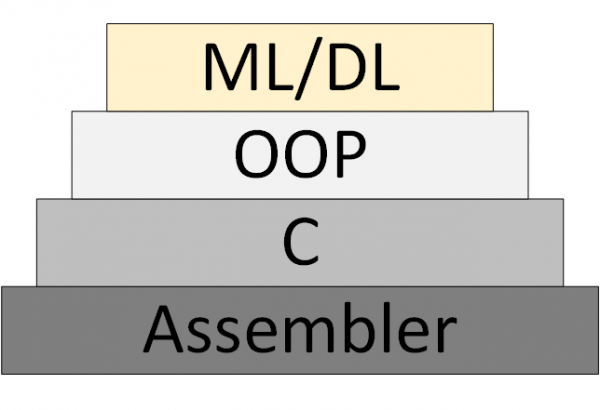
Attēls 3 – ML/DL kā jauna programmēšanas metodoloģija
Tomēr nav izveidojusies „neironu tīklu teorija”, kas ļautu domāt un strādāt sistemātiski. Tas, ko šobrīd sauc par „teoriju”, patiesībā ir eksperimentāli, heoristiski algoritmi.
Saites uz maniem un ne tikai resursiem:
- Jaunumu biļetens par Datu zinātni. Galvenokārt par attēlu apstrādi. Tie, kas vēlas saņemt, lūdzu, sūtiet e-pastu (foobar167<gaff-gaff>gmail<punktu>com). Saite uz rakstiem un video tiek nosūtītas, kad materiāls tiek uzkrāts.
- Vispārējs , kurus esmu izgājis un kurus vēlētos apgūt.
- , no kuriem būtu jāsāk mācīties par neironu tīkliem. Plus brošūra .
- , kur katrs atradīs kaut ko interesantu sev.
- Ekstremāli noderīgi ir bijuši video kanāli, kas analizē zinātniskos rakstus par Data Science. Atrodiet, abonējiet tos un dalieties ar saitēm ar saviem kolēģiem un ar mani arī. Piemēri:
- un ar soli pa solim instrukcijām un atvērtā koda projektiem.
Paldies par uzmanību!
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish