

Sveiki, Habr!
Atgādinām, ka esam izlaiduši kārtējo ārkārtīgi interesanto un noderīgo par Kubernetes paraugiem. Viss sākās ar "" Brendana Bernsa darbiem, un, lai gan mūsu darbs šajā jomā , šodien mēs piedāvājam jums izlasīt rakstu no MinIO emuāra, kas īsi izklāsta tendences un specifiku datu glabāšanas paraugiem Kubernetes vidē.
Kubernetes fundamentāli mainījis tradicionālos lietotņu izstrādes un izvietošanas paraugus. Tagad komandām var aiziet tikai dažas dienas, lai izstrādātu, pārbaudītu un izvietotu lietotni – dažādās vidēs, un viss tas Kubernetes klasteros. Šādas tehnoloģijas no iepriekšējām paaudzēm parasti prasīja nedēļas, ja ne mēnešus.
Šāds paātrinājums ir iespējams, pateicoties Kubernetes nodrošinātajai abstrahēšanai — tas ir, pateicoties tam, ka Kubernetes pats nodrošina mijiedarbību ar zemākām fizisko vai virtuālo mašīnu detaļām, ļaujot lietotājiem noteikt, starp citām iespējām, nepieciešamo procesoru, nepieciešamo atmiņas apjomu un konteineru skaitu. Tā kā Kubernetes atbalsta milzīga kopiena un tā pielietošanas apjoms nepārtraukti paplašinās, tas ievērojami apsteidz visus konteineru orķestrācijas platformas.
Palielinoties Kubernetes izmantošanai, pieaug arī neskaidrība par tajā izmantotajiem datu glabāšanas paraugiem..
Saskaroties ar vispārēju konkurenci par datu glabātuvi Kubernetes (tas ir, par datu glabāšanu), kad runa ir par datu glabāšanu, signāls šeit pazūd spēcīgā troksnī.
Kubernetes iemieso mūsdienu modeli lietotņu izstrādei un izvietošanai, kā arī to pārvaldībai. Šāds mūsdienu modelis atdala datu glabāšanu no aprēķiniem. Lai pilnībā saprastu šo atdalīšanu Kubernetes kontekstā, ir jāizprot, kas ir lietotnes, kas strādā ar stāvokli vai bez tā, un kā tas apvienojas ar datu glabāšanu. Tieši šeit REST API pieeja, ko izmanto S3, ir acīmredzamas priekšrocības salīdzinājumā ar POSIX/CSI pieeju, kas raksturīga citām risinājumiem.
Šajā rakstā mēs runāsim par datu uzglabāšanas modeļiem Kubernetes un atsevišķi apskatīsim strīdu par lietojumprogrammām, kas darbojas ar un bez stāvokļa saglabāšanas, lai saprastu, kāda ir atšķirība starp tām un kāpēc tā ir svarīga. Tālāk rakstā tiks apskatītas lietojumprogrammas un tajās izmantotie datu uzglabāšanas modeļi, ņemot vērā labākās prakses containers un Kubernetes darbā.
Ne-stāvokļa konteineri
Konteineri pēc būtības ir viegli un efemēri. Tos var viegli apturēt, dzēst vai izvietot citā mezglā – viss šis process aizņem vien dažas sekundes. Lielā konteineru orķestrācijas sistēmā šādas darbības notiek nepārtraukti, un lietotāji pat nepamana šīs izmaiņas. Tomēr pārvietošana ir iespējama tikai tad, ja konteineram nav nekādu atkarību no mezgla, uz kura tas atrodas. Par šādiem konteineriem saka, ka tie darbojas bez stāvokļa.
Stāvokļa konteineri
Ja konteiners glabā datus vietēji pieslēgtos ierīcēs (vai uz bloku ierīces), tad datu krātuve, kurā tas atrodas, būs jāpārvieto uz jaunu mezglu kopā ar pašu konteineru – kļūmes gadījumā. Tas ir svarīgi, jo pretējā gadījumā konteinerā palaižamā lietojumprogramma nespēs pareizi darboties, jo tai ir nepieciešams piekļūt datiem, kas glabāti vietējos nesējos. Par šādiem konteineriem saka, ka tie darbojas ar stāvokļa saglabāšanu.
Tehniskā ziņā stāvokļa konteinerus arī var pārvietot uz citiem mezgliem. Parasti to nodrošina ar izdalītām failu sistēmām vai tīkla blokā datu krātuves, kas ir pievienotas visiem mezgliem, uz kuriem strādā konteineri. Tādējādi konteineri iegūst piekļuvi tiltiem, lai persistēt datu uzglabāšanai, un informācija tiek glabāta diskos, kas atrodas visā tīklā. Šādu metodi es saukšu par “stāvokļa saglabāšanas konteineru pieeju”, un atlikušajā raksta daļā es to arī saukšu tādā veidā vienkāršības labad.
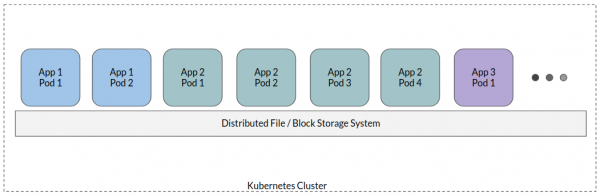
Tipiskajā konteineru pieejā ar stāvokļa saglabāšanu visi lietotņu podi tiek piesaistīti vienai izplatītajai failu sistēmai – sanāk sava veida kopīgi izmantota krātuve, kurā tiek uzkrāti visi lietotņu dati. Lai gan iespējamas dažas variācijas, tas ir augsta līmeņa pieejas raksturojums.
Tagad aplūkosim, kāpēc konteineru pieeja ar stāvokļa saglabāšanu mākoņorientētajā pasaulē ir antipatern.
Mākoņorientēta lietotņu projektēšana
Tradicionāli lietotnes izmantoja datubāzes strukturētai informācijas glabāšanai un lokālos diskus vai izplatītas failu sistēmas, uz kurām tika iemesti visi nestrukturētie vai pat daļēji strukturētie dati. Pieaugot nestrukturēto datu apjomiem, izstrādātāji saprata, ka POSIX ir pārāk "trokšņains", saistīts ar būtiskām izmaksām un beigu beigās traucē lietotnes darbību, pārejot uz patiešām lieliem mērogiem.
Tas galvenokārt veicināja jauna datu glabāšanas standarta rašanos, proti, mākoņorientētām krātuvēm, kas galvenokārt darbojas uz REST API bāzes un atbrīvo lietotni no apgrūtinošās lokālā datu glabāšanas uzturēšanas. Šādā gadījumā lietotne faktiski pāriet uz stāvokļa saglabāšanas izslēgšanu (jo stāvoklis atrodas attālā krātuvē). Mūsdienu lietotnes tiek veidotas no paša sākuma, ņemot vērā šo faktoru. Parasti katra mūsdienu lietotne, kas apstrādā kāda veida datus (logus, metadatus, blokus utt.) ir uzbūvēta saskaņā ar mākoņorientētu paradigmu, kur stāvoklis tiek pārvietots uz īpaši tam veltītu programmatūras sistēmu.
Konteineru pieeja ar stāvokļa saglabāšanu liek visai šai paradigmai atgriezties tieši tur, no kurienes tā sākās!
Izmantojot POSIX saskarnes datu glabāšanai, lietojumprogrammas darbojas tāpat kā tad, ja tās saglabātu stāvokli, un tādēļ novirzās no vissvarīgākajiem mākoņorientētā projektēšanas postulātiem, proti, no iespējas mainīt lietojumprogrammas darba plūsmu izmērus atkarībā no ienākošās slodzes, pārvietoties uz jaunu mezglu, tiklīdz aktuālais mezgls neizdodas, un tā tālāk.
Uz tām uzmanīgāk paskatoties, atklājam, ka, izvēloties datu glabātuvi, mēs atkal un atkal saskaramies ar dilemmu "POSIX pret REST API", BET ar papildu problēmu saasināšanu, ko izraisa POSIX distribuētās rakstura dēļ Kubernetes vidē. Proti,
- POSIX ir izteiksmīgs: POSIX semantika prasa asociēt ar katru operāciju metadatus un failu descriptorus, kas palīdz uzturēt operācijas stāvokli. Tas rada būtiskas izmaksas, kas nav nekādas reālas vērtības. Objekta glabāšanas API, īpaši S3 API, ir atbrīvojušies no šīm prasībām, ļaujot lietojumprogrammai izpildīt uzdevumu un pēc tam "aizmirst" par izsaukumu. Datu glabāšanas sistēmas atbilde norāda, vai šī darbība tika veikta veiksmīgi vai nē. Ja rodas kļūme, lietojumprogramma var veikt atkārtotu mēģinājumu.
- Tīkla ierobežojumi: Distribuētā sistēmā tiek pieņemts, ka var pastāvēt daudzas lietojumprogrammas, kas mēģina ierakstīt datus vienā un tajā pašā pievienotajā nesējā. Tādēļ, ka lietojumprogrammas sacenšas viena ar otru par joslas platumu (lai nosūtītu datus uz nesēju), pati datu glabāšanas sistēma sacenšas par šo joslas platumu, izplatot datus pa fiziskajiem diskiem. Sakarā ar POSIX izteiksmību, tīkla izsaukumu skaits pieaug vairākkārtīgi. No otras puses, S3 API nodrošina skaidru tīkla izsaukumu nošķiršanu starp izsaukumiem, kas nāk no klienta uz serveri, un tiem, kas notiek servera iekšienē.
- Drošība: POSIX drošības modelis ir izstrādāts, lai aktīvi iesaistītu cilvēku: administratoriem ir jākonfigurē konkrēti piekļuves līmeņi katram lietotājam vai grupai. Šādu paradigmu ir grūti pielāgot mākoņiem balstītai pasaulei. Mūsdienu lietojumprogrammas ir atkarīgas no drošības modeļiem, kas ir saistīti ar API, kur piekļuves tiesības tiek noteiktas kā politiku kopums, tiek piešķirtas pakalpojumu konti, pagaidu akreditācijas dati utt.
- Pārvaldāmība: Pārvaldītas konteineru ar saglabāšanu saistītas izmaksas ietver datu piekļuves saskaņošanas, datu konsekvences nodrošināšanu, kas prasa rūpīgi izvērtēt, kādi datu piekļuves modeļi tiks izmantoti. Ir jāuzstāda, jākontrolē un jākonfigurē papildu programmas, nerunājot par papildu pūlēm, kas nepieciešamas izstrādei.
Datu krātuves konteineru interfeiss
Datu konteineru krātuves interfeiss (CSI) lieliski palīdzējis izplatīt Kubernetes apjoma līmeni, daļēji nododot to trešo pušu datu krātuves piegādātājiem, bet arī nejauši veicinājis pārliecību, ka konteineru pieeja ar saglabāšanu ir ieteicams datu glabāšanas veids Kubernetes vidē.
CSI tika izstrādāts kā standarts, lai piedāvātu vienotas bloka un failu datu krātuves sistēmas mantojušiem lietojumiem Kubernetes vidē. Un, kā tika parādīts šajā rakstā, vienīgā situācija, kurā konteineru pieeja ar saglabāšanu (un CSI pašreizējā formā) ir jēgpilna, ir tad, kad pati lietojumprogramma ir mantojuša sistēma, kurai nav iespējams pievienot objektu datu krātuves API atbalstu.
Ir svarīgi saprast, ka, izmantojot CSI pašreizējā formā, proti, pieslēdzot apjomus, strādājot ar mūsdienu lietojumprogrammām, mēs saskarsimies ar līdzīgām problēmām kā tās, kas radās sistēmās, kur datu glabāšana bija organizēta POSIX stilā.
Kvalitatīvāks pieejas veids
Šajā gadījumā ir svarīgi saprast, ka lielākā daļa lietojumprogrammu būtībā nav paredzētas darbam ar stāvokļa saglabāšanu vai bez tās. Šāda uzvedība ir atkarīga no sistēmas kopējās arhitektūras un no konkrētajiem variantiem, kas izvēlēti projektēšanas laikā. Pārrunāsim nedaudz par lietojumprogrammām, kas saglabā stāvokli.
Principā visus lietojumprogrammu datus var iedalīt vairākos plašos tipos:
- Žurnālu dati
- Laika zīmju dati
- Transakciju dati
- Metadati
- Konteineru attēli
- Blobu dati (lieli bināri objekti)
Visi šie datu tipi ir ļoti labi atbalstīti mūsdienu datu uzglabāšanas platformās, un ir pieejamas vairākas mākoņorientētas platformas, kas pielāgotas datu piegādei katrā no šiem konkrētajiem formātiem. Piemēram, transakciju dati un metadati var atrasties mūsdienu mākoņorientētā datu bāzē, piemēram, CockroachDB, YugaByte utt. Konteineru attēli vai blobu dati var tikt uzglabāti docker reģistrā, kas balstīts uz MinIO. Laika zīmju dati var tikt uzglabāti laika rindas datu bāzē, piemēram, InfluxDB utt. Neiesim detaļās par katru datu tipu un attiecīgajām lietojumprogrammām, bet vispārējā ideja ir izvairīties no persistantā datu uzglabāšanas, kas balstīta uz lokālo disku montēšanu.
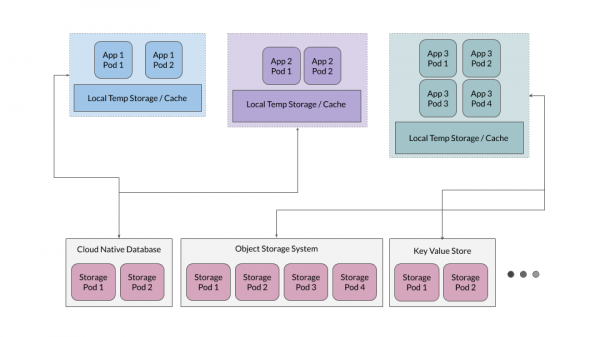
Turklāt bieži izrādās efektīvi nodrošināt pagaidu kešatmiņas līmeni, kas lietojumprogrammām kalpo kā izveidotu pagaidu failu krātuve, taču lietojumprogrammas nedrīkst paļauties uz šo līmeni kā uz patiesības avotu.
Krātuve lietojumprogrammām ar stāvokļa saglabāšanu
Lai gan lielākajā daļā gadījumu ir izdevīgi turēt lietojumprogrammas bez stāvokļa saglabāšanas, tās lietojumprogrammas, kas paredzētas datu uzglabāšanai – piemēram, datu bāzes, objektu krātuves, atslēgu un vērtību krātuves – ir jāuztur ar stāvokli. Apskatīsim, kāpēc šīs lietojumprogrammas tiek izvietotas Kubernetes. Kā piemēru ņemsim MinIO, bet līdzīgi principi ir piemērojami jebkurām citām lielām mākoņorientētām datu uzglabāšanas sistēmām.
Mākoņu orientētās lietojumprogrammas tiek projektētas ar mērķi maksimāli efektīvi izmantot konteineru elastību. Tas nozīmē, ka tajās netiek pieņemti nekādi pieņēmumi par vidi, kurā tās tiks izvērstas. Piemēram, MinIO izmanto iekšējo datu izdzīvošanas mehānismu (erasure coding), kas nodrošina pietiekamu sistēmas noturību, lai tā paliktu funkcionāla pat pusdisku bojājuma gadījumā. Arī MinIO pārvalda datu integritāti un drošību, izmantojot savu hashēšanu un šifrēšanu servera pusē.
Šādām mākoņu orientētām lietojumprogrammām kā rezerves krātuve visērtāk ir izmantot lokālos persistējošos apjomus (PV). Lokālais PV nodrošina iespēju uzglabāt neapstrādātus datus, kamēr lietojumprogrammas, kas darbojas virs šiem PV, pašas vāc informāciju, kas ļauj mērogot datus un pārvaldīt pieaugošās datu prasības.
Šis pieejas modelis ir daudz vienkāršāks un daudz labāk mērogojams salīdzinājumā ar CSI bāzes PV, kuri sistēmā ievieš savus datu pārvaldības un redundances līmeņus; problēma ir tāda, ka šie līmeņi parasti konfliktē ar lietojumprogrammām, kas projektētas, pamatojoties uz stāvokļa saglabāšanu.
Paātrināta pāreja uz datu atdalīšanu no aprēķiniem
Šajā rakstā mēs runājām par to, kā lietojumprogrammas pārorientējas darbam bez stāvokļa saglabāšanas, tas ir, datu uzglabāšana tiek atdalīta no aprēķiniem, ko veic virs tiem. Noslēgumā aplūkosim dažus reālus šāda trenda piemērus.
, slavenā datu analīzes platforma, tradicionāli tika izmantota ar stāvokļa saglabāšanu un izvēršot to HDFS failu sistēmā. Tomēr, pārejot uz mākoņu orientēto pasauli, šī platforma arvien vairāk tiek izmantota bez stāvokļa saglabāšanas, izmantojot `s3a`. Spark izmanto s3a, lai pārsūtītu stāvokli uz citām sistēmām, kamēr paši Spark konteineri darbojas pilnībā bez stāvokļa saglabāšanas. Citi lielie uzņēmumi, kas darbojas liela apjoma datu analītikas jomā, proti, , , , arī pāriet uz darbību ar datu uzglabāšanas un aprēķinu atdalīšanu.
Līdzīgi modeļi ir novērojami arī citās lielās analītiskajās platformās, piemēram, Presto, Tensorflow uz R, Jupyter. Izgūstot datus attālinātajās mākoņglabāšanas sistēmās, jūsu lietojumprogrammas pārvaldība un mērogošana kļūst daudz vieglāka. Turklāt tas veicina lietojumprogrammas portabilitāti dažādās vidēs.
Avots: habr.com
