

Šis ieraksts būs interesants tiem, kas izmanto datu apstrādes bibliotēku R — data.table, un, iespējams, būs priecīgi redzēt tās izmantošanas elastību dažādos piemēros.
Iedvesmojoties no laba piemēra , un cerot, ka jūs jau esat izlasījis viņa rakstu, piedāvāju dziļāk izpētīt koda optimizāciju un veiktspēju, pamatojoties uz data.table.
Ievads: no kurienes nāk data.table?
Vislabāk ir sākt iepazīstināšanu ar bibliotēku nedaudz attālināti, proti, ar datu struktūrām, no kurām var iegūt data.table objektu (turpmāk — DT).
Masīvs
Kods
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Viens no šādām struktūrām ir masīvs (?base::array). Tāpat kā citās valodās, masīvi šeit ir daudzdimensionāli. Tomēr interesanti, ka, piemēram, divdimensiju masīvs sāk manto īpašības no matricas klases (?base::matrix), bet viendimensionālais masīvs, kas arī ir svarīgi, nemanto no vektora (?base::vector).
Jāņem vērā, ka datu tips, kas saturas kādā objektā, ir jāpārbauda ar funkciju base::typeof, kas atgriež iekšējo datu veida aprakstu saskaņā ar R Internals — kopējo valodas protokolu, kas saistīts ar primāro C.
Vēl viena komanda, lai noteiktu objekta klasi, base::class, atgriež gadījumā, ja runa ir par vektoriem, vektora tipu (tas atšķiras ar nosaukumu no iekšējā, taču arī ļauj saprast datu veidu).
Saraksts
No divdimensionāla masīva, tas ir, matricas, var pāriet uz sarakstu (?base::list).
Kods
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Šajā procesā notiek vairākas lietas uzreiz:
- Otrā dimensija matricas tiek nospiesta, proti, mēs iegūstam gan sarakstu, gan vektoru.
- Saraksts, tādējādi, manto no šīm klasēm. Jāņem vērā, ka saraksta elementam atbilst viena (skalāra) vērtība no matricas-masīva šūnas.
Ņemot vērā, ka saraksts ir arī vektors, uz to var piemērot dažas funkcijas, kas attiecas uz vektoriem.
Datu rāmis
No saraksta, matricas vai vektora var pāriet uz datu rāmi (?base::data.frame).
Kods
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Interesanti, ka datu rāmis manto no saraksta! Datu rāmja kolonnas ir saraksta šūnas. Tas būs svarīgi turpmāk, kad mēs izmantosim funkcijas, kas attiecas uz sarakstiem.
data.table
DT (?data.table::data.table) var iegūt no datu rāmja, saraksta, vektora vai matricas. Piemēram, tā (in place).
Kods
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Noderīgi ir tas, ka, tāpat kā datu rāmis, DT manto saraksta īpašības.
DT un atmiņa
Atšķirībā no visiem citiem objektiem R bāzē, data.table tiek nodoti pa atsaucēm. Ja nepieciešams izveidot kopiju jaunā atmiņas apgabalā, nepieciešama funkcija data.table::copy vai jāveic atlase no vecā objekta.
Kods
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Šeit ievads tuvojas beigām. data.table ir datora datu struktūru attīstības turpinājums R, kas galvenokārt notiek, paplašinot un paātrinot operācijas, ko veic uz datu rāmju objektiem. Tajā pašā laikā saglabājas mantojums no citiem primitīvām.
Daži data.table īpašību izmantošanas piemēri
Kā saraksts…
Iterēt pa datu rāmjiem vai data.table nav labākais risinājums, jo cikla kods R ir krietni lēnāks C, bet iet ciklā pa kolonām, kuru, parasti, ir daudz mazāk, ir iespējams. Iejot kolonās, atceramies, ka katra kolonna ir saraksta elements, kas parasti satur vektoru. Un operācijas uz vektoriem ir labi vektorizētas pamata valodas funkcijās. Tāpat var izmantot atlases operatorus, kas raksturīgi sarakstiem un vektoriem: `[[`, `$`.
Kods
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektorizācija
Ja nepieciešams iterēt pa lielām data.table rindām, labākais risinājums būs funkcijas uzrakstīšana ar vektorizāciju. Bet, ja tas nesanāk, tad jāatceras, ka cikls iekšpusē data.table tomēr ir ātrāks par ciklu R, jo tiek izpildīts uz C.
Mēģināsim uz lielākā piemēra ar 100K rindām. Izvilksim pirmo burtu no vārdiem, kas ir vektora kolonnā. w.
Atjaunināts
Kods
library(magrittr)
library(microbenchmark)

## Lielāks piemērs ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorizācija

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# otrais

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# trešais

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Pirmais skrējiens, iterējot pa rindām:
Vienības: milisekundes
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Otra pasūtījums, kur vektorizācija notiek, pārveidojot sarakstu matricas formā un ņemot elementus pa indeksu 1 (tas ir pati vektorizācija). Labojums: vektorizācija funkciju līmenī. strsplit, kas spēj pieņemt vektoru ievadā. Izrādās, saraksta pārveidošana matricas formā ir daudz grūtāka par pašu vektorizāciju, taču šajā gadījumā tas ir daudz ātrāk nekā nevectors variants.
Vienības: milisekundes
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Paātrinājums pēc mediānas ir 3 reizes.
Trešais uzdevums, kurā ir mainīta matricas pārveidošanas shēma.
Vienības: milisekundes
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Paātrinājums pēc mediānas ir 13 reizes.
Ar šo vajag eksperimentēt, jo vairāk — jo labāk būs.
Vēl viens piemērs ar vektorizāciju, kur arī ir teksts, bet tas ir tuvāk reāliem apstākļiem: atšķirīgs vārdu garums, atšķirīgs vārdu skaits. Nepieciešams izvilkt pirmos 3 vārdus. Šādi:
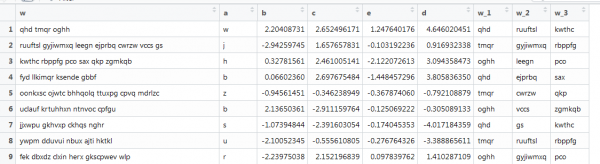
Šeit iepriekšējā funkcija vairs nedarbojas, jo vektori ir atšķirīga garuma, bet mēs esam noteikuši matricas izmēru. Pārveidosim to, padziļinoties internetā.
Kods
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Vienības: milisekundes
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Skripts ir darbojies ar vidējo ātrumu 1 sekunde. Nav slikti.
Saistīti ar vienu ķēdi…
Ar DT objektiem var strādāt, izmantojot chaining. Tas izskatās kā kreisās sintakses piedāvāšana, būtībā, tas ir saldāks.
Kods
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Tek caur caurulēm…
Tādas pašas darbības var veikt caur piping, izskatās līdzīgi, bet funkcionāli bagātāk, jo var izmantot jebkādas metodes, ne tikai DT. Izdosim loģistiskās regresijas koeficientus mūsu sintētiskajiem datiem ar virkni filtriem uz DT.
Kods
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistika, mašīnmācīšanās un citi aspekti iekš DT
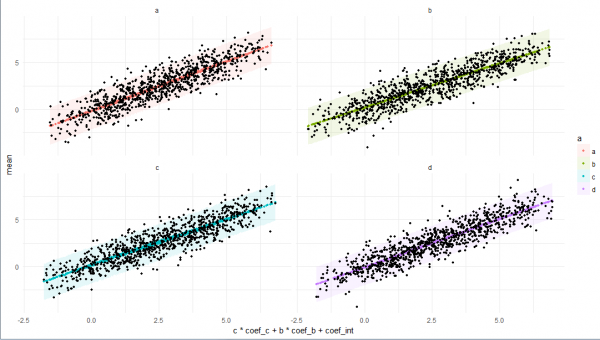
Var izmantot lambda funkcijas, bet dažreiz labāk ir tās izveidot atsevišķi, aprakstīt visu datu analīzes cauruļvadu, un uz priekšu — tās darbojas iekš DT. Piemērs ir papildināts ar visām iepriekš minētajām funkcijām, pievienojot dažas noderīgas lietas no DT arsenāla (piemēram, piekļuvi pašam DT iekšā DT caur atsauci, kas dažreiz nav secīgi ievietota, bet lai būtu).
Kods
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Secinājums
Ceru, ka man izdevās izveidot vispārīgu, taču, protams, nepilnīgu, skatu uz tādu objektu kā data.table, sākot no tā īpašībām, kas saistītas ar mantojumu no R klasēm, un beidzot ar tā paša iezīmēm un vidē no tidyverse elementiem. Ceru, ka tas jums palīdzēs labāk izprast un izmantot šo bibliotēku darbā un izklaidei.
Paldies!
Pilns kods
Kods
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish