

Daudzi saskaras ar Elasticsearch. Bet kas notiek, kad vēlies to izmantot, lai glabātu žurnālus "īpaši lielos apjomos"? Un kā nesāpīgi izturēt jebkura datu centra atteikšanu? Kāda arhitektūra būtu jāveido un kādi slēpti riski tevi sagaida?
Mēs, Odnoklassniki, nolēmām, izmantojot Elasticsearch, atrisināt žurnālu pārvaldības jautājumu un tagad dalāmies ar savu pieredzi Habrā: gan par arhitektūru, gan par slēptiem riskiem.
Es esmu Pēteris Zaitsevs, strādāju par sistēmu administratoru Odnoklassniki. Iepriekš arī biju admins, strādāju ar Manticore Search, Sphinx Search, Elasticsearch. Iespējams, ja parādīsies vēl kāds ...search, es, visticamāk, strādāšu arī ar to. Tāpat esmu iesaistījies vairākos atvērtā koda projektos uz brīvprātības pamata.
Kad ierados Odnoklassniki, es nedomājot teicu intervijā, ka protu strādāt ar Elasticsearch. Pēc tam, kad iepazinos un nedaudz pabeidzu dažus vienkāršus uzdevumus, man tika uzticēts liels uzdevums saistībā ar esošās žurnālu pārvaldības sistēmas reformēšanu.
Prasības
Sistēmas prasības tika formulētas šādi:
- Kā front-end risinājumu bija jāizmanto Graylog. Jo uzņēmumā jau bija pieredze ar šo produktu, programmētāji un testētāji to pazina, un tas viņiem bija ērti un saprotami.
- Datu apjoms: vidēji 50-80 tūkstoši ziņu sekundē, bet, ja kaut kas sabojājas, tad trafiks nav ierobežots, tas var būt 2-3 miljoni rindiņu sekundē.
- Pārrunājot ar pasūtītājiem prasības attiecībā uz meklēšanas pieprasījumu apstrādes ātrumu, mēs sapratām, ka tipiska šādas sistēmas izmantošanas shēma ir tāda: cilvēki meklē savas lietojumprogrammu žurnālus pēdējām divām dienām un nevēlas gaidīt atbildi uz izteikto pieprasījumu ilgāk par vienu sekundi.
- Administratori uzstāja, lai sistēma, ja nepieciešams, viegli paplašinātos, neprasot no viņiem dziļus izpratnes līmeņus par tās darbību.
- Lai vienīgā apkalpošanas uzdevums, kas šīm sistēmām periodiski bija nepieciešams, bija mainīt kādu aparatūru.
- Turklāt Odnoklassniki ir lieliska tehniskā tradīcija: jebkuram pakalpojumam, ko mēs uzsākam, jāspēj izturēt datu centra atteikšanu (neparedzēta, neplānota un absolūti jebkurā laikā).
Pēdējais prasība šī projekta īstenošanā mums izrādījās visgrūtākā, par ko es vēl runāšu sīkāk.
Vide
Mēs strādājam četros datu centros, un Elasticsearch datu mezgli var atrasties tikai trijos (vairāku netehnisku iemeslu dēļ).
Šajos četros datu centros atrodas aptuveni 18 tūkstoši dažādu žurnālu avotu — aparatūra, konteineri, virtuālas mašīnas.
Svarīga iezīme: klastera palaišana notiek konteineros nevis uz fiziskām mašīnām, bet uz . Konteineriem tiek garantēti 2 kodoli, kas atbilst 2.0Ghz v4 ar iespēju izmantot pārējos kodolus, ja tie ir dīkstāvē.
Citiem vārdiem sakot:
Topoloģija
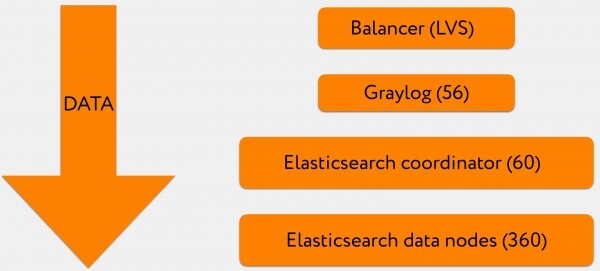
Vispārējais risinājuma izskats man sākotnēji šķita šāds:
- 3-4 VIP atrodas aiz Graylog domēna A-rekorda, tas ir adrese, uz kuru tiek nosūtīti žurnāli.
- katrs VIP ir LVS līdzsvarotājs.
- Pēc tam žurnāli nonāk Graylog baterijā, daļa datu tiek nosūtīta GELF formātā, daļa - syslog formātā.
- Tālāk viss tiek lielos partiju rakstīts koordinātoru Elasticsearch baterijā.
- Un tie, savukārt, nosūta ieraksta un lasīšanas pieprasījumus attiecīgajiem datu mezgliem.
Terminoloģija
Iespējams, ka ne visi detalizēti pārzina terminoloģiju, tāpēc vēlētos nedaudz apstāties pie tās.
Elasticsearch ir vairāki mezglu veidi — master, coordinator, data node. Ir arī divi citi veidi dažādiem žurnālu pārvēršanai un dažādu klasteru savienošanai, bet mēs izmantojām tikai uzskaitītos.
Master
Ping visus klasterī esošos mezglus, uztur aktuālu klastera karti un izplata to starp mezgliem, apstrādā notikumu loģiku, nodarbojas ar dažāda veida klastera mājasdarbiem.
Coordinator
Veic vienu vienīgu uzdevumu: pieņem pieprasījumus no klientiem lasīšanai vai rakstīšanai un maršrutē šo trafiku. Ja pieprasījums ir par rakstīšanu, visticamāk, ka tas vaicās master, kurā shard attiecīgā indeksa to novietot, un pāradresēs pieprasījumu tālāk.
Data node
Glabā datus, veic no ārienes ienākošos meklēšanas pieprasījumus un operācijas ar tajā novietotajiem shardiem.
Graylog
Tas ir kaut kas līdzīgs Kibana un Logstash saplūšanai ELK kaudzē. Graylog apvieno gan lietotāja saskarni, gan žurnālu apstrādes kanālu. Zem Graylog ir Kafka un Zookeeper, kas nodrošina Graylog sasaisti kā klusteru. Graylog var kešatmiņā saglabāt žurnālus (Kafka), ja Elasticsearch nav pieejams, un atkārtot neveiksmīgos lasīšanas un rakstīšanas pieprasījumus, grupēt un marķēt žurnālus saskaņā ar noteiktiem noteikumiem. Tāpat kā Logstash, Graylog ir funkcionalitāte, lai modificētu virknes pirms to ierakstīšanas Elasticsearch.
Turklāt Graylog ir iebūvēts pakalpojumu atklāšanas rīks, kas ļauj, pamatojoties uz vienu pieejamu Elasticsearch mezglu, iegūt visu klusteru karti un filtrēt to pēc noteikta taga, kas dod iespēju novirzīt pieprasījumus uz konkrētiem konteineriem.
Vizualizācija izskatās aptuveni tā:

Šī ir ekrānšāviņš no konkrēta instancē. Šeit mēs veidojam histogrammu pēc meklēšanas pieprasījuma, parādot attiecīgās virknes.
Indeksi
Atgriežoties pie sistēmas arhitektūras, es vēlētos detalizētāk apskatīt, kā mēs veidojām indeksu modeli, lai viss darbotos pareizi.
Iepriekš minētajā shēmā tas ir viszemākais līmenis: Elasticsearch datu mezgli.
Indeks ir liela virtuāla būtne, kas sastāv no Elasticsearch shardiem. Katrs shard pats par sevi ir nekas cits kā Lucene indekss. Un katrs Lucene indekss, savukārt, sastāv no viena vai vairākiem segmentiem.
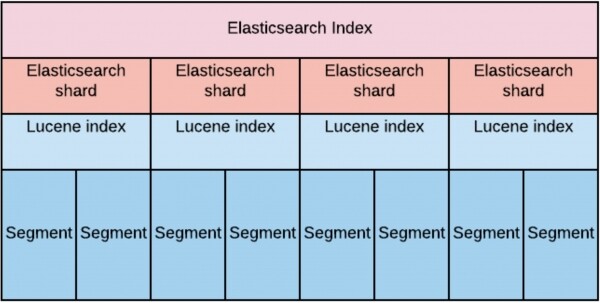
Projektēšanas procesā mēs lēsa, ka, lai nodrošinātu prasību pēc ātras lasīšanas lielos datu apjomos, mums ir nepieciešams vienmērīgi "izplaisīt" šos datus pa datu mezgliem.
Tas noveda pie tā, ka shardu skaitam uz indeksu (kopā ar replikām) mums jābūt stingri vienādam ar datu mezglu skaitu. Pirmkārt, lai nodrošinātu replikācijas faktoru divi (proti, mēs varam zaudēt pusi klusteru). Otrkārt, lai lasīšanas un rakstīšanas pieprasījumus apstrādātu vismaz uz pusi klusteru.
Mēs noteicām glabāšanas laiku vispirms kā 30 dienas.
Shardu sadalījumu var attēlot grafiski šādi:
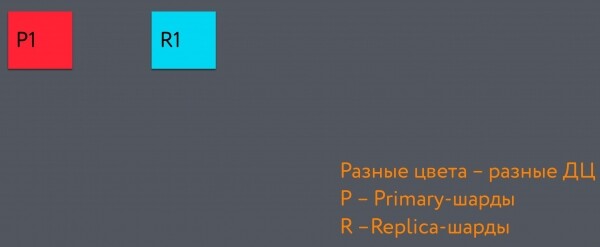
Visi tumši pelēkie taisnstūri kopumā veido indeksu. Kreisais sarkanais kvadrāts tajā ir primārais shard, pirmais indeksā. Savukārt gaiši zils kvadrāts ir replikas shard. Tie atrodas dažādās datu centrā.
Kad pievienojam vēl vienu shard, tas nonāk trešajā datu centrā. Un, galu galā, mēs iegūstam šādu struktūru, kas nodrošina datu konsekvences saglabāšanu, pat zaudējot datu centru:
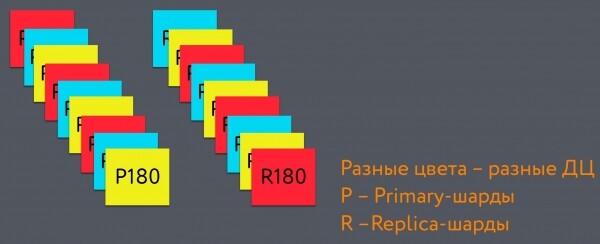
Indeksu rotācija, t.i., jaunā indeksa izveide un vecākā dzēšana, ir noteikta uz 48 stundām (saskaņā ar indeksu izmantošanas raksturu: pēdējās 48 stundas tiek meklētas visbiežāk).
Šāds indeksu rotācijas intervāls ir saistīts ar šādiem iemesliem:
Kad konkrētā datu noda saņem meklēšanas vaicājumu, no veiktspējas viedokļa ir izdevīgāk, ja tiek aptaujāts viens shard, ja tā lielums ir salīdzināms ar noda heap lielumu. Tas ļauj saglabāt 'karsto' indeksa daļu heap'ā un ātri pie tās piekļūt. Kad 'karsto daļu' ir daudz, indeksa meklēšanas ātrums samazinās.
Kad noda sāk veikt meklēšanas vaicājumu vienā shard, tā piešķir pavedienu (thread) skaitu, kas ir vienāds ar fiziskās mašīnas hipertirdzniecības kodolu skaitu. Ja meklēšanas vaicājums attiecas uz lielu skaitu shard, tad pavedienu skaits pieaug proporcionāli. Tas nelabvēlīgi ietekmē meklēšanas ātrumu un negatīvi ietekmē jauno datu indeksāciju.
Lai nodrošinātu nepieciešamo meklēšanas latentumu, mēs nolēmām izmantot SSD. Mašīnām, uz kurām tika izvietoti šie konteineri, bija jābūt vismaz 56 kodoliem, lai ātri apstrādātu vaicājumus. Cifrē, kas ir 56, ir izvēlēta kā nosacīti pietiekama vērtība, kas nosaka pavedienu skaitu, ko procesā radīs Elasticsearch. Elasticsearch daudzi thread pool parametri tieši atkarīgi no pieejamo kodolu skaita, kas savukārt tieši ietekmē nepieciešamo nodu skaitu klasterī pēc principa 'mazāk kodolu — vairāk nodu'.
Rezultātā mēs ieguvām, ka vidēji shard sver apmēram 20 gigabaitu, un uz 1 indeksu attiecas 360 shard. Tādējādi, ja mēs tos rotējam reizi 48 stundās, tad mums ir 15 no tiem. Katrs indekss satur datus par 2 dienām.
Datu ieraksta un lasīšanas shēmas
Paskatīsimies, kā šajā sistēmā tiek ierakstīti dati.
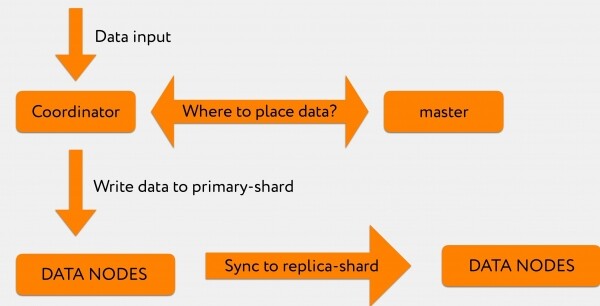
Pieņemsim, ka no Graylog saņemam kādu vaicājumu uz koordinatoru. Piemēram, mēs vēlamies indeksēt 2-3 tūkstošus rindu.
Koordinators, saņemot pieprasījumu no Graylog, uzdot meistram: «Mūsu indeksācijas pieprasījumā konkrēti tika norādīts indekss, bet kurā shard to rakstīt — nav norādīts».
Meistars atbild: «Pieraksti šo informāciju shard numur 71», pēc tam tā tiek nosūtīta uz attiecīgo datu mezglu, kur atrodas primārais shard numur 71.
Pēc tam darījumu žurnāls tiek replikēts uz replikas shard, kas atrodas jau citā datu centrā.
No Graylog uz koordinātoru pienāk meklēšanas pieprasījums. Koordinators to pārvirza pa indeksu, un Elasticsearch pēc round-robin principa sadala pieprasījumus starp primāro shard un replikas shard.
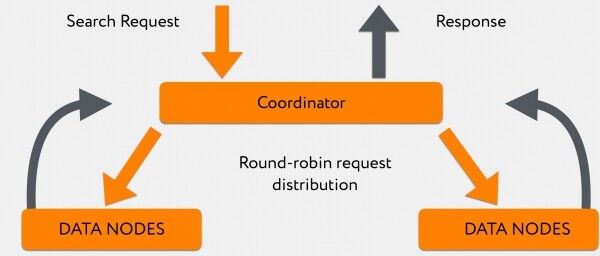
Mezgli, kuru ir 180, atbild neviendabīgi, un, kamēr tie atbild, koordinators uzkrāj informāciju, ko no tā jau «izspļāvušas» ātrākas datu mezgls. Pēc tam, kad vai nu visa informācija ir saņemta, vai ir sasniegts pieprasījuma laika limits, viss tiek nodots tieši klientam.
Visa šī sistēma vidēji apstrādā meklēšanas pieprasījumus par pēdējām 48 stundām 300-400ms laikā, izņemot tos pieprasījumus, kuriem ir leading wildcard.
«Ziedi» ar Elasticsearch: Java konfigurācija
Lai viss darbotu tā, kā mēs sākotnēji vēlējāmies, mēs ļoti ilgi izstrādājām dažādas lietas klasterī.
Pirmajā daļā atrasto problēmu cēlonis saistīts ar to, kā Elasticsearch pēc noklusējuma ir iepriekš konfigurēta Java.
Problēma pirmā
Mēs novērojām ļoti lielu skaitu ziņojumu par to, ka līmenī Lucene, kad ir palaikti background job’i, Lucene segmentu sapludināšana beidzas ar kļūdu. Tajā pašā laikā žurnālos bija redzams, ka tas ir OutOfMemoryError. Mēs pa telemetrijai redzējām, ka hipe ir brīvs, un nebija skaidrs, kāpēc šī operācija krīt.
Noskaidrojās, ka Lucene indeksu sapludināšanas notiek ārpus hipe. Un konteineri ir diezgan stingri ierobežoti patērēto resursu ziņā. Šajos resursos iekļāvās tikai hipa (vērtība heap.size bija aptuveni vienāda ar RAM), bet kādas off-heap operācijas krīt ar atmiņas piešķiršanas kļūdu, ja kādu iemeslu dēļ neizdevās iekļauties tajos ~500MB, kas palika līdz limita.
Risinājums bija diezgan vienkāršs: palielināja pieejamo RAM apjomu konteineram, pēc tam aizmirsām, ka tādas problēmas mums vispār bija.
Problēma otrā
Pēc apmēram 4-5 dienām pēc klastera palaišanas mēs pamanījām, ka datu mezgli sāk periodiski izkrist no klastera un piekļūst tam pēc 10-20 sekundēm.
Kad nolēmām analizēt, izrādījās, ka šī off-heap atmiņa Elasticsearch praktiski nav kontrolējama. Kad mēs konteineram piešķīrām vairāk atmiņas, mēs guvām iespēju piepildīt tiešos buferu baseinus ar dažādu informāciju, un tā tika iztīrīta tikai pēc tam, kad tika veikts explicit GC no Elasticsearch puses.
Vairākos gadījumos šī operācija norisinājās diezgan ilgi, un šā laikā klasters paspēja atzīmēt šo mezglu kā izslēgtu. Šī problēma ir labi aprakstīta. .
Risinājums bija šāds: mēs ierobežojām Java iespējas izmantot lielāko daļu atmiņas ārpus hipa šīm operācijām. Mēs ierobežojām to līdz 16 gigabaitiem (-XX:MaxDirectMemorySize=16g), panākot to, ka explicit GC tika izsaukti ievērojami biežāk un darbojās ievērojami ātrāk, tādējādi pārtraucot stabilizēt klasteri.
Trešā problēma.
Ja domājat, ka problēmas ar „mezgliem, kuri negaidīti pamet klasteri” šeit beidzas, jūs maldāties.
Konfigurējot darbu ar indeksiem, mēs izvēlējāmies mmapfs, lai pār svaigiem shardiem ar lielu segmentāciju. Tā bija diezgan rupja kļūda, jo, izmantojot mmapfs, fails ir mapēts operatīvajā atmiņā, un tālāk mēs strādājam jau ar mapped-failu. Tā rezultātā, mēģinot GC apstādināt pavedienus lietojumprogrammā, mēs ilgi nonākam safepoint, un ceļā uz to lietojumprogramma pārstāj atbildēt uz meistara pieprasījumiem par to, vai tā ir dzīvā. Attiecīgi, meistars uzskata, ka mezgls mūsu klasterī vairs nepastāv. Pēc tam, apmēram 5-10 sekunžu laikā, darbojas garbage collector, mezgls atdzīvojas, atkal pievienojas klasterim un uzsāk shardu inicializāciju. Viss tas stipri atgādināja “produkciju, kuru mēs izpelnījām” un nebija piemērots nekam nopietnam.
Lai atbrīvotos no šāda uzvedības modeļa, mēs vispirms pārgājām uz standarta niofs, bet pēc tam, kad ar piektajām versijām Elastic pārgājām uz sestajām, izmēģinājām hybridfs, kur šī problēma neizpaudās. Sīkāk par krātuves veidiem var izlasīt. .
Ceturtā problēma.
Pēdējā bija vēl ļoti interesanta problēma, kuru mēs risinājām rekordlīdzīgi ilgi. Mēs to novērojām 2-3 mēnešus, jo pilnīgi neskaidri bija tās paraugs.
Reizēm mūsu koordinatori nonāca Full GC, parasti ap pusdienlaiku, un vairs neatgriezās. Tajā pašā laikā, reģistrējot GC aizkaves, tas izskatījās šādi: viss labi, labi, labi, un tad pēkšņi – viss strauji pasliktinājās.
Sākumā mēs domājām, ka mums ir ļauns lietotājs, kurš nosūta kādu pieprasījumu, kas izsist koordinatoru no darba režīma. Ilgi reģistrējām pieprasījumus, cenšoties noskaidrot, kas notiek.
Galu galā noskaidrojās, ka tajā brīdī, kad kāds lietotājs nosūta ļoti lielu pieprasījumu, un tas nonāk pie konkrēta Elasticsearch koordinatora, dažas noder atbild ar lielāku kavēšanos nekā citas.
Un tas laiks, kamēr koordinatora gaida atbildes no visām nodošajām nodym, viņš uzkrāj sev rezultātus, kas nosūtīti no jau atbildējušām nodym. GC šajā gadījumā nozīmē, ka mūsu hipa izmantošanas modelis ātri mainās. Un tas GC, ko mēs lietojām, ar šo uzdevumu netika galā.
Vienīgais risinājums, ko mēs atradām, lai mainītu klastera uzvedību šādā situācijā – pāreja uz JDK13 un Shenandoah atkritumu savācēja izmantošana. Tas novērsa problēmu, koordinatoriem vairs nebija kritienu.
Ar šo problēmas ar Java beidzās un sākās problēmas ar caurlaidspēju.
«Ogas» ar Elasticsearch: caurlaidspēja
Problēmas ar caurlaidspēju nozīmē, ka mūsu klasters strādā stabilā režīmā, bet indeksējamo dokumentu skaita pieaugumu un manevru brīžos veiktspēja ir nepietiekama.
Pirmais novērojamais simptoms: pie kādām «sprādzieniem» produktīvajā vidē, kad strauji ģenerējas ļoti liels žurnālu daudzums, Graylogā bieži parādās kļūda indeksācijā es_rejected_execution.
Tas notika tāpēc, ka thread_pool.write.queue vienā datu nodē pirms tam, kad Elasticsearch spēj apstrādāt pieprasījumu par indeksēšanu un nodot informāciju shard diskā, pēc noklusējuma var kešot tikai 200 pieprasījumus. Un par šo parametru tiek teikts ļoti maz. Tiek norādīts tikai maksimālais pavedienu skaits un noklusējuma izmērs.
Protams, mēs devāmies regulēt šo vērtību un noskaidrojām sekojošo: konkrēti mūsu uzstādījumā līdz 300 pieprasījumiem kešojas diezgan labi, bet lielāka vērtība ir bīstama, jo mēs atkal nonākam Full GC.
Turklāt, ņemot vērā, ka tās ir ziņu pakas, kas tiek nosūtītas viena pieprasījuma ietvaros, bija jāuzlabo arī Graylog, lai tas nerakstītu bieži un mazās partijās, bet gan lielās partijās vai ik pēc 3 sekundēm, ja partija vēl nav pilna. Šādā gadījumā iegūstam, ka informācija, ko rakstām Elasticsearch, kļūst pieejama ne divu, bet piecu sekunžu laikā (kas mūs pilnībā apmierina), taču samazinās atkārtojumu skaits, kas jāveic, lai nospiestu lielu informācijas partiju.
Tas īpaši ir svarīgi brīžos, kad kaut kas ir izgāzies un par to intensīvi ziņo, lai neiegūtu pilnībā pārspamojušu Elastic, un pēc kāda laika – nedarbīgus Graylog mezglus, jo ir aizsprostoti buferi.
Turklāt, kad notika šie paši sprādzieni ražošanā, mēs saņēmām sūdzības no programmētājiem un testeriem: tajā brīdī, kad viņiem ļoti nepieciešami šie žurnāli, tie tiek piegādāti ļoti lēni.
Sāka analizēt. No vienas puses, bija skaidrs, ka gan meklēšanas pieprasījumi, gan indeksēšanas pieprasījumi būtībā tiek apstrādāti uz vienām un tām pašām fiziskajām mašīnām, un tā vai citādi būs noteiktas novirzes.
Bet šo daļēji varēja apiet, pateicoties tam, ka sestajās Elasticsearch versijās parādījās algoritms, kas ļauj sadalīt pieprasījumus starp attiecīgajiem datu mezgliem nevis nejaušā kārtībā round-robin (konteiners, kas nodarbojas ar indeksēšanu un tur primāro fragmentu, var būt ļoti noslogots, tur nebūs iespējas ātri atbildēt), bet nosūtīt šo pieprasījumu uz mazāk noslogoto konteineru ar replikas fragmentu, kas atbildēs ievērojami ātrāk. Citiem vārdiem sakot, mēs pārgājām uz use_adaptive_replica_selection: true.
Lasīšanas aina sāk izskatīties šādi:
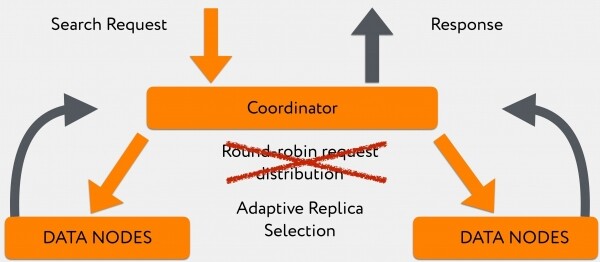
Pāreja uz šo algoritmu ļāva ievērojami uzlabot pieprasījuma laiku brīžos, kad mums notika liels žurnālu rakstīšanas plūsma.
Visbeidzot, galvenā problēma bija sāpīga datu centra izslēgšana.
Ko mēs vēlējāmies no klastera uzreiz pēc savienojuma zaudēšanas ar vienu datu centru:
- Ja mums atslēgtajā datu centrā ir pašreizējais meistars, tad tas tiks atkārtoti izvēlēts un pārcelsies kā loma uz citu mezglu citā datu centrā.
- Meistars ātri izmetīs no klastera visus nepieejamos mezglus.
- Pamatojoties uz atlikušajām, viņš sapratīs: zaudētajā datu centrā mums bija tādi primāri shardi, ātri promocēsim papildinošos replikas shardus atlikušajos datu centros, un mums turpināsies datu indeksācija.
- Šī rezultātā mūsu klastera caurlaidspēja rakstīšanai un lasīšanai pakāpeniski pasliktināsies, tomēr kopumā viss darbosies, lai arī lēnāk, bet stabilāk.
Kā izrādījās, mēs vēlējāmies kaut ko līdzīgu tam:
Bet saņēmām sekojošo:
Kā tā notika?
Datu centra krituma brīdī mūsu šaurs posms bija meistars.
Kāpēc?
Problēma ir tā, ka meistaram ir TaskBatcher, kas atbild par noteiktu uzdevumu un notikumu izplatīšanu klasterī. Ikviens mezgla iziešanas, jebkura sharda pāreja no replikas uz primāro, ikviens uzdevums kāda sharda izveidei — viss tas vispirms nonāk TaskBatcher, kur tas tiek apstrādāts secīgi un vienā plūsmā.
Datu centra zaišanas brīdī izrādījās, ka visi datu mezgli izdzīvojušajos datu centros uzskatīja par savu pienākumu informēt meistaru, ka „mums ir pazuduši tādi shardi un tādi datu mezgli”.
Tajā pat laikā izdzīvojušie datu mezgli sūtīja visu šo informāciju pašreizējam meistaram un centās gaidīt apstiprinājumu, ka viņš to ir saņēmis. Viņi to nesaņēma, jo meistars saņēma uzdevumus ātrāk, nekā spēja atbildēt. Mezgls pēc izsniegšanas atkārtoja pieprasījumus, bet meistars tajā laikā jau pat necentās atbildēt uz tiem, bet pilnībā bija absorbēts uzdevuma šķirošanai pēc prioritātes.
Termiņa ziņā izrādījās, ka datu mezgli sūtīja meistaram tik daudz pieprasījumu, ka viņš nonāca pilnīgā GC. Pēc tam mūsu meistara loma pārgāja uz kādu nākamo mezglu, un ar to notika absolūti tas pats, un galu galā klasteris pilnībā sabruka.
Mēs veicām mērījumus, un līdz versijai 6.4.0, kur šī problēma tika novērsta, mums bija pietiekami izslēgt vienlaikus tikai 10 datu mezglus no 360, lai pilnībā nogalinātu klasteri.
Tas izskatījās apmēram šādi:
Pēc versijas 6.4.0, kur tika novērsta šī biedējošā kļūda, datu mezgli pārstāja nogalināt meistaru. Bet no tā viņš kļuva „gudrāks”. Proti, kad mēs izslēdzam 2, 3 vai 10 (jebkuru skaitu, izņemot vienu) datu mezglus, meistars saņem kaut kādu pirmo ziņu, kas saka, ka mezgls A ir izslēdzies, un cenšas par to pastāstīt mezglam B, mezglam C, mezglam D.
Pašlaik ar šo var cīnīties tikai, uzstādot laika ierobežojumu mēģinājumiem kādam kaut ko pastāstīt, apmēram 20-30 sekundes, tādējādi kontrolējot datu centra izslēgšanas ātrumu no klastera.
Principā tas atbilst prasībām, kas sākotnēji tika izvirzītas galīgajam produktam projekta ietvaros, taču no "tīrās zinātnes" viedokļa tas ir kļūda. Kura, starp citu, tika veiksmīgi novērsta izstrādātāju versijā 7.2.
Turklāt, kad kāda datu noda izslēdzās, izrādījās, ka svarīgāk ir izplatīt informāciju par tās izslēgšanos nekā informēt visu klasteri, ka uz tās atradās noteikts primārais shards (lai reklamētu replica-shard citā datu centrā kā primāro, uz kuru var rakstīt informāciju).
Tādēļ, kad viss "atkal ir sakārtots", izslēgtās datu nodes nekavējoties netiek apzīmētas kā novecojušas. Tādējādi mēs esam spiesti gaidīt, kad beigsies visi pingus uz izslēgtajām datu noda, un tikai pēc tam mūsu klasteris sāk ziņot par to, ka tur, tur un tur ir jāturpina rakstīt informāciju. Plašāk par šo var lasīt. .
Galu galā datu centra izslēgšanas operācija mums šodien aizņem apmēram 5 minūtes stundas pīķa laikā. Tām lielajām un smagnējām struktūrām tas ir diezgan labs rezultāts.
Galu galā mēs nonācām pie šāda risinājuma:
- Mums ir 360 datu nodes ar 700 gigabaitu diskiem.
- 60 koordinatoru, lai maršrutētu trafiku pa šīm datu nodēm.
- 40 masteru, kas mums palikuši kā zināms mantojums no versijām pirms 6.4.0 — lai izturētu datu centra izslēgšanu, mēs morāli bijām gatavi zaudēt dažas mašīnas, lai garantētu pat sliktākā scenārija gadījumā saglabāt masteru balsu skaitu.
- Jebkuras mēģinājumas apvienot lomas vienā konteinerā aizvien pamatā nonāca pie tā, ka agrāk vai vēlāk node sabojājās zem slodzes.
- Visā klasterī tiek izmantots heap.size, kas ir 31 gigabaits: visas mēģinājumi samazināt izmēru noved pie tā, ka smagos meklēšanas pieprasījumos ar leading wildcard tika iznīcinātas dažas noderes vai tika ieslēgts circuit breaker paša Elasticsearch.
- Turklāt, lai nodrošinātu meklēšanas veiktspēju, mēs cenšamies uzturēt objektu skaitu klasterī pēc iespējas mazāku, lai apstrādātu pēc iespējas mazāk notikumu pašā šaurākajā vietā, kas mums radās masterī.
Beidzot par uzraudzību.
Lai viss darbotos tā, kā plānots, mēs uzraugām sekojošo:
- Katrs datu centrs ziņo mūsu mākoņos, ka tas eksistē un uz tā ir šādi šardu. Kad mēs kaut kur kādu izslēdzam, klasteris pēc 2-3 sekundēm ziņo, ka centrā A mēs izslēdzām mezglu 2, 3 un 4 — tas nozīmē, ka citos datu centros mums nekādā gadījumā nevar izslēgt tos mezglus, uz kuriem palikuši šardi vienīgā eksemplārā.
- Pazīstot meistara uzvedību, mēs ļoti uzmanīgi sekojam pending-uzdevumu skaitam. Jo pat viens iestrēdzis uzdevums, ja netiks savlaicīgi izlaists, teorētiski kādā steidzamā situācijā var kļūt par iemeslu, kāpēc mums nedarbosies, piemēram, replikas šarda pāreja uz primāro, kā rezultātā apstājas indeksēšana.
- Mēs arī ļoti uzmanīgi sekojam garbage collector aizkavēšanās laikam, jo ar to mums jau bija lieli sarežģījumi optimizācijas procesā.
- Rejdžekti pa pavedieniem, lai iepriekš saprastu, kur atrodas "sūknēšanas piltuve".
- Nu un standarta metriki, piemēram, heap, RAM un I/O.
Izveidojot uzraudzību, noteikti jāņem vērā īpašības Thread Pool Elasticsearch. apraksta iespējas konfigurēt un noklusējuma vērtības meklēšanai, indeksēšanai, taču pilnībā norobežojas no thread_pool.management. Šie pavedieni apstrādā, tostarp, pieprasījumus, piemēram, _cat/shards un citus līdzīgus, kurus ērti izmantot, rakstot uzraudzību. Jo lielāks klasteris, jo vairāk tādu pieprasījumu tiek izpildīti vienā laika vienībā, bet iepriekš minētais thread_pool.management ne tikai netiek iekļauts oficiālajā dokumentācijā, bet arī pēc noklusējuma ir ierobežots ar 5 pavedieniem, kas ļoti ātri tiek izlietoti, pēc kā uzraudzība pārstāj darboties pareizi.
Ko gribas teikt noslēgumā: mums izdevās! Mēs izveidojām saviem programmētājiem un izstrādātājiem rīku, kas praktiski jebkurā situācijā spēj ātri un precīzi sniegt informāciju par notiekošo ražošanā.
Jā, tas izrādījās diezgan sarežģīti, taču tomēr mūsu vēlmes izdevās iekļaut jau esošajos produktos, kurus tajā pašā laikā nevajadzēja labot un pārrakstīt sev.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish