

Tabulu un indeksu uzpūšanas efekts (bloat) ir plaši zināms un tam ir raksturīga ne tikai Postgres. Ir veidi, kā ar to cīnīties "no kastes" kā VACUUM FULL vai CLUSTER, bet tie bloķē tabulas darba laikā un tādēļ ne vienmēr var tikt izmantoti.
Rakstā būs nedaudz teorijas par to, kā rodas bloat, kā ar to var cīnīties, par deferred constraints un problēmām, kuras tās ievieš, izmantojot pg_repack paplašinājumu.
Šis raksts ir rakstīts, pamatojoties uz PgConf.Russia 2020.
Kāpēc rodas bloat
Postgres pamatā ir vairākversiju modelis (). Tās būtība ir tāda, ka katrai rindai tabulā var būt vairākas versijas, savukārt transaction redz ne vairāk kā vienu no šīm versijām, bet tas nav obligāti jābūt tādai pašai. Tas ļauj vairākiem darījumiem darboties vienlaicīgi un praktiski nekādā veidā neietekmēt cits citu.
Acīmredzot jāuzglabā visas šīs versijas. Postgres strādā ar atmiņu lappušu līmenī un lappa ir minimālais datu apjoms, ko var izlasīt no diska vai ierakstīt. Apskatīsim nelielu piemēru, lai saprastu, kā tas notiek.
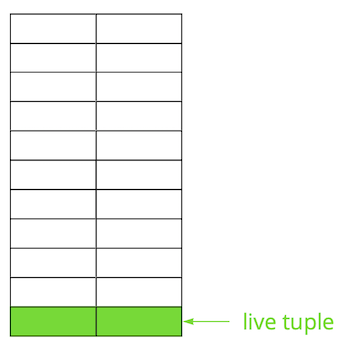
Pieņemsim, ka mums ir tabula, kurā pievienotas vairākas ieraksti. Pirmajā datu faila lappusē, kur tiek glabāta tabula, parādījās jauni dati. Tie ir dzīvās rindu versijas, kas pēc apstiprināšanas ir pieejamas citiem darījumiem (lai vienkāršotu pieņemam, ka izolācijas līmenis ir Read Committed).
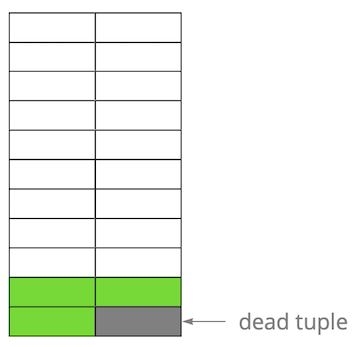
Tad mēs atjauninājām vienu no ierakstiem un tādējādi atzīmējām veco versiju kā neaktuālu.
Pakāpeniski atjauninot un dzēšot rindu versijas, mēs iegūstam lappusi, kurā apmēram puse datu ir "atkritumi". Šie dati nav redzami nevienam darījumam.
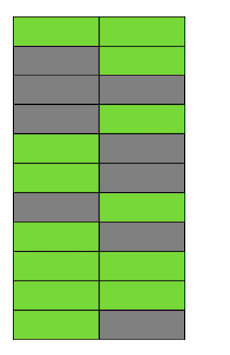
Postgres pastāv mehānisms , kas iztīra neaktualizētās versijas un atbrīvo vietu jauniem datiem. Bet, ja tas nav pietiekami agresīvi iestatīts vai ir aizņemts darbā citās tabulās, tad "atkritumu dati" paliek, un mums jāizmanto papildu lappuses jaunajiem datiem.
Tātad mūsu piemērā kādā brīdī tabula sastāvēs no četriem lapām, bet dzīvās datu daļas tajā būs tikai puse. Rezultātā, piekļūstot tabulai, mēs izlasīsim daudz vairāk datu, nekā nepieciešams.
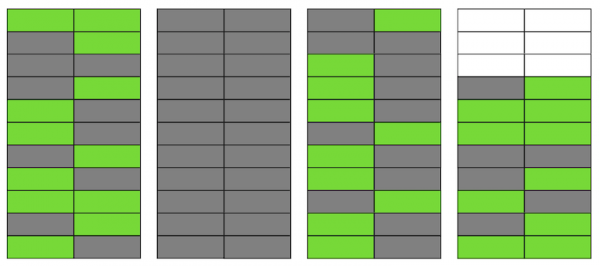
Pat, ja VACUUM noņem visus novecojušos rindu variantus, situācija krasi neuzlabosies. Mums radīsies brīva vieta lapās vai pat veselas lapas jaunām rindām, taču mēs joprojām lasīsim vairāk datus, nekā nepieciešams.
Starpslāni, ja pilnīgi tukša lapa (otrā mūsu piemērā) atrastos faila beigās, VACUUM varētu to noņemt. Bet šobrīd tā atrodas pa vidu, tāpēc neko ar to izdarīt nevar.
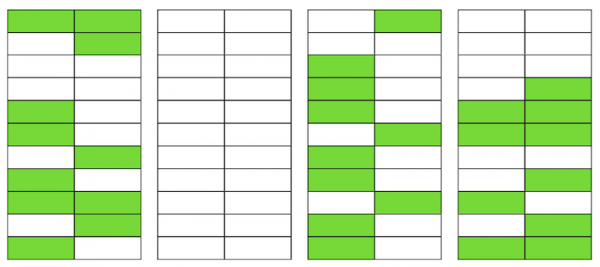
Kad šādu tukšu vai ļoti izsvaidītu lapu skaits kļūst liels, ko sauc par bloat, tas sāk ietekmēt veiktspēju.
Iepriekš aprakstītais ir bloat veidošanās mehānika tabulās. Indeksos tas notiek aptuveni tāpat.
Vai man ir bloat?
Ir vairāki veidi, kā noteikt, vai jums ir bloat. Pirmais ir izmantošana, kas izmanto Postgres iekšējās statistikas datus, kuros ir aptuvena informācija par rindu skaitu tabulās, “dzīvām” rindām utt. Internetā var atrast daudz variantu jau gataviem skriptiem. Mēs balstījāmies uz no PostgreSQL Experts, kas var novērtēt tabulu bloat kopā ar toast un bloat btree-indeksiem. Saskaņā ar mūsu pieredzi tā precizitāte ir 10-20%.
Cits veids — izmantot paplašinājumu , kas ļauj ielūkoties lapās un iegūt gan novērtējuma, gan precīzu bloat vērtību. Bet otrajā gadījumā būs jāskenē visa tabula.
Mazu bloat vērtību, līdz 20%, mēs uzskatām par pieņemamu. To var uzskatīt par līdzvērtīgu fillfactor un . Pie 50% un vairāk var rasties veiktspējas problēmas.
Cīņas veidi pret bloat
Postgres ir vairāki veidi, kā cīnīties ar bloat “no kastes”, tomēr tie ne vienmēr un ne visiem var izrādīties piemēroti.
Iestatiet AUTOVACUUM, lai bloat nerastos.. Un precīzāk, lai tas tiktu uzturēts pie jums pieņemamā līmenī. Šķiet, ka tas ir „kapteiņa” padoms, taču patiesībā to ne vienmēr ir viegli sasniegt. Piemēram, ja jums notiek aktīva izstrāde ar regulārām datu shēmas izmaiņām vai ir kāda datu migrācija. Līdz ar to jūsu slodzes profils var bieži mainīties un, kā likums, tas atšķiras dažādām tabulām. Tas nozīmē, ka jums nepārtraukti nedaudz jāstrādā uz priekšu un jāpielāgo AUTOVACUUM mainīgajam katras tabulas profilam. Bet ir acīmredzami, ka to izdarīt nav vienkārši.
Vēl viena izplatīta iemesla dēļ, kāpēc AUTOVACUUM nespēj apstrādāt tabulas, ir ilgstošu darījumu esamība, kas neļauj tam izdzēst datus, jo tie ir pieejami šiem darījumiem. Ieteikums šeit arī ir acīmredzams – atbrīvoties no „karājošajiem” darījumiem un minimizēt aktīvo darījumu laiku. Bet ja jūsu lietotnes slodze ir OLAP un OLTP hibrīds, jums vienlaikus var būt gan daudz biežu atjauninājumu un īsu vaicājumu, gan ilgstošas operācijas – piemēram, kāda pārskata izveide. Šādā situācijā ir vērts apsvērt slodzes sadalīšanu uz dažādām datubāzēm, kas ļaus veikt katras no tām rūpīgāku konfigurāciju.
Vēl viens piemērs – pat ja profils ir viendabīgs, bet datubāze atrodas ļoti augstas slodzes apstākļos, tad pat maksimāli agresīvs AUTOVACUUM var nespēt tikt galā, un bloat var rasties. Skalēšana (vertikāla vai horizontāla) ir vienīgā atrisinājums.
Kā rīkoties situācijā, kad AUTOVACUUM esat iestatījis, bet bloat turpina augt.
Komanda VACUUM FULL pārbūvē tabulu un indeksu saturu un atstāj tajos tikai aktuālos datus. Lai novērstu bloat, tas darbojas ideāli, taču tās veikšanas laikā tiek pieprasīta ekskluzīva blokāde uz tabulu (AccessExclusiveLock), kas neļauj veikt vaicājumus uz šo tabulu, pat selectus. Ja jūs varat atļauties apturēt savu pakalpojumu vai tā daļu uz noteiktu laiku (no desmit minutēm līdz vairākām stundām, atkarībā no datubāzes lieluma un jūsu aparatūras), tad šis variants ir vislabākais. Diemžēl mēs neesam spējīgi veikt VACUUM FULL izpildi plānotā apkalpošanas laikā, tādēļ šī metode mums neder.
Komanda CLUSTER Tāpat kā VACUUM FULL, tas pārveido tabulu saturu, ļaujot norādīt indeksu, pēc kura dati fiziski tiks sakārtoti diskā (taču nākotnē jaunām rindām kārtība netiek garantēta). Noteiktos apstākļos tā ir laba optimizācija vairākiem pieprasījumiem – lasot vairākus ierakstus pēc indeksa. Komandas trūkums ir tāds pats kā VACUUM FULL – tā bloķē tabulu darbības laikā.
Komanda REINDEX tāpat kā iepriekšējās divas, taču veic konkrēta indeksa vai visu tabulas indeksu pārveidošanu. Bloķēšanas ir nedaudz vājākas: ShareLock uz tabulu (traucē modificēšanu, bet atļauj select izpildi) un AccessExclusiveLock uz pārveidojamo indeksu (bloķē pieprasījumus, kas izmanto šo indeksu). Tomēr 12. versijā Postgres tika ieviests parametrs , kas ļauj pārveidot indeksu, nebloķējot paralēlu ierakstu pievienošanu, maiņu vai dzēšanu.
Agrākajās Postgres versijās rezultātu, kas līdzīgs REINDEX CONCURRENTLY, var sasniegt, izmantojot . Tas ļauj izveidot indeksu bez stingras bloķēšanas (ShareUpdateExclusiveLock, kas netraucē paralēlām pieprasījumiem), pēc tam nomainīt veco indeksu uz jauno un izdzēst veco indeksu. Tas ļauj novērst indeksu bloat, netraucējot jūsu lietojumprogrammas darbību. Ir svarīgi ņemt vērā, ka indeksu pārveidošanas laikā diskam būs papildu slodze.
Tādējādi, ja indeksiem ir veidi, kā novērst bloat „karstajā” režīmā, tad tabulām tādu nav. Šeit iejaucas dažādi ārējie paplašinājumi: (agrāk pg_reorg), , un citi. Šajā rakstā es nesalīdzināšu tos un pastāstīšu tikai par pg_repack, kuru pēc nelielas pielāgošanas mēs izmantojam pie sevis.
Kā darbojas pg_repack
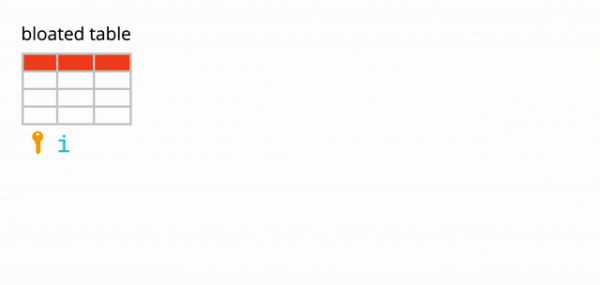
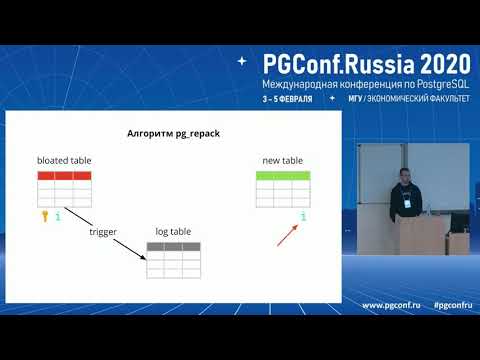
Pieņemsim, ka mums ir pilnīgi parasta tabula – ar indeksiem, ierobežojumiem un, diemžēl, ar bloat. Pirmajā solī pg_repack izveido žurnāla tabulu, lai glabātu datus par visām izmaiņām darba laikā. Trīgeris replikēs šīs izmaiņas uz katru insert, update un delete. Pēc tam tiek izveidota tabula, kas ir līdzīga sākotnējai struktūrai, taču bez indeksiem un ierobežojumiem, lai nepalēninātu datu ievietošanas procesu.
Tālāk pg_repack pārvieto datus no vecās tabulas jaunajā, automātiski filtrējot visus novecojušos ierakstus, un pēc tam izveido indeksus jaunajai tabulai. Visu šo operāciju laikā žurnālu tabulā tiek uzkrāti izmaiņas.
Nākamais solis ir pārvietot izmaiņas jaunajā tabulā. Pārvietošanas process notiek vairākās iterācijās, un kad žurnālu tabulā paliek mazāk par 20 ierakstiem, pg_repack ievēro stingru bloķēšanu, pārvieto pēdējos datus un aizvieto veco tabulu ar jauno sistēmas tabulās Postgres. Tas ir vienīgais un ļoti īss laika posms, kad jūs nevarat strādāt ar tabulu. Pēc tam vecā tabula un žurnālu tabula tiek dzēstas, atbrīvojot vietu failu sistēmā. Process ir pabeigts.
Teorijā viss izskatās lieliski, bet kas notiek praksē? Mēs testējām pg_repack bez slodzes un slodzes apstākļos, pārbaudījām tā darbību gadījumā, ja tas tiek priekšlaicīgi pārtraukts (vienkāršiem vārdiem, ar Ctrl+C). Visi testi bija pozitīvi.
Mēs devāmies uz ražošanas vidi — un šeit viss aizgāja negaidīti.
Pirmais pārpratums ražošanā
Pirmajā klasterī mēs saņēmām kļūdu par unikālā ierobežojuma pārkāpumu:
$ ./pg_repack -t tablename -o id
INFO: pārkopēju tabulu "tablename"
ERROR: vaicājums neizdevās:
    ERROR: dublikāta atslēgas vērtība pārkāpj unikālo ierobežojumu "index_16508"
DETAIL: Atslēga (id, index)=(100500, 42) jau eksistē.
Šim ierobežojumam bija automātiski ģenerēts nosaukums index_16508 — to izveidoja pg_repack. Pēc tā atribūtiem mēs noteicām “mūsu” ierobežojumu, kas tam atbilst. Problēma izrādījās, ka tas nav pavisam parasts ierobežojums, bet atlikts (), t.i., tā pārbaude notiek vēlāk nekā SQL komanda, kas noved pie negaidītām sekām.
Atliktie ierobežojumi: kāpēc tie ir nepieciešami un kā tie darbojas
Nedaudz teorijas par atliktajiem ierobežojumiem.
Ņemsim vienkāršu piemēru: mums ir automašīnu katalogs ar diviem atribūtiem – nosaukumu un automašīnas secību katalogā.
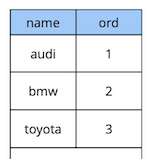
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Pieņemsim, ka mums nepieciešams samainīt pirmo un otro automašīnu vietām. Risinājums “pa taisno” – atjaunināt pirmo vērtību uz otro, un otro uz pirmo:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Bet, izpildot šo kodu, mēs sagaidām, ka saņemsim ierobežojuma pārkāpumu, jo vērtību secība tabulā ir unikāla:
[23305] KĒĻA: dublēta atslēgas vērtība pārkāpj unikālā ierobežojuma “uk_cars”
Detaļas: Atslēga (ord)=(2) jau pastāv.
Kā to izdarīt savādāk? Pirmais variants: pievienot papildu aizvietojumu vērtībai kārtībā, kas noteikti neeksistē tabulā, piemēram, “-1”. Programmēšanā to sauc par “divu mainīgo vērtību apmaiņu caur trešo”. Vienīgais šī metode trūkums ir papildu atjauninājums.
Otrais variants: pārprojektēt tabulu, lai izmantotu kustīgu komatu datu tipu kārtības vērtībai, nevis veseliem skaitļiem. Tad, atjauninot vērtību no 1, piemēram, uz 2.5, pirmais ieraksts automātiski “nostāsies” starp otro un trešo. Šis risinājums darbojas, taču tam ir divi ierobežojumi. Pirmkārt, tas jums nederēs, ja vērtība tiek izmantota kaut kur saskarnē. Otrkārt, atkarībā no datu tipa precizitātes jums būs ierobežots iespējamo ievietojumu skaits pirms visiem ierakstiem jānoprecizē vērtības.
Trešais variants: padarīt ierobežojumu atliktu, lai to pārbaudītu tikai apņemšanās brīdī:
izveidot tabulu automašīnām
(
  nosaukums teksts ierobežojums pk_cars primārā atslēga,
  ord vesels skaitlis ne nulles ierobežojums uk_cars unikāls atlikts sākuma atlikts
);
Tā kā mūsu sākotnējā pieprasījuma loģika garantē, ka apņemšanās brīdī visas vērtības ir unikālas, tad tas tiks izpildīts veiksmīgi.
Iepriekš apskatītais piemērs, protams, ir ļoti sintētisks, taču ideju skaidri parāda. Mūsu lietojumprogrammā mēs izmantojam atliktus ierobežojumus konflikta risināšanas loģikas īstenošanai, kad vairāki lietotāji vienlaikus strādā ar kopīgiem objektiem-žogiem uz dēļa. Šādu ierobežojumu izmantošana ļauj mums padarīt lietojumprogrammas kodu nedaudz vienkāršāku.
Kopumā, atkarībā no ierobežojuma veida Postgres, pastāv trīs līmeņu detalizētība to pārbaudei: rindu līmenis, darījumu līmenis un izteiksmes līmenis.
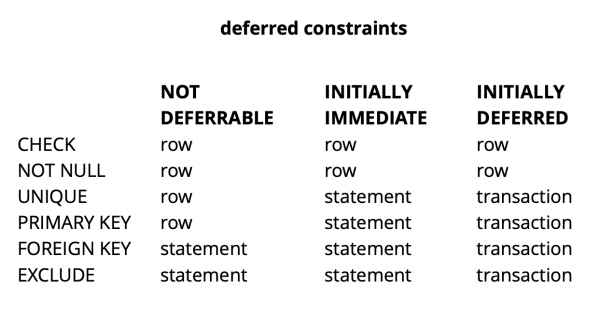
Avots:
CHECK un NOT NULL vienmēr tiek pārbaudīti rindu līmenī, pārējiem ierobežojumiem, kā redzams tabulā, ir dažādi varianti. Sīkāk var izlasīt .
Ja īsi rezumētu, atliktie ierobežojumi daudzkārt ļauj veidot kodu, kas ir vieglāk lasāms un prasa mazāk komandu. Tomēr par to nākas samaksāt ar procesa sarežģītību, jo kļūdas rašanās brīdis un brīdis, kad par to uzzināt, ir atšķirīgi. Vēl viena iespējamā problēma ir tā, ka plānotājs ne vienmēr spēj izveidot optimālu plānu, ja pieprasījumā ir iekļauts atliktais ierobežojums.
pg_repack uzlabošana
Mēs esam sapratuši, kas ir atliktie ierobežojumi, bet kā tie ir saistīti ar mūsu problēmu? Atcerēsimies kļūdu, kuru iepriekš saņēmām:
$ ./pg_repack -t tablename -o id
INFO: pārkopēju tabulu "tablename"
ERROR: vaicājums neizdevās:
    ERROR: dublikāta atslēgas vērtība pārkāpj unikālo ierobežojumu "index_16508"
DETAIL: Atslēga (id, index)=(100500, 42) jau eksistē.
Tā rodas datu kopēšanas brīdī no žurnāla tabulas uz jauno tabulu. Tas izskatās dīvaini, jo dati žurnāla tabulā tiek apstiprināti kopā ar dati no sākotnējās tabulas. Ja tie apmierina sākotnējās tabulas ierobežojumus, kā tad tie var pārkāpt tos pašus ierobežojumus jaunajā?
Izrādās, problēmas sakne slēpjas iepriekšējā pg_repack darba posmā, kur tiek izveidoti tikai indeksi, nevis ierobežojumi: vecajā tabulā bija unikāls ierobežojums, bet jaunajā tā vietā tika izveidots unikāls indekss.
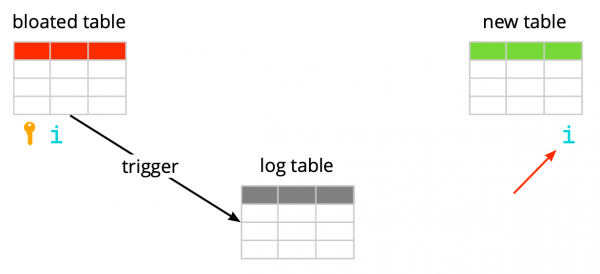
Šeit ir svarīgi atzīmēt, ka, ja ierobežojums ir parasts, nevis atlikts, tad tā vietā izveidotais unikālais indekss ir ekvivalents šim ierobežojumam, jo unikālie ierobežojumi Postgres tiek īstenoti, izmantojot unikālu indeksu izveidi. Bet gadījumā ar atlikto ierobežojumu uzvedība nav tāda pati, jo indekss nevar būt atlikts un vienmēr tiek pārbaudīts SQL komandas izpildes brīdī.
Tādējādi problēmas būtība ir "atliktajā" pārbaudē: sākotnējā tabulā tā notiek apstiprinājuma brīdī, bet jaunajā - SQL komandas izpildes brīdī. Tātad mums ir jādara tā, lai pārbaudes notiktu vienādi abos gadījumos: vai nu vienmēr atlikti, vai nu vienmēr nekavējoties.
Tātad, kādas idejas mums bija.
Izveidot indeksu, kas līdzīgs atliktajam
Pirma ideja ir veikt abas pārbaudes tūlītējā režīmā. Tas var radīt dažus false positive ierobežojumus, bet, ja tādu būs maz, tam nevajadzētu ietekmēt lietotāju darbu, jo šādas konfliktācijas ir normāla situācija. Tās rodas, piemēram, kad divi lietotāji vienlaicīgi sāk rediģēt to pašu logrīku, un otrā lietotāja klients nepagūst saņemt informāciju, ka logrīks jau ir bloķēts pirmajam lietotājam. Šādā situācijā serveris atbild otrajam lietotājam ar atteikumu, un viņa klients atgriež izmaiņas un bloķē logrīku. Nedaudz vēlāk, kad pirmais lietotājs pabeidz rediģēšanu, otrais saņems informāciju, ka logrīks vairs nav bloķēts un var atkārtot savu darbību.
Lai pārbaudes vienmēr būtu neatliekamā režīmā, mēs izveidojām jaunu indeksu, kas ir līdzīgs oriģinālajam atliktā ierobežojuma indeksam:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- run pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
Mūsu testēšanas vidē mēs saņēmām tikai dažas paredzētās kļūdas. Panākums! Atkal palaidām pg_repack uz produkcijas un saņēmām 5 kļūdas pirmajā klasterī stundas laikā. Tas ir pieņemams rezultāts. Tomēr jau otrajā klasterī kļūdu skaits palielinājās vairākkārtīgi un mums nācās apturēt pg_repack.
Kāpēc tā notika? Kļūdas rašanās iespējamība ir atkarīga no tā, cik daudz lietotāju vienlaicīgi strādā ar vieniem un tiem pašiem logrīkiem. Spriežot pēc visa, tajā brīdī datus, kas tika glabāti pirmajā klasterī, bija daudz mazāk konkurējošu izmaiņu nekā pārējos, t.i., mums vienkārši «paveicās».
Ideja nesanāca. Tajā brīdī mēs redzējām divus citus risinājuma variantus: pārrakstīt mūsu lietojumprogrammas kodu, lai atteiktos no atliktajiem ierobežojumiem, vai «iemācīt» pg_repack ar tiem strādāt. Mēs izvēlējāmies otro.
Aizstāt indeksus jaunajā tabulā ar atliktajiem ierobežojumiem no oriģinālās tabulas
Uzlabojuma mērķis bija acīmredzams – ja sākotnējai tabulai ir atliktais ierobežojums, tad jaunajai jāizveido tāds ierobežojums, nevis indekss.
Lai pārbaudītu mūsu izmaiņas, mēs uzrakstījām vienkāršu testu:
- tabula ar atlikto ierobežojumu un vienu ierakstu;
- ievietojam ciklā datus, kas konfliktē ar esošo ierakstu;
- veicam atjauninājumu – dati vairs nav pretrunīgi;
- apstiprinām izmaiņas.
izveidot tabulu test_table
(
  id sērijas,
  val int,
  ierobežojums uk_test_table__val unikāls (val) atlikts sākotnēji atlikts
);
Ievietot test_table (val) VĒRTĪBAS (0);
FOR i IN 1..10000 CYKLS
  SĀKT
    Ievietot test_table VĒRTĪBAS (0) ATGRIEŽOT id INTO v_id;
    ATJAUNOT test_table iestatīt val = i kur id = v_id;
    APSTIPRINĀT;
  BEIGT;
END LOOP;
Pamatversija pg_repack vienmēr kļūdījās pirmajā ievietošanā, uzlabotā versija strādāja bez kļūdām. Lieliski.
Dodamies uz produkciju un atkal saņemam kļūdu tajā pašā datu kopēšanas fāzē no žurnāltabulas uz jauno:
$ ./pg_repack -t tablename -o id
INFO: pārkopēju tabulu "tablename"
ERROR: vaicājums neizdevās:
    ERROR: dublikāta atslēgas vērtība pārkāpj unikālo ierobežojumu "index_16508"
DETAIL: Atslēga (id, index)=(100500, 42) jau eksistē.
Klasiska situācija: testēšanas vidēs viss strādā, bet produkcijā – nē?!
APPLY_COUNT un divu partiju savienojums
Mēs sākām analizēt kodu burtiski pa rindām un atklājām svarīgu momentu: datu pārsūtīšana no žurnāltabulas uz jauno notiek partijās, konstante APPLY_COUNT norādīja uz partijas izmēru:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     turpināt;
/* varētu būt vēl daži tuplī, atkārtojiet. */
...
}
Problēma ir tā, ka sākotnējās transakcijas dati, kurā vairākas operācijas var potenciāli pārkāpt ierobežojumu, pārsūtīšanas laikā var nonākt uz divu partiju savienojuma – puse komandu tiks apstiprinātas pirmajā partijā, bet otra puse — otrajā. Un šeit kā paveiksies: ja komandas pirmajā partijā neko nepārkāpj, tad viss ir labi, bet ja pārkāpj — notiek kļūda.
APPLY_COUNT ir 1000 ieraksti, kas izskaidro, kāpēc mūsu testi izdevās – tie neaptvēra gadījumu "partiju savienojuma". Mēs izmantojām divas komandas – ievietošana un atjaunināšana, tāpēc tieši 500 transakcijas pa divām komandām vienmēr iekļāvās partijā, un mēs nesaskārāmies ar problēmām. Pēc otrā atjauninājuma pievienošanas mūsu labojums vairs nedarbosies:
FOR i IN 1..10000 CYKLS
  SĀKT
    Ievietot test_table VĒRTĪBAS (1) ATGRIEŽOT id INTO v_id;
    ATJAUNOT test_table iestatīt val = i kur id = v_id;
    ATJAUNOT test_table iestatīt val = i kur id = v_id; -- vēl viena atjaunināšana
    APSTIPRINĀT;
  BEIGT;
END LOOP;
Tātad nākamais uzdevums – panākt, lai no sākotnējās tabulas dati, kas tika mainīti vienā transakcijā, nonāktu jaunajā tabulā arī vienā transakcijā.
Attieksme no partiju veidošanas
Un again, we had two solutions available. The first was to completely abandon batching and perform the data transfer in a single transaction. The advantage of this solution was its simplicity – the required code changes were minimal (by the way, in older versions, pg_reorg used to work this way). However, there is a problem – we create a long transaction, which, as previously mentioned, poses a risk of new bloat occurring.
The second solution is more complex but perhaps more correct: to create a column in the log table with the identifier of the transaction that added the data to the table. This way, when copying the data, we can group it by this attribute and ensure that related changes are transferred together. The batch will be formed from several transactions (or one large one), and its size will vary depending on how much data was modified in these transactions. It's important to note that since data from different transactions enter the log table in a random order, it will no longer be possible to read it sequentially as before. Using seqscan with each request filtered by tx_id is too costly; an index is needed, but it will slow down the method due to the overhead of updating it. In general, as always, something must be sacrificed.
So, we decided to start with the first option as it was simpler. First, we needed to understand whether a long transaction would be a real problem. Since the main data transfer from the old table to the new one also occurs in one long transaction, the question transformed into "how much will we increase this transaction?" The duration of the first transaction mainly depends on the size of the table. The duration of the new one depends on how many changes accumulate in the table during the data pouring, i.e., on the intensity of the load. The pg_repack run occurred during minimal service load, and the volume of changes was negligible compared to the original table size. We decided that we could ignore the time of the new transaction (on average, it is 1 hour and 2-3 minutes).
The experiments were successful. The launch in production was as well. For clarity – here is an image showing the size of one of the databases after running the process:
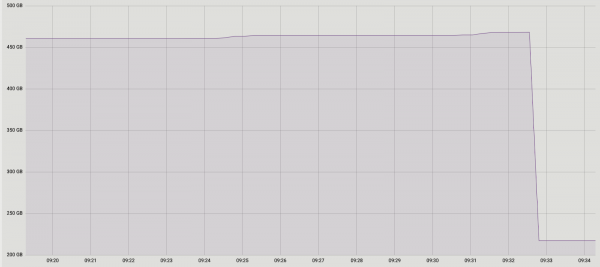
Tā kā šis risinājums mūs pilnībā apmierināja, mēs nolēmām neizmēģināt otro variantu, taču apsveram iespēju to apspriest ar paplašinājuma izstrādātājiem. Mūsu pašreizējā izstrāde, diemžēl, vēl nav gatava publicēšanai, jo mēs atrisinājām problēmu tikai ar unikālajiem atliktajiem ierobežojumiem, bet pilnvērtīgam labojumam nepieciešams atbalsts arī citiem veidiem. Ceram, ka nākotnē izdosies to paveikt.
Iespējams, jums radās jautājums, kāpēc mēs vispār iesaistījāmies šajā stāstā par pg_repack pielāgošanu, nevis izmantojām tā analogus? Noteiktā brīdī arī mēs par to domājām, taču iepriekšējā pozitīvā pieredze ar tā izmantošanu tabulās bez atliktajiem ierobežojumiem motivēja mūs mēģināt izprast problēmas būtību un to novērst. Turklāt, lai izmantotu citus risinājumus, nepieciešams laiks testēšanai, tādēļ nolēmām vispirms izmēģināt problēmu novērst šajā, un, ja sapratīsim, ka to nevarēsim izdarīt saprātīgā laikā, tad sāksim apsvērt analogus.
Secinājumi
Ko mēs varam ieteikt, pamatojoties uz savu pieredzi:
- Uzraugiet savu bloat. Pamatojoties uz uzraudzības datiem, jūs varat saprast, cik labi ir konfigurēts autovacuum.
- Konfigurējiet AUTOVACUUM, lai saglabātu bloat pieļaujamā līmenī.
- Ja bloat tomēr pieaug un jūs to nevarat novērst ar ''kastē iekļautajiem'' līdzekļiem, nebaidieties izmantot ārējos paplašinājumus. Galvenais ir veikt labus testus.
- Neizaudējiet iespēju pielāgot ārējos risinājumus savām vajadzībām – dažreiz tas var būt efektīvāk un pat vieglāk nekā mainīt savu kodu.
Avots: habr.com
