

Šī ir stāsts par to, kā mēs izmantojam konteinerus produkta vidē, īpaši Kubernetes. Raksts ir veltīts metrikas un žurnālu vākšanai no konteineriem, kā arī attēlu veidošanai.
Mēs esam fintehnoloģiju uzņēmums Exness, kas nodarbojas ar tiešsaistes tirdzniecības pakalpojumu un fintehnoloģiju produktu izstrādi B2B un B2C. Mūsu R&D ir daudzas dažādas komandas, izstrādes nodaļā strādā vairāk nekā 100 darbinieku.
Mēs pārstāvējam komandu, kas atbild par platformas izstrādi, kas tiek izmantota, lai vāktu un palaistu kodu mūsu izstrādātājiem. It īpaši mēs atbildam par metrikas, žurnālu un notikumu vākšanu, glabāšanu un sniegšanu no lietotnēm. Pašlaik mēs apkalpojam apmēram trīs tūkstošus Docker konteineru produkta vidē, uzturam mūsu big data krātuvi ar apjomu 50 TB un piedāvājam arhitektūras risinājumus, kas ir balstīti uz mūsu infra struktūru: Kubernetes, Rancher un dažādi publiskie mākoņu pakalpojumu sniedzēji.
Mūsu motivācija
Kas deg? Neviens nevar atbildēt. Kur ir avots? Grūti saprast. Kad tas aizdegās? Var noskaidrot, bet ne uzreiz.
Kāpēc daži konteineri stāv, bet citi nokrituši? Kurš konteineris ir pie vainas? Galu galā no ārpuses konteineri izskatās vienādi, bet katram iekšpusē ir savs Neo.
Mūsu izstrādātāji ir zinoši speciālisti. Viņi veido labus pakalpojumus, kas uzņēmumam nes peļņu. Bet mēdz būt neveiksmju mirkļi, kad lietotņu konteineri nonāk haotiskā stāvoklī. Viens konteineris patērē pārāk daudz CPU, cits - tīklu, trešais - I/O operācijas, ceturtais vispār nav skaidrs, ko dara ar soketiem. Viss tas avarē un kuģis grimst.
Aģenti
Lai saprastu, kas notiek iekšienē, mēs nolēmām uzstādīt aģentus tieši konteineros.
Šie aģenti ir ierobežojošas programmas, kas uztur konteinerus tādā stāvoklī, lai tie nesabojātu viens otru. Aģenti ir standartizēti, un tas ļauj standartizēt pieeju konteineru apkalpošanai.
Mūsu gadījumā aģentiem jānodrošina žurnāli standartizētā formātā, ar marķējumu un regulēšanu. Viņiem arī jāpiedāvā standartizētas metrikas, kas ir paplašināmas uzņēmējdarbības lietotņu skatījumā.
Aģenti ietver arī rīkus ekspluatācijai un apkalpošanai, kas ir spējīgi strādāt dažādās orķestra sistēmās un atbalsta dažādas images (Debian, Alpine, Centos utt.).
Visbeidzot, aģentiem ir jāatbalsta vienkāršs CI/CD, kas ietver Docker failus. Pretējā gadījumā kuģis saārdīsies, jo konteineri tiks piegādāti pa "krokiem" sliedēm.
Būves process un mērķa attēla ierīce
Lai viss būtu standartizēts un pārvaldāms, ir jāievēro kāds standarta būves process. Tāpēc mēs nolēmām veidot konteinerus, izmantojot konteinerus — tāda ir rekursija.
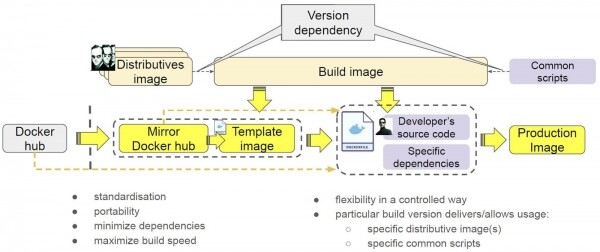
Šeit konteineri ir attēloti kā solidi kontūri. Mēs arī izlēmām ievietot tajos distribūcijas, lai "dzīve nesanāktu kā aveņu lauks". Kāpēc tas tika izdarīts, mēs pastāstīsim zemāk.
Rezultātā izveidojām būves rīku — noteikta versijas konteiners, kurš atsaucas uz noteiktām distribūciju versijām un noteiktām skriptu versijām.
Kā mēs to lietojam? Mums ir Docker Hub, kurā atrodas konteiners. Mēs to mirgojam savā sistēmā, lai atbrīvotos no ārējām atkarībām. Rezultātā mēs iegūstam konteiners, kurš ir marķēts dzeltenā krāsā. Mēs izveidojam veidni, lai uzstādītu visus nepieciešamos distribūcijas un skriptus konteinerā. Pēc tam mēs veidojam darbam gatavu attēlu: izstrādātāji tajā ievieto kodu un dažas savas specifiskās atkarības.
Kāpēc šāds pieejas modelis ir labs?
- Pirmkārt, pilnīga versiju kontrole būves rīkiem – būves konteiners, skriptu un distribūciju versijas.
- Otrkārt, mēs sasniedzām standartizāciju: vienādā veidā izveidojam veidnes, starpposma un darbam gatavas attēlus.
- Treškārt, konteineri nodrošina mums pārnēsājamu risinājumu. Šodien mēs izmantosim GitLab, bet rīt pāriesim uz TeamCity vai Jenkins un tāpat varēsim palaist mūsu konteinerus.
- Ceturkārt, atkarību minimizācija. Mēs nejauši ievietojām distribūcijas konteinerā, jo tas ļauj nebūt katru reizi jālejupielādē tās no Interneta.
- Piektkārt, uzlabojās būves ātrums – lokālo attēlu klātbūtne ļauj netērēt laiku lejupielādēšanai, jo ir lokālais attēls.
Citiem vārdiem sakot, mēs esam sasnieguši kontrolētu un elastīgu būves procesu. Mēs izmantojam vienādus rīkus, lai veidotu jebkādus konteinerus ar pilnu versiju kontrole.
Kā darbojas mūsu būves procedūra
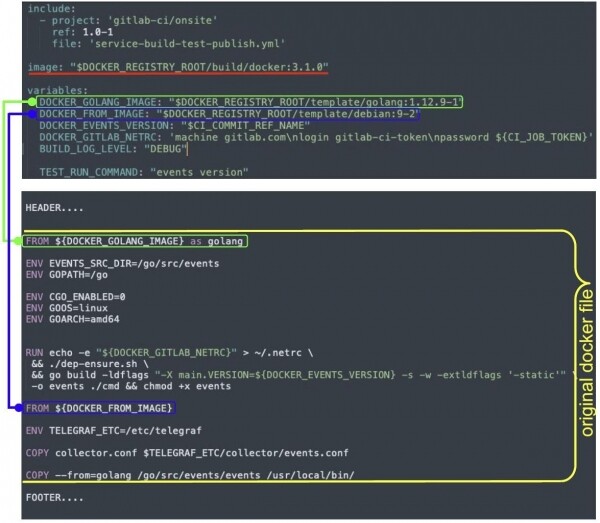
Savilka sākas ar vienu komandu, process tiek izpildīts attēlā (izcelts sarkanā krāsā). Izstrādātājam ir Docker fails (izcelts dzeltenā krāsā), kuru mēs renderējam, aizstājot mainīgos ar vērtībām. Un blakus pievienojam header’ī un footer’ī — tie ir mūsu aģenti.
Header pievieno izplatījumus no attiecīgajiem attēliem. Footer iekšpusē iestata mūsu pakalpojumus, konfigurē darba slodzes uzsākšanu, žurnālu veidošanu un citus aģentus, aizstāj entrypoint utt.
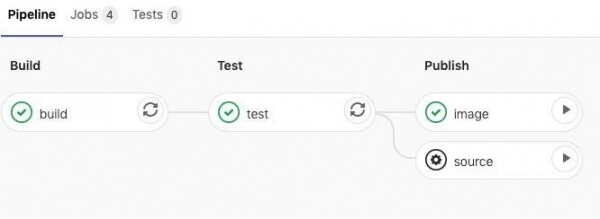
Mēs ilgi domājām, vai mums vajag supervizoru. Galu galā, mēs nolēmām, ka tas mums ir nepieciešams. Izvēlējāmies S6. Supervizors nodrošina konteineru pārvaldību: ļauj piekļūt tam, ja galvenais process sabrūk, un nodrošina manuālo konteineru pārvaldību bez tā atkārtotas izveides. Žurnāli un metrikas ir procesi, kas tiek izpildīti iekšpusē konteinerā. Tos arī ir jāuzrauga, un mēs to darām ar supervizoru. Visbeidzot, S6 uzņemas mājas pārvaldību, signālu apstrādi un citas prasmes.
Tā kā mēs izmantojam dažādas orķestrācijas sistēmas, pēc konteineru izstrādes un uzsākšanas tam ir jāizprot, kādā vidē tas atrodas, un jārīkojas atbilstoši situācijai. Piemēram:
Tas ļauj mums izveidot vienu attēlu un palaist to dažādās orķestrācijas sistēmās, turklāt tā uzsākšana notiks, ņemot vērā šīs orķestrācijas sistēmas specifiku.
Vienam un tam pašam konteineram mēs iegūstam dažādas procesu kokus Docker un Kubernetes:
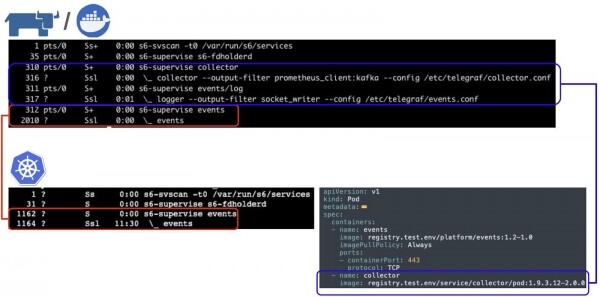
Noderīgā slodze tiek izpildīta supervizora S6 uzraudzībā. Lūdzu, pievērsiet uzmanību collector un events — tie ir mūsu aģenti, kas atbild par žurnāliem un metriku. Kubernetes tie nav, bet Docker ir. Kāpēc?
Ja paskatāmies uz «poda» specifikāciju (no šīs brīža — Kubernetes pod), tad redzam, ka konteineru events izpilda podā, kurā ir atsevišķs konteiner collector, kas veic metrikas un žurnālu vākšanas funkciju. Mēs varam izmantot Kubernetes iespējas: konteineru uzsākšanu vienā podā, vienotā procesu un/vai tīkla telpas ietvaros. Faktiski ieviest savus aģentus un veikt kādas funkcijas. Un, ja šis pats konteineris tiks uzsākts Docker, tas saņems visus tos pašus iespējas, t.i., varēs piegādāt žurnālus un metrikas, jo aģenti tiks uzsākti iekšpusē.
Metrikas un žurnāli
Metriku un žurnālu piegāde ir sarežģīta uzdevums. Ar šīs problēmas risināšanu saistīti vairāki aspekti.
Infrastruktūra tiek veidota, lai izpildītu noderīgu slodzi, nevis masveida žurnālu piegādi. Proti, šim procesam jānotiek ar minimālām prasībām pret konteineru resursiem. Mēs cenšamies palīdzēt mūsu izstrādātājiem: „Paņemiet Docker Hub konteineru, palaidiet to, un mēs varam piegādāt žurnālus.”
Otrais aspekts ir žurnālu apjoma ierobežojums. Ja vairākos konteineros notiek žurnālu apjoma pieaugums (lietojumprogramma ciklā izvada stack-trace), palielinās slodze uz CPU, sakaru kanāliem, žurnālu apstrādes sistēmu un tas ietekmē mākoņa resursu darbību kopumā un citus konteinerus mākoņā, dažreiz tas noved pie „mākoņa” kritiena.
Trešais aspekts ir nepieciešamība atbalstīt pēc iespējas vairāk metožu metrikas iegūšanai no kastes. No failu lasīšanas un Prometheus-endpoint uzraudzīšanas līdz specifisko lietojumprogrammu protokolu izmantošanai.
Un pēdējais aspekts ir nepieciešamība minimizēt resursu patēriņu.
Mēs izvēlējāmies atklātā koda risinājumu Go valodā ar nosaukumu Telegraf. Tas ir universāls savienotājs, kas atbalsta vairāk nekā 140 veidu ievades kanālus (input plugins) un 30 veidu izvades kanālus (output plugins). Mēs to esam pielāgojuši un tagad pastāstīsim, kā tas tiek izmantots pie mums Kubernetes piemēra ietvaros.
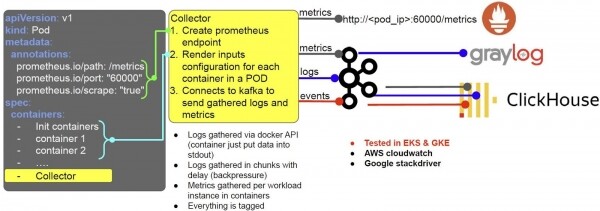
Pieņemsim, ka izstrādātājs izvieto slodzi, un Kubernetes saņem pieprasījumu izveidot podu. Šajā brīdī katram podam automātiski tiek izveidots konteiners ar nosaukumu Collector (mēs izmantojam mutācijas webhook). Collector ir mūsu aģents. Uzsākot darbu, šis konteiners konfigurē sevi darbam ar Prometheus un žurnālu vākšanas sistēmu.
- Tam viņš izmanto podu anotācijas, un atkarībā no tās satura izveido, teiksim, Prometheus end-point;
- Balstoties uz podu specifikāciju un konteineru specifiskajiem iestatījumiem, tiek nolemts, kā piegādāt žurnālus.
Žurnālus mēs ievācam, izmantojot Docker API: izstrādātājiem pietiek tos ievietot stdout vai stderr, un tālāk Collector visu izsistīs. Žurnāli tiek vākti chunk'os ar nelielu aizkavi, lai novērstu iespējamo mākoņa pārslodzi.
Metrikas tiek vākts pēc darba slodzes (procesu) instancēm konteineros. Viss tiek marķēts ar tagiem: namespace, pods utt., un pēc tam tiek konvertēts Prometheus formātā – un pieejams vākšanai (izņemot žurnālus). Tāpat žurnāli, metriki un notikumi tiek nosūtīti uz Kafka un tālāk:
- Žurnāli ir pieejami Graylog (vizuālai analīzei);
- Datu žurnāli, metrikas, notikumi tiek sūtīti uz Clickhouse ilgtermiņa glabāšanai.
Tieši tāpat tas darbojas AWS, tikai mēs aizstājām Graylog ar Kafka ar Cloudwatch. Sūtām tur žurnālus, un viss ir ļoti ērti: uzreiz skaidrs, kuram klasterim un konteineram tie pieder. Tas pats attiecas arī uz Google Stackdriver. Tātad mūsu shēma darbojas gan uz vietas ar Kafka, gan mākoņa vidē.
Ja mums nav Kubernetes ar podiem, shēma kļūst nedaudz sarežģītāka, bet darbojas pēc tiem pašiem principiem.
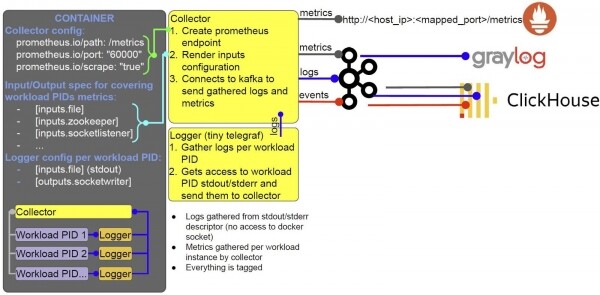
Kontejnerā tiek izpildīti tādi paši procesi, tie tiek orķestrēti, izmantojot S6. Visi tie paši procesi tiek palaisti iekšējā konteinerā.
Rezultātā
Mēs esam izveidojuši vienotu risinājumu attēlu izveidei un palaišanai ražošanā, ar metrikas vākšanas un žurnālu piegādes opcijām:
- Izstrādājām standartizētu pieeju attēlu veidošanai, uz kuras pamata izstrādājām CI veidnes;
- Datu vākšanas aģenti ir mūsu Telegraf paplašinājumi. Mēs tos labi pārbaudījām ražošanā;
- Izmantojam mutācijas webhook, lai ievadītu konteinerus ar aģentiem podos;
- Integrejamies Kubernetes/Rancher ekosistēmā;
- Mēs varam izpildīt identiskus konteinerus dažādās orķestrēšanas sistēmās un iegūt sagaidāmo rezultātu;
- Mēs esam izveidojuši pilnībā dinamisku konteineru vadības konfigurāciju.
Līdzautors: Ilja Prudņikovs
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish