

Kādas sajūtas jūs justu, ja kādu skaistu vasaras dienu datu centrs ar jūsu aprīkojumu izskatītos šādi?
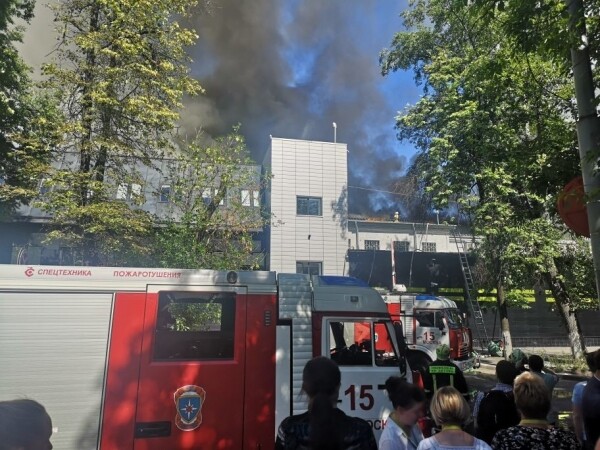
Sveiki visiem! Mani sauc Dmitrijs Samsonovs, es strādāju kā vadošais sistēmu administrators uzņēmumā “”. Attēlā ir viens no četriem datu centriem, kuros ir uzstādīts aprīkojums, kas apkalpo mūsu projektu. Aiz šīm sienām atrodas apmēram 4000 iekārtu: serveri, datu glabāšanas sistēmas, tīkla aprīkojums utt. – gandrīz ⅓ no visa mūsu aprīkojuma.
Lielākā daļa serveru ir Linux. Ir arī daži desmiti serveru uz Windows (MS SQL) – mūsu mantojums, no kura mēs pakāpeniski atsakāmies jau daudzus gadus.
Tātad, 2019. gada 5. jūnijā plkst. 14:35 inženieri vienā no mūsu datu centriem paziņoja par ugunsgrēka trauksmi.
Noraidījums
14:45. Sīki incidenti ar dūmiem datu centros notiek biežāk, nekā šķiet. Rādītāji iekšpusē bija normāli, tāpēc mūsu pirmā reakcija bija samērā mierīga: tika pieņemts lēmums aizliegt darbības ar produkciju, proti, veikt jebkādas konfigurācijas izmaiņas, izvērst jaunas versijas utt., izņemot darbus, kas saistīti ar defektu novēršanu.
Dusmas
Vai jūs kādreiz esat mēģinājuši uzzināt no ugunsdzēsējiem, kur tieši uz jumta noticis ugunsgrēks, vai arī mēģinājuši paši iekļūt degošajā jumtā, lai novērtētu situāciju? Kāda būs informācijas uzticība, kas iegūta caur pieciem cilvēkiem?
14:50. Saņemtā informācija liecina, ka uguns tuvojas dzesēšanas sistēmai. Bet vai tā tiešām sasniegs? Dežūrējošais sistēmu administrators izvada ārējo trafiku no šī datu centra frontēm.
Pašlaik visu mūsu pakalpojumu frontes ir dublētas trijos datu centros, izmanto DNS līmeņa līdzsvarošanu, kas ļauj izņemt viena datu centra adreses no DNS, tādējādi pasargājot lietotājus no potenciālām problēmām ar piekļuvi pakalpojumiem. Gadījumā, ja datu centrā jau ir radušās problēmas, tas automātiski izslēdzas no rotācijas. Vairāk var lasīt šeit:
Ugunsgrēks mūs līdz šim nav ietekmējis – ne lietotāji, ne aprīkojums nav cietuši. Vai tas ir negadījums? Pirmajā dokumenta “Rīcības plāns avārijas gadījumā” sadaļā ir sniegta definīcija jēdzienam “Negadījums”, un sadaļa beidzas ar:
«Ja ir šaubas, vai tas ir negadījums vai nē, tad tas ir negadījums!»
14:53. Notiek avārijas koordinatora ieceļšana.
Koordinators ir persona, kas kontrolē saziņu starp visiem dalībniekiem, novērtē avārijas apmērus, izmanto "Avārijas rīcības plānu", pieaicina nepieciešamo personālu, uzrauga remonta pabeigšanu un, pats galvenais, deleģē uzdevumus. Citiem vārdiem sakot, tā ir persona, kas vada visu avārijas likvidācijas procesu.
Tirdzniecība
15:01. Sākam atslēgt serverus, kas nav saistīti ar ražošanu.
15:03. Pareizi izslēdzam visus rezervētos pakalpojumus.
Šeit iekļaujas ne tikai priekšējie rāmji (uz kuriem šajā brīdī lietotāji vairs neiet), un to palīgpakalpojumi (biznesa loģika, kešatmiņas u.tml.), bet arī dažādas datubāzes ar replikācijas faktoru 2 un vairāk (, , , u.c.)
15:06. Saņemta informācija, ka ugunsgrēks apdraud vienu no datu centra zālēm. Šajā zālē mums nav aprīkojuma, bet tas, ka uguns var pārlekt no jumta uz zālēm, būtiski maina situāciju.
(Vēlāk noskaidrojās, ka fiziska apdraudējuma zālei nebija, jo tā ir hermētiski izolēta no jumta. Apdraudējums bija tikai šīs zāles dzesēšanas sistēmai.)
15:07. Atļaujam komandu izpildi serveros paātrinātā režīmā bez papildu pārbaudēm ().
15:08. Temperatūra zālēs ir normas robežās.
15:12. Konstatēta temperatūras paaugstināšanās zālēs.
15:13. Vairāk nekā puse serveru datu centrā ir izslēgti. Turpinām.
15:16. Pieņemts lēmums izslēgt visu aprīkojumu.
15:21. Sākam atslēgt barošanu uz stateless serveriem bez pareizas lietojumprogrammas un operētājsistēmas izslēgšanas.
15:23. Tiek izveidota atbildīgo grupa par MS SQL (tādā skaitā nav daudz, pakalpojumu atkarība no tiem nav liela, bet atjaunošanas procedūra ilgst vairāk laika un ir sarežģītāka nekā, piemēram, ar Cassandra).
Depresija
15:25. Saņemta informācija par barošanas izslēgšanu četrās zālēs no 16 (Nr.6, 7, 8, 9). 7. un 8. zālēs atrodas mūsu aprīkojums. Par divām citām mūsu zālēm (Nr.1 un 3) informācijas nav.
Parasti ugunsgrēka gadījumā elektroapgādi nekavējoties izslēdz, bet šajā gadījumā, pateicoties saskaņotai ugunsdzēsēju un datu centra tehniskā personāla darbībai, tas netika izdarīts visur un uzreiz, bet gan pēc nepieciešamības.
(Vēlāk noskaidrojās, ka barošana zālēs 8 un 9 nebija atslēgta.)
15:28. Sākam atjaunot MS SQL datu bāzes no dublējumiem citos datu centros.
Cik ilgs laiks būs nepieciešams tam? Vai tīkls visā maršrutā spēs nodrošināt pietiekamu caurlaidspēju?
15:37. Ir fiksēts, ka daži tīkla posmi ir atslēgti.
Menedžments un ražošanas tīkls ir fiziski izolēti viens no otra. Ja ražošanas tīkls ir pieejams, jūs varat piekļūt serverim, apturēt lietojumprogrammu un izslēgt operētājsistēmu. Ja tas nav pieejams, varat piekļūt caur IPMI, apturēt lietojumprogrammu un izslēgt operētājsistēmu. Ja nav neviena no tīkliem, jūs neko nevarat izdarīt. "Paldies, kapteini!", - domāsiet jūs.
"Un vispār, šeit ir diezgan liela rosība," - iespējams, domāsiet jūs.
Viss ir tā, ka serveri pat bez uguns rada milzīgu siltuma daudzumu. Precīzāk, kad ir dzesēšana, tie ģenerē siltumu, bet kad tā nav, tie radīs elles karstumu, kas labākajā gadījumā izkausēs daļu aprīkojuma un atslēgs citu daļu, bet sliktākajā gadījumā... izraisīs ugunsgrēku zālē, kas praktiski garantēti iznīcinās visu.
15:39. Fiksējam problēmas ar conf datu bāzi.
Conf datu bāze ir backend vienam un tam pašam pakalpojumam, ko izmanto visas ražošanas lietojumprogrammas, lai operatīvi mainītu iestatījumus. Bez šīs datu bāzes mēs nevaram pārvaldīt portāla darbību, bet pats portāls var darboties.
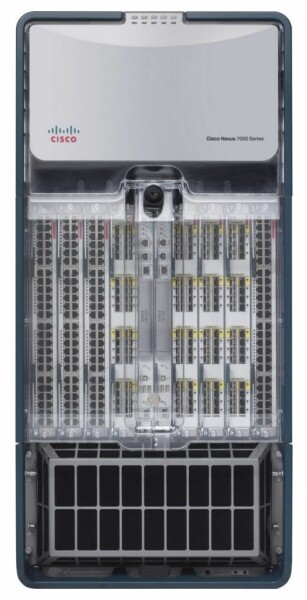
15:41. Temperatūras sensori Core tīkla aprīkojumā fiksē rādījumus, kas ir tuvu pieļaujamiem maksimumiem. Tā ir kastīte, kas aizņem visu stendu un nodrošina visu tīklu darbību datu centrā.
15:42. Problēmu izsekošanas rīks un wiki nav pieejami, pārslēdzamies uz rezerves režīmu.
Tas nav ražošana, bet avārijas gadījumā jebkuras zināšanu bāzes pieejamība var būt kritiska.
15:50. Viena no uzraudzības sistēmām ir atslēgta.
To ir vairākas, un tās atbild par dažādiem pakalpojumu darbības aspektiem. Dažas no tām ir konfigurētas patstāvīgai darbībai katrā datu centrā (t.i., tās uzrauga tikai savu datu centru), citas sastāv no izkliedētām sastāvdaļām, kas caurredzami iztur jebkura datu centra zudumu.
Šajā gadījumā pārstāja darboties , kas darbojas master-standby režīmā. Pārslēdzāmies uz rezerves režīmu.
Pieņemšana
15:51. Caurs IPMI izslēdzām visus serverus bez pareizas darbības pabeigšanas, izņemot MS SQL.
Vai esat gatavi masveida serveru pārvaldībai caur IPMI, ja nepieciešams?
Tā ir tā mirkļa, kad datu centra aprīkojuma glābšana šajā posmā ir pabeigta. Viss, ko varēja izdarīt, ir izdarīts. Daži kolēģi var atpūsties.
16:13. Ir saņemta informācija, ka uz jumta ir plīsušas dzesēšanas caurules – tas atliks datu centra palaišanu pēc ugunsgrēka novēršanas.
16:19. Saskaņā ar datiem, kas iegūti no datu centra tehniskā personāla, temperatūras paaugstināšanās zālēs ir apstājusies.
17:10. Ir atjaunota conf bāzes darbība. Tagad varam mainīt lietojumprogrammu iestatījumus.
Kāpēc tas ir tik svarīgi, ja viss ir uzticams un darbojas pat bez viena datu centra?
Pirmkārt, ne viss ir uzticams. Ir dažādas sekundārās pakalpojumu, kas pagaidām pietiekami labi nepiecieš datus no datu centra, un ir bāzes režīmā master-standby. Iespēja pārvaldīt iestatījumus ļauj veikt visu nepieciešamo, lai pat sarežģītajos apstākļos minimizētu negadījuma sekas uz lietotājiem.
Otrkārt, kļuva skaidrs, ka tuvākajās stundās datu centra darbība pilnībā netiks atjaunota, tādēļ bija nepieciešams veikt pasākumus, lai ilgstoša kopiju nepieejamība nenovestu pie papildu nepatikšanām, piemēram, disku pārpildīšanās atlikušajos datu centros.
17:29. Pica laiks! Mums strādā cilvēki, nevis roboti.
Rehabilitācija
18:02. Zālēs №№8 (mūsu), 9, 10 un 11 temperatūra ir stabilizējusies. Vienā no tām, kas paliek izslēgtas (№7), atrodas mūsu aprīkojums, un temperatūra tur joprojām turpina pieaugt.
18:31. Ir doti zaļo gaismu iekārtu palaišanai zālēs №№1 un 3 – šīs zāles ugunsgrēks nav skāris.
Šobrīd tiek uzsākta serveru palaišana zālēs №№1, 3, 8, sākot ar viskritiskākajiem. Tiek pārbaudīta visu palaisto pakalpojumu darbība. Joprojām ir problēmas ar zāli №7.
18:44. Datu centra tehniskā personāls konstatēja, ka zālē №7 (kur atrodas tikai mūsu aprīkojums) daudzi serveri nav izslēgti. Saskaņā ar mūsu datiem, tur paliek ieslēgti 26 serveri. Pēc atkārtotas pārbaudes atklājam 58 serverus.
20:18. Datu centra tehniskā personāls pūš gaisu zālē bez kondicionēšanas caur mobilajiem ventilācijas kanāliem, kas novietoti cauri koridoriem.
23:08. Pirmo administratoru atlaida mājās. Kādam nakts laikā jāatpūšas, lai rīt turpinātu darbus. Tālāk atlaides vēl daļa administratoru un izstrādātāju.
02:56. Esam palaiduši visu, ko varējām palaist. Veicam plašu visu pakalpojumu pārbaudi ar automatizētajiem testiem.
03:02. Kondicionēšana pēdējā, 7. zālē ir atjaunota.
03:36. Esam aktivizējuši frontus datu centrā DNS rotācijā. No šī brīža sāk ienākt lietotāju datplūsma.
Atlaidu lielāko daļu administratoru mājās. Bet dažus cilvēkus atstājam.
Neliels FAQ:
Q: Kas notika no 18:31 līdz 02:56?
A: Sekojot „Rīcības plānam avārijas gadījumā”, mēs palaidām visus pakalpojumus, sākot ar vissvarīgākajiem. Šajā procesā koordinators čatā piešķir pakalpojumu brīvajam administratoram, kurš pārbauda, vai OS un lietojumprogramma ir palaistas, vai nav kļūdu, un vai rādītāji ir normā.
Process papildus kavējas dēļ izslēgtiem dzelžiem. Pat ja OS apturēšana un serveru izslēgšana noritēja pareizi, daļa serveru neatgriežas dēļ pēkšņi atteikušiem diskiem, atmiņai, šasijai. Elektrības samazināšanās gadījumā atteikumu procents palielinās.
Q: Kāpēc nevar vienkārši palaist visu uzreiz un pēc tam labot to, kas parādīsies.monitoringā?
A: Viss jādara pakāpeniski, jo starp pakalpojumiem ir atkarības. Un visam jāpārbauda uzreiz, negaidot monitoringu — jo ar problēmām labāk tikt galā uzreiz, negaidot, kad tās pasliktinās.
7:40. Pēdējais admins (koordinators) gāju gulēt. Pirmā diena pabeigta.
8:09. Pirmie izstrādātāji, inženieri datu centros un administratori (ieskaitot jauno koordinātoru) uzsāk atjaunošanas darbus.
09:37. Sākuši celtniecību 7. zālē (pēdējā).
Vienlaikus turpinām atjaunot to, ko neesam pabeiguši citās zālēs: disku/atmiņas/serveru nomaiņa, visu, kas "deg" monitoringā, remonts, lomu atpakaļ pārslēgšana master-standby shēmās un citas sīkumi, kuru tomēr ir pietiekami daudz.
17:08. Atļaujam visus parastās darbības ar produkciju.
21:45. Otrās dienas darbi pabeigti.
09:45. Šodien ir piektdiena. Monitoringā joprojām ir daudz sīku problēmu. Priekšā ir brīvdienas, visiem gribas atpūsties. Turpinām masveidā labot visu, ko var. Štatiskās administratīvās uzdevumi, kurus varēja atlikt, ir atlikti. Ir jauns koordinators.
15:40. Negaidīti restartējās puse no Core tīkla aprīkojuma kā citā datu centrā. No rotācijas tika izņemti priekšējie, lai samazinātu riskus. Ietekmes lietotājiem nav. Vēlāk noskaidrojās, ka tā bija bojāta šasija. Koordinators tagad strādā pie divu avāriju labojuma.
17:17. Tīkla darbība citā datu centrā ir atjaunota, viss ir pārbaudīts. Datu centrs ir ieviests rotācijā.
18:29. Trešo dienu darbs, un kopumā avārijas atjaunošana ir pabeigta.
Pēcvārds
04.04.2013. , "Odnoklassniki" — trīs dienas portāls bija pilnībā vai daļēji nepieejams. Visa šī laika gaitā vairāk nekā 100 cilvēki no dažādām pilsētām, no dažādām firmām (vēlreiz liels paldies!), attālināti un tieši datu centros, manuāli un automātiski laboja tūkstošiem serveru.
Mēs esam izdarījuši secinājumus. Lai šādas situācijas neatkārtotos, mēs veicām un turpina veikt plašus darbus.
Kādas ir galvenās atšķirības starp pašreizējo avāriju un 404?
- Mums ir izstrādāts "Avārijas rīcības plāns". Reizi ceturksnī mēs veicam mācības - lomu spēlējam avārijas situāciju, ko grupai administratoru (visi pa kārtām) ir jānovērš, izmantojot "Avārijas rīcības plānu". Galvenie sistēmu administratori pa kārtai iepazīstas ar koordinatora lomu.
- Ceturkšņa testēšanas režīmā izolējam datu centrus (visus pa kārtām) pa LAN un WAN tīklu, kas ļauj laikus identificēt vājās vietas.
- Mazāk sabojātu disku, jo mēs esam pastiprinājuši standartus: mazāks darba laiks, stingrāki S.M.A.R.T. sliekšņi.
- Pilnībā atteicāmies no BerkeleyDB — vecā un nestabilā datu bāze, kurai bija nepieciešams daudz laika, lai atjaunotu servera restartēšanas gadījumā.
- Samazinājām serveru skaitu ar MS SQL un samazinājām atkarību no atlikušajiem.
- Mums ir parādījies mūsu , uz kuru mēs jau divus gadus aktīvi migrējam visus pakalpojumus. Mākonis ievērojami atvieglo visu darba ciklu ar lietojumprogrammu, un avārijas gadījumā sniedz tādas unikālas rīkus kā:
- vienkārša visu lietojumu apturēšana ar vienu klikšķi;
- vienkārša lietojumu migrācija no neveiksmīgajiem serveriem;
- automātisks reģistrēts (pēc prioritātes) visa datu centrāla palaišana.
Avarija, par kuru rakstīts šajā rakstā, bija lielākā kopš 404. Numura. Protams, ne viss notika gludi. Piemēram, datu centra ugunsgrēka dēļ citā datu centrā viens no serveru diskajiem izjuka, tādējādi palika pieejama tikai viena no trim kopijām Cassandra klasterī, kā rezultātā 4,2% mobilās lietojumprogrammas lietotāju nevarēja pieteikties. Tajā pašā laikā jau pieslēgtie lietotāji turpināja strādāt. Kopumā pēc avārijas rezultātiem tika konstatētas vairāk nekā 30 problēmas — no vienkāršiem defektiem līdz pakalpojumu arhitektūras trūkumam.
Bet vissvarīgākā atšķirība starp pašreizējo avāriju un 404. ir tā, ka, kamēr mēs novēršam ugunsgrēka sekas, lietotāji turpināja sūtīt ziņojumus un veikt video zvanus , spēlēja spēles, klausījās mūziku, dāvināja viens otram dāvanas, skatījās video, seriālus un TV kanālus , kā arī straumēja .
Kā ir ar jūsu avārijām?
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish