

CAP teorija ir pamatakmens teorijas par izkliedētajām sistēmām. Protams, strīdi ap to nebeidzas: definīcijas nav kanoniskas, un stingra pierādījuma nav... Tomēr, stingri nostājušies ikdienas veselā saprāta pozīcijās™, mēs intuitīvi saprotam, ka teorija ir patiess.
Vienīgais, kas nav acīmredzams, ir burtu «P» nozīme. Kad klasteris sadalās, tas izlemj - vai nu neatsaukties, kamēr nav sasniegts kvórums, vai arī sniegt pieejamos datus. Atkarībā no šī lēmuma rezultātiem sistēma tiek klasificēta vai nu kā CP, vai kā AP. Cassandra, piemēram, var uzvesties gan tā, gan tā, atkarībā ne tikai no klastera iestatījumiem, bet arī no katra konkrētā pieprasījuma parametriem. Bet, ja sistēma nav «P», un tā ir sadalījusies, tad - kas notiek?
Atbilde uz šo jautājumu ir nedaudz negaidīta: CA klasteris nevar sadalīties.
Kas tad ir šis klasteris, kas nespēj sadalīties?
Nepārtraukts šāda klastera atribūts ir kopēja datu glabāšanas sistēma. Lielākajā daļā gadījumu tas nozīmē savienojumu caur SAN, kas ierobežo CA risinājumu lietošanu lielos uzņēmumos, kas spēj uzturēt SAN infrastruktūru. Lai vairāki serveriem varētu strādāt ar vieniem un tiem pašiem datiem, nepieciešama klastera failu sistēma. Šādas failu sistēmas ir HPE (CFS), Veritas (VxCFS) un IBM (GPFS) portfelī.
Oracle RAC
Real Application Cluster opcija pirmo reizi parādījās 2001. gadā Oracle 9i izlaišanā. Šādā klasterī vairāki instanti serveris strādā ar to pašu datu bāzi.
Oracle var strādāt gan ar klastera failu sistēmu, gan ar savu risinājumu - ASM, Automatic Storage Management.
Katrs instants uztur savu žurnālu. Transakcija tiek izpildīta un fiksēta vienā instanē. Gadījumā, ja kādam instantam ir kļūme, viens no izdzīvojušajiem klastera mezgliem (instantiem) nolasīs tā žurnālu un atjaunos zaudētos datus - tādējādi tiek nodrošināta pieejamība.
Visi instanti uztur savu kešu, un vienas un tās pašas lapas (bloki) var atrasties vienlaikus vairāku instantu kešos. Turklāt, ja kādai instansei ir nepieciešama kāda lapa, un tā ir cita instanta kešā, viņš var to saņemt no "kaimiņa", izmantojot cache fusion mehānismu, nevis nolasot no diska.
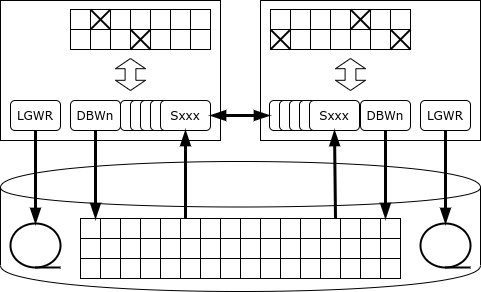
Bet kas notiks, ja kādai no instancēm būs nepieciešams mainīt datus?
Oracle iezīme ir tā, ka tam nav atsevišķas bloķēšanas servisa: ja servers vēlas bloķēt rindu, tad bloķēšanas ieraksts tiek veikts tieši tajā atmiņas lapā, kur atrodas bloķētā rinda. Šāda pieeja padara Oracle par veiktspējas čempionu monolītās datubāzēs: bloķēšanas serviss nekad nenoliedz sevi par šauru vietu. Tomēr klastera konfigurācijā šāda arhitektūra var novest pie intensīvas datu apmaiņas un savstarpējām bloķēšanām.
Kad ieraksts ir bloķēts, instanse paziņo visām citām instancēm, ka lapa, kurā glabājas šis ieraksts, ir ieņemta monopolā režīmā. Ja citai instancei būs nepieciešams mainīt ierakstu tajā pašā lapā, tai jāgaida, kamēr izmaiņas lapā netiks fiksētas, t.i., informācija par izmaiņu nav ierakstīta žurnālā diskā (šajā procesā darījums var turpināties). Var arī gadīties, ka lapu secīgi maina vairākas instances, un tad, ierakstot lapu diskā, būs jāsaprot, kam pieder aktuālā versija šīs lapas.
Sakritīgas atjaunināšanas uz tām pašām lapām caur dažādiem RAC mezgliem noved pie būtiska datubāzes veiktspējas samazinājuma – līdz tam, ka klastera veiktspēja var būt zemāka nekā vienai instancē.
Pareiza Oracle RAC izmantošana ir fiziska datu dalīšana (piemēram, izmantojot sekciju tabulu mehānismu) un piekļuve katrai sekciju grupai caur atsevišķu mezglu. Galvenais RAC uzdevums nav horizontālā mērogošana, bet nodrošināt pieejamību bez traucējumiem.
Ja mezgls pārstāj reaģēt uz heartbeatu, tad pirmais mezgls, kas to atklāja, uzsāk balsošanas procedūru diskā. Ja arī šeit pazudušais mezgls neatzīmējas, tad viens no mezgliem uzņem datu atjaunošanas pienākumus:
- «sasalst» visas lapas, kas atradās pazudušā mezgla kešatmiņā;
- izlasa pazudušā mezgla žurnālus (redo) un atkārtoti piemēro izmaiņas, kas reģistrētas šajos žurnālos, vienlaikus pārbaudot, vai citiem mezgliem nav jaunāku versiju maināmajām lapām.
- atsaka nepabeigtas darījumus.
Lai atvieglotu pārslēgšanos starp mezgliem, Oracle izmanto pakalpojuma jēdzienu - virtuālu instance. Instance var apkalpot vairākus pakalpojumus, un pakalpojums var pārvietoties starp mezgliem. Lietojumprogramma, kas apkalpo noteiktu datu bāzes daļu (piemēram, klientu grupu), darbojas ar vienu pakalpojumu, un pakalpojums, kas atbild par šo datu bāzes daļu, kad mezgls izkrīt, pārvietojas uz citu mezglu.
IBM Pure Data Systems for Transactions
Klāsteru risinājums datu bāzēm parādījās Zilā Giganta portfelī 2009. gadā. Ideoloģiski tas ir Parallel Sysplex klastera mantinieks, kas balstīts uz "parastajām" iekārtām. 2009. gadā tika laists tirgū produkts DB2 pureScale, kas sastāv no programmatūras komplekta, bet 2012. gadā IBM piedāvā programmatūras un aparatūras komplektu (appliance) ar nosaukumu Pure Data Systems for Transactions. Nevajag confundēt to ar Pure Data Systems for Analytics, kas ir nekas cits kā pārdēvēts Netezza.
pureScale arhitektūra pirmā acu uzmetiena izskatās līdzīga Oracle RAC: tāpat vairākas mezgli ir pieslēgti kopējai datu glabāšanas sistēmai, un katrā mezglā darbojas sava datu bāzes instance ar savām atmiņas jomām un darījumu žurnāliem. Taču, atšķirībā no Oracle, DB2 ir specializēts bloķēšanas pakalpojums, ko pārstāv procesu komplekts db2LLM*. Klāsteru konfigurācijā šis pakalpojums tiek izvietots atsevišķā mezglā, kas Parallel Sysplex tiek dēvēts par coupling facility (CF), bet Pure Data – PowerHA.
PowerHA nodrošina sekojošus pakalpojumus:
- bloķēšanas menedžeris;
- globālais buferu kešs;
- starpprocessu komunikāciju zona.
Lai pārsūtītu datus no PowerHA uz datu bāzes mezgliem un otrādi, tiek izmantota attālinātā piekļuve atmiņai, tādēļ klāsteru interkonekcijai jāatbalsta RDMA protokols. PureScale var izmantot gan Infiniband, gan RDMA over Ethernet.
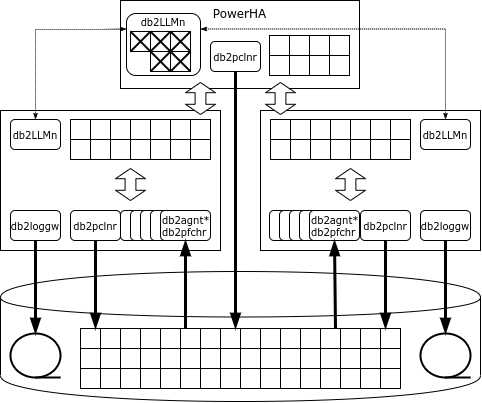
Ja mezglam nepieciešama lapa, un šīs lapas nav kešā, tad mezgls pieprasa lapu globālajā kešā, un tikai tad, ja arī tur tās nav, to lasa no diska. Atšķirībā no Oracle, pieprasījums notiek tikai uz PowerHA, nevis uz blakus esošajiem mezgliem.
Ja, kad instance plāno mainīt rindu, tā to bloķē ekskluzīvā režīmā, bet lapu, kur atrodas rinda, – koplietošanas režīmā. Visas bloķēšanas tiek reģistrētas globālajā bloķēšanas pārvaldniekā. Kad darījums ir pabeigts, mezgls nosūta ziņojumu bloķēšanas pārvaldniekam, kurš kopē mainīto lapu globālajā kešatmiņā, noņem bloķēšanas un invalidē mainīto lapu citu mezglu kešatmiņās.
Ja lapa, kurā atrodas maināmā rinda, jau ir bloķēta, bloķēšanas pārvaldnieks izlasīs mainīto lapu no mezgla atmiņas, kas veica izmaiņas, noņems bloķēšanu, invalidēs mainīto lapu citu mezglu kešatmiņās un atdos lapas bloķēšanu mezglam, kurš to pieprasījis.
«Netīrie», tas ir, mainītie, lapas var tikt ierakstītas diskā gan no parastā mezgla, gan no PowerHA (izsist).
Ja viens no mezgliem pureScale atteikšanās gadījumā atjaunošana ir ierobežota tikai ar tām transakcijām, kas brīža kad katastrofa vēl nav pabeigtas: lapas, ko mainījis šis mezgls pabeigtajās transakcijās, ir globālajā kešatmiņā uz PowerHA. Mezgls tiek restartēts samazinātā konfigurācijā uz viena no klastera serveriem, atsauc neizpildītās transakcijas un atbrīvo bloķēšanas.
PowerHA darbojas uz diviem serveriem, un galvenais mezgls sinhroni replikē savu stāvokli. Ja galvenais mezgls atteicas, PowerHA klasteris turpina darbu ar rezerves mezglu.
Protams, ja piekļūstat datu kopai caur vienu mezglu, kopējā klastera veiktspēja būs augstāka. PureScale pat var pamanīt, ka noteikta datu zona tiek apstrādāta no viena mezgla, un tad visas bloķēšanas, kas attiecas uz šo zonu, tiks apstrādātas lokāli, netērējot resursus komunikācijai ar PowerHA. Bet, tiklīdz programma mēģina piekļūt šiem datiem caur citu mezglu, centralizētā bloķēšanas apstrāde atsāksies.
IBM iekšējie slodzes testi, kuru sastāvs ir 90% lasīšanas un 10% rakstīšanas, kas ļoti līdzinās reālām rūpnieciskajām slodzēm, parāda gandrīz lineāru mērogojamību līdz 128 mezgliem. Testēšanas apstākļi, diemžēl, netiek atklāti.
HPE NonStop SQL
Savā augsti pieejamā platformā ir arī Hewlett-Packard Enterprise portfelī. Tā ir NonStop platforma, kas tirgū laista 1976. gadā uzņēmuma Tandem Computers. 1997. gadā uzņēmums tika uzpirkts no Compaq, kas savukārt 2002. gadā apvienojās ar Hewlett-Packard.
NonStop tiek izmantots kritisko lietojumprogrammu izveidē - piemēram, HLR vai bankas karšu apstrādei. Platforma tiek piedāvāta kā programmatūras un aparatūras komplekss (appliance), kas ietver izsniegšanas mezglus, datu glabāšanas sistēmu un sakaru aprīkojumu. ServerNet tīkls (mūsdienu sistēmās - Infiniband) kalpo gan mezglu mijiedarbībai, gan piekļuvei datu glabāšanas sistēmai.
Agrākajās sistēmas versijās tika izmantoti proprietārie procesori, kas tika sinhronizēti savā starpā: visas operācijas tika izpildītas sinhroni ar vairākiem procesoriem, un, tiklīdz viens no procesoriem kļūdījās, tas tika izslēgts, bet otrais turpināja darbu. Vēlāk sistēma pārgāja uz parastajiem procesoriem (vispirms MIPS, pēc tam Itanium un visbeidzot x86), un sinhronizācijai tika izmantoti citi mehānismi:
- ziņojumi: katram sistēmas procesam ir dublikāts-„ēna”, kuram aktīvais process periodiski nosūta ziņojumus par savu stāvokli; ja galvenais process neizdodas, ēnas process sāk darbu no brīža, ko noteicis pēdējais ziņojums;
- balsošana: datu glabāšanas sistēmai ir īpaša aparatūras komponents, kas pieņem vairākus vienādus pieprasījumus un tos izpilda tikai gadījumā, ja pieprasījumi sakrīt; fiziskās sinhronizācijas vietā procesori darbojas asinkroni, un to darba rezultāti tiek salīdzināti tikai ievades/izvades brīžos.
Sākot no 1987. gada, uz NonStop platformas darbojas relāciju datu bāze - vispirms SQL/MP, bet vēlāk - SQL/MX.
Visa datu bāze tiek sadalīta daļās, un katra daļa pieder konkrētam Datu piekļuves pārvaldniekam (DAM). Tas nodrošina datu ierakstīšanu, kešatmiņu un bloķēšanas mehānismu. Datu apstrādi veic izpildproti (Executor Server Process), kas darbojas tajos pašos mezglos, kur arī attiecīgie datu pārvaldnieki. SQL/MX plānotājs sadala uzdevumus starp izpildītājiem un apvieno rezultātus. Ja nepieciešams veikt saskaņotus labojumus, tiek izmantots divfāžu apstiprināšanas protokols, ko nodrošina TMF (Transaction Management Facility) bibliotēka.
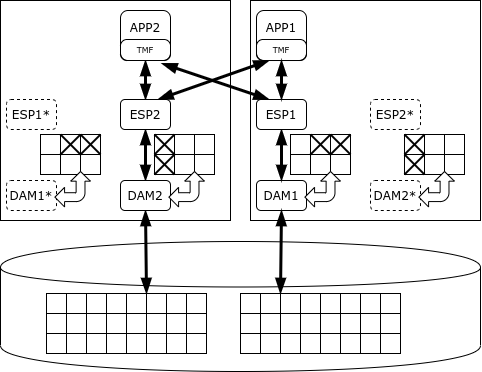
NonStop SQL spēj prioritizēt procesus tā, lai garie analītiskie vaicājumi netraucētu darījumu izpildei. Tomēr tās galvenā funkcija ir tieši īsu darījumu apstrāde, nevis analīze. Izstrādātājs garantē NonStop klastera pieejamību līmenī pieci «devītnieki», t.i., dīkstāve ir tikai 5 minūtes gadā.
SAP HANA
Pirmais stabilais HANA DB izlaišanas (1.0) datums bija 2010. gada novembris, savukārt SAP ERP pakotne pārgāja uz HANA no 2013. gada maija. Platforma balstās uz iegādātām tehnoloģijām: TREX meklētājs (kolonnu glabāšanas meklēšana), P*TIME DB un MAX DB.
Pats vārds «HANA» ir akronīms, kas nozīmē High performance ANalytical Appliance. Šī DB tiek piegādāta kā kods, kas var darboties uz jebkuriem x86 serveriem, taču rūpnieciskās instalācijas ir atļautas tikai sertificētajā aprīkojumā. Ir pieejami risinājumi no HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Dažas Lenovo konfigurācijas pat ļauj darbināt bez SAN – kopīga glabāšana tiek nodrošināta ar GPFS klasteri uz vietējiem diskiem.
Atšķirībā no iepriekš minētajām platformām, HANA ir atmiņas DB, t.i., primārais datu attēls tiek glabāts operatīvajā atmiņā, bet tikai žurnāli un periodiski attēli tiek ierakstīti diskā – avārijas gadījumā atjaunošanai.
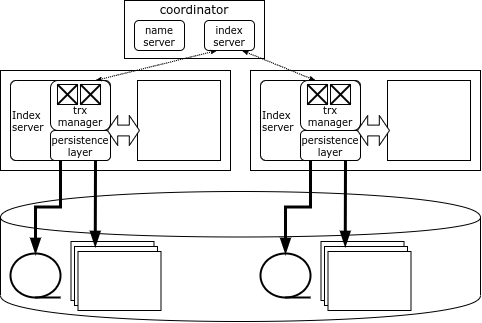
Katrs HANA klastera mezgls atbild par savu datu daļu, un datu karte tiek glabāta īpašā komponentē – Nosaukumu serverī, kas atrodas koordinējošajā mezglā. Dati starp mezgliem netiek dublēti. Informācija par bloķēšanu arī tiek glabāta katrā mezglā, taču sistēmā ir globāls savstarpējo bloķēšanu detektors.
HANA klients, izveidojot savienojumu ar klasteri, ielādē tā topoloģiju un vēlāk var tieši piekļūt jebkuram mezglam, atkarībā no tā, kādi dati tam nepieciešami. Ja darījums attiecas uz viena mezgla datiem, to var izpildīt šis mezgls lokāli, taču, ja tiek mainīti vairāku mezglu dati, iniciatīvas mezgls vēršas pie koordinējošā mezgla, kurš atver un koordinē izplatīto darījumu, to fiksējot, izmantojot optimizētu divfāzu fiksācijas protokolu.
Koordinējošais mezgls ir dublēts, tāpēc, ja koordinators iznāk no ierindas, nekavējoties darboties sāk rezerves mezgls. Ja neizdodas mezgls ar datiem, vienīgais veids, kā piekļūt viņa datiem, ir restartēt mezglu. Parasti HANA klasteros ir rezerves (spare) serveris, lai pēc iespējas ātrāk restartētu zaudēto mezglu.
Avots: habr.com
