

Sveiki, esmu Dmitrijs Logvinenko — datu inženieru grupas "Veza" analītikas nodaļā.
Es jums pastāstīšu par brīnišķīgu rīku ETL procesu izstrādei — Apache Airflow. Bet Airflow ir tik universāls un daudzdimensionāls, ka tam jāpiegriež uzmanība pat tad, ja jūs nenodarbojaties ar datu plūsmām, bet jums ir nepieciešams periodiski uzsākt kādus procesus un sekot to izpildei.
Un jā, es ne tikai stāstīšu, bet arī rādīšu: programmā ir daudz koda, ekrānšāviņu un ieteikumu.
Ko parasti redzi, kad meklē vārdu Airflow / Wikimedia Commons
Saturs
Ievads
Apache Airflow — tas ir tieši kā Django:
- rakstīts Python valodā,
- ir lieliska administratora saskarne,
- neierobežoti paplašināms,
— tikai labāks, un izveidots pavisam citiem mērķiem, proti (kā rakstīts pirms koda):
- uzdevumu izpilde un uzraudzība neierobežotā skaitā mašīnās (cik vien atļaus Celery/Kubernetes un jūsu sirdsapziņa)
- ar dinamisku darba plūsmu ģenerēšanu no ļoti viegli rakstāma un uztverama Python koda
- un iespēju savienot savā starpā jebkuras datu bāzes un API, izmantojot kā gatavus komponentus, tā pašmāju spraudņus (kas ir ļoti vienkārši izdarāms).
Mēs izmantojam Apache Airflow šādi:
- savācam datus no dažādiem avotiem (daudz SQL Server un PostgreSQL instanču, dažādi API ar lietojumprogrammu metriku, pat 1C) DWH un ODS (mums tas ir Vertica un Clickhouse).
- kā uzlabotu
cron, kas uzsāk datu konsolidācijas procesus ODS, kā arī seko to apkalpei.
Līdz nesenam laikam mūsu vajadzības apmierināja viens neliels serveris ar 32 kodoliem un 50 GB operatīvajā atmiņā. Airflow šajā laikā darbojas:
- vairāk nekā 200 dagu (pati workflows, kurās mēs esam iekļāvuši uzdevumus),
- katrā vidēji pa 70 uzdevumiem,
- šis labums tiek palaists (tāpat vidēji) reizi stundā.
Un par to, kā mēs paplašinājāmies, es rakstīšu zemāk, bet tagad definēsim über-uzdevumu, kuru mēs risināsim:
Ir ir trīs SQL Server instances, katrā pa 50 datubāzēm — viena projekta instances, līdz ar to to struktūra ir vienāda (gandrīz visur, muahahah), un tāpēc katrā ir tabula Orders (par laimi tabulu ar šādu nosaukumu var ievietot jebkurā biznesā). Mēs ņemam datus, pievienojot palīglaikus (avota serveris, avota datubāze, ETL uzdevuma identifikators) un naivi izmest tos, teiksim, Vertica.
Aiziet!
Pamatdaļa, praktiskā (un mazliet teorētiskā)
Kāpēc tas mums (un jums)
Kad koki bija lieli, bet es biju parasts SQL-šāvējs vienā Krievijas mazumtirdzniecībā, mēs strādājām ar ETL procesiem, kas ir datu plūsmu, ar diviem pieejamajiem rīkiem:
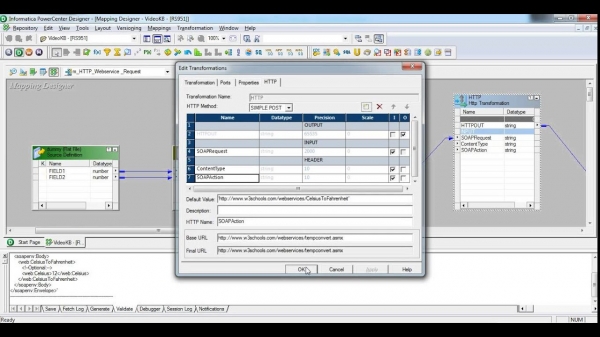
- Informatica Power Center — ārkārtīgi plaša sistēma, ļoti jaudīga, ar savām aparatūrām, pašu versiju vadību. Es izmantoju, cerams, 1% tās iespēju. Kāpēc? Nu, pirmajā kārtā, šis interfeiss ir kaut kur no nulles, psiholoģiski mūs spieda. Otrajā kārtā, šī lieta ir piemērota ļoti sarežģītiem procesiem, asi pārstrādāt komponentus un citām ļoti svarīgām korporatīvajām funkcijām. Par to, cik tā maksā, mēs klusēsim, kā Airbus A380/gads.
Uzmanību, ekrānšāviņš var būt nedaudz sāpīgs cilvēkiem līdz 30 gadiem

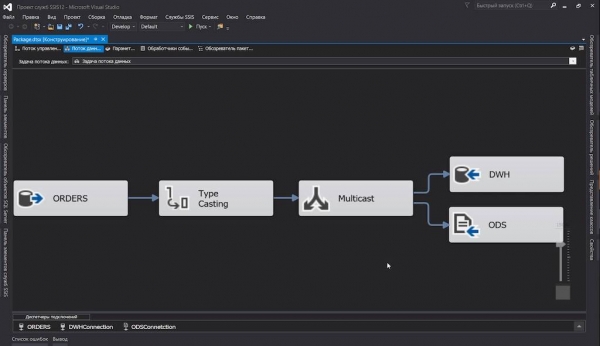
- SQL Server Integration Server — šo rīku mēs izmantojām savos iekšējos projektos. Nu, patiesībā: SQL Server jau tiek izmantots, un nebūtu prātīgi neizmanto ETL rīkus. Viss ir labā stāvoklī: gan interfeiss ir skaists, gan izpildes ziņojumi… Bet ne jau par to mēs mīlam programmatūras produktus, ak, ne jau par to. Versijām varam vadīt
dtsx(kas ir XML ar sajauktām mezgliem saglabāšanas laikā), mēs varam, bet kas no tā? Vai izveidot uzdevumu kopu, kas pārvietos simtiem tabulu no vienas servera uz citu? Jā, kas no simts tabulām, jūsu rādītājs pirksts no kritīs nost, klikšķinot ar peli. Bet izskatās tas noteikti modernāk:
Mēs noteikti meklējām risinājumus. Pat gandrīz aizgājām līdz pašrakstīta SSIS pakotņu ģeneratoram...
… un tad mani atrada jauna darba vieta. Un tajā mani satika Apache Airflow.
Kad uzzināju, ka ETL procesu apraksti ir vienkāršs Python kods, es teju vai nedejoju no prieka. Tā, datu plūsmas tika pakļautas versiju kontrolei un difūzijai, un metot tabulas ar vienotu struktūru no simts datubāzēm vienā mērķī kļuva Python koda jautājums pusotru - divus 13" ekrānus.
Sagatavojam klasteri
Nē, nevajag izveidot bērnu dārzu un runāt par pilnīgi acīmredzamām lietām, piemēram, Airflow uzstādīšanu, jūsu izvēlēto datubāzi, Celery un citiem jautājumiem, kas aprakstīti dokumentācijā.
Lai mēs varētu uzreiz sākt eksperimentus, es esmu izveidojis. docker-compose.yml kur:
- Paceļam pašu Airflow: Scheduler, Webserver. Tur darbosies arī Flower, lai uzraudzītu Celery uzdevumus (jo tas jau ir iekļauts
apache/airflow:1.10.10-python3.7, un mēs to neiebilstam); - PostgreSQL, kur Airflow ierakstīs savu administratīvo informāciju (plānotāja dati, izpildes statistika utt.), bet Celery — atzīmēs pabeigtos uzdevumus;
- Redis, kas būs uzdevumu brokeris Celery;
- Celery darbinieks, kas īstenos konkrētos uzdevumus.
- Katalogā
.\/dagsmēs ievietosim savus failus ar dagu aprakstiem. Tie tiks automātiski nolasīti, tāpēc nav nepieciešams pārstartēt visu sistēmu pēc katras niecības.
Dažviet piemēros kods nav pilnībā sniegts (lai nesabojātu tekstu), bet dažās vietās tas tiek mainīts procesa gaitā. Darbojošos kode piemērus var apskatīt repozitorijā. .
docker-compose.yml
version: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis as a Celery broker
  broker:
    image: redis:6.0.5-alpine

  # DB for the Airflow metadata
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Main container with Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, will be scaled using `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Piezīmes:
- Kompozīcijas izveidē es lielā mērā balstījos uz labi zināmo tēlu – noteikti apskatiet. Varbūt jums dzīvē nekas vairāk arī nevajadzēs.
- Visas Airflow iestatījumu opcijas ir pieejamas ne tikai caur
airflow.cfg, bet arī caur vides mainīgajiem (paldies izstrādātājiem), ko es zlotski izmantoju. - Protams, tas nav piemērots ražošanas vajadzībām: es apzināti neesmu uzstādījis heartbeat uz konteineriem, neesmu uztraucies par drošību. Tomēr minimums, kas der mūsu eksperimentiem, ir izveidots.
- Lūdzu, ņemiet vērā, ka:
- DAG mapei jābūt pieejamai gan plānotājam, gan darbiniekiem.
- Tas pats attiecas uz visām trešo pušu bibliotēkām - tām visām jābūt uzstādītām uz mašīnām ar plānotāju un darbiniekiem.
Un tagad vienkārši:
$ docker-compose up --scale worker=3Pēc tam, kad viss tiks palaists, var skatīties uz tīmekļa saskarnēm:
- Airflow:
- Flower:
Pamatjēdzieni
Ja, ja neesat sapratuši, par ko ir runa šajos "dagos", tad šeit ir īss vārdnīca:
- Scheduler — galvenais cilvēks Airflow, kurš uzrauga, lai strādātu roboti, nevis cilvēki: viņš uzrauga grafikus, atjaunina dagus, uzsāk uzdevumus.
Patiesībā, vecākajās versijās bija problēmas ar atmiņu (nē, ne amnēzija, bet noplūdes) un konfigurācijās palika pat imuno parametru
run_duration— tā ir intervāls tā atkārtotai iedarbināšanai. Bet tagad viss ir kārtībā. - DAG (tā arī "dag") — "virziena necilvēcīgs grafiks", bet šāds definējums maz ko teiks, bet patiesībā tas ir konteiners savstarpēji saistītu uzdevumu (sk. zemāk) vai analoģija pakotnei SSIS un Workflow Informatica.
Papildus dagiem var būt arī subdagas, bet mēs, visticamāk, pie tām nenonāksim.
- DAG Run — inicializēts dag, kam piešķirts savs
execution_date. Dagruni viena daka var strādāt paralēli (ja, protams, esat padarījuši savus uzdevumus idempotentus). - Operator — tie ir koda gabali, kas ir atbildīgi par konkrētu darbību izpildi. Ir trīs operatoru veidi:
- darbība, piemēram, mūsu mīļais
PythonOperator, kas spēj izpildīt jebkuru (derīgu) Python kodu; - pārsūtīt, kas pārsūta datus no vietas uz vietu, teiksim,
MsSqlToHiveTransfer; - sensor ļaus reaģēt vai apturēt turpmāku daka izpildi līdz noteikta notikuma iestāšanai.
HttpSensorvar pārbaudīt norādīto gala punktu, un, kad saņems atbilstošu atbildi, uzsākt pārsūtīšanuGoogleCloudStorageToS3Operator. Zinātkārais prāts jautās: "kāpēc? Jo var veikt atkārtojumus tieši operatorā!" Bet pēc tam, lai nenoslogotu uzdevumu pūli ar iestrēgušiem operatoriem. Sensors tiek uzsākts, pārbauda un mirst līdz nākamajai atkārtotai pokrei.
- darbība, piemēram, mūsu mīļais
- Task — deklarētie operatori neatkarīgi no veida un pievienoti dagam paaugstināti uz uzdevuma līmeņa.
- Task instance — kad ģenerālpārvaldnieks izlēma, ka uzdevumi ir jāsūta kaujā izpildītājiem-darbiniekiem (tieši vietā, ja mēs izmantojam
LocalExecutorvai attālinātu mezglu gadījumā arCeleryExecutor), viņš nosaka tiem kontekstu (t. i., mainīgo komplektu — izpildes parametrus), attīsta komandu vai pieprasījumu šablonus un ievieto tos pūlī.
Ģenerējam uzdevumus
Vispirms iezīmēsim vispārējo mūsu daga shēmu, un pēc tam arvien vairāk iegremdēsimies detaļās, jo mēs izmantojam dažus netradicionālus risinājumus.
Tātad visvienkāršākā formā šāds dag izskatīsies tā:
importēt timedelta, datetime

no airflow import DAG
no airflow.operators.python_operator import PythonOperator

no commons.datasources import sql_server_ds

dag = DAG('pasūtījumi',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Sāksim:
- Vispirms importējam nepieciešamās bibliotēkas un nedaudz citu informāciju;
sql_server_ds— tas irList[namedtuple[str, str]]ar savienojumu nosaukumiem no Airflow Connections un datubāzēm, no kurām mēs ņemsim mūsu tabulu;dag— mūsu dag deklarācija, kas obligāti jānovietoglobals(), citādi Airflow to neatradīs. Daga arī jāpasaka:- kas to sauc
orders— šis nosaukums vēlāk parādīsies tīmekļa saskarnē, - ka tas darbosies, sākot no astotā jūlija pusnakts,
- un tam jāizveido aptuveni ik pēc 6 stundām (pārējie var izmantot
timedelta()ir atļautscron-rindot0 0 0/6 ? * * *, mazāk pieredzējušiem — izteiksme kā@daily);
- kas to sauc
workflow()veiks galveno darbu,bet ne tagad. Tagad mēs просто izvadīsim mūsu kontekstu žurnālā.- Tagad vienkārša burvība, lai izveidotu uzdevumus:
- pārlidojam cauri mūsu avotiem;
- inicializējam
PythonOperator, kas izpildīs mūsu tukšos uzdevumus.workflow()Neaizmirstiet norādīt unikālu (dag ietvaros) uzdevuma nosaukumu un sasaistīt pašu dag. Karogsprovide_contextsavukārt pierakstīs funkcijai papildu argumentus, kurus mēs uzmanīgi savāksim ar**context.
Pagājušajā laikā viss, ko mēs ieguvām:
- jauns dag tīmekļa saskarnē,
- pusotrs simts uzdevumu, kas tiks izpildīti paralēli (ja to atļauj Airflow, Celery un serveru jauda).
Nekā, praktiski ieguvām.
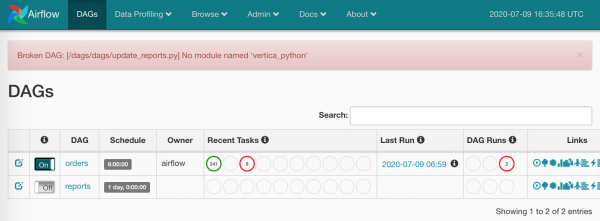
Kurš uzstādīs atkarības?
Lai visu šo lietu atvieglotu, es iekļāvu docker-compose.yml apstrādi requirements.txt visās mezglos.
Tagad nu sāksim:
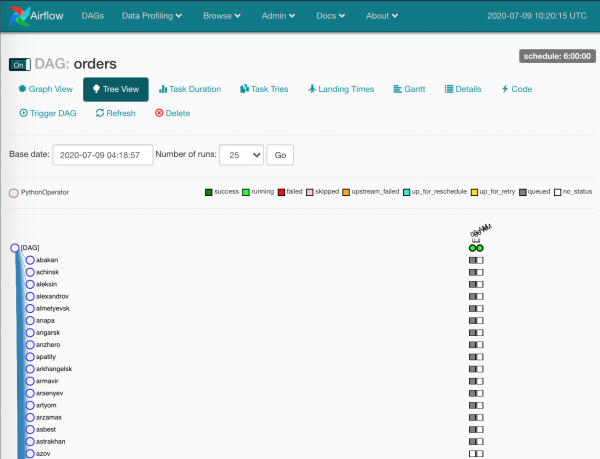
Pelēkie kvadrāti — uzdevumu instances, ko apstrādā plānošanas lietotne.
Nedaudz gaidām, uzdevumus paņem darbinieki:
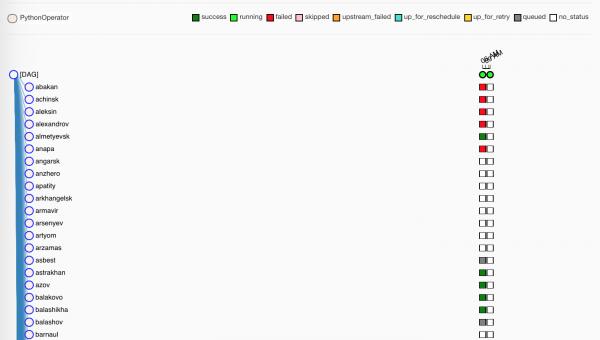
Zaļie, saprotams, — veiksmīgi izpildīti. Sarkanie — ne pārāk veiksmīgi.
Starp citu, mūsu produkcijā nav neviens mape
.\/dags, kas sinhronizējas starp mašīnām — visi dag irgitmūsu Gitlab, un Gitlab CI izklāj atjauninājumus uz mašīnām, kad ir savienotsmaster.
Mazliet par Flower
Kamēr darbinieki strādā ar mūsu tukšajiem uzdevumiem, atcerēsimies vēl vienu rīku, kas var norādīt — Flower.
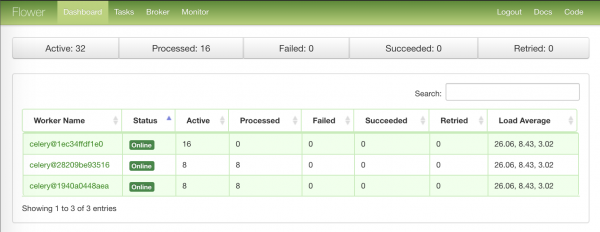
Pirmā lappuse ar kopsavilkuma informāciju par mezgliem-darbiniekiem:
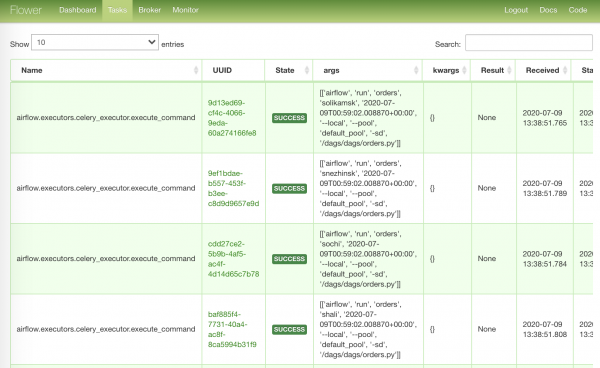
Visblīvākā lappuse ar uzdevumiem, kas uzsākuši darbu:
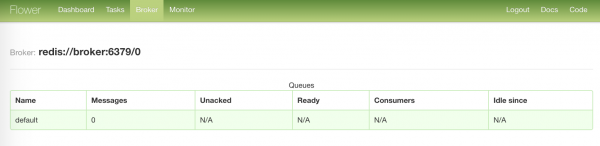
Visumā garlaicīgākā lappuse ar mūsu brokera stāvokli:
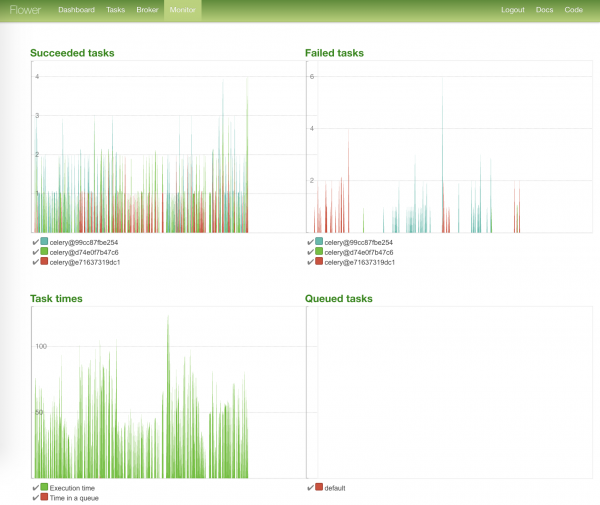
Vispiesātinātākā lappuse — ar uzdevumu stāvokļa grafikiem un to izpildes laiku:
Piedodam nenokārtoto
Tātad, visi uzdevumi ir izpildīti, varam vest ievainotos.
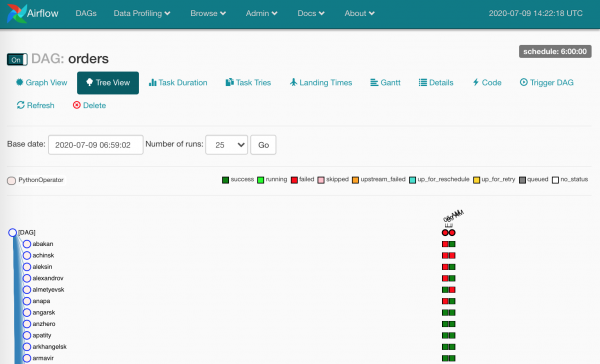
Un ievainoto izrādījās diezgan daudz — dažādu iemeslu dēļ. Ja Airflow tiek pareizi izmantots, šie kvadrāti liecina par to, ka dati noteikti nav ieradušies.
Jāskatās žurnāls un jārestartē neveiksmīgie uzdevumu gadījumi.
Noklikšķinot uz jebkura kvadrāta, redzēsim mums pieejamās darbības:
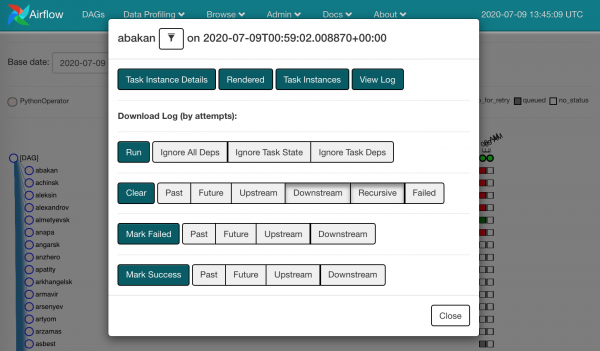
Mēs varam veikt Clear nevainīgajam uzdevumam. Tas nozīmē, ka mēs aizmirstam, ka tur ir kas sabojāts, un tas pats uzdevuma gadījums varēs doties pie plānotāja.
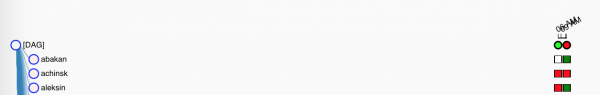
Protams, darīt to ar peli visiem sarkaniem kvadrātiem nav īpaši humāni — ne to mēs sagaidām no Airflow. Saprotams, mums ir masu iznīcināšanas ierocis: Browse/Task Instances
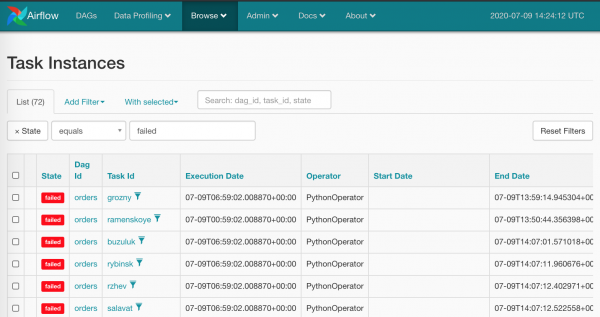
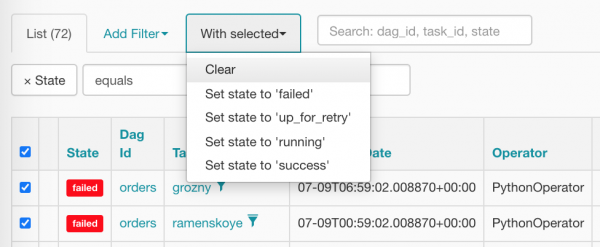
Izvēlēsimies visu uzreiz un noklikšķināsim uz pareizā punkta:
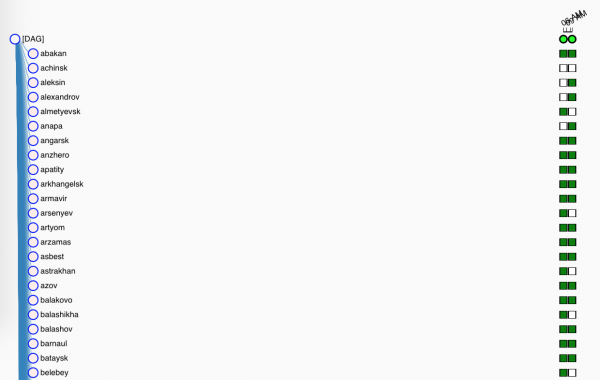
Pēc noskaidrošanas mūsu uzdevumi izskatās šādi (tie jau gaida, kad plānotājs tos ieplānos):
Savienojumi, hooku un citas mainīgās
Vispiemērotākais laiks, lai paskatītos uz nākamo DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Godmate, ziņojumi ir atjaunināti"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natālija, mosties, mēs {{ dag.dag_id }} esam pazeminājuši
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Visi taču kādreiz esat veikuši ziņojumu atjaunināšanu? Tā ir atkal tā pati: ir avotu saraksts, no kura iegūt datus; ir saraksts, kur tos novietot; neaizmirstam paziņot, kad viss notika vai sabojājās (nu, tas nav par mums, nē).
Apskatīsim vēlreiz failu un aplūkosim jaunas mulsinošas lietas:
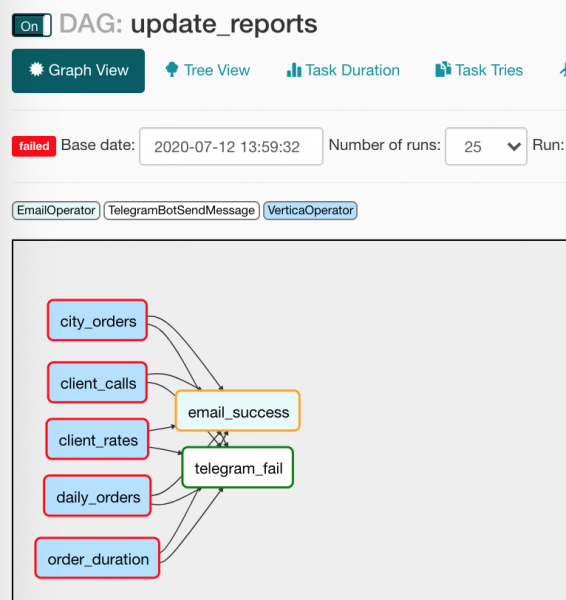
from commons.operators import TelegramBotSendMessage— mūs nekas neierobežo izveidot savus operatorus, ko mēs izmantojām, izveidojot nelielu apvalku ziņu sūtīšanai uz Unlock. (Par šo operatoru mēs vēl runāsim tālāk);default_args={}— DAG var izplatīt tos pašus argumentus visiem saviem operatoriem;to='{{ var.value.all_the_kings_men }}'— lauksuzmums nebūs cieti iestatīts, bet veidosies dinamiski, izmantojot Jinja un saraksta e-pastu mainīgo, ko es rūpīgi ievietojuAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— operatora izpildes nosacījums. Mūsu gadījumā, vēstule tiks nosūtīta vadītājiem, tikai ja visas atkarības tika izpildītas veiksmīgi;tg_bot_conn_id='tg_main'— argumenticonn_idņem identifikatorus pieslēgumiem, kurus mēs izveidojamAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— ziņas Telegram tiks nosūtītas tikai, ja būs krituši uzdevumi;task_concurrency=1— mēs aizliedzam vienlaicīgu vairāk nekā viena uzdevuma instanču palaišanu. Pretējā gadījumā mēs saņemsim vairākuVerticaOperator(kuras norāda uz vienu tabulu);report_update >> [email, tg]— vissVerticaOperatortiks apvienots, lai nosūtītu vēstuli un ziņu, lūk tā:

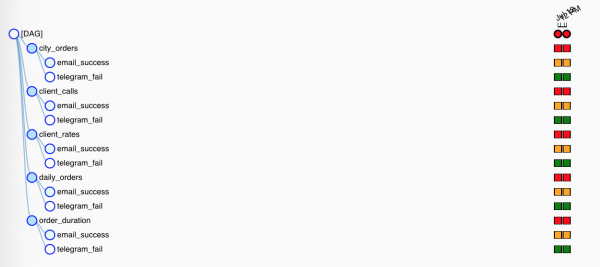
Bet tā kā paziņojumu operatoriem ir dažādi palaišanas nosacījumi, darbosies tikai viens. Tree View izskatās nedaudz mazāk pārskatāmi:

Pastāstīšu dažus vārdus par makro un to draugiem — interpolāciju.
Makro ir Jinja aizvietotāji, kas var ievietot dažādu noderīgu informāciju operatoru argumentiem. Piemēram, tā:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} tiks izpildīts konteksta mainīgā saturā execution_date formātā YYYY-MM-DD: 2020-07-14. Patīkamākais ir tas, ka konteksta mainīgie tiek piesaistīti konkrētam uzdevuma instancem (kvadrātiņam Tree View), un, atkārtoti palaižot, aizvietotāji tiks attēloti skaidrās vērtībās.
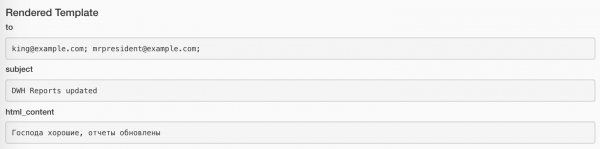
Piešķirtās vērtības var apskatīt, izmantojot pogu Rendered katrā uzdevuma instancē. Lūk, kā tas izskatās uzdevumam ar vēstules sūtīšanu:
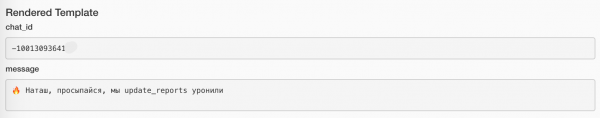
Un tā izskatās uzdevumam ar ziņas sūtīšanu:
Pilns iebūvēto makro saraksts, kas pieejams pēdējai versijai, ir šeit:
Turklāt, izmantojot spraudņus, mēs varam paziņot savus makro, bet tas jau ir pavisam cita stāsts.
Papildus iepriekš definētām lietām, mēs varam ievietot savu mainīgo vērtības (es jau to izmantoju kodā iepriekš). Izveidosim Admin/Variables dažas lietas:
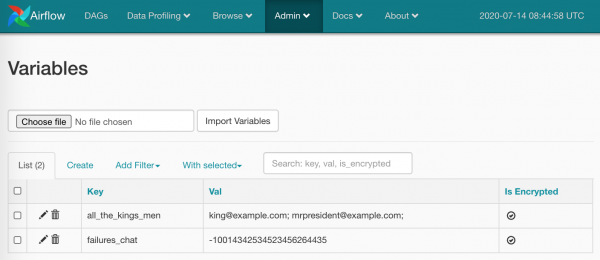
Viss, varam lietot:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')Vērtībā var būt skalarā, un tā var būt arī JSON. JSON gadījumā:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
vienkārši izmantojam ceļu uz nepieciešamo atslēgu: {{ var.json.bot_config.bot.token }}.
Teikšu burtiski vienu vārdu un parādīšu vienu ekrānšāviņu par savienojumiem. Šeit viss ir elementāri: lapā Admin/Connections izveidojam savienojumu, ievietojam tur savus lietotājvārdu/paroles un specifiskākus parametrus. Lūk, tā:
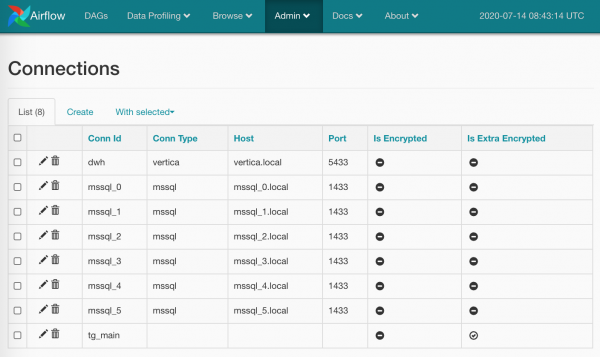
Paroles var šifrēt (daudz rūpīgāk nekā noklusējuma variantā), un var nepiekļaut savienojuma tipu (kā es izdarīju priekš tg_main) — lieta ir tāda, ka tipu saraksts ir iebūvēts Airflow modeļos, un to nevar paplašināt, neiejaucoties avota kodā (ja es kaut ko neatradu — lūdzu, labojiet mani), bet iegūt kreditorus vienkārši pēc nosaukuma mums nekas netraucē.
Un vēl var izveidot vairākus savienojumus ar vienu nosaukumu: šādā gadījumā metode BaseHook.get_connection(), kas iegūst savienojumus pēc nosaukuma, atgriezīs nejaušu no vairākiem homonīmiem (būtu loģiskāk izveidot Round Robin, bet atstāsim to Airflow izstrādātāju ziņā).
Mainīgie un savienojumi, bez šaubām, ir lieliski rīki, bet ir svarīgi nezaudēt līdzsvaru: kuras daļas no jūsu plūsmām glabājat kodā, bet kuras uzticat Airflow uzglabāšanai. No vienas puses, ātri mainīt vērtību, piemēram, izsūtīšanas kastīti, var būt ērti caur UI. No otras puses — tomēr atgriešanās pie klikšķiem, no kuriem mēs (es) vēlējāmies izvairīties.
Darbs ar savienojumiem ir viena no uzdevuma hooku. Patiesībā Airflow huki ir piekļuves punkti tā savienošanai ar trešo personu pakalpojumiem un bibliotēkām. Piemēram, JiraHook dos mums klientu, lai mijiedarbotos ar Jira (var pārvietot uzdevumus turp un atpakaļ), bet ar SambaHook var uzsist vietējo failu uz smb-punktu.
Izvērtējam pielāgotu operatoru
Un mēs esam tuvu tam, lai apskatītu, kā ir veidots TelegramBotSendMessage
Kods commons/operators.py ar pašu operatoru:
noŠeit viss, tāpat kā pārējais Airflow, ir ļoti vienkārši:
- Mēs mantojam no
BaseOperator, kas īsteno diezgan daudz Airflow specifisku lietu (apskatiet mierīgā laikā) - Paziņojām laukus
template_fields, kuros Jinja meklēs makros, ko apstrādāt. - Izveidojām pareizos argumentus
__init__(), norādījām noklusējuma vērtības, kur tas nepieciešams. - Par vecāku inicializāciju arī neaizmirsām.
- Atvērām atbilstošo datu savienojuma moduli
TelegramBotHook, saņēmām no tā klienta objektu. - Pārdefinējām metodi
BaseOperator.execute(), kuru Airflow izsauks, kad pienāks laiks izpildīt operatoru — tajā mēs īstenojam galveno darbību, neaizmirstot pierakstīties. (Mēs, starp citu, pierakstāmies tiešistdoutunstderr— Airflow visu noķers, skaisti apvīs, sakārtos, kur nepieciešams.)
Apskatīsim, kas mums ir commons/hooks.py. Faila pirmā daļa, ar pašu datu savienojuma moduli:
no typing import Union

no airflow.hooks.base_hook import BaseHook
no requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Telegram Bot API datu savienojuma modulis

    Piezīme: pievienojiet savienojumu ar tukšu Conn Type un neaizmirstiet
    aizpildīt Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Es pat nezinu, ko šeit varētu izskaidrot, vienkārši pievērsīšu uzmanību svarīgām lietām:
- Mantojam, domājam par argumentiem — lielākajā daļā gadījumu tas būs viens:
conn_id; - Pārdefinējam standarta metodes: es ierobežojos ar
get_conn(), kurā es iegūstu savienojuma parametrus pēc nosaukuma un vienkārši iegūstu sekcijuextra(šajā JSON laukā) es ieliku Telegram bota tokenu:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Izveidoju mūsu
TelegramBot, piešķirot tam jau konkrētu tokenu.
Tas arī viss. Klientu no hooka var iegūt, izmantojot TelegramBotHook().clent vai TelegramBotHook().get_conn().
Un otrā daļa faila, kurā es veicu mikroapvalku Telegram REST API, lai neņemtu līdzi to pašu viena metodei sendMessage.
class TelegramBot:
    """Telegram Bot API wrappers

    Piemēri:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Sveiki, dārgais')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Sveiki, dārgais', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Pareizs ceļš ir salikt visu kopā:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— pliginā, ievietot publiskajā repozitorijā un atdot Open Source.
Kamēr mēs visu to pētījām, mūsu ziņojumu atjauninājumi veiksmīgi sabruka un nosūtīja man kanālā kļūdas ziņojumu. Iešu pārbaudīt, kas atkal nav kārtībā...
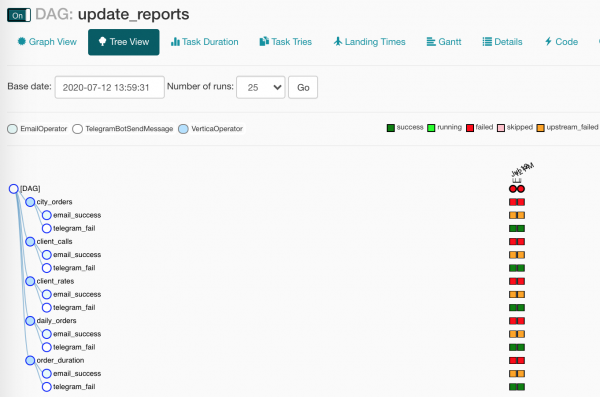
Mūsu DAGā kaut kas ir salūzis! Un vai mēs negaidījām tieši to? Tieši tā!
Vai tu ielaidīsi?
Jūtat, esmu ko palaidis garām? Izskatās, ka solīju datus no SQL Server pārcelt uz Vertica un te pēkšņi novirzījos no tēmas, nedzirdējs?
Šis pārkāpums bija apzināts, man bija obligāti jāizskaidro jums dažas terminoloģijas. Tagad var turpināt.
Mums bija plāns:
- Izveidot DAG
- Nģenerēt uzdevumus
- Apskatīt, kā viss izskatās jauki
- Pieskiršanu uzlādēm sesiju numurus
- Iegūt datus no SQL Server
- Ievietot datus Vertica
- Savākt statistiku
Tātad, lai visu to uzsāktu, es izveidoju mazu papildinājumu mūsu docker-compose.yml:
docker-compose.db.yml
version: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Tur mēs uzsākam:
- Vertica kā hostu
dwhar visām noklusējuma iestatījumiem, - trīs SQL Server instancēm,
- aizpildām datubāzes ar dažiem datiem (nekādā gadījumā neskatieties
mssql_init.py!)
Mēs palaižam visu labumu ar nedaudz sarežģītāku komandu nekā iepriekš:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Tas, ko ģenerējusi mūsu brīnumainā randomizācija, varam apskatīt, izmantojot sadaļu Data Profiling/Ad Hoc Query:
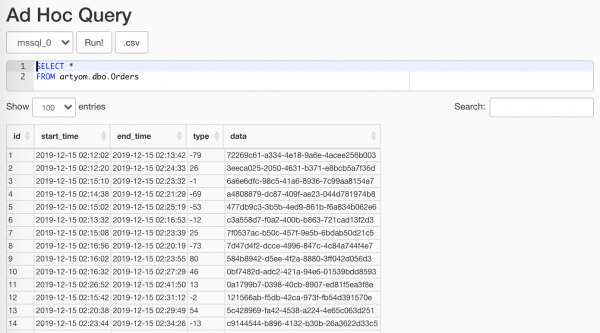
Galvenais, nerādīt to analītikām
Sīkāk neapstāšos pie ETL sesijām es nevēlos, tur viss ir vienkārši: veidojam datubāzi, tajā tabulu, iepakojam visu konteksta menedžerī, un tagad darām tā:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Load workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
no sys import stderr

class Session:
    """ETL darba sesija

    Piemērs:
        with Session(task_name) as session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Lieliski pārbaudīts'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            IZVEIDOT TABULU, JA NEKAS NETRAFIED AJAHANOS (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            IEVADĪT TABULAS sessions (task_name, finished)
            VĒRTĪBAS (%s, NULL)
            ATGRIEZOT id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'atvērts')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Sesija netika atvērta')
        query = """
            ATJAUNOT sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            ATGRIEZOT id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'aizvērts',
              ', veiksmīgs: ', self.successful,
              ', Ielādēts: ', self.loaded_rows,
              ', komentārs:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Ir pienācis laiks iegūt mūsu datus no mūsu pusotras simts tabulām. Mēs to izdarīsim, izmantojot ļoti vienkāršas rindas:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    IZVĒLĒTIES
        id, start_time, end_time, type, data
    NO dbo.Orders
    KUR
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Ar hook palīdzību iegūsim no Airflow
pymssql-savienojums - Kvadra uzdotā jautājumā tiks noteikts datuma ierobežojums - paraugs to nometīs funkcijā.
- Mēs nododam mūsu pieprasījumu
pandas, kas piegādās mumsDataFrame— tas mums noderēs nākotnē.
Es izmantoju aizvietojumu
{dt}vietā jautājuma parametra%sne tāpēc, ka esmu ļaunais Buraķins, bet tieši tāpēcpandasnerad spēj tikt galā arpymssqlun pārsūta pēdējamparams: Saraksts, kaut gan tas ļoti vēlastuple.
Ņemiet vērā, ka attīstītājspymssqlnolēma vairs neatbalstīt to, un ir pienācis laiks pārcelties uzpyodbc.
Apskatīsim, kā Airflow ir iekļāvis mūsu funkciju argumentus:
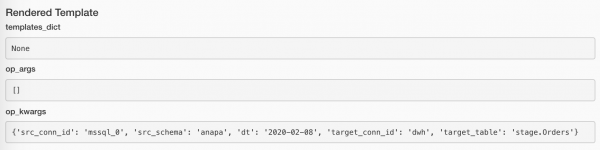
Ja datu nav, tad turpināt nav jēgas. Bet uzskatīt, ka ielāde ir veiksmīga, arī būtu dīvaini. Taču tas nav kļūda. A-ha, ko darīt?! Bet šādi:
if df.empty:
    raise AirflowSkipException('Nav rindu, ko ielādēt')
AirflowSkipException teiks Airflow, ka kļūdu, patiesībā, nav, bet uzdevumu mēs izlaidīsim. Saskarnē nebūs ne zaļš, ne sarkans kvadrāts, bet rozā krāsā.
Pievienosim mūsu datiem dažas kolonnas:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Proti:
- DB, no kuras mēs paņēmām pasūtījumus,
- Mūsu ielādes sesijas identifikators (tas būs atšķirīgs katram uzdevumam),
- Hash no avota un pasūtījuma identifikatora — lai gala datubāzē (kur viss tiks salikts vienā tabulā) mums būtu unikāls pasūtījuma identifikators.
Palicis pirmspēdējais solis: ielādēt visu Vertica. Un, kā negaidīti, viens no visefektīvākajiem veidiem to izdarīt — caur CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Mēs izveidojam speciālu saņēmēju
StringIO. pandaslaipni saliks tajā mūsuDataFramekāCSV-rindas.- Atvērsim savienojumu ar mūsu mīļo Vertica, izmantojot hook.
- Un tagad ar
copy()nosūtīsim mūsu datus tieši uz Vertica!
No draivera paņemsim, cik daudz rindu ir piepildījušās, un teiksim sesijas menedžerim, ka viss ir kārtībā:
session.loaded_rows = cursor.rowcount
session.successful = True
Tas arī viss.
Ražošanā mēs manuāli izveidojam mērķa tabulu. Šeit es atļāvos nelielu automatizāciju:
create_schema_query = f'CREATĒ SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    IZVEIDO TABULU IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Es izmantoju
VerticaOperator()izveidoju datu bāzes shēmu un tabulu (ja tās vēl nav, protams). Galvenais, pareizi sakārtot atkarības:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Noslēdzot
— Nu lūk, — teica pelīte, — vai ne, tagad
Vai esi pārliecinājies, ka mežā esmu visbriesmīgākais zvērs?
Džūlija Donaldsone, „Grufalo”
Domāju, ja mēs ar saviem kolēģiem rīkotu sacensību: kurš ātrāk izveidos un palaidīs ETL procesu no nulles: viņi ar saviem SSIS un peli, un es ar Airflow... Un tad mēs arī salīdzinātu uzturēšanas ērtumu... Ah, domāju, tu piekritīsi, ka es viņus apsteigšu visos aspektos!
Ja runājam nedaudz nopietnāk, tad Apache Airflow — pateicoties procesu aprakstam programmēšanas kodā — padarīja manu darbu krietni ērtāku un patīkamāku.
Tā neierobežotā paplašināmība: gan spraudņu ziņā, gan tieksme uz mērogojamību — dod jums iespēju pielietot Airflow praktiski jebkurā jomā: gan pilnā datu vākšanas, sagatavošanas un apstrādes ciklā, gan raķešu palaišanā (uz Marsu, protams).
Noslēguma daļa, informatīva
Grābekļi, kurus mēs esam savākuši jums
start_date. Jā, tas jau ir lokāls memes. Caur galveno argumentu DAGstart_datepārgāja visi. Īsi sakot, ja norādātstart_datepašreizējo datumu, betschedule_interval— vienu dienu, tad DAG palaidīsies rīt ne agrāk.start_date = datetime(2020, 7, 7, 0, 1, 2)Un vairs nekādu problēmu.
Ar to ir saistīta arī vēl viena izpildes kļūda:
Uzdevumam trūkst start_date parametra, kas visbiežāk liecina par to, ka esi aizmirsis sasaistīt ar operatoru DAG.- Viss uz viena datora. Jā, gan datubāzes (paša Airflow un mūsu „apstrādes”), gan tīmekļa serveris, plānotājs un darbinieki. Un tas pat strādāja. Bet laika gaitā uzdevumu skaits pakalpojumos pieauga, un kad PostgreSQL sāka atbildēt pēc indeksiem pēc 20 ms, nevis 5 ms, mēs to paņēmām un pārvietojām.
- LocalExecutor. Jā, mēs joprojām to izmantojam, un mēs jau esam tuvu bezdibeņa malai. LocalExecutor mums joprojām pietika, bet tagad ir pienācis laiks paplašināt vismaz ar vienu darbinieku, un būs jāpastrādā, lai pārietu uz CeleryExecutor. Un ņemot vērā to, ka ar to var strādāt arī uz viena datora, nekas neaptur izmantot Celery pat ne serverī, kas „dabiski nekad neies uz ražošanu, solīts!”
- Nepietiekamība iekļautajiem līdzekļiem:
- Connections dienesta akreditācijas datu glabāšanai,
- SLA Misses reakcijai uz uzdevumiem, kas netika izpildīti laikā,
- XCom metadatu apmaiņai (es teicu metadatus!starp uzdevumiem DAG.
- E-pasta ļaunprātīga izmantošana. Ko te teikt? Tika iestatīti paziņojumi par visiem atkārtotajiem kritušajiem uzdevumiem. Tagad manā darba Gmail >90k vēstuļu no Airflow, un e-pasta tīmekļa saskarne atsakās ņemt un dzēst vairāk par 100 vienā reizē.
Vēl vairāk slēpto problēmu:
Rīki vēl lielākai automatizācijai
Lai mēs varētu vēl vairāk strādāt ar prātu, nevis ar rokām, Airflow ir sagatavojis šo:
- — tas joprojām ir eksperimentāls, kas netraucē tam darboties. Ar tā palīdzību var ne tikai saņemt informāciju par DAG un uzdevumiem, bet arī apturēt/sākt DAG, izveidot DAG Run vai izveidot pūļu.
- — caur komandrindu ir pieejami daudzi rīki, kas ne vienkārši ir neērti lietojami caur WebUI, bet arī vispār trūkst. Piemēram:
backfillir nepieciešams, lai atkārtoti palaiž uzdevumu instancē.
Piemēram, nāk analītiķi, saka: "Bet jums, biedri, ir problēmas ar datiem no 1. līdz 13. janvārim! Labojiet, labojiet, labojiet!". Un tu tā kā:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Datu bāzes apkalpošana:
initdb,resetdb,upgradedb,checkdb. run, kas ļauj palaist vienu uzdevuma instanci, un vēl pat ignorēt visas atkarības. Turklāt to var palaist caurLocalExecutor, pat ja jums ir Celery klasteris.- Apmēram to pašu dara
test, tikai vēl arī nekas netiek ierakstīts datubāzē. connectionsļauj masveidā veidot savienojumus no shell.
- — diezgan rūpīga mijiedarbības metode, kas paredzēta spraudņiem, nevis pastiprināšanai ar rokām. Bet kas mums liedz doties uz
/home/airflow/dags, palaistipythonun sākt darboties? Piemēram, varat eksportēt visus savienojumus ar tādu kodu:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Savienojums ar Airflow metadatu bāzi. Es neiesaku rakstīt tajā, bet stāvokļu iegūšana attiecībā uz dažādām specifiskām metrikām var būt ievērojami ātrāka un vieglāka nekā caur jebkuru API.
Teiksim, ka ne visi mūsu uzdevumi ir idempotenti un reizēm var krist, un tas ir normāli. Bet dažas avārijas – tās jau ir aizdomīgas, un vajadzētu pārbaudīt.
Esiet uzmanīgi ar SQL!
AR pēdējo izpildījumu kā (
SELECT
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
FROM public.task_instance
WHERE
    execution_date > now() - INTERVAL '2' DAY
),
failed AS (
    SELECT
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    FROM last_executions
    WHERE
        state IN ('failed', 'up_for_retry')
)
SELECT
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
FROM failed
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Saites
Protams, pirmajām desmit atsaucēm no Google rezultātiem ir Airflow mape no manām grāmatzīmēm.
- — protams, jāuzsāk ar oficiālo dokumentāciju, bet kas gan lasa instrukcijas?
- — vismaz izlasiet rekomendācijas no izstrādātājiem.
- — viss sākums: lietotāja interfeiss attēlos
- — labi izskaidroti pamata jēdzieni, gadījumā, ja (pēkšņi!) kaut ko neesat sapratuši pie manis.
- — īss ceļvedis Airflow klastera iestatīšanai.
- — gandrīz tikpat interesanta raksts, tikai vairāk formāls, bet mazāk piemēru.
- — par sadarbību ar Celery.
- — par uzdevumu idempotentību, ielādi pēc ID, nevis datuma, transformācijām, failu struktūru un citām interesantām lietām.
- — uzdevumu atkarības un Trigger Rule, par kurām es tikai pieminēju.
- — kā pārvarēt dažus "darbojas kā paredzēts" no plānotāja, ielādēt zaudētus datus un noteikt uzdevumu prioritātes.
- — noderīgi SQL vaicājumi metadatiem Airflow.
- — ir noderīga sadaļa par pielāgotā sensora izveidi.
- — interesanta īsa piezīme par infrastruktūras izveidi AWS datu zinātnei.
- — izplatītas kļūdas (kad kāds tomēr nelasa instrukcijas).
- — pasmaidi, kā cilvēki izturas pret parolēm, kaut gan varētu vienkārši izmantot Connections.
- — neizteikta DAG pārnese, konteksta nodošana funkcijā, atkal par atkarībām, un arī par uzdevumu izpildes izlaidi.
- — par izmantošanu
noklusējuma argumentiunparamsveidnēs, kā arī par Variables un Connections. - — stāsts par to, kā plānotājs ir sagatavots Airflow 2.0.
- — nedaudz novecojusi raksts par mūsu klastera izvietošanu
docker-compose. - — dinamiskie uzdevumi, izmantojot veidnes un konteksta nodošanu.
- — standarta un pielāgota paziņojumi pa e-pastu un Slack.
- — uzdevumu sazarojums, makrosi un XCom.
Un saites, kas izmantotas rakstā:
- — pieejamie veidnēs izmantošanai paredzētie vietturis.
- — izplatītas kļūdas DAG veidošanā.
- —
docker-composeeksperimentiem, atkļūdošanai un ne tikai. - — Python apvalks Telegram REST API.
Avots: habr.com
