

Pēdējā laikā kolēģi no "darbnīcas" neatkarīgi viens no otra sākuši man jautāt: kā no viena SDR uztvērēja vienlaicīgi saņemt visus Bluetooth kanālus? Josla taču ļauj, ir SDR ar izejas joslu 80 MHz un vairāk. Protams, to var izdarīt arī uz FPGA, taču šīs izstrādes laiks būs diezgan liels. Jau sen zināju, ka to varētu uztaisīt uz GPU, taču tik viegli!
Bluetooth standarts nosaka fizisko līmeni divās versijās: Classic un Low Energy. Specifikācija ir . Dokuments ir briesmīgi liels, to pilnībā lasīt ir bīstami prātam. Par laimi, lielas kompānijas, kas ražo mērīšanas tehnoloģijas, ir aprīkotas ar līdzekļiem, lai izveidotu vizuāli pieejamus dokumentus par šo tēmu. un , piemēram. Man nav nekādu iespēju konkurēt ar viņiem attiecībā uz materiāla kvalitāti. Interesentiem lūdzu izpētīt pa saitēm.
Viss, kas man jāzina par fizisko līmeni, lai izveidotu daudzkanālu filtru, ir frekvenču režģa solis un modulācijas ātrums. Tie ir apkopoti tabulā vienā no minētajiem dokumentiem:
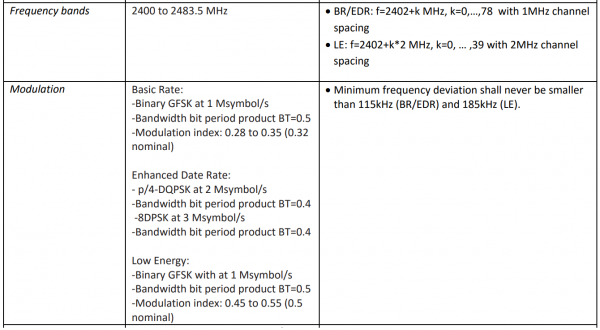
Tādējādi mums ir jāizgriež 80 MHz josla 79 filtriem ar regulēšanas soli 1 MHz un vienlaicīgi 40 filtriem ar regulēšanas soli 2 MHz. Frekvenču sekvences no filtriem jābūt 1 MHz un 2 MHz, attiecīgi.
Tādējādi mums ir nepieciešamas divas filtru ķēdes.
Sāksim izvēlēties šo filtru parametrus, pamatojoties uz Bluetooth Classic un Bluetooth Low Energy signālu joslām. Mums nepieciešamas to impulsīvās īpašības, lai aprēķinātu slodzi uz filtrēšanas skaitļošanas ierīci. Šeit uzreiz jāpiebilst, ka impulsīvās īpašības garumus esam izvēlējušies pamatojoties uz "ātrā" filtrēšanas algoritma prasībām. Tās būtību tas nemaina. Arī impulsīvās īpašības koeficientu skaitam nevajadzētu būt pārāk lielam, lai filtrs tiktu realizēts uz saprātīgas skaitļošanas aparatūras.
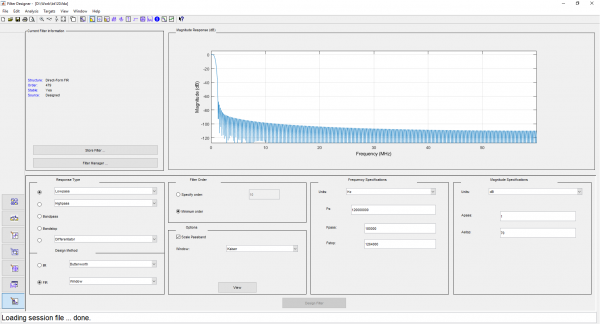
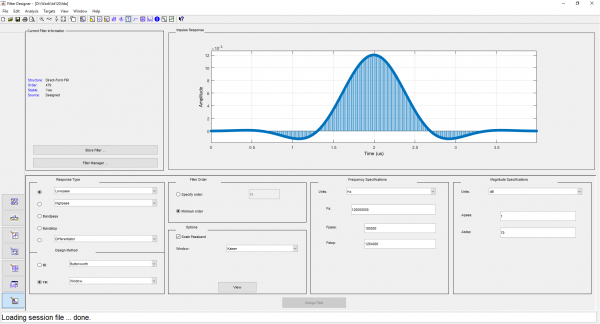
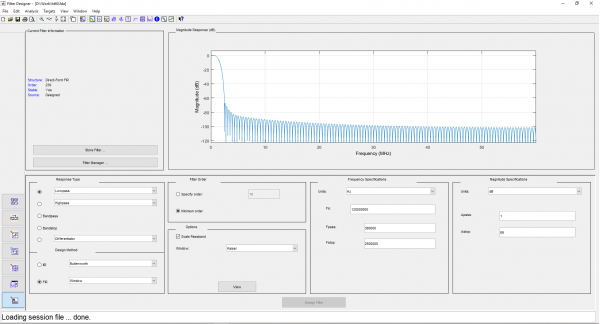
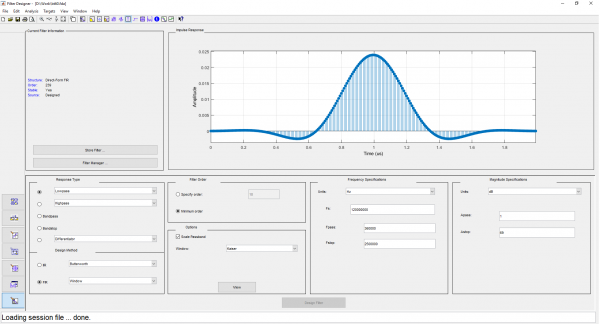
Filtriem ar 1 MHz soli izvēlēsimies zemo frekvenci (pusi no joslas platuma) 500 kHz, impulsīvās īpašības garumu pielāgosim līdz 480 atvieglojumiem. Filtriem ar 2 MHz šo parametrus izvēlēsimies 1 MHz un 240 atvieglojumiem, attiecīgi. Loga veidu izvēlamies Kaisa. Aprēķināsim impulsīvās īpašības filterDesigner un eksportēsim tās C-header formātā:
Ekrānuzņēmumi no filterDesigner
Problēmu var risināt tieši: veidot atbilstošu filtriem DDC masīvu (). Šāda pieeja ir laba FPGA, kur ir iespējams ietaupīt, samazinot pirmajos posmos veiktspējas precizitāti. Turklāt FPGA ir visefektīvākais veids, kā to īstenot energoefektivitātes ziņā. Bet šīs pieejas darba slodze ir visaugstāka.
Izpildot filtru kamoliņu populārajos GPU, ir iespēja īstenot sarežģītāku algoritmu: polifāzisko filtru kamoliņu, kas balstās uz FFT, kas ir pieejams CUDA bibliotēkā. Ārzemju literatūrā algoritms tiek saukts par Polyphase vai WOLA (Weight, Overlap and Add) FFT Filterbank. Manas zīmēšanas slinkums neļauj man pats veikt vizuālu skaidrojumu. Internetā ir daudz materiālu par šo tēmu, īpaši vizuāls grafiks ir izpildīts 11. lapā (liels paldies cienījamajiem autoriem), šis ir tas:
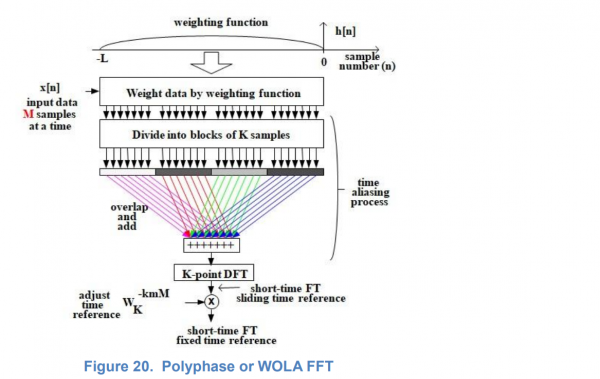
Es mēģināšu paskaidrot apstrādes shēmu ar saviem vārdiem. Vāji nervoziem lūdzu nelasīt.
Es mēģināšu paskaidrot apstrādes shēmu ar saviem vārdiem, ņemot vērā manas metodiskās iespējas. FFT ir ieejas signāla konvolūcija ar visu kompleksu ortogonālo harmoniku spektru, kas iekļaujas impulsa atbildes intervālā. Filtra impulsa atbilde, uz kuru signāls tiek reizināts pirms FFT, modulē šo harmoniku spektru. Citiem vārdiem sakot, rezultējošo filtru kamoliņu impulsa atbilžu apvalks tiek izcelts ārpus slēdzenes. Pēc tam harmoniku spektrs tiek samazināts kādā skaitā reizes, ņemot vērā filtra pārejas joslas paplašināšanu attiecībā pret taisnstūrveida logu filtru. Attēlā mēs redzam samazinājumu par četriem. Citiem vārdiem sakot, pēc pārejas joslas paplašināšanas ar Kaiser logu (ar vienlaicīgu samazināšanu aizkavēšanās joslā) mums vairs nav nepieciešami visi filtri, bet tikai ceturtā daļa no tiem. Pārējie ir lieki, to frekvenču raksturlielumi pārklājas. No četrām secīgām FFT punktiem ņemam tikai nulles punktu, kuras aprēķins ir četru
ietilpīgu punktu summēšana, ņemta ar laiku, kas vienāds ar ceturtdaļu no sākotnējā FFT ilguma.
Dzelzi izvēlēsimies to, kas ir pie rokas. Tas ir "Instrumentālās Sistēmas" FMC126P ievades plates. Par to jau esmu rakstījis vienā no iepriekšējiem darbiem. . FMC slot of the board has a sub-module from the same company with an AD9371 transceiver operating at a bandwidth of 100 MHz. The entire stream from the transceiver can be continuously transmitted to the computer for processing.
Let's choose a graphics card with a GTX 1050 GPU. (I lied, it chose us: that's all that was at hand, it was pulled from a computing unit for antenna calculations, but it was all the more surprising to see a working comb). Let's move on to the software part.
Unfortunately, due to licensing, we cannot publish the full code. We can only show the GPU kernels. Moreover, the rest of the code is not particularly interesting.
Here is the kernel that performs the multiplication of the signal with the window and addition, along with a wrapper for its call:
__global__ void cuComplexMultiplyWindowKernel(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result) {
    __shared__ cuComplex multiplicationResult[480];
    multiplicationResult[threadIdx.x] = cuComplexMultiplyFloat(data[threadIdx.x + windowSize / 4 * blockIdx.x], window[threadIdx.x]);
    __syncthreads();
    cuComplex sum;
    sum.x = sum.y = 0;
    if (threadIdx.x < windowSize / 4) {
        for(int i = 0; i < 4; i++) {
            sum = cuComplexAdd(sum, multiplicationResult[threadIdx.x + i * windowSize / 4]);
        }
        result[threadIdx.x + windowSize / 4 * blockIdx.x] = sum;
    }
}

cudaError_t cuComplexMultiplyWindow(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result, size_t dataSize, cudaStream_t stream) {
    size_t windowStep = windowSize / 4;
    cuComplexMultiplyWindowKernel<<>>(data, window, windowSize, result);
    return cudaGetLastError();
}
The signal processing code that calls this kernel exactly follows the scheme of the algorithm depicted in the figure above, so I see no point in providing it here.
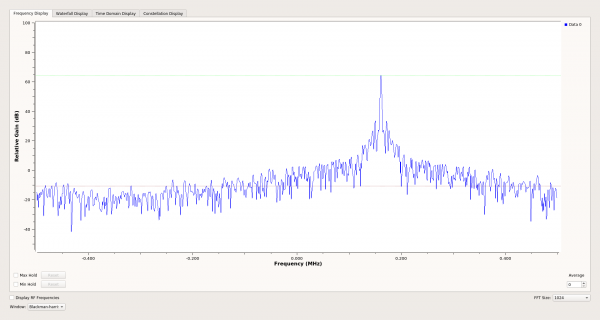
The combs were checked on the output spectrum of channels in real time. A 2450 MHz signal from the signal generator was fed into the AD9371, and the selectivity of the filters matched the calculated values.
Plans: adaptation of the software for the XRTX board and implementation of packet searching, if someone finds it necessary or if there is free time.
All the work on the software was done by , glory to him!
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish