

Ievads
Pirms kāda laika man tika uzdots uzdevums izstrādāt noturīgu klasteri , kas darbojas vairākos datu centros, savienotiem ar šķiedru optiku vienā pilsētā, un spēj izturēt vienas datu centra atteici (piemēram, jauda tiek atslēgta). Kā programmatūru, kas atbild par noturību, es izvēlējos , jo tas ir oficiālais risinājums no RedHat, lai izveidotu noturīgus klasterus. Tas ir labs ar to, ka RedHat nodrošina tā atbalstu un ka šis risinājums ir universāls (modulārs). Ar tā palīdzību varēs nodrošināt noturību ne tikai PostgreSQL, bet arī citiem pakalpojumiem, vai nu izmantojot standarta moduļus, vai izstrādājot tos konkrētām vajadzībām.
Uz šo risinājumu radās saprātīgs jautājums: cik noturīgs būs noturīgais klasteris? Lai to izpētītu, es izstrādāju testa vidi, kas imitē dažādas atteices klastera mezglos, gaida atjaunošanos, atjauno atteikušo mezglu un turpina testus ciklā. Sākotnēji šis projekts tika saukts par hapgsql, bet laika gaitā man apnika nosaukums, kurā ir tikai viena patskaņa. Tāpēc noturīgās datubāzes (un float IP, kas uz tām norāda) es sāku dēvēt par krogan (varonis no datorspēles, kuram visiem svarīgajiem orgāniem ir rezerves), bet mezglus, klasterus un pašu projektu - tuchanka (planēta, kur dzīvo krogaņi).
Tagad vadība ir atļāvusi . README drīz tiks iztulkots angļu valodā (jo tiek gaidīts, ka galvenie patērētāji būs Pacemaker un PostgreSQL izstrādātāji), bet veco krievu versiju README es nolēmu noformēt (daļēji) šī raksta veidā.
Klasteri tiek izvietoti virtuālajās mašīnās . Kopumā tiks izvietotas 12 virtuālās mašīnas (kopā 36GiB), kas veidos 4 noturīgus klasterus (dažādi varianti). Pirmie divi klasteri sastāv no diviem PostgreSQL serveriem, kas izvietoti dažādos datu centros, un kopējā servera witness c quorum device (kas izvietots lētā virtuālajā mašīnā trešajā datu centrā), kas atrisina neskaidrību 50%/50%, piešķirot savu balsi vienai no pusēm. Trešais klasteris ir trīs datu centros: viens galvenais, divi vergi, bez quorum device. Ceturtais klāsters sastāv no četriem PostgreSQL serveriem, pa diviem datu centrā: viens meistars, pārējie replikas, un arī izmanto witness c quorum device. Ceturtais spēj izturēt divu serveru vai viena datu centra avāriju. Šo risinājumu, ja nepieciešams, var paplašināt uz vairākiem replikām.
Precīza laikā pakalpojums ir arī pārkonfigurēts augstā pieejamībā, bet tur tiek izmantota paša ntpd (orphan mode). Kopējais serveris witness pilda centrālā NTP servera lomu, izdalot savu laiku visiem klasteriem, tādējādi sinhronizējot visus serverus savā starpā. Ja witness iznāk no kārtības vai nonāk izolācijā, tad savu laiku sāks izdalīt viens no klastera serveriem (iekšējā klasterī). Palīgšķietamais kešatmiņas HTTP proxy ir arī uzstādīts witness, ar tā palīdzību pārējām virtuālajām mašīnām ir piekļuve Yum repozitorijiem. Realitātē tādi pakalpojumi kā precīzs laiks un proxy noteikti tiks izvietoti uz atsevišķiem serveriem, bet šajā standā tie ir izvietoti uz witness tikai, lai ietaupītu virtuālo mašīnu skaitu un vietu.
Versijas
v0. Strādā ar CentOS 7 un PostgreSQL 11 VirtualBox 6.1 vidē.
Klāsteru struktūra
Visi klasteri ir paredzēti izvietošanai vairākos datu centros, apvienoti vienā plaknē un jāspēj izturēt viena datu centra avāriju vai tīkla izolāciju. Tādēļ nav iespējama izmanto, lai aizsargātu pret split-brain standarta tehnoloģiju Pacemaker, kas saucas STONITH (Shoot The Other Node In The Head) vai fencing. Tās būtība: ja mezglu klasterī sāk šaubīties, ka ar kādu mezglu notiek kas nepareizs, viņš neatbild vai uzvedas nepareizi, tad tie piespiedu kārtā to izslēdz caur „īpašiem” ierīcēm, piemēram, IPMI vai UPS vadības karti. Bet tas darbosies tikai gadījumos, kad pie viena servera avārijas IPMI vai UPS turpina darboties. Šeit plānota aizsardzība pret daudz katastrofālākām avārijām, kad avarē (piemēram, kļūst bez elektrības) viss datu centrs. Un šādā avārijā visi stonith-ierīces (IPMI, UPS utt.) arī nedarbosies.
Tā vietā sistēmas pamatā ir kvoruma ideja. Visi mezgliem ir balss, un strādāt var tikai tie, kuri redz vairāk nekā pusi no visiem mezgliem. Šis skaits „puse+1” saucas kvorums. Ja kvorums netiek sasniegts, tad mezgls izlemj, ka tas atrodas tīkla izolācijā un jāatvieno savus resursus, t.i., tas ir tāds aizsardzība pret split-brain. Ja rīkojumam, kas atbild par šādu uzvedību, programmēšana nedarbojas, tad jāaktivizē uzraugs, piemēram, IPMI bāzē.
Ja mezglu skaits ir pāra skaitlis (klasteris divos datu centros), var rasties tā saucamā nenoteiktība. 50%/50% (puse uz pusi), kad tīkla izolācija sadala klasteri tieši divās daļās. Tādēļ pāra mezglu skaitam tiek pievienots quorum device — prasību neizvirzošs demons, kuru var palaist uz vislētākās virtuālās mašīnas trešajā datu centrā. Viņš dod savu balsi vienam no segmentiem (ko redz) un tādējādi atrisina 50% / 50% nenoteiktību. Serveris, uz kura tiks palaists quorum ierīce, es nosaucu par witness (terminoloģija no repmgr, man patīk).
Resursi var pārvietoties no viena uz citu, piemēram, no bojātiem serveriem uz labiem, vai pēc sistēmas administratoru komandas. Lai klienti zinātu, kur atrodas nepieciešamie resursi (kur pieslēgties?), tiek izmantoti peldīgi IP (float IP). Tie ir IP, kurus Pacemaker var pārvietot pa mezgliem (viss atrodas plaknē tīklā). Katrs no tiem simbolizē resursu (pakalpojumu) un atradīsies tur, kur vajag pieslēgties, lai piekļūtu šim pakalpojumam (mūsu gadījumā datu bāzei).
Tuchanka1 (blīvējumu shēma)
Struktūra
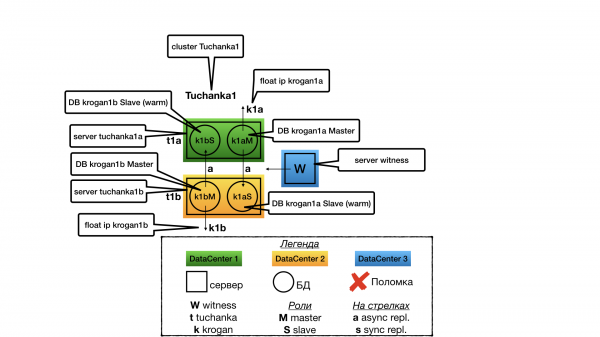
Ideja bija tāda, ka mums ir daudz mazu datu bāzu ar zemu slodzi, kuru dēļ nav izdevīgi uzturēt atsevišķu slave-serveri karstā rezerves režīmā read only transakcijām (nav nepieciešamības pēc tādas resursu izsīkuma).
Katram datu centrā ir viens servers. Katram serverim ir divi PostgreSQL instanci (PostgreSQL terminoloģijā tos sauc par klasteriem, taču lai neradītu confusion, es nosaukšu tos par instancēm (analogā ar citām DB), bet klasterus saukšu tikai par Pacemaker klasteriem). Viens instances darbojas kā meistars, un tikai viņš sniedz pakalpojumus (tikai uz viņu ved float IP). Otra instances darbojas kā vergs otrajā datu centrā un sniegs pakalpojumus tikai tad, ja viņa meistars izgāzīsies. Tā kā lielāko daļu laika pakalpojumus (veicot pieprasījumus) sniegs tikai viens no diviem instancēm (meistars), visi servera resursi tiks optimizēti uz meistaru (tiks atvēlēta atmiņa shared_buffers kešam u.tml.), bet tā, lai arī otrai instancei pietiktu resursu (lai gan neoptimālā darbībā caur failu sistēmas kešu) gadījumā, ja viens no datu centriem atteiksies. Vergs nesniedz pakalpojumus (neveic read only pieprasījumus) normālā klastera darbības laikā, lai nebūtu resursu cīņas ar meistaru tajā pašā mašīnā.
Divu mezglu gadījumā kļūdas tolerance ir iespējama tikai pie asinhronas replikācijas, jo pie sinhronas verga atteikums noved pie meista apstāšanās.
Witness atteikums
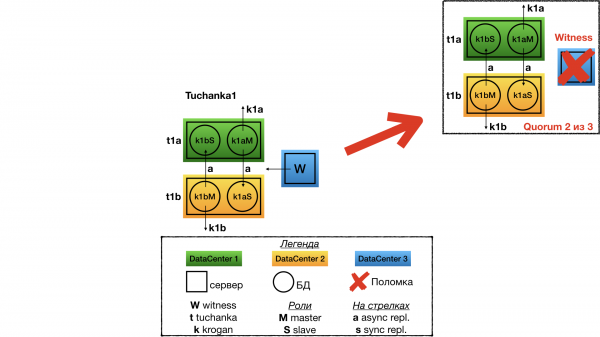
Witness atteikums (quorum device) es apskatīšu tikai Tuchanka1 klastera gadījumā, pārējiem būs tāda pati situācija. Pie witness atteikuma klastera struktūrā nekas nemainīsies, viss turpinās darboties tāpat kā iepriekš. Taču kvorums kļūs vienāds 2 no 3, tāpēc jebkurš nākamais atteikums būs fatāls klasterim. Jebkurā gadījumā to būs jālabo steidzami.
Tuchanka1 atteikums
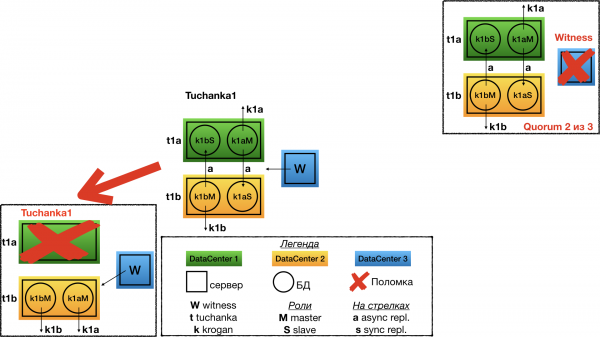
Viens no datu centriem atteikums Tuchanka1 gadījumā. Šajā gadījumā witness viņš nodod savu balsi otrajam mezglam otrajā datu centrā. Tur bijušais vergs pārvēršas par meistaru, kā rezultātā uz viena servera darbojas abi meistari un uz tiem norāda abi to float IP.
Tuchanka2 (klasiskā)
Struktūra
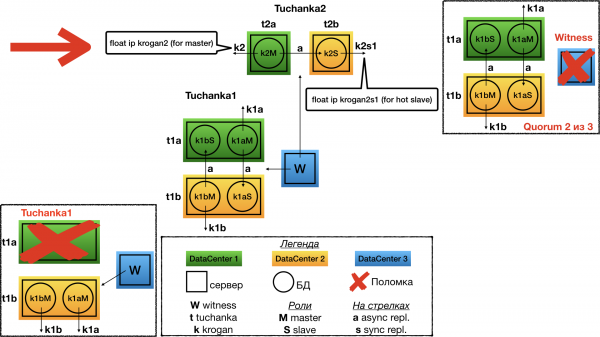
Klasiska shēma ar diviem mezgliem. Uz viena darbojas meistars, uz otra vergs. Abi var veikt pieprasījumus (vergs tikai read only), tāpēc uz abiem norāda float IP: krogan2 — uz meistaru, krogan2s1 — uz vergu. Kļūdas tolerance būs gan meistaram, gan vergam.
Divu mezglu gadījumā kļūdas tolerance ir iespējama tikai pie asinhronas replikācijas, jo pie sinhronas verga atteikums noved pie meista apstāšanās.
Tuchanka2 atteikums
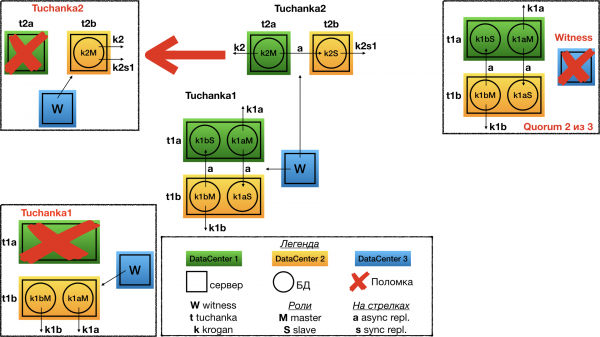
Viens no datu centriem atteikums witness balso par otro. Uz vienīgā darbojošā datu centra tiks uzstādīts meistars, un uz to norādīs abi float IP: meistara un darba. Protams, instancim jābūt konfigurētam tā, lai tam pietiktu resursu (limitus zem savienojuma utt.) vienlaikus pieņemt visas savienojumus un pieprasījumus no meistara un darba float IP. Tātad normālas darbības laikā tam jābūt pietiekamai rezervē limitos.
Tuchanka4 (daudz darba)
Struktūra
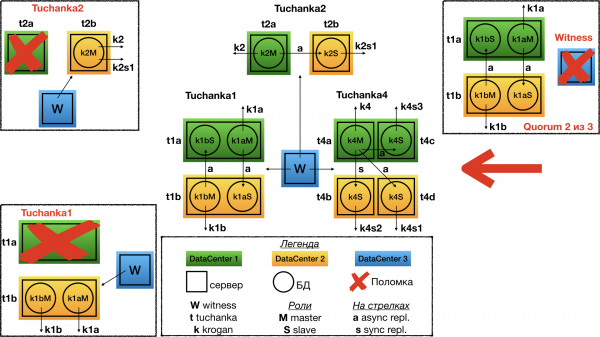
Jau cita ekstrēma situācija. Ir datu bāzes, uz kurām nāk ļoti daudz read-only pieprasījumu (tipiska augstas slodzes vietne). Tuchanka4 ir situācija, kad darba var būt trīs vai vairāk, lai apstrādātu šādus pieprasījumus, bet tomēr ne pārāk daudz. Pie ļoti liela darbinieku skaita būs jāizdomā hierarhiska replikācijas sistēma. Minimālajā gadījumā (attēlā) katrā no diviem datu centriem atrodas divi serveri, uz katra kuriem ir pa instancam PostgreSQL.
Vēl viena šīs shēmas iezīme ir tā, ka šeit jau var organizēt vienu sinhrono replikāciju. Tā ir konfigurēta, lai replikētu, ja iespējams, citā datu centrā, nevis uz replikas tajā pašā datu centrā, kur ir meistars. Uz meistaru un katru darba norāda float IP. Vairāk vai mazāk, starp darbiniekiem būs jāveic pieprasījumu balansēšana ar kādu sql proxy, piemēram, klienta pusē. Dažādiem klientu tipiem var prasīt atšķirīgu tipu sql proxy, un tikai klientu izstrādātāji zina, kuram kurš ir nepieciešams. Šī funkcionalitāte var tikt īstenota gan kā ārējs demons, gan klienta bibliotēka (savienojumu baseins), utt. Viss šis iet ārpus tēmas par datu bāzes noturīgo klasteri (noturība SQL proxy var tikt īstenota neatkarīgi, kopā ar klienta noturību).
Tuchanka4 atteikums
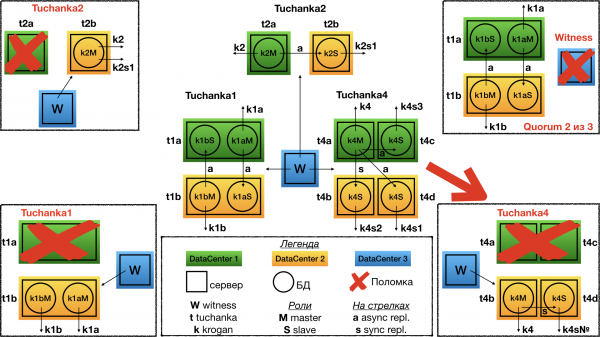
Kad viens datu centrs neizdodas (t.i., divi serveri), liecinieks balso par otro. Rezultātā otrajā datu centrā strādā divi serveri: uz viena darbojas meistars, un uz to norādīts meistara float IP (lasīt-rakstīt pieprasījumiem); bet uz otra servera darbojas darbinieks ar sinhrono replikāciju, un uz to norādīts viens no darba float IP (lasīt tikai pieprasījumiem).
Pirmais, kas jāatzīst: strādājošs darba float IP būs ne visi, bet tikai viens. Un, lai to pareizi darbotos, būs nepieciešams, sql proxy pāradresēts visus pieprasījumus uz vienīgo palikušo float IP; ja nē, tad var norādīt visus float IP vergu atdalītā ar komatu URL, lai pieslēgtos. Šādā gadījumā sql proxy savienojums tiks izveidots ar pirmo darba IP, tā ir izdarīts automātiskajā testēšanas sistēmā. Iespējams, citās bibliotēkās, piemēram, JDBC, tas var nedarboties. libpq Tā ir izdarīts, jo float IP vergiem ir liegums vienlaikus pārcelties uz vienu serveri, lai tie vienmērīgi sadalītos starp vergu serveriem, ja tie darbojas vairāki. sql proxyOtrkārt: pat datu centra atteikuma gadījumā saglabāsies sinhrona replikācija. Un pat ja notiks otrs atteikums, tas ir, ja palikušajā datu centrā atteiksies viens no diviem serveriem, klasteris, lai gan pārtrauks sniegt pakalpojumus, tomēr saglabās informāciju par visām apstiprinātajām transakcijām, par kurām tas deva apstiprinājumu par komitu (nebūs informācijas zuduma otrajā atteikumā).
Tuchanka3 (3 datu centri)
Tas ir klasteris situācijai, kad ir trīs pilnvērtīgi strādājoši datu centri, kuros katrā ir pilnvērtīgi darošs datu bāzes serveris. Šādā gadījumā
Struktūra
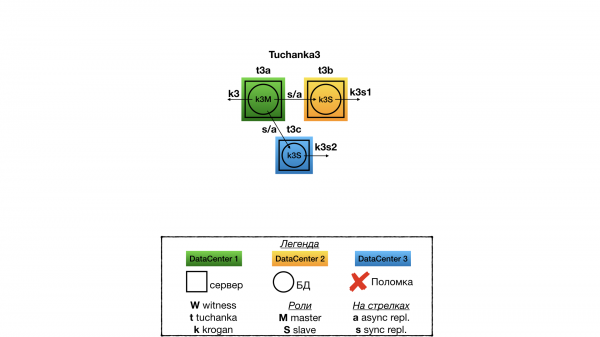
nav nepieciešams. Vienā datu centrā darbojas meistars, divos citos — vergi. Replikācija ir sinhrona, tipa ANY (slave1, slave2), tas ir, klientam tiks nosūtīts apstiprinājums par komitu, kad jebkurš no vergiem pirmais atbildēs, ka tas ir pieņēmis komitu. Resursi norāda uz vienu float IP meistaram un diviem vergiem. Atšķirībā no Tuchanka4 visi trīs float IP ir izgāzties izturīgi. Lasījumiem ir iespējams izmantot quorum device (ar atsevišķu izgāzties izturību), vai arī pusei klientu piešķirt vienu vergu float IP, bet otrai pusei — otro. sql proxy Izgāšanās Tuchanka3
Ja vienam no datu centriem ir izgāšanās, paliek divi. Viens ir pacelts meistars un float IP no meistara, bet otrs — vergs un abi vergu float IP (instancē jābūt divkāršam resursu rezervēm, lai pieņemtu visas pieslēgšanās no abiem vergu float IP). Starp meistariem un vergu ir sinhrona replikācija. Tāpat klasteris saglabās informāciju par apstiprinātajām un apstiprinātajām transakcijām (nebūs informācijas zuduma) divu datu centru iznīcināšanas gadījumā (ja tie nav iznīcināti vienlaikus).
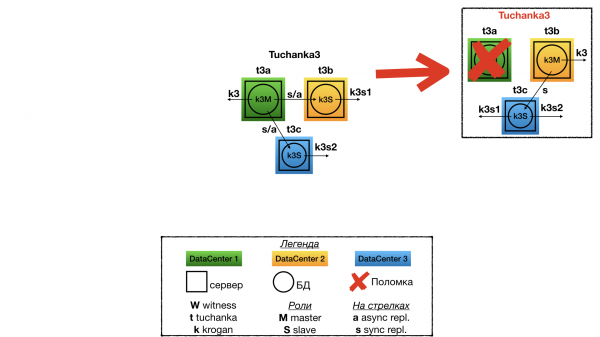
Ja vienai datu centrā ir traucējumi, paliek divas. Viens no tiem ir sagatavots kā meistars ar float IP no meistara, otrs — kā vergs ar abiem vergu float IP. (Instancēm jābūt divkāršam resursu rezervem, lai varētu uzņemt visas saites no abiem vergu float IP). Starp meistariem un vergu notiek sinhronā replikācija. Klasteris arī saglabās informāciju par apstiprinātajām un apstiprinātajām darījumiem (informācija netiks zaudēta) divu datu centru iznīcināšanas gadījumā (ja tie netiek iznīcināti vienlaicīgi).
Izsmeļošs failu struktūras un izvietošanas apraksts netika iekļauts. Kurš vēlēsies pamēģināt, visu to var izlasīt README. Es sniedzu tikai automātiskā testēšanas aprakstu.
Automātiskās testēšanas sistēma
Lai pārbaudītu klusteru izturību, simulējot dažādas defektus, ir izstrādāta automātiskās testēšanas sistēma. To palaiž ar skriptu test/failure. Skripts var pieņemt kā parametrus klusteru numurus, kurus vēlaties pārbaudīt. Piemēram, šī komanda:
test/failure 2 3pārbaudīs tikai otro un trešo klusteru. Ja parametri nav norādīti, tad tiks pārbaudīti visi klasteri. Visi klasteri tiek testēti paralēli, un rezultāts tiek parādīts tmux panelī. Tmux izmanto atsevišķu tmux serveri, tāpēc skriptu var palaist no default tmux, veidojot iegultu tmux. Es iesaku izmantot terminālu lielā logā ar mazu fontu. Pirms testēšanas visas virtuālās mašīnas tiek atjaunotas uz momentuzņēmumu, kas uzņemts skripta beigās. setup.
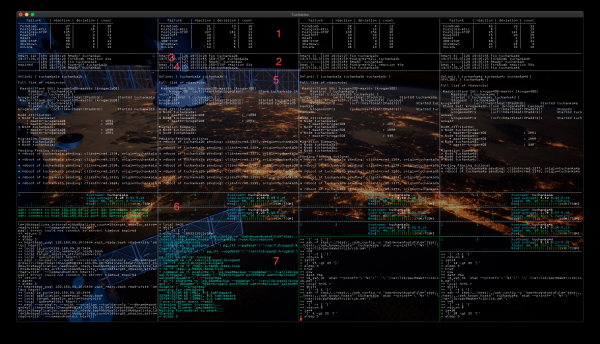
Termināls tiek sadalīts kolonnās, atbilstoši testējamo klasteru skaitam, pēc noklusējuma (iekš screenshot) to ir četri. Kolonnu saturu es aprakstīšu uz Tuchanka2 piemēra. Paneļi screenshot ir numurēti:
- Šeit tiek parādīta statistika par testiem. Kolonnas:
- failure — testu nosaukums (funkcijas skriptā), kas simulē defektu.
- reaction — vidējais laiks sekundēs, kurā klusters atjaunoja savu darbspēju. Tiek mērīts no skripta palaišanas sākuma, kas simulē defektu, līdz brīdim, kad klusters atjauno savu darbspēju un var turpināt sniegt pakalpojumus. Ja laiks ir ļoti īss, piemēram, sešas sekundes (tā notiek klasteros ar vairākiem vergiem (Tuchanka3 un Tuchanka4)), tas nozīmē, ka defekts radās uz asimetriskā verga un nekādā veidā neietekmēja darbspēju, klastera stāvokļa pārslēgšana nebija.
- deviation — rāda izkliedi (precizitāti) vērtībai reaction izmantojot "standarta novirzes" metodi.
- count — cik reizes šis tests tika veikts.
- Īss žurnāls ļauj novērtēt, ar ko klusters nodarbojas šobrīd. Tiek parādīts iterācijas (testa) numurs, laika atzīme un operācijas nosaukums. Pārāk ilgs izpildes laiks (> 5 minūtes) norāda uz kaut kādām problēmām.
- heart (sirds) — pašreizējais laiks. Lai vizuāli novērtētu darba spēju meistari viņa tabulā pastāvīgi tiek ierakstīts pašreizējais laiks, izmantojot meistara float IP. Ja tests ir veiksmīgs, rezultāts tiek parādīts šajā panelī.
- sit (pulsācija) — «pašreizējais laiks», kas iepriekš bija ierakstīts skriptā heart meistarā, tagad tiek nolasīts no verga caur viņa float IP. Tas ļauj vizuāli novērtēt verga darba spēju un replikāciju. Tuchanka1 nav vergu ar float IP (nav vergu, kas sniedz pakalpojumus), taču tur ir divi instanču (DB), tāpēc šeit tiks rādīts ne sit, bet heart otra instance.
- Klāsteru stāvokļa monitorings ar rīku
pcs mon. Rāda struktūru, resursu sadalījumu starp mezgliem un citu noderīgu informāciju. - Šeit tiek parādīta sistēmas monitorings no katras virtuālās mašīnas klasterī. Šādu paneļu var būt vairāk — cik daudz virtuālo mašīnu ir klasterī. Divi grafiki CPU Slodze (virtuālajās mašīnās pa diviem procesoriem), virtuālās mašīnas nosaukums, Sistēmas Slodze (norādīts kā Slodzes Vidējais, jo tas ir vidējs 5, 10 un 15 minūtēs), dati par procesiem un atmiņas sadalījumu.
- Skripta trasēšana, kas veic testēšanu. Ja rodas kļūme — pēkšņa apstāšanās vai bezgalīga gaidīšanas cikla — šeit varēs redzēt šāda uzvedības iemeslu.
Testēšana tiek veikta divos posmos. Sākumā skripts iziet cauri visām testa sugām, nejauši izvēloties virtuālo mašīnu, kurai šo testu pielietot. Pēc tam tiek veikts bezgalīgs testēšanas cikls, virtuālās mašīnas un kļūme katru reizi tiek izvēlētas nejauši. Pēkšņa testēšanas skripta pabeigšana (apakšējais panels) vai bezgalīga gaidīšana uz kaut ko (> 5 minūtes viena operācija, tas redzams trasē) norāda, ka kāds no testiem šajā klasterī ir izgāzies.
Katrs tests sastāv no šādām operācijām:
- Funkcijas palaišana, kas simulē kļūmi.
- Gatavs? — gaidīšana uz klastera atjaunošanu (kad tiek sniegti visi pakalpojumi).
- Tiek rādīts klastera atjaunošanas laiks (reaction).
- Labot — klasteris «tiek labots». Pēc tam tam jāatgriežas pilnīgā darba stāvoklī un gatavībā uz nākamo kļūmi.
Šeit ir testu saraksts ar aprakstu, ko tie dara:
- ForkBomb: rada "Out of memory" ar fork-bombi.
- OutOfSpace: pārpilda cieto disku. Taču tests ir drīzāk simbolisks, ņemot vērā minimālo slodzi, kas tiek radīta testēšanas laikā, pie cietā diska pārpildes PostgreSQL parasti neizdodas.
- Postgres-KILL: nogalina PostgreSQL ar komandu
killall -KILL postgres. - Postgres-STOP: uzsākt PostgreSQL ar komandu
killall -STOP postgres. - PowerOff: «pārtrauc» virtuālo mašīnu ar komandu
VBoxManage controlvm "virtuāla mašīna" poweroff. - Atjaunot: pārrestartē virtuālo mašīnu ar komandu
VBoxManage controlvm "virtuāla mašīna" reset. - SBD-STOP: pauž SBD demon ar komandu
killall -STOP sbd. - ShutDown: caur SSH nosūta virtuālajai mašīnai komandu
systemctl poweroff, sistēma pareizi noslēdz darbību. - UnLink: tīkla izolācija, komanda
VBoxManage controlvm "virtuāla mašīna" setlinkstate1 off.
Testēšanas noslēgšana var notikt ar standarta komandu tmux "kill-window" Ctrl-b &, vai ar komandu "detach-client" Ctrl-b d: šajā procesā testēšana beidzas, tmux aizveras, virtuālās mašīnas izslēdzas.
Identificētās problēmas testēšanas laikā
Pašreiz ir jāpiespiež izvēlēties vai nu skaņu, vai suspend/atjaunot. Gaidām, kad moduli bce autors pabeigs funkcionālā uzlabošanu. watchdog demons sbd apstrādā novērojamo demonu apstāšanos, bet ne to iesaldēšanu. Un, kā rezultātā, nepareizi apstrādā bojājumus, kas noved pie iesaldēšanas tikai Corosync un Pacemaker, bet nepārtrauc sbd. Pārbaudei Corosync jau ir pieejams , apstiprināts zarā master. Solīja (PR#83), ka arī Pacemaker būs kaut kas līdzīgs, ceru, ka līdz RedHat 8 tiks izstrādāts. Bet šādas «bojājumu» teorijas ir viegli simulēt mākslīgi, izmantojot, piemēram,
killall -STOP corosync, bet nekad nesastopamas reālajā dzīvē.Uz Pacemaker versijā CentOS 7 nepareizi iestatīts sync_timeout u quorum device, rezultātā , uz kuru būtu jāpāriet maîtère. Tika izlabots, palielinot sync_timeout u quorum device izvietošanas laikā (skriptā
setup/setup1). Šis labojums netika pieņemts izstrādātājiem Pacemaker, tā vietā viņi solīja pārstrādāt infrastruktūru tādā veidā (kādu nezināmu nākotnē), lai šo taimeri varētu aprēķināt automātiski.Ja, konfigurējot datu bāzi, ir norādīts, ka
LC_MESSAGES(teksta ziņojumi) var izmantot Unicode, piemēram,ru_RU.UTF-8, tad palaižot postgres vidē, kur locale nav UTF-8, piemēram, tukšā vidē (šeit pacemaker+pgsqlms(paf) palaiž postgres), tad . PostgreSQL izstrādātāji joprojām nav vienojušies par to, kas jādara šādā gadījumā. Tas ir izdarāms, jāuzstādaLC_MESSAGES=en_US.UTF-8konfigurējot (izveidojot) DB instanci.Ja ir iestatīts wal_receiver_timeout (pēc noklusējuma 60s), tad, testējot PostgreSQL-STOP uz galvenā servera klasteros tuchanka3 un tuchanka4 . Replikācija tur ir sinhrona, tāpēc apstājas ne tikai darba, bet arī jaunā galvenā servera darbība. To var apiet, iestatot wal_receiver_timeout=0, konfigurējot PostgreSQL.
Retu reizi esmu novērojis replikācijas apstāšanos PostgreSQL testā ForkBomb (atmiņas pārpildīšana). . Esmu saskāries ar to tikai klasteros tuchanka3 un tuchanka4, kur, jo replikācija ir sinhrona, galvenais serveris apstājās. Problēma izzuda pati par sevi pēc kāda ilga laika (ap divām stundām). Nepieciešama papildu izpēte, lai to novērstu. Pēc simptomiem tas līdzinās iepriekšējai kļūdai, ko izraisa cita iemesla dēļ, taču ar līdzīgiem rezultātiem.
Krogan attēls ņemts no ar autora atļauju:
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish