

Es turpinu savu stāstu par to, kā savienot Exchange un ELK (sākums ). Atgādinu, ka šī kombinācija spēj bez šaubām apstrādāt ļoti lielu žurnālu daudzumu. Šoreiz mēs runāsim par to, kā izveidot sadarbību starp Exchange un Logstash un Kibana komponentiem.
Logstash ELK kaudzē tiek izmantots, lai intelektuāli apstrādātu žurnālus un sagatavotu tos izvietošanai Elastic formā kā dokumentus, uz kuru pamata ir ērti veidot dažādas vizualizācijas Kibana.
Uzstādīšana
Tas sastāv no diviem posmiem:
- OpenJDK pakotnes uzstādīšana un konfigurācija.
- Logstash pakotnes uzstādīšana un konfigurācija.
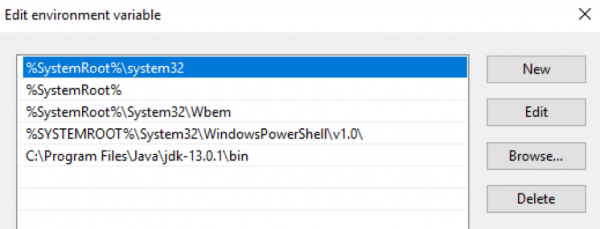
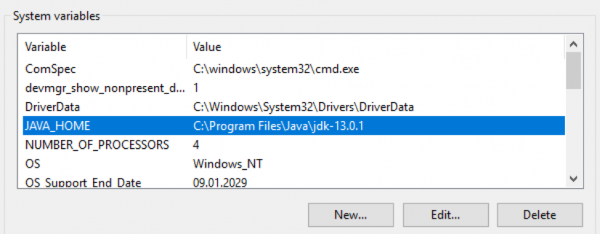
OpenJDK pakotni nepieciešams lejupielādēt un izpakot noteiktā direktorijā. Pēc tam jāievieš ceļš uz šo direktoriju sistēmas Windows vides mainīgajos $env:Path un $env:JAVA_HOME:
Pārbaudīsim Java versiju:
PS C:> java -version openjdk version "13.0.1" 2019-10-15 OpenJDK Runtime Environment (build 13.0.1+9) OpenJDK 64-Bit Server VM (build 13.0.1+9, mixed mode, sharing)
Logstash pakotnes uzstādīšana un konfigurācija
Lejupielādējiet arhīva failu ar Logstash izplatīšanu
. Arhīvs jāpārvieto diskā. Nevajadzētu izpakot folderī , jo Logstash atteiksies normāli startēt. Pēc tam jāveic izmaiņas failā C:Program Files jvm.options , kas atbild par atmiņas piešķiršanu Java procesam. Ieteiktu norādīt pusi no servera operatīvās atmiņas. Ja tam ir 16 GB operatīvās atmiņas, tad noklusējuma taustiņi: -Xms1g -Xmx1g
jānomaina uz:
-Xms8g -Xmx8g
Turklāt ir lietderīgi komentēt rindiņu
-XX:+UseConcMarkSweepGC . Sīkāk par to. Nākamais solis ir izveidot noklusējuma konfigurāciju failā logstash.conf: input { stdin{} } filter { } output { stdout { codec => "rubydebug" } }
Izmantojot šo konfigurāciju, Logstash lasa datus no konsoles, iztukšo to cauri tukšam filtram un izvada atpakaļ konsolē. Šīs konfigurācijas izmantošana ļaus pārbaudīt Logstash darbību. Tādēļ palaidīsim to interaktīvā režīmā:
PS C:...bin> .logstash.bat -f .logstash.conf ... [2019-12-19T11:15:27,769][INFO ][logstash.javapipeline ][main] Pipeline started {"pipeline.id"=>"main"} The stdin plugin is now waiting for input: [2019-12-19T11:15:27,847][INFO ][logstash.agent ] Pipelines running {:count=>1, :running_pipelines=>[:main], :non_running_pipelines=>[]} [2019-12-19T11:15:28,113][INFO ][logstash.agent ] Successfully started Logstash API endpoint {:port=>9600}
Logstash veiksmīgi uzsācies portā 9600.
Finālais uzstādīšanas solis: palaist Logstash kā Windows pakalpojumu. To var izdarīt, piemēram, ar pakotnes
NSSM :
PS C:...bin> .nssm.exe install logstash
Service "logstash" installed successfully!
Izmaksu noturība
Logu saglabāšana, pārsūtot no avota servera, ir nodrošināta ar Persistent Queues mehānismu.
Kā tas darbojas
Rindu izvietojuma shēma loģu apstrādes procesā: iestatījums → rinda → filtrs + izeja.
Input spraudnis saņem datus no loģu avota, ieraksta tos rindā un nosūta avotam apstiprinājumu par datu saņemšanu.
Ziņas no rindas apstrādā Logstash, tās iziet cauri filtram un output spraudnim. Kad output saņem apstiprinājumu par loģa nosūtīšanu, Logstash dzēš apstrādāto loģu ziņas no rindas. Ja Logstash tiek apturēts, visas neapstrādātās ziņas un ziņas, par kurām nav saņemts apstiprinājums par nosūtīšanu, paliek rindā, un Logstash turpinās to apstrādi pie nākamās palaišanas.
Iestatījumi
Regulēts ar atslēgām failā C:Logstashconfiglogstash.yml:
queue.type: (iespējamās vērtības —persistedunmemory (noklusējums)).path.queue: (ceļš uz mapes, kurā atrodas rindu faili, kuri noklusējuma kārtojumi ir C:Logstashqueue).queue.page_capacity: (maksimālais rindas lapas izmērs, noklusējuma vērtība — 64mb).queue.drain: (true/false — ieslēdz/izslēdz rindas apstrādes apturēšanu pirms Logstash izslēgšanas. Neiesaku ieslēgt, jo tas tieši ietekmēs servera izslēgšanas ātrumu).queue.max_events: (maksimālais notikumu skaits rindā, noklusējuma — 0 (neierobežots)).queue.max_bytes: (maksimālais rindas lielums baitos, noklusējuma — 1024mb (1gb)).
Ja ir iestatīti queue.max_events un queue.max_bytes, tad ziņas pārstāj tikt pieņemtas rindā, sasniedzot kādas no šīm iestatījumu vērtībām. Sīkāk par Persistent Queues ir izskaidrots .
Logstash.yml daļas piemērs, kas atbild par rindas iestatījumiem:
queue.type: persisted
queue.max_bytes: 10gb
Iestatījumi
Logstash konfigurācija parasti sastāv no trim daļām, kas atbild par dažādām ieejošo loģu apstrādes fāzēm: saņemšana (input sekcija), parsēšana (filter sekcija) un nosūtīšana uz Elastic (output sekcija). Zemāk mēs sīkāk aplūkosim katru no tām.
Ieejas
Ieejošais plūsma ar neapstrādātajiem logiem tiek pieņemta no filebeat aģentiem. Tieši šo spraudni mēs norādām input sekcijā:
input {
  beats {
    port => 5044
  }
}
Pēc šādas iestatīšanas Logstash sāk klausīties portu 5044, un, saņemot logus, apstrādā tos saskaņā ar filter sekcijas iestatījumiem. Ja nepieciešams, varam ietin logu saņemšanas kanālu no filebit SSL. Sīkāk par beats spraudņa iestatījumiem ir rakstīts .
Filter
Visi interesanti teksta žurnāli, kurus ģenerē Exchange, ir csv formātā ar lauciņiem, kas aprakstīti pašos žurnālu failos. Logstash piedāvā trīs spraudņus csv ierakstu parsēšanai: , csv un grok. Pirmais ir visātrākais, bet tas spēj sarindot tikai visvienkāršākos žurnālus. …,"MDB:GUID1, Mailbox:GUID2, Event:526545791, MessageClass:IPM.Note, CreationTime:2020-05-15T12:01:56.457Z, ClientType:MOMT, SubmissionAssistant:MailboxTransportSubmissionEmailAssistant",…
To var izmantot žurnālu parsēšanai, piemēram, IIS gadījumā. Šajā gadījumā filtration sekcija var izskatīties šādi:
filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
    }
  }
}
Logstash konfigurācija ļauj izmantot
nosacījuma operatorus, tāpēc mēs spraudnī dissect varam virzīt tikai ierakstus, kas tika atzīmēti ar filebeat tagu
IIS. , kas saturēja ierakstu no žurnāla, un varam pievienot nejaušu lauku, kas saturēs piemēram, lietojumprogrammas nosaukumu, no kuras mēs vācam žurnālus. Žurnālu uzskaitē vēlams izmantot csv spraudni, tas spēj pareizi apstrādāt sarežģītus laukus:filter { if "Tracking" in [tags] { csv { columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"] remove_field => ["message", "tenant-id", "schema-version"] add_field => { "application" => "exchange" } } } messageSpraudnī mēs saderinām lauku vērtības ar to nosaukumiem, noņemam sākotnējo lauku
(un arī laukus
tenant-id
schema-version), kas saturēja ierakstu no žurnāla, un varam pievienot nejaušu lauku, kas saturēs piemēram, lietojumprogrammas nosaukumu, no kuras mēs vācam žurnālus. message Filtrācijas posma izejā mēs iegūsim dokumentus, kas pirmajā piegājienā ir gatavi vizualizēšanai Kibana. Mums trūks nākamā: tenant-id un schema-version), kas saturēja ierakstu no žurnāla, un mēs varam pievienot papildu lauku, kurā varētu būt, piemēram, lietojumprogrammas nosaukums, no kuras mēs vācam žurnālus.
Izvades filtrācijas posmā mēs saņemsim dokumentus, kas pirmajā piegājienā ir gatavi vizualizācijai Kibana. Mums trūks nākamā:
- Skaidru lauki tiks interpretēti kā teksts, kas neļauj veikt ar tiem darbības. Proti, lauki
time-takenIIS žurnāla, kā arī laukirecipient-countuntotal-bitesTracking žurnāla. - Dokumenta standarta laika stamps saturēs žurnāla apstrādes laiku, nevis tā ierakstīšanas laiku servera pusē.
- Lauks
recipient-addressizskatīsies kā viena būvju līnija, kas neļauj veikt analīzi ar e-pasta saņēmēju skaita saskaitīšanu.
Ir pienācis laiks pievienot nedaudz maģijas žurnālu apstrādes procesā.
Numerisko laukumu konvertācija
Dissect spraudnim ir opcija convert_datatype, ko var izmantot teksta lauka pārveidošanai ciparu formātā. Piemēram, tā:
dissect {
  …
  convert_datatype => { "time-taken" => "int" }
  …
}
Jāatceras, ka šī metode ir piemērota tikai tad, ja lauks noteikti saturēs virkni. Null vērtības no laukiem šī opcija neapstrādā un izraisīs izņēmumu.
Tracking žurnāliem līdzīga konvertēšanas metode labāk netikt izmantota, jo lauki recipient-count un total-bites var būt tukši. Šo lauku konvertēšanai labāk izmantot spraudni :
mutate {
  convert => [ "total-bytes", "integer" ]
  convert => [ "recipient-count", "integer" ]
}
recipient_address sadalīšana atsevišķos saņēmējos
Šo uzdevumu var arī atrisināt, izmantojot spraudni mutate:
mutate {
  split => ["recipient_address", ";"]
}
Laika zīmodža maiņa
Attiecībā uz Tracking žurnāliem uzdevums ļoti viegli tiek atrisināts ar spraudni , kas palīdzēs ierakstīt laukā laika zīmoga datumu un laiku vajadzīgā formātā no lauka date-time:
date {
  match => [ "date-time", "ISO8601" ]
  timezone => "Europe/Moscow"
  remove_field => [ "date-time" ]
}
Attiecībā uz IIS žurnāliem mums būs nepieciešams apvienot datu laukus date un time izmantojot spraudni mutate, norādīt vajadzīgo laika zonu un ievietot šo laika zīmodzi laika zīmoga ar spraudni date:
mutate {
  add_field => { "data-time" => "%{date} %{time}" }
  remove_field => [ "date", "time" ]
}
date {
  match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
  timezone => "UTC"
  remove_field => [ "data-time" ]
}
Izvade, reģistrs. Šajā projektā tie mums nebūs nepieciešami.
Izvade sekcija tiek izmantota, lai nosūtītu apstrādātos žurnālus žurnāla pieņēmējam. Ja sūtāt tieši uz Elastic, tiks izmantots spraudnis , kur tiek norādīta servera adrese un indeksu nosaukuma veidne, lai nosūtītu izveidoto dokumentu:
output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Beigu konfigurācija
Beigu konfigurācija izskatīsies šādi:
ievade {
  ritmi {
    osta => 5044
  }
}

filtres {
  ja "IIS" ir [tags] {
    izsmej {
      kartotne => {
        "ziņa" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      noņemt_lauku => ["ziņa"]
      pievienot_lauku => { "lietojums" => "apmaiņa" }
      pārvērst_datu_tipu => { "time-taken" => "int" }
    }
    mainīt {
      pievienot_lauku => { "data-time" => "%{date} %{time}" }
      noņemt_lauku => [ "date", "time" ]
    }
    datums {
      atbilst => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
      laika_zona => "UTC"
      noņemt_lauku => [ "data-time" ]
    }
  }
  ja "Izsekošana" ir [tags] {
    csv {
      kolonnas => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      noņemt_lauku => ["ziņa", "tenant-id", "schema-version"]
      pievienot_lauku => { "lietojums" => "apmaiņa" }
    }
    mainīt {
      pārvērst => [ "total-bytes", "integer" ]
      pārvērst => [ "recipient-count", "integer" ]
      sadalīt => ["recipient_address", ";"]
    }
    datums {
      atbilst => [ "date-time", "ISO8601" ]
      laika_zona => "Europe/Moscow"
      noņemt_lauku => [ "date-time" ]
    }
  }
}

izeja {
  elastīgs {
    viesi => ["127.0.0.1:9200", "127.0.0.2:9200"]
    pārvaldīt_templāti => false
    indekss => "Exchange-%{+YYYY.MM.dd}"
  }
}
Noderīgas saites:
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish