

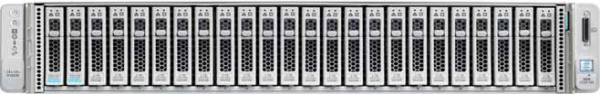
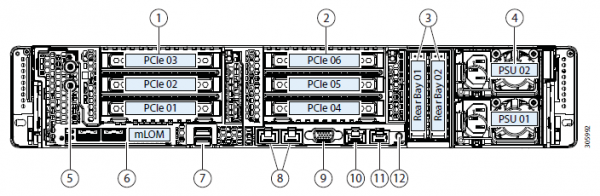
Tas ir mīts, kas diezgan izplatīts serveru aparatūras jomā. Tomēr praksē hiperkonverģentās risinājumi (kad viss ir vienā) ir nepieciešami daudzām lietām. Vēsturiski pirmās arhitektūras izstrādāja Amazon un Google saviem pakalpojumiem. Toreiz ideja bija izveidot skaitļošanas saimniecību no vienādiem mezgliem, katram no kuriem ir savi diski. Viss tika apvienots ar kādu sistēmas veidojošo programmatūru (hiper-vizoru) un sadalīts virtuālajās mašīnās. Galvenais mērķis ir minimāls darbs vienas mezglu apkalpošanai un minimālas problēmas mērogojot: vienkārši iegādājāties vēl tūkstoti vai divas tādu pašu serveru un pievienojat tos blakus. Praksē tas ir vienreizēji gadījumi, un daudz biežāk runa ir par mazāku mezglu skaitu un nedaudz citu arhitektūru.
Bet priekšrocība paliek tā pati — neticama mērogošanas un pārvaldības vienkāršība. Mīnuss ir tāds, ka dažādas uzdevumu veidi dažādi patērē resursus, un kaut kur lokālo disku būs daudz, kaut kur ir maz RAM un tā tālāk, tātad pie dažādiem uzdevumu veidiem samazinās resursu izmantošana.
Izrādījās, ka jūs maksājat par 10–15% vairāk par iestatīšanas ērtumu. Tas arī izraisīja mītu no virsraksta. Mēs ilgi meklējām, kur tehnoloģija būtu optimāli piemērojama, un atradām. Problēma bija tāda, ka Cisco nebija savu uzglabāšanas risinājumu, bet viņi vēlējās pilnu serveru tirgu. Un viņi izveidoja Cisco Hyperflex — risinājumu ar lokālajiem uzglabāšanas risinājumiem mezglos.
Un no tā iznāca ļoti labs risinājums rezerves datu centriem (Disaster Recovery). Kāpēc un kā — tagad to izstāstīšu. Un parādīšu klastera testus.
Kur nepieciešams
Hiperkonverģence — tas ir:
- Disku pārvietošana skaitļošanas mezglos.
- Pilnvērtīga datu uzglabāšanas sistēmas integrācija ar virtualizācijas sistēmu.
- Pārvietošana/integrācija ar tīkla sistēmu.
Šāda saikne ļauj realizēt daudzas glabāšanas sistēmas funkcijas virtualizācijas līmenī, un visu no viena vadības loga.
Mūsu uzņēmumā ir ļoti pieprasīti rezerves datu centru projektēšanas projekti, un bieži tiek izvēlēts tieši hiperkonverģents risinājums daudzās replikācijas opcijās (līdz metroklasterim) no tūlītējas pieejamības.
Datu centrā rezervācijas gadījumā parasti runa ir par attālinātu objektu citā pilsētas malā vai pat citā pilsētā. Tas ļauj atjaunot kritiskas sistēmas daļēja vai pilnīga galvenā datu centra (DC) atteikuma gadījumā. Dati pastāvīgi tiek replikēti no produkcijas, un šī replikācija var notikt gan lietojumprogrammas, gan blokšķiedras ierīces līmenī (SAS).
Tādēļ tagad stāstīšu par sistēmas uzbūvi un testiem, bet pēc tam par dažiem reāla pielietojuma scenārijiem ar ietaupīto datu informāciju.
Testi
Mūsu instance sastāv no četriem serveriem, katrā no kuriem ir 10 SSD diski ar 960 GB ietilpību. Ir atsevišķs disks rakstīšanas operāciju kešēšanai un pakalpojuma virtuālās mašīnas glabāšanai. Pašreizējais risinājums ir ceturtā versija. Pirmais bija acīmredzami neizstrādāts (saskaņā ar atsauksmēm), otrais ir joprojām neizstrādāts, trešais jau ir pietiekami stabils, bet šo var uzskatīt par versiju pēc beta testēšanas pabeigšanas plašai auditorijai. Testēšanas laikā problēmu man nebija, viss strādā nevainojami.
Izmaiņas v4Novērsta vairums kļūdu.
Sākotnēji platforma varēja darboties tikai ar hipervizoru VMware ESXi un atbalstīja nelielu skaitu mezglu. Turklāt izvietošanas process tālu ne vienmēr beidzās veiksmīgi, nācās restartēt dažus soļus, bija problēmas atjauninot no vecākām versijām, dati GUI ne vienmēr tika attēloti pareizi (lai gan es joprojām neesmu apmierināts ar veiktspējas grafiku attēlošanu), dažreiz bija problēmas saskares vietās ar virtualizāciju.
Tagad visas bērnu slimības ir novērstas, HyperFlex atbalsta gan ESXi, gan Hyper-V, turklāt iespējami:
- Izveidot izpletni klasteri.
- Izveidot klasteri birojiem, neizmantojot Fabric Interconnect, no diviem līdz četriem mezgliem (iegādājamies tikai serverus).
- Iespēja strādāt ar ārējiem SAS.
- Atbalsts konteineriem un Kubernetes.
- Izveidot pieejamības zonas.
- Integrācija ar VMware SRM, ja iebūvētais funkcionalitāte neapmierina.
Architektūra būtiski neatšķiras no galveno konkurentu risinājumiem, un velosipēdu nav izstrādājuši. Tas viss darbojas uz VMware vai Hyper-V virtualizācijas platformas. Aparatūra ir izvietota uz Cisco UCS izstrādātajiem serveriem. Ir tādi, kuri ienīst platformu par relatīvo sarežģītību sākotnējā iestatījumā, daudzām pogām, netriviālo veidņu un atkarību sistēmu, bet ir arī tie, kuri ir iepazinušies ar zen, ieinteresējušies par ideju un vairs nevēlas strādāt ar citiem serveriem.
Mēs apskatīsim risinājumu tieši VMware, jo tas tika sākotnēji izstrādāts tieši tam un tam ir lielāka funkcionalitāte, bet Hyper-V izstrādāta pa ceļam, lai nesāktu atpalikt no konkurentiem un atbilstu tirgus cerībām.
Ir klasteris no serveriem, kas piepildīti ar diskiem. Ir diskus datu glabāšanai (SSD vai HDD — kā jums patīk un kādas ir jūsu vajadzības), un ir viens SSD disks kešatmiņai. Ierakstot datus datu krātuvē, dati tiek saglabāti kešatmiņas slānī (veltīts SSD disks un RAM servisa VM). Paralēli datu bloks tiek sūtīts uz klastera mezgliem (mezglu skaits atkarīgs no klastera replikācijas faktora). Pēc apstiprinājuma no visiem mezgliem par veiksmīgu ierakstu apstiprinājuma e-pasts tiek nosūtīts hipervizoram un tālāk — VM. Ierakstītie dati fonā tiek deduplicēti, saspiežami un ierakstīti glabāšanas diskos. Tajā pašā laikā uz glabāšanas diskiem vienmēr tiek ierakstīts liels bloks secīgi, kas samazina slodzi uz glabāšanas diskiem.
Deduplication un kompresija ir pastāvīgi ieslēgti, un tos nevar izslēgt. Datu lasīšana notiek tieši no glabāšanas diskiem vai no RAM kešatmiņas. Ja tiek izmantota hibrīda konfigurācija, tad lasīšana arī tiek kešota uz SSD diska.
Dati nav piesaistīti pašreizējai virtuālās mašīnas atrašanās vietai un tiek sadalīti starp mezgliem vienmērīgi. Šāda pieeja ļauj vienmērīgi noslogot visus diskus un tīkla interfeisus. Vēl viens acīmredzams trūkums ir: mēs nevaram maksimāli samazināt lasīšanas aizkavi, jo nav garantijas par datu pieejamību lokāli. Bet es uzskatu, ka tas ir nenozīmīgs upuris salīdzinājumā ar iegūtajiem ieguvumiem. Turklāt tīkla aizkaves ir sasniegušas tādas vērtības, ka praktiski neietekmē kopējo rezultātu.
Par visu diskosistēmas loģiku atbild īpaša pakalpojumu VM Cisco HyperFlex Data Platform controller, kas tiek izveidota katrā glabāšanas mezglā. Mūsu konfigurācijā pakalpojumu VM tika piešķirti astoņi vCPU un 72 GB RAM, kas nav nemaz tik maz. Atgādinu, ka pašam hostam ir pieejami 28 fiziski kodoli un 512 GB RAM.
Pakalpojumu VM piekļūst fiziskajiem diskam tieši, izmantojot SAS kontroliera pārbīdīšanu uz VM. Saziņa ar hipervizoru notiek caur īpašu IOVisor moduli, kas uztver I/O operācijas, un, izmantojot aģentu, kas ļauj nosūtīt komandas hipervizora API. Aģents atbild par darbu ar HyperFlex momentuzņēmumiem un kloniem.
Hipervizorā diskresursi tiek montēti kā NFS vai SMB koplietošanas (atkarībā no hipervizora veida, uzminiet, kurš kur). Bet zem vāka tā ir izkliedēta failu sistēma, kas ļauj pievienot pieaugušiem pilnīgām SDD: plāna apjoma piešķiršanu, saspišanu un deduplicēšanu, momentuzņēmumus ar Redirect-on-Write tehnoloģiju, sinhrono/asinhrono replikāciju.
Pakalpojumu VM nodrošina piekļuvi HyperFlex apakšsistēmas pārvaldības WEB interfeisam. Ir integrācija ar vCenter, un lielāko daļu ikdienas uzdevumu var veikt no tā, taču datu veikali, piemēram, ērtāk ir sagriezt no atsevišķas tīmekļa lapas, ja esat jau pārgājuši uz ātru HTML5 interfeisu, vai izmantot pilnvērtīgu Flash klientu ar pilnu integrāciju. Pakalpojumu tīmekļa lapā var apskatīt sistēmas veiktspēju un detalizētu statusu.
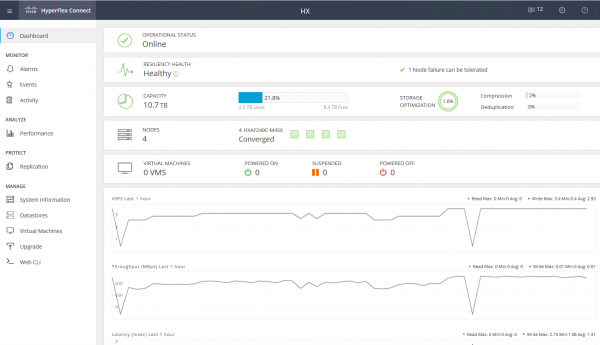
Ir arī cita veida mezgli klasterī — skaitļošanas mezgli. Tie var būt rack vai blade serveri bez iebūvētiem diskiem. Šajos serveros var darbināt VM, kuru dati tiek glabāti serveros ar diskiem. Piekļuves datiem ziņā starp mezglu veidiem nav atšķirības, jo arhitektūra paredz abstrakciju no datu fiziskā izvietojuma. Maksimālais skaitļošanas mezglu un glabāšanas mezglu attiecība ir 2:1.
Skaitļošanas mezglu izmantošana palielina elastību, paplašinot klastera resursus: mums nav obligāti jāiegādājas mezgli ar diskiem, ja mums ir vajadzības tikai pēc CPU/RAM. Turklāt mēs varam pievienot blade grozu un iegūt ietaupījumus serveru novietošanā skapī.
Kā rezultātā mums ir hiperkonverģenta platforma ar šādām funkcijām:
- Līdz 64 mezgliem klasterī (līdz 32 uzglabāšanas mezgliem).
- Minimālais mezglu skaits klasterī ir trīs (divi — Edge klasterim).
- Datu redundances mehānisms: mirroring ar replikācijas faktoru 2 un 3.
- Metro klasteris.
- Asinhronā VM replikācija citā HyperFlex klasterī.
- Orkestrācija VM pārlēkšanai uz attālo datu centru.
- Native snapshot, izmantojot Redirect-on-Write tehnoloģiju.
- Līdz 1 PB noderīgā apjoma ar replikācijas faktoru 3 un neņemot vērā deduplikāciju. Replikācijas faktors 2 netiek ņemts vērā, jo tas nav nopietns pārdošanas variants.
Vēl viens liels ieguvums — vadības un izvietošanas vienkāršība. Visas UCS serveru konfigurācijas sarežģītības uzņemas specializēta VM, ko sagatavojuši Cisco inženieri.
Testēšanas standarta konfigurācija:
- 2 x Cisco UCS Fabric Interconnect 6248UP kā vadības klasteris un tīkla komponenti (48 porti, kas darbojas 10G Ethernet/16G FC režīmā).
- Četri Cisco UCS HXAF240 M4 serveri.
Serveru specifikācijas:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Tīkls
UCSC-MLOM-CSC-02 (VIC 1227). 2 10G Ethernet porti
Glabātuves HBA
Cisco 12G Modular SAS Pass Through Controller
Glabātuves diski
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Vairāk konfigurāciju iespējuPapildus izvēlētajai aparatūrai pašlaik ir pieejamas šādas iespējas:
- HXAF240c M5.
- Viens vai divi CPU no Intel Silver 4110 līdz Intel Platinum I8260Y. Pieejams otrais paaudzes.
- 24 atmiņas slots, modulis no 16 GB RDIMM 2600 līdz 128 GB LRDIMM 2933.
- No 6 līdz 23 diskiem datiem, viens kešatmiņas disks, viens sistēmas un viens starta disks.
Jauda diski
- HX-SD960G61X-EV 960 GB 2.5 collu Enterprise Value 6G SATA SSD (1X izturība) SAS 960 GB.
- HX-SD38T61X-EV 3.8 TB 2.5 collu Enterprise Value 6G SATA SSD (1X izturība) SAS 3.8 TB.
- Kešatmiņas diski
- HX-NVMEXPB-I375 375 GB 2.5 collu Intel Optane disks, augsta veiktspēja un izturība.
- HX-NVMEHW-H1600* 1.6 TB 2.5 collu Ent. Perf. NVMe SSD (3X izturība) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400 GB 2.5 collu Ent. Perf. 12G SAS SSD (10X izturība) SAS 400 GB.
- HX-SD800GBENK9** 800 GB 2.5 collu Ent. Perf. 12G SAS SED SSD (10X izturība) SAS 800 GB.
- HX-SD16T123X-EP 1.6 TB 2.5 collu Enterprise performance 12G SAS SSD (3X izturība).
Sistēmas / žurnāla diski
- HX-SD240GM1X-EV 240 GB 2.5 collu Enterprise Value 6G SATA SSD (prasa uzlabojumu).
Starta diski
- HX-M2-240GB 240 GB SATA M.2 SSD SATA 240 GB.
Tīkla savienojums caur 40G, 25G vai 10G Ethernet portiem.
Kā FI var būt HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Pats tests
Disku apakšsistēmas testēšanai es izmantoju HCIBench 2.2.1. Tas ir bezmaksas rīks, kas ļauj automātiski izveidot slodzi no vairākām virtuālajām mašīnām. Paša slodze tiek ģenerēta ar parasto fio.
Mūsu klasteris sastāv no četriem mezgliem, replikācijas faktors 3, visi diski ir Flash.
Testēšanai es izveidoju četrus datu krātuves un astoņas virtuālās mašīnas. Ierakstu testiem tiek pieņemts variants, kad kešatmiņas disks nenokļūst pilns.
Testa rezultāti ir šādi:
100 % Lasīt 100 % Nejauša
0 % Lasīt 100% Nejauša
Bloks/izsistās dziļums
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Boldā izceltie skaitļi norāda uz vērtībām, pēc kurām veiktspēja vairs nepalielinās, dažkārt pat var redzēt degradāciju. Tas saistīts ar to, ka nonākam līdz tīkla/kontroliera/diska veiktspējai.
- Secinājums lasot 4432 MB/s.
- Secinājums rakstot 804 MB/s.
- Ja viens kontrolieris neizdodas (kā kontroliera vai viesdatora atteice), veiktspēja samazinās līdz pusei.
- Ja uzglabāšanas disks neizdodas — veiktspēja samazinās par 1/3. Disku pārbūve aizņem 5% resursu katram kontrolierim.
Nelielā blokā mēs nonākam pie kontroliera veiktspējas (virtuālā mašīna), tā CPU ir noslogots par 100%, palielinot bloku, mēs sasniedzam pārsūtīšanas jaudas pielaidumu. 10 Gbit/s nav pietiekami, lai atklātu AllFlash sistēmas potenciālu. Diemžēl 40 Gbit/s pārbaude nav iespējama sniegto demo stenda parametru dēļ.
Mani iespaidi no testiem un arhitektūras izpētes rāda, ka pateicoties algoritmam, kas izplata datus starp visiem hostiem, mēs iegūstam skalojamu, paredzamu veiktspēju, taču tas ir ierobežojums lasīšanai, jo no lokālajiem diskiem varētu iegūt vairāk, šeit varētu palīdzēt efektīvāka tīkls, piemēram, pieejamie FI uz 40 Gbit/s.
Tāpat viens disks kešošanai un deduplication var būt ierobežojošs, faktiski šajā stendā mēs varam rakstīt uz četriem SSD diskiem. Būtu lieliski, ja būtu iespēja palielināt kešojošo disku skaitu un redzēt atšķirību.
Reāla izmantošana
Apakšcentrālo visu jomu rezervēšanai var izmantot divus pieejas veidus (nenorādām rezerves kopijas izvietojumu attālinātā vietā):
- Aktīvs-Pasīvs. Visas lietojumprogrammas tiek izvietotas galvenajā datu centrā. Replikācija ir sinhrona vai asinhrona. Galvenā datu centra sabrukuma gadījumā mums jāaktivizē rezervētā. To var izdarīt manuāli/skribentiem/orķestrācijas lietotnēm. Šeit mēs iegūsim RPO, kas ir salīdzināms ar replikācijas biežumu, un RTO ir atkarīgs no administratora reakcijas un prasmēm, kā arī no plāna pārslēgšanas izstrādes/uzlabošanas kvalitātes.
- Aktīvs-Aktīvs. Šajā gadījumā ir pieejama tikai sinhrona replikācija, datu centru pieejamība tiek noteikta pēc kvoruma/arbitra, kas atrodas stingri trešajā vietā. RPO = 0, bet RTO var sasniegt 0 (ja lietojumprogramma to atļauj) vai ir vienāds ar nodaļa izbēgšanas apstrādes laiku virtualizācijas klasterī. Virtualizācijas līmenī tiek izveidots garš (Metro) klasteris, kas prasa Aktīvs-Aktīvs datu uzglabāšanas sistēmu.
Parasti mēs redzam pie klientiem jau īstenotu arhitektūru ar klasisku datu uzglabāšanas sistēmu galvenajā datu centrā, tāpēc projektējam vēl vienu replikācijai. Kā jau minēju, Cisco HyperFlex piedāvā asimetrisku replikāciju un garā klastera izveidi virtualizācijā. Tajā pašā laikā mums nav nepieciešama atsevišķa vidējo datu uzglabāšanas sistēmu un augstākas klases ar dārgām replikācijas un Aktīvs-Aktīvs datu pieejamības funkcijām uz divām datu uzglabāšanas sistēmām.
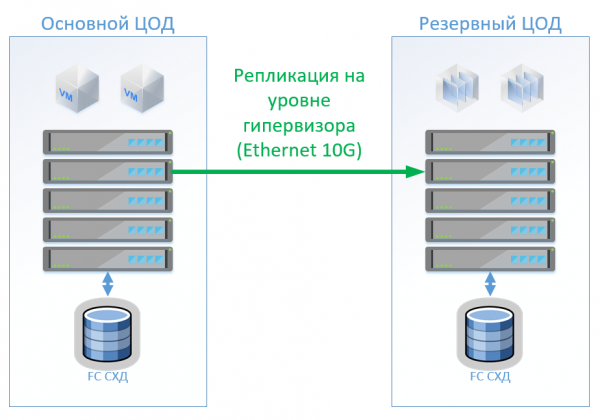
Scenārijs 1: Mums ir galvenie un rezerves datu centri, VMware vSphere virtualizācijas platforma. Visas ražošanas sistēmas atrodas galvenajā datu centrā, un virtuālo mašīnu replikācija notiek hipervizora līmenī, kas ļaus nezaudēt VM rezervētajā datu centrā. Datu bāzes un speciālās lietojumprogrammas tiek replikētas ar iebūvētiem līdzekļiem, un mēs turam VM ieslēgtas. Galvenā datu centra sabrukuma gadījumā aktivizējam sistēmas rezerves datu centrā. Mēs uzskatām, ka mums ir apmēram 100 virtuālo mašīnu. Kamēr galvenais datu centrs darbojas, rezerves datu centrā var ieslēgt testēšanas vidēs un citas sistēmas, kuras var atslēgt galvenā datu centra pārslēgšanas gadījumā. Tāpat ir iespējams variants, ka mēs izmantojam divvirzienu replikāciju. No aprīkojuma viedokļa nekas nemainīsies.
Klasiskajā arhitektūrā mēs katrā datu centrā uzstādīsim hibrīdo uzglabāšanas sistēmu ar piekļuvi, izmantojot FibreChannel, datu plūsmu, datu atdublēšanu un kompresiju (bet ne tiešsaistē), 8 serverus katrā vietā, pa 2 FibreChannel un 10G Ethernet slēgvietām. Replikācijai un pārvaldei klasiskajā arhitektūrā varam izmantot VMware rīkus (Replication + SRM) vai arī trešo pušu rīkus, kas būs nedaudz lētāki un dažreiz ērtāki.
Zīmē ir parādīta shēma.
Ja izmantojam Cisco HyperFlex, tad iegūstam sekojošo arhitektūru:
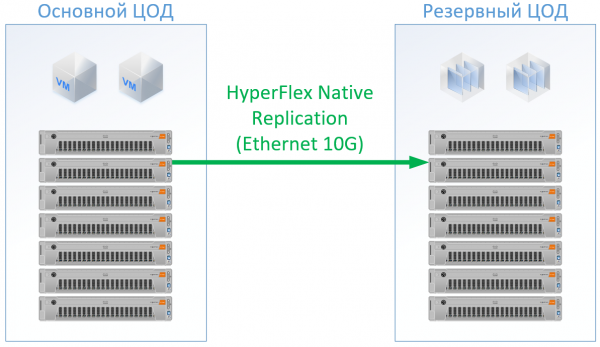
HyperFlex esmu izmantojis serverus ar lieliem CPU/RAM resursiem, jo daļa resursu tiks izmantota HyperFlex kontroliera VM, CPU un atmiņas konfigurācijā es pat nedaudz pārbaudīju resursus, lai neizsniegtu priekšrocības Cisco un garantētu resursus pārējiem VM. Tātad mēs varam atteikties no FibreChannel slēgvietām, un mums nav nepieciešami Ethernet porti katram serverim, lokālās datu plūsmas tiek pārslēgtas iekšējā FI.
Rezultātā sanāca sekojoša konfigurācija katram datu centram:
Serveri
8 x 1U serveris (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Glabāšanas sistēma
Hibrīda uzglabāšanas sistēma ar FC Front-End (20 TB SSD, 130 TB NL-SAS)
—
LAN
2 x 10G 12 portu Ethernet slēgvietas
—
SAN
2 x 32/16Gb 24 portu FC slēgvietas
2 x Cisco UCS FI 6332
Licences
VMware Ent Plus
Replikācija un/vai VM pārslēgšanas orķestrācija
VMware Ent Plus
Hyperflex esmu neiekļāvis licences replikāciju programmatūrai, jo mums tas ir pieejams kā standarts.
Klasiskajā arhitektūrā izvēlējos piegādātāju, kurš sevi ir apliecinājis kā kvalitatīvu un lētu ražotāju. Abiem variantiem pielietoju standarta atlaidi konkrētajam risinājumam, rezultātā guvu reālas cenas.
Risinājums uz Cisco HyperFlex izrādījās par 13% lētāks.
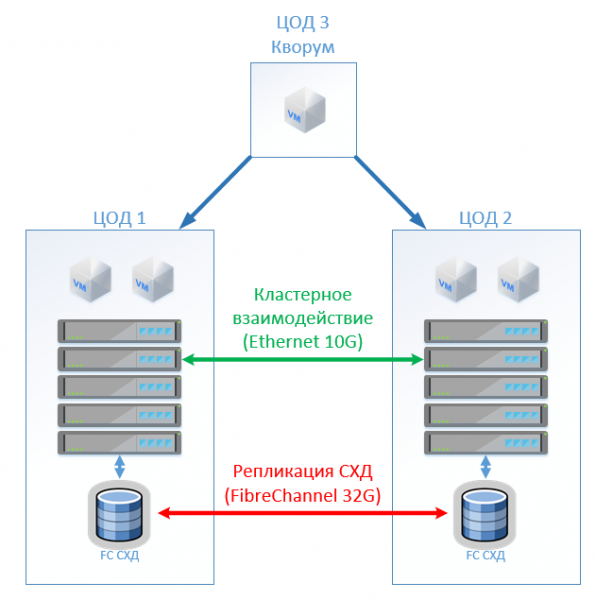
Scenārijs 2: divu aktīvo datu centru izveide. Šajā scenārī projektējam izplestu klasteri uz VMware.
Klasiskā arhitektūra sastāv no virtualizācijas serveriem, SAN (FC protokols) un divām uzglabāšanas sistēmām, kas prot nolasīt un rakstīt uz tā, kas ir izplešams starp tām. Katrā uzglabāšanas sistēmā ieplānojām noderīgo kapacitāti lokālai izmantošanai.
HyperFlex mēs vienkārši izveidojam izplešamo klasteri ar vienādu nodu skaitu abās vietās. Šajā gadījumā tiek izmantots replikācijas faktors 2+2.
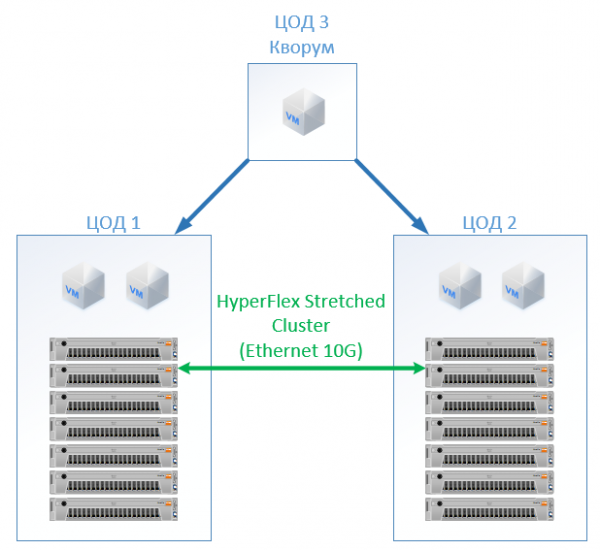
Sanāca sekojoša konfigurācija:
Klasiskā arhitektūra
HyperFlex
Serveri
16 x 1U serveris (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Glabāšanas sistēma
2 x AllFlash uzglabāšanas sistēmas (150 TB SSD)
—
LAN
4 x 10G 24 portu Ethernet slēgvietas
—
SAN
4 x 32/16Gb 24 portu FC slēgvietas
4 x Cisco UCS FI 6332
Licences
VMware Ent Plus
VMware Ent Plus
Visos aprēķinos es neesmu ņēmis vērā tīkla infrastruktūru, datu centrus u.t.t.: tie būs vienādi klasiskajā arhitektūrā un risinājumā uz HyperFlex.
Attiecībā uz izmaksām HyperFlex izrādījās par 5% dārgāks. Jāatzīmē, ka attiecībā uz CPU/RAM resursiem man Cisco rezultāts iznāca ne līdzsvarots, jo konfigurācijā es izlīdzināju atmiņas kontrolieru kanālus. Cena nedaudz augstāka, bet ne par kārtu, kas skaidri norāda, ka hiper-konvergences risinājums nav obligāti „bagātnieku rotaļlieta”, bet var konkurēt ar standarta pieeju datu centru izveidei. Tas var būt interesanti arī tiem, kam jau ir Cisco UCS serveri un atbilstoša infrastruktūra.
Priekšrocībās mēs iegūstam to, ka nav izmaksu par SAN un STH administrēšanu, tiešsaistes kompresiju un deduplikāciju, vienotu atbalsta ieejas punktu (virtualizācija, serveri, tie paši – STH), vietas ekonomiju (bet ne visos scenārijos), ekspluatācijas vienkāršošanu.
Attiecībā uz atbalstu, jūs to saņemat no viena piegādātāja — Cisco. Balstoties uz pieredzi ar Cisco UCS serveriem, man tā patika, HyperFlex atvērt man nevajadzēja, viss strādāja. Inženieri reaģē ātri un var risināt ne tikai tipiskas problēmas, bet arī sarežģītus robežgadījumus. Dažreiz es viņiem uzdodu jautājumus: „Vai tā var izdarīt, pievienojot to?” vai „Es šeit kaut ko konfigurēju un tas nevēlas darboties. Palīdziet!” — viņi tur pacietīgi atradīs nepieciešamo rokasgrāmatu un norādīs pareizas darbības, atbildēt: „Mēs risinām tikai aparatūras problēmas” viņi neizdarīs.
Saites
- Mana e-pasta adrese — StGeneralov@croc.ru
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish