

Pirms kursa uzsākšanas sagatavojuši jums tulkojumu vēl vienam noderīgam materiālam.
Hafmana kodēšana ir datu saspiešanas algoritms, kas formulē pamata ideju par failu saspiešanu. Šajā rakstā mēs runāsim par fiksētas un mainīgas garuma kodēšanu, unikāli dekodējamiem kodiem, prefiksu noteikumiem un Hafmana koka būvēšanu.
Mēs zinām, ka katrs ieraksts tiek glabāts kā secība no 0 un 1 un aizņem 8 bitus. To dēvē par fiksētas garuma kodēšanu, jo katrs ieraksts izmanto vienādu fiksētu bitu skaitu glabāšanai.
Pieņemsim, ka ir dots teksts. Kā mēs varam samazināt nepieciešamo vietu, lai glabātu vienu simbolu?
Pamats ir mainīgas garuma kodēšanā. Mēs varam izmantot faktu, ka daži simboli tekstā parādās biežāk nekā citi (), lai izstrādātu algoritmu, kas attēlo to pašu simbolu secību ar mazāku bitu skaitu. Mainīgas garuma kodēšanā mēs piešķiram simboliem mainīgu bitu skaitu atkarībā no to parādīšanās biežuma attiecīgajā tekstā. Beigās daži simboli var aizņemt tikai 1 bitu, bet citi - 2, 3 vai vairāk. Problēma ar mainīgas garuma kodēšanu ir tikai secīgā dekodēšana.
Kā, zinot bitu secību, to dekodēt bez neskaidrībām?
Apskatīsim virkni «aabacdab». Tajā ir 8 simboli, un fiksētas garuma kodēšanai tās glabāšanai būs vajadzīgi 64 bīti. Pamanīsim, ka simbolu biežums «a», «b», «c» un «d» ir attiecīgi 4, 2, 1, 1. Mēģināsim attēlot «aabacdab» ar mazāku bitu skaitu, izmantojot faktu, ka «a» parādās biežāk nekā «b», bet «b» parādās biežāk nekā «c» un «d». Sāksim ar to, ka kodēsim «a» ar vienu bitu, kas ir 0, «b» mēs piešķirsim divu bitu kodu 11, bet ar trīs bitiem 100 un 011 kodēsim «c» un «d».
Galu galā mēs iegūsim:
a
0
b
11
c
100
d
011
Tādējādi virkni «aabacdab» mēs kodēsim kā 00110100011011 (0|0|11|0|100|011|0|11), izmantojot iepriekš minētos kodus. Tomēr galvenā problēma būs dekodēšanā. Kad mēs mēģināsim dekodēt virkni 00110100011011, mums būs neskaidrs rezultāts, jo to var attēlot kā:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
utt.
Lai novērstu šo neskaidrību, mums ir jāgarantē, ka mūsu kodēšana atbilst tādai koncepcijai kā priekšmeta noteikums, kas savukārt nozīmē, ka kodi var tikt dekodēti tikai vienā unikālā veidā. Priekšmeta noteikums garantē, ka neviens kods nebūs cita prefikss. Ar kodu mēs saprotam bitus, kas tiek izmantoti konkrēta simbola attēlošanai. Augstāk minētajā piemērā 0 – tas ir priekšmets 011, kas pārkāpj priekšmeta noteikumu. Tātad, ja mūsu kodi atbilst priekšmeta noteikumiem, tad var veikt viennozīmīgu dekodēšanu (un otrādi).
Pārskatīsim iepriekšējo piemēru. Šoreiz mēs piešķirsim simboliem «a», «b», «c» un «d» kodus, kas atbilst priekšmeta noteikumiem.
a
0
b
10
c
110
d
111
Izmantojot šādu kodēšanu, virkni «aabacdab» tiks kodēta kā 00100100011010 (0|0|10|0|100|011|0|10). Bet 00100100011010 mēs jau varēsim viennozīmīgi dekodēt un atgriezties pie mūsu sākotnējās virknes «aabacdab».
Hafmana kodēšana
Tagad, kad esam apguvuši mainīgā garuma kodēšanu un priekšmeta noteikumu, runāsim par Huffmaņa kodēšanu.
Šī metode balstās uz bināro koku veidošanu. Tajā mezgls var būt gan beigu, gan iekšējs. Sākotnēji visi mezgli tiek uzskatīti par lapām (beigu), kuras attēlo pašu simbolu un tā svaru (t.i., parādīšanās biežumu). Iekšējie mezgli satur simbola svaru un norāda uz diviem bērnu mezgliem. Saskaņā ar vispārēju vienošanos bits «0» apzīmē sekošanu pa kreiso zaru, bet «1» — pa labo. Pilnīgā kokā N ir lapas un N-1 iekšējie mezgli. Ieteicams, veidojot Huffmaņa koku, noraidīt neizmantotās simbolus, lai iegūtu optimālas garuma kodus.
Mēs izmantosim prioritāšu rindu, lai izveidotu Huffmaņa koku, kur mezglam ar zemāko biežumu tiks piešķirta augstākā prioritāte. Zemāk aprakstīti būvēšanas soļi:
- Izveidojiet lapu mezglu katram simbolam un pievienojiet tos prioritāšu rindai.
- Kamēr rindā ir vairāk nekā viens lapu mezgls, darām sekojošo:
- Noņemiet divus mezglus ar augstāko prioriteti (ar viszemāko biežumu) no rindas;
- Izveidojiet jaunu iekšējo mezglu, kur šie divi mezgli būs bērni, un parādīšanās biežums būs vienāds ar šo divu mezglu biežumu summu.
- Pievienojiet jauno mezglu prioritāšu rindai.
- Vienīgais atlikušo mezgls būs saknes mezgls, šajā brīdī koka būve beigsies.
Pieņemsim, ka mums ir teksts, kas sastāv tikai no simboliem «a», «b», «c», «d» un «e», un to parādīšanās biežums ir 15, 7, 6, 6 un 5 attiecīgi. Zemāk ir ilustrācijas, kas parāda algoritma soļus.
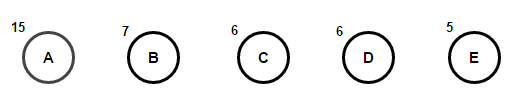
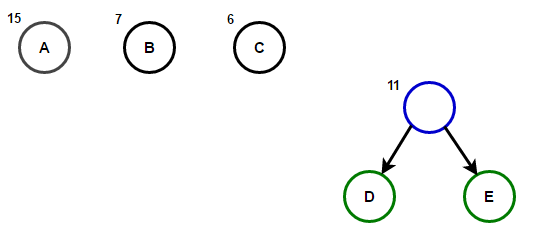
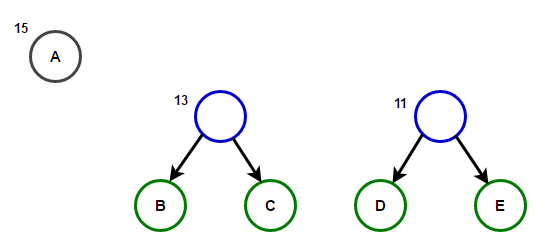
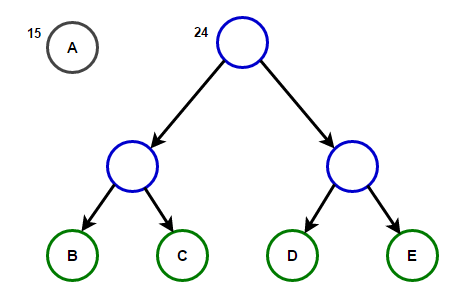
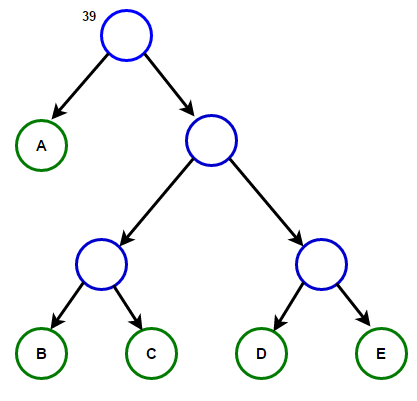
Ceļš no saknes līdz jebkuram galapunktam glabās optimālo prefiksu kodu (tā arī saukto Huffmana kodu), kas attiecas uz simbolu, kas saistīts ar šo galapunktu.
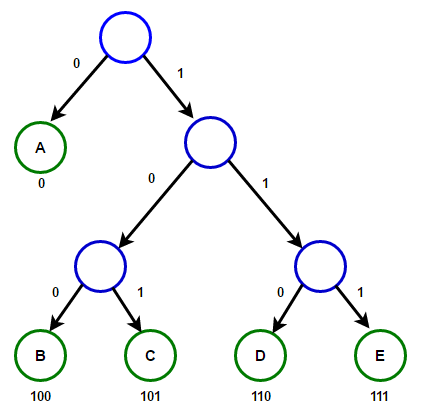
Huffman koks
Zemāk jūs atradīsiet Huffmana saspiešanas algoritma realizāciju valodās C++ un Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Koka mezgls
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Apstrādā Huffman koku un saglabā Huffman kodus
// kartē.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// atrasts lapu mezgls
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Apstrādā Huffman koku un atšifrē kodēto virkni
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// atrasts lapu mezgls
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Izveido Huffman koku un huffmanCode un atšifrē dotu ieejas tekstu
public static void buildHuffmanTree(String text)
{
// saskaita katra simbolu rašanās biežumu
// un saglabā to kartē
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Izveido prioritātes rindu, lai saglabātu dzīvos mezglus Huffman kokā
// Pievērsiet uzmanību, ka augstākā prioritāte ir viszemākā biežums
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Izveidojiet lapu mezglu katram simbolam un pievienojiet to
// prioritātes rindai.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// turpina, kamēr rindā nav vairāk kā viens mezgls
while (pq.size() != 1)
{
// noņemiet divus augstākās prioritātes mezglus
// (viszemākais biežums) no rindas
Node left = pq.poll();
Node right = pq.poll();
// Izveidojiet jaunu iekšēju mezglu, pievienojot šos divus mezglus kā bērnus
// un ar biežumu, kas vienāds ar šo divu mezglu
// biežumu summu. Pievienojiet jauno mezglu prioritātes rindai.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// sakne glabā rādītāju uz Huffman koka sakni
Node root = pq.peek();
// apstrādā Huffman koku un saglabā Huffman kodus kartē
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// izdrukā Huffman kodus
System.out.println("Huffman kods ir :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nOriginalais teksts bija :\n" + text);
// izdrukā kodēto virkni
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nKodētā virkne ir :\n" + sb);
// vēlreiz apstrādā Huffman koku un šoreiz
// atšifrē kodēto virkni
int index = -1;
System.out.println("\nAtšifrētā virkne ir: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffman kodēšana ir datu kompresijas algoritms.";
buildHuffmanTree(text);
}
}Piezīme: Ievadītās virsmas izmantotā atmiņa ir 47 * 8 = 376 biti, bet kodētais virsraksts aizņem tikai 194 bitus, t.i., dati tiek saspiesti aptuveni par 48%. C++ programmā augstāk mēs izmantojam string klasi, lai uzglabātu kodēto virsrakstu un padarītu programmu lasāmāku.
Tā kā efektīvām datu struktūrām ar prioritāriem rindām nepieciešams O(log(N)) laiks, un pilnīgā binārajā kokā ar N lapām ir 2N-1 mezgli, un Huffmaņa kokam ir pilnīga binārā koka struktūra, tad algoritms darbojas O(Nlog(N)) laikā, kur N – ir simbolu skaits.
Avoti:
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish