

Laika datu bāze (TSDB, time series database) Prometheus 2 ir lielisks inženierijas risinājums, kas piedāvā būtiskus uzlabojumus salīdzinājumā ar v2 krātuvi Prometheus 1 attiecībā uz datu uzkrāšanas ātrumu un vaicājumu izpildi, resursu izmantošanas efektivitāti. Mēs ieviešam Prometheus 2 Percona Monitoring and Management (PMM), un man bija iespēja izpētīt Prometheus 2 TSDB veiktspēju. Šajā rakstā es pastāstīšu par šo novērojumu rezultātiem.
Vidējā slodze Prometheus
Tie, kas ir pieraduši strādāt ar galveno datu bāzēm, noteikti atradīs, ka parastā Prometheus slodze ir diezgan interesanta. Datu uzkrāšanas ātrums tendējas uz stabilu vērtību: parasti pakalpojumi, kurus jūs uzraugāt, nosūta apmēram vienādu metrikas daudzumu, un infrastruktūra mainās salīdzinoši lēni.
Informācijas vaicājumi var nākt no dažādiem avotiem. Daži no tiem, piemēram, brīdinājumi, arī tendējas uz stabilu un paredzamu vērtību. Citi, piemēram, lietotāju vaicājumi, var izraisīt uzplūdus, lai gan tas nav raksturīgi lielākajai daļai slodzes.
Slodzes tests
Testēšanas laikā es koncentrējos uz datu uzkrāšanas spēju. Es izvietoju Prometheus 2.3.2, kas tika salikts ar Go 1.10.1 (kā daļa no PMM 1.14) Linode pakalpojumā, izmantojot šo skriptu: . Lai maksimāli reāli ģenerētu slodzi, izmantojot šo es palaidu vairākas MySQL mezglu ar reālu slodzi (Sysbench TPC-C Test), katrs no tiem emulēja 10 Linux/MySQL mezglu.
Visi turpmākie testi tika veikti serverī Linode ar astoņiem virtuāliem kodoliem un 32 GB atmiņas, uz kura tika palaisti 20 slodzes simulācijas, uzraugot divsimt MySQL instanču. Vai, Prometheus valodā, 800 mērķi (targets), 440 uzkrāšana (scrapes) sekundē, 380 tūkstoši ierakstu (samples) sekundē un 1,7 miljoni aktīvo laika rindu.
Dizains
Parastā pieeja tradicionālajām datu bāzēm, ieskaitot to, ko izmantoja Prometheus 1.x, ir . Ja tā nepietiek slodzes izpildei, jūs saskarsities ar lieliem aizkavējumiem, un daži vaicājumi netiks izpildīti. Atmiņas izmantošana Prometheus 2 tiek konfigurēta, izmantojot atslēgu storage.tsdb.min-block-duration, kas nosaka, cik ilgi ieraksti tiks glabāti atmiņā pirms pārsūtīšanas uz disku (noklusējuma iestatījums ir 2 stundas). Nepieciešamā atmiņa būs atkarīga no laika rindām, etiķetēm (labels) un datu vākšanas intensitātes (scrapes) kopā ar tīro ienākošo plūsmu. Disku platības plānā Prometheus mērķē izmantot 3 baiti uz ierakstu (sample). No otras puses, prasības attiecībā uz atmiņu ir ievērojami augstākas.
Neskatoties uz to, ka ir iespēja konfigurēt bloka izmēru, to manuāli iestatīt nav ieteicams, tāpēc jums jāsniedz Prometheus tik daudz atmiņas, cik tas lūgs jūsu slodzei.
Ja atmiņas nepietiks, lai uzturētu ienākošo metrikas plūsmu, Prometheus saskarsies ar out of memory vai tiks izsistīts no atmiņas (OOM killer).
Swapa pievienošana, lai atliktu brīdi, kad Prometheus beigsies atmiņa, īpaši nemaz nepalīdz, jo šīs funkcijas izmantošana izraisa strauju atmiņas patēriņu. Es domāju, ka tas ir saistīts ar Go, tā garbage collector un to, kā tas darbojas ar swap.
Cits interesants piegājiens ir noregulēt head block pārsūtīšanu uz disku noteiktā laikā, nevis skaitīt to no procesa sākuma.
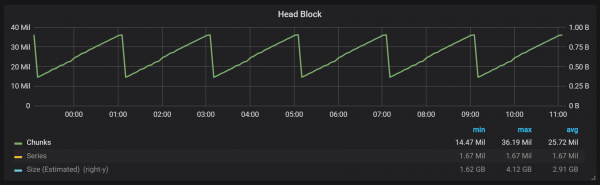
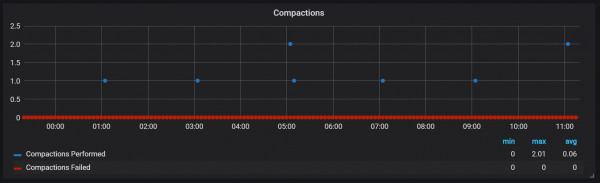
Kā redzat no grafika, pārsūtīšanas uz disku notiek ik pēc divām stundām. Ja mainīsit parametru min-block-duration uz vienu stundu, šie pārsūtījumi notiks katru stundu, sākot pēc pusstundas.
Ja vēlaties izmantot šo un citus grafikus savā Prometheus instalācijā, varat izmantot šo . Tas tika izstrādāts PMM, taču, ar dažām nelielām izmaiņām, tas ir piemērots jebkurai Prometheus instalācijai.
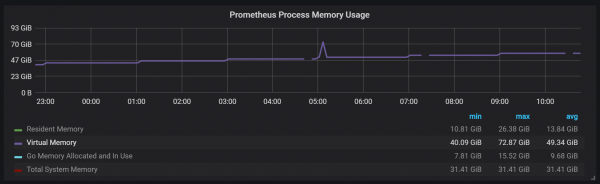
Mums ir aktīvs bloks, ko sauc par head block, kas tiek glabāts atmiņā; bloki ar vecākiem datiem ir pieejami caur mmap(). Tas novērš nepieciešamību konfigurēt kešu atsevišķi, bet arī nozīmē, ka jums jāatstāj pietiekami daudz vietas operētājsistēmas kešam, ja vēlaties veikt pieprasījumus uz datiem, kas ir vecāki par tiem, kurus ietver head block.
Un tas arī nozīmē, ka Prometheus virtuālās atmiņas patēriņš izskatīsies diezgan augsts, par ko nav jāuztraucas.
Vēl viens interesants dizaina aspekts ir WAL (rakstīt priekšā žurnāls). Kā redzams dokumentācijā par krātuvi, Prometheus izmanto WAL, lai izvairītos no datu zudumiem avārijas gadījumā. Diemžēl konkrētie mehānismi datu izturības nodrošināšanai nav pietiekami dokumentēti. Prometheus 2.3.2 versija izmet WAL diskā ik pēc 10 sekundēm, un šo iestatījumu nevar konfigurēt lietotājs.
Kompakcijas
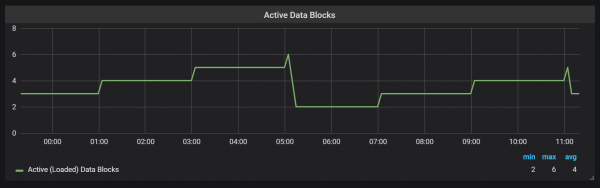
Prometheus TSDB ir projektēta pēc LSM krātuves (Log Structured Merge — žurnālu strukturēts saplūšanas koks): galvas bloks tiek periodiski izmetīts diskā, vienlaikus kompakciju mehānisms apvieno vairākus blokos, lai izvairītos no pārāk daudzu bloku skenēšanas vaicājumos. Šeit ir redzams blokku skaits, ko es novēroju testa sistēmā pēc dienas slodzes.
Ja vēlaties uzzināt vairāk par krātuvi, varat izpētīt meta.json failu, kurā ir informācija par esošajiem blokiem un to izcelsmi.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Kompakcijas Prometheus saistītas ar galvas bloka izmešanu diskā. Šajā brīdī var tikt veikti vairāki šādi procesi.
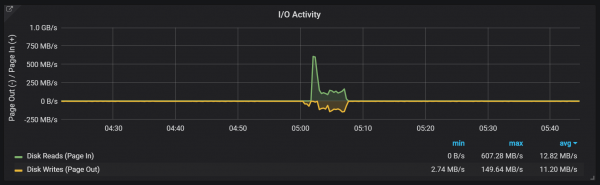
Tā šķiet, ka saspiešanas procesu nekādi nerobežo, un tie var radīt lielus diska I/O lēcienus izpildes laikā.
CPU slodzes lēcieni
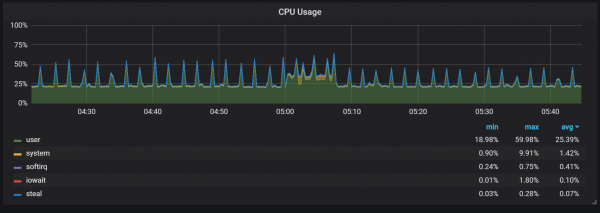
Protams, tas negatīvi ietekmē sistēmas ātrumu un ir nopietns izaicinājums LSM glabātavām: kā veikt saspiešanu, lai nodrošinātu augstu pieprasījumu ātrumu un vienlaikus neradītu pārāk lielu pārslodzi?
Atmiņas izmantošana saspiešanas procesā arī izskatās diezgan interesanti.
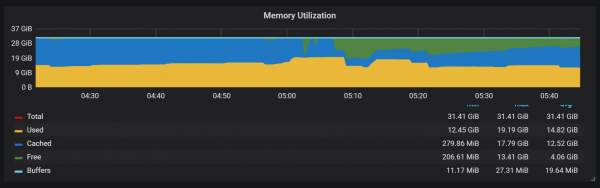
Mēs redzam, ka saspiešanas rezultātā lielākā daļa atmiņas maina stāvokli no Cached uz Free: tas nozīmē, ka potenciāli vērtīga informācija ir no turienes izņemta. Interesanti, vai tiek izmantota fadvice() vai kāda cita minimizācijas tehnika, vai tas ir saistīts ar to, ka kešatmiņa tika atbrīvota no saspiešanas rezultātā iznīcinātajiem blokiem?
Atkopšana pēc kļūmes
Atkopšana pēc kļūdām prasa laiku, un tas ir pamatoti. Ierakstiem 1 miljonu minūtē man bija jāpagaida apmēram 25 minūtes, kamēr notika atkopšana SSD diska ņemšanai vērā.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Sāk Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Sāk klausīties savienojumus" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Sāk TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="atrasts veselīgs bloks" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="router prefix" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="atrasts veselīgs bloks" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="atrasts veselīgs bloks" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="atrasts veselīgs bloks" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="atrasts veselīgs bloks" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="WAL bojājums konstatēts; saīsināšana" err="neparedzēts CRC32 kopsavilkums d0465484, vēlas 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB uzsākta"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Ielādējot konfigurācijas failu" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Konfigurācijas faila ielādēšana pabeigta" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Serveris ir gatavs pieņemt tīmekļa pieprasījumus."
Galvenā problēma atjaunošanas procesā — augsta atmiņas patēriņš. Neskatoties uz to, ka normālas darbības laikā serveris var stabilizēties ar tādu pašu atmiņas apjomu, krīzes situācijā tas var neizdoties atjaunoties OOM dēļ. Vienīgais risinājums, ko atradu, ir izslēgt datu vākšanu, uzsākt serveri, ļaut tam atjaunoties un pēc tam restartēt jau ar ieslēgtu vākšanu.
Sasitījums
Vēl viena uzvedība, par kuru jāatceras sasildīšanas laikā — zemas veiktspējas un augsta resursu patēriņa attiecība tieši pēc starta. Dažās, bet ne visās startēšanās esmu novērojis smagu slodzi uz CPU un atmiņu.
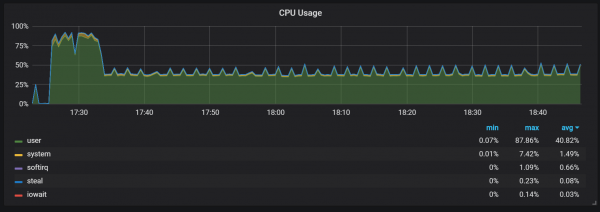
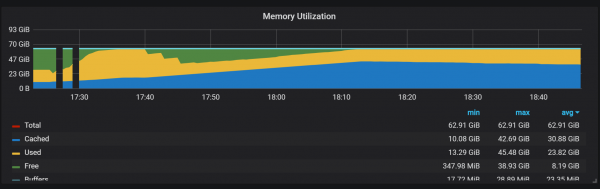
Atmiņas izmantošanas kritumi liecina, ka Prometheus nespēj no paša sākuma konfigurēt visus vākumus, un daži dati tiek zaudēti.
Es neesmu noskaidrojis precīzos iemeslus augstai procesora un atmiņas slodzei. Apsveru, ka tas varētu būt saistīts ar jaunu laika rindu izveidošanu galvenajā blokā ar augstu biežumu.
CPU slodzes svārstības
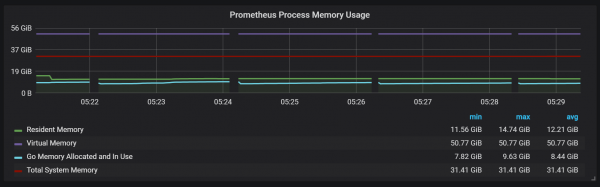
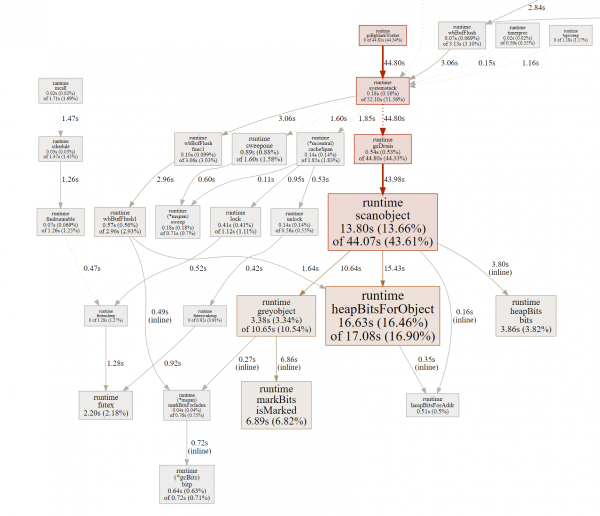
Papildus blīvēšanas procesiem, kas rada ievērojamu I/O slodzi, es pamanīju nopietnas procesora slodzes svārstības ik pēc divām minūtēm. Pīķi ilgstoši notiek pie lieliem ienākošiem datu plūsmām un šķiet, ka tos izraisa Go atkritumu savācējs, vismaz daži kodoli ir pilnībā noslogoti.
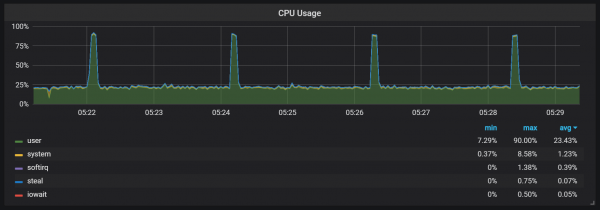
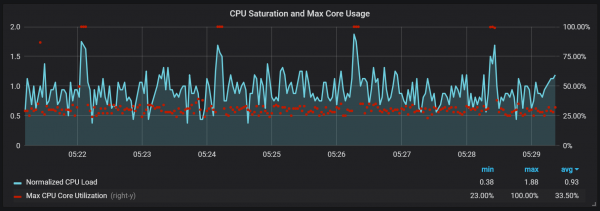
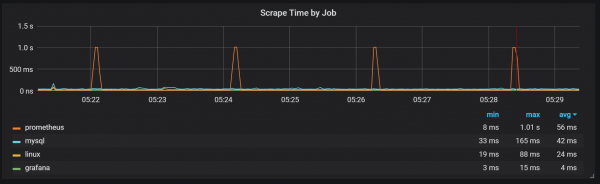
Šīs svārstības nav tik nenozīmīgas. Izskatās, ka kad tās notiek, iekšējā ieeja un Prometheus metri kļūst nepieejami, kas izraisa datu trūkumus šajos pašos laika posmos.
Arī var pamanīt, ka Prometheus eksportētājs apstājas uz vienu sekundi.
Mēs varam novērot korelācijas ar atkritumu savākšanu (GC).
Secinājums
Prometheus 2 TSDB darbojas ātri, spēj apstrādāt miljoniem laika rindu, tajā pašā laikā veicot tūkstošiem ierakstu sekundē, izmantojot ļoti pieticīgu aprīkojumu. Procesora un diska I/O izmantošana arī ir iespaidīga. Mans piemērs rādīja līdz 200 000 metrikām sekundē uz katru izmantoto kodolu.
Plānojot paplašināšanu, jāatceras par pietiekamu jaudas apjomu, un tam jābūt reālam atmiņas apjomam. Iegūtā atmiņas izmantošanas apjoms, ko es novēroju, bija aptuveni 5 GB uz 100 000 ierakstiem sekundē no ienākošās plūsmas, kas kopā ar operētājsistēmas kešatmiņu veidoja apmēram 8 GB aizņemtās atmiņas.
Protams, ir vēl daudz darāmā, lai pieradinātu CPU un disku I/O svārstības, un tas nav pārsteigums, ņemot vērā, cik jauna ir Prometheus 2 TSDB salīdzinājumā ar InnoDB, TokuDB, RocksDB, WiredTiger, bet visiem viņiem bija līdzīgas problēmas dzīves cikla sākumā.
Avots: habr.com
