

2017. gadā mēs uzvarējām konkursā par investīciju biznesa transakciju kodola izstrādi Alfa-Bankā un uzsākām darbu (HighLoad++ 2018 ar ziņojumu par investīciju biznesa kodolu) Vladimirs Drinkins, investīciju biznesa transakciju kodola virziena vadītājs Alfa-Bankā). Šai sistēmai bija jāapvieno dati par darījumiem no dažādiem avotiem dažādos formātos, vienot datus, saglabāt tos un nodrošināt piekļuvi.
Izstrādes procesā sistēma evolucionēja un pievienojās funkcionalitāte, un kādā brīdī mēs sapratām, ka veidojas kaut kas daudz lielāks par vienkāršu lietojumprogrammu, kas radīta konkrētu uzdevumu risināšanai: mēs ieguvām sistēmu, lai veidotu izkliedētas lietojumprogrammas ar pastāvīgu glabāšanu. Iegūtā pieredze kļuva par pamatu jaunam produktam — (TDG).
Es gribu pastāstīt par TDG arhitektūru un risinājumiem, kurus mēs atradām izstrādes procesā, iepazīstināt jūs ar galveno funkcionalitāti un parādīt, kā mūsu produkts var kļūt par bāzi pabeigtu risinājumu izveidei.
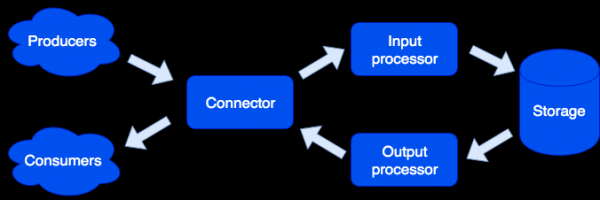
Arhitektūras ziņā mēs sadalījām sistēmu atsevišķās lomas, katra no tām ir atbildīga par noteiktu uzdevumu risināšanu. Viens palaists lietojumprogrammas instances īsteno vienu vai vairākus lomu tipus. Klasterī var būt vairākas vienas lomu veida:
Connector
Connector atbild par savienojumu ar ārējo pasauli; tā uzdevums ir pieņemt pieprasījumu, to analizēt un, ja tas izdevies, nosūtīt datus apstrādei input processor. Mēs atbalstām HTTP, SOAP, Kafka, FIX formātus. Arhitektūra ļauj viegli pievienot atbalstu jauniem formātiem, drīzumā tiks pievienots atbalsts IBM MQ. Ja pieprasījuma analīze noslēdzas ar kļūdu, tad connector atgriezīs kļūdu; pretējā gadījumā tas atbildēs, ka pieprasījums tika apstrādāts veiksmīgi, pat ja tālākajā apstrādē radās kļūda. Tas darīts īpaši, lai strādātu ar sistēmām, kuras nemāk atkārtot pieprasījumus — vai tieši otrādi, to dara pārāk uzstājīgi. Lai netiktu zaudēti dati, tiek izmantota remonta rinda: objekts vispirms nonāk tajā, un tikai pēc veiksmīgas apstrādes tiek no tās izdzēsts. Administrators var saņemt brīdinājumus par objektiem, kas palikuši remonta rindā, un pēc programmatūras kļūdas vai aparatūras kļūmes novēršanas izpildīt atkārtotu mēģinājumu.
Input processor
Input processor klasificē saņemtos datus pēc raksturīgajām pazīmēm un izsauc atbilstošos apstrādātājus. Apstrādātāji ir Lua valodā rakstīts kods, kas tiek izpildīts smilšu kastē, tādējādi ietekmēt sistēmas darbību tie nevar. Šajā posmā datus var pielāgot vajadzīgajam izskatam, kā arī, ja nepieciešams, palaist patvaļīgu uzdevumu skaitu, kuri var realizēt nepieciešamo loģiku. Piemēram, produktā MDM (Master Data Management), kas veidots uz Tarantool Data Grid, pievienojot jaunu lietotāju, lai nepagarinātu pieprasījuma apstrādi, zelta ieraksta izveide tiek palaista kā atsevišķs uzdevums. Smilšu kaste atbalsta datu lasīšanas, modificēšanas un pievienošanas pieprasījumus, ļauj veikt kādu funkciju visās storage tipa lomās un apkopot rezultātu (map/reduce).
Apstrādātāji var būt aprakstīti failos:
sum.lua

local x, y = unpack(...)
return x + y
Un tad, tie var tikt deklarēti konfigurācijā:
functions:
  sum: { __file: sum.lua }
Kāpēc Lua? Lua ir ļoti vienkārša valoda. Saskaņā ar mūsu pieredzi, pēc pāris stundām iepazīšanās ar to, cilvēki sāk rakstīt kodu, kas atrisina viņu uzdevumus. Un tas neattiecas tikai uz profesionālajiem izstrādātājiem, bet piemēram, arī analītiķiem. Turklāt, pateicoties jit-kompilerim, Lua darbojas ļoti ātri.
Uzglabāšana
Storage glabā persisten datos. Pirms saglabāšanas dati tiek validēti atbilstoši datu shēmai. Šīs shēmas aprakstam mēs izmantojam paplašināto formātu . Piemērs:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Saskaņā ar šo aprakstu automātiski tiek ģenerēts DDL (Datu definīcijas valoda) datu bāzei Tarantool un shēma piekļuvei datiem.
Atbalsta asynhrono datu replikāciju (tiek plānots pievienot sinhrono).
Izejas apstrādātājs
Reizēm par jaunu datu ienākšanu jāinformē ārējie patērētāji, tam ir izveidota loma Izejas apstrādātājs. Pēc datu saglabāšanas tos var nodot atbilstošajam apstrādātājam (piemēram, lai tos formatētu tā, kā to prasa patērētājs) — un pēc tam nosūtīt uz connector. Šeit arī tiek izmantota remonta rinda: ja objekts netiek pieņemts, administrators var atkārtoti mēģināt vēlāk.
Mērogošana
Connector, input processor un output processor lomas nav stāvokļa, kas ļauj mums horizontāli paplašināt sistēmu, vienkārši pievienojot jaunus lietojumprogrammas instance ar ieslēgtu vajadzīgā veida lomu. Horizontālajai paplašināšanai storage tiek izmantota klastera organizēšanai, izmantojot virtuālos bākas. Pēc jauna servera pievienošanas daļa bākas no vecajiem serveriem fona režīmā pārvietojas uz jauno serveri; tas notiek caurspīdīgi lietotājiem un neietekmē visas sistēmas darbību.
Datu īpašības
Objekti var būt ļoti lieli un saturēt citus objektus. Mēs nodrošinām atomaritāti datu pievienošanā un atjaunināšanā, saglabājot objektu ar visām atkarībām uz vienu virtuālo bāku. Tādējādi tiek izslēgta objekta "izplūšana" pa vairākiem fiziskiem serveriem.
Atbalsta versiju kontroli: katra objekta atjaunināšana rada jaunu versiju, un mēs vienmēr varam izveidot laika griezumu un apskatīt, kā pasaule izskatījās tajā laikā. Datiem, kuriem nav nepieciešama gara vēsture, mēs varam ierobežot versiju skaitu vai pat uzglabāt tikai vienu — pēdējo, — tādējādi faktiski atslēdzot versiju kontroli noteikta tipa datiem. Tāpat iespējams ierobežot vēsturi pēc laika: piemēram, dzēst visus kāda tipa objektus, kas ir vecāki par 1 gadu. Atbalsta arī arhivēšanu: mēs varam eksportēt objektus, kas ir vecāki par noteiktu laiku, atbrīvojot vietu klasterī.
Uzdevumi
No interesantajām funkcijām var izcelt uzdevumu palaišanu saskaņā ar grafiku, pēc lietotāja pieprasījuma vai programmatiski no smilšu kastes:
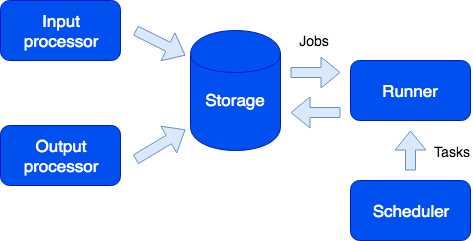
Šeit mēs redzam vēl vienu lomu — runner. Šai lomai nav stāvokļa, un nepieciešamības gadījumā klasterī var pievienot papildu instances ar šo lomu. Runner atbild par uzdevumu izpildi. Kā teikts, no smilšu kastes ir iespējams radīt jaunus uzdevumus; tie tiek saglabāti rindā uz uzglabāšanas un pēc tam tiek izpildīti uz runner. Šis uzdevumu veids tiek saukts par Job. Mums ir arī uzdevumu veids, ko sauc par Task — tās ir lietotāja definētas uzdevumi, kurus var palaist saskaņā ar grafiku (tiek izmantota cron sintakse) vai pēc pieprasījuma. Lai šādus uzdevumus palaistu un uzraudzītu, mums ir ērts uzdevumu plānotājs. Lai šī funkcionalitāte būtu pieejama, nepieciešams aktivizēt lomu scheduler; šai lomai ir stāvoklis, tādēļ tā neskaļojas, taču tas nav nepieciešams; tomēr, tāpat kā visas citas lomas, tai var būt replika, kas sāk darboties, ja meistars pēkšņi atteicas.
Logger
Vēl viena loma tiek saukta par logger. Tā apkopo žurnālus no visiem klastera dalībniekiem un nodrošina saskarni to eksportēšanai un apskatei caur tīmekļa saskarni.
Pakalpojumi
Jāatzīmē, ka sistēma ļauj viegli izveidot pakalpojumus. Konfigurācijas failā var norādīt, kādus pieprasījumus novirzīt uz lietotāja rakstītu apstrādātāju, kas tiek izpildīts smilšu kastē. Šajā apstrādātājā var, piemēram, veikt kādu analītisku pieprasījumu un atgriezt rezultātu.
Pakalpojums tiek aprakstīts konfigurācijas failā:
services:
   sum:
      doc: "pievieno divus skaitļus"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API tiek automātiski ģenerēts un pakalpojums kļūst pieejams izsaukumam:
query {
   sum(x: 1, y: 2)
}
Tas nov leadīs pie apstrādātāja izsaukuma sum, kas atgriezīs rezultātu:
3
Pieprasījumu profilēšana un metriķi
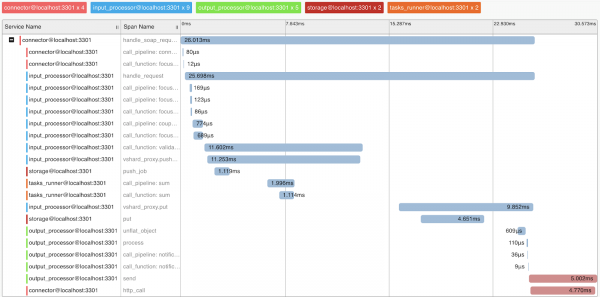
Lai izprastu sistēmas darbību un pieprasījumu profilēšanu, mēs esam īstenojuši atbalstu OpenTracing protokolam. Sistēma var pēc pieprasījuma nosūtīt informāciju rīkiem, kas atbalsta šo protokolu, piemēram, Zipkin, kas ļaus izprast, kā tika izpildīts pieprasījums:
Dabiski, sistēma nodrošina iekšējās metriķus, kurus var apkopot, izmantojot Prometheus un vizualizēt, izmantojot Grafana.
Izvietošana
Tarantool Data Grid var tikt izvietots no RPM pakotnēm vai arhīviem, izmantojot piegādāto utilītu vai Ansible, arī ir atbalsts Kubernetes ().
Lietojumprogrammas, kas īsteno biznesa loģiku (konfigurācija, apstrādātāji), tiek ielādētas izvietotajā Tarantool Data Grid klasterī kā arhīvs caur UI vai izmantojot skriptu, izmantojot mūsu nodrošināto API.
Lietojumprogrammu piemēri
Kādas lietojumprogrammas var izveidot, izmantojot Tarantool Data Grid? Patiesībā lielākā daļa biznesa uzdevumu, tā vai citādi, saistīti ar datu plūsmu apstrādi, uzglabāšanu un piekļuvi tiem. Tāpēc, ja jums ir lielas datu plūsmas, kuras jāuzglabā uzticami un jānodrošina piekļuve, mūsu produkts var ietaupīt jums daudz laika izstrādē un koncentrēties uz savu biznesa loģiku.
Piemēram, mēs vēlamies vākt informāciju par nekustamo īpašumu tirgu, lai nākotnē, piemēram, gūtu informāciju par vislielākajām piedāvājuma priekšrocībām. Šajā gadījumā mēs izdalīsim šādas uzdevumus:
- Roboti, kas vācu informāciju no atklātajiem avotiem, būs mūsu datu avoti. Šo uzdevumu jūs varat risināt, izmantojot gatavus risinājumus vai uzrakstot kodu jebkurā valodā.
- Tālāk Tarantool Data Grid pieņems un saglabās datus. Ja datu formāts no dažādiem avotiem atšķiras, jūs varat uzrakstīt kodu Lua valodā, kas veiks konversiju uz vienotu formātu. Pirmsapstrādes posmā jums būs iespēja arī, piemēram, filtrēt atkārtotus piedāvājumus vai papildus atjaunināt datu bāzē informāciju par aģentiem, kas darbojas tirgū.
- Tagad jums ir mērogojama risinājuma klasterī, kuru varat piepildīt ar datiem un veikt datu vaicājumus. Turpinājumā varat ieviest jaunu funkcionalitāti, piemēram, izveidot pakalpojumu, kas veiks pieprasījumu uz datiem un sniegs visizdevīgāko piedāvājumu dienā — tas prasīs dažas rindas konfigurācijas failā un nedaudz Lua koda.
Kas tālāk?
Mūsu prioritāte ir uzlabot izstrādes ērtumu ar . Piemēram, tā ir IDE, kas atbalsta profilēšanu un atkļūdošanu apstrādātājiem, kas darbojas smiltīs.
Mēs arī pievēršam lielu uzmanību drošības jautājumiem. Pašreiz mēs pārbaudām FSTEK Krievijas sertifikāciju, lai apstiprinātu augstu drošības līmeni un atbilstu prasībām, kas nospriedušas programmatūras izstrādes produktu sertificēšanai, ko izmanto personas datu informācijas sistēmās un valsts informācijas sistēmās.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish