

Lielajās mākoņu sistēmās īpaši aktuāla ir automātiskās slodzes izsvarošana vai izlīdzināšana uz datu apstrādes resursiem. Par šo jautājumu ir domājusi arī Tioniks (mākoņu pakalpojumu izstrādātājs un operators, kas ir daļa no Rostelecom grupas).
Un, ņemot vērā, ka mūsu galvenā izstrādes platforma ir OpenStack, un mēs, tāpat kā visi cilvēki, esam slinki, tika nolemts atrast kādu gatavu moduļa risinājumu, kas jau ir platformas sastāvā. Mūsu izvēle krita uz Watcher, kuru mēs nolēmām izmantot savām vajadzībām.
Sākumā noskaidrosim terminus un definīcijas.
Termini un definīcijas
Mērķis — tas ir cilvēkam saprotams, novērojams un izmērāms galarezultāts, kas jāsasniegt. Katram mērķim ir viena vai vairākas stratēģijas. Stratēģija ir algoritma realizācija, kas spēj atrast risinājumu šim mērķim.
Darbība (Action) — tā ir elementāra uzdevuma funkcija, kas maina pašreizējo stāvokli mērķa pārvaldāmā OpenStack klastera resursā, piemēram: virtuālās mašīnas migrācija (migration), mezgla strāvas stāvokļa maiņa (change_node_power_state), nova pakalpojuma stāvokļa maiņa (change_nova_service_state), flavor maiņa (resize), NOP ziņojuma reģistrācija (nop), darbību trūkums noteiktu laika periodu laikā — pauze (sleep), diska pārvietošana (volume_migrate).
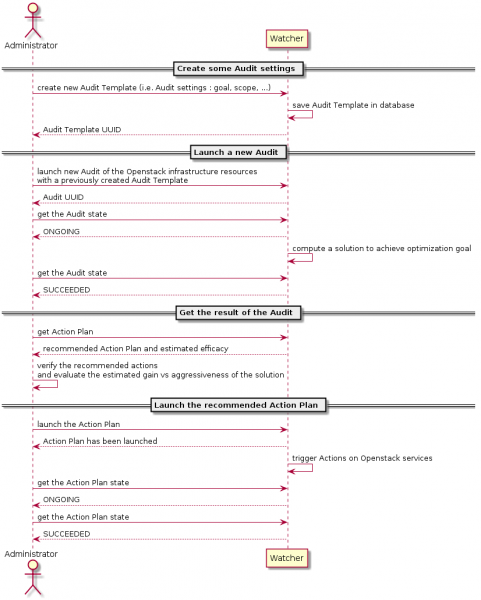
Darbības plāns (Action Plan) — specifisks darbību secību plūsma, ko veic noteiktā kārtībā, lai sasniegtu konkrētu mērķi. Darbības plāns arī ietver novērtējamo globālo efektivitāti ar komplektu efektivitātes rādītāju. Darbības plāns tiek ģenerēts Watcher, kad veiksmīgi notiek audits, kura rezultātā izmantotā stratēģija atrod risinājumu mērķa sasniegšanai. Darbības plāns sastāv no secīgu darbību saraksta.
Audits (Audit) — tas ir pieprasījums optimizēt klasteri. Optimizācija tiek veikta, lai sasniegtu vienu Mērķi šajā klasterī. Par katru veiksmīgu auditu Watcher ģenerē Darbības plānu.
Audita joma (Audit Scope) — tas ir resursu komplekts, kura ietvaros tiek veikta audits (pieejamības zona(-as), mezglu agregatori, atsevišķas skaitļošanas mezgli vai glabāšanas mezgli utt.). Audita joma tiek noteikta katrā veidnē. Ja audita joma nav norādīta, tiek veikta visa klastera auditēšana.
Audita veidne (Audit Template) — saglabāta iestatījumu kopums audita palaišanai. Veidnes ir nepieciešamas, lai vairākkārtīgi veiktu auditus ar vienādiem iestatījumiem. Veidnei obligāti jāietver audita mērķis, ja stratēģijas netiek norādītas, tiek izvēlētas vispiemērotākās no esošajām stratēģijām.
Klasteris (Cluster) — tas ir fizisko mašīnu kopums, kas sniedz skaitļošanas resursus, glabāšanas resursus un tīkla resursus, un to pārvalda viens un tas pats OpenStack kontrolieris.
Klastera datu modelis (Cluster Data Model, CDM) — tas ir loģisks pašreizējā stāvokļa un topoloģijas attēlojums resursiem, ko pārvalda klasteris.
Efektivitātes rādītājs (Efficacy Indicator) — rādītājs, kas norāda, kā tiek izpildīts risinājums, kas izstrādāts, izmantojot šo stratēģiju. Efektivitātes rādītāji ir specifiski konkrētai mērķim un parasti tiek izmantoti globālās efektivitātes aprēķināšanai gala rīcības plānā.
Efektivitātes specifikācija (Efficacy Specification) — tas ir specifisku iezīmju kopums, kas saistīts ar katru Mērķi, un nosaka dažādus efektivitātes rādītājus, kurus stratēģijai, kas nodrošina attiecīgā mērķa sasniegšanu, jānodrošina savā risinājumā. Patiesībā katrs risinājums, ko piedāvā stratēģija, tiks pārbaudīts atbilstības specifikācijai pirms globālās efektivitātes aprēķināšanas.
“Skaitīšanas” dzinējs (Scoring Engine) — tas ir izpildāms fails, kam ir skaidri noteikti ievades dati, skaidri noteikti izejas dati un kas veic tīri matemātisku uzdevumu. Tādējādi aprēķins nav atkarīgs no vides, kurā tas tiek izpildīts — tas sniegs vienādu rezultātu jebkur.
Watcher plānotājs (Watcher Planner) — daļēja Watcher lēmumu pieņemšanas mehānisma sastāvdaļa. Šis modulis pieņem darbību kopumu, ko ģenerējusi stratēģija, un izveido darba plāna shēmu, kas nosaka, kā laika gaitā ieplānot šīs dažādās darbības un kādas ir priekšnosacījumi katrai darbībai.
Watcher mērķi un stratēģijas
Mērķis
Stratēģijas
Dummy mērķis
Dummy stratēģija
Dummy stratēģija, izmantojot paraugus Scoring Engines
Dummy stratēģija ar izmēru mainīšanu
Enerģijas taupīšana
Enerģijas taupīšanas stratēģija
Servera konsolidācija
Pamata off-line servera konsolidācija
VM slodzes konsolidācijas stratēģija
Slodzes līdzsvars
Slodzes līdzsvara migrācijas stratēģija
Tālvadības jaudas līdzsvara stratēģija
Slodžu stabilizācija
Troksnis kaimiņš
Troksnis kaimiņš
Termiskā optimizācija
Stratēģija, kas balstīta uz izejas temperatūru
Gaisa plūsmas optimizācija
Vienmērīgas gaisa plūsmas migrācijas stratēģija
Aprīkojuma apkope
Zonas migrācija
Neklasificēts
Aktuators
Dummy mērķis — rezerves mērķis, kas tiek izmantots testēšanas nolūkiem.
Saistītās stratēģijas: Dummy stratēģija, Dummy stratēģija, izmantojot paraugus Scoring Engines un Dummy stratēģija ar izmēru mainīšanu. Dummy stratēģija ir fikcionāla stratēģija, kas tiek izmantota integrācijas testēšanai, izmantojot Tempest. Šī stratēģija nesniedz nekādu noderīgu optimizāciju, tās vienīgais mērķis ir izmantot Tempest testus.
Dummy stratēģija, izmantojot paraugus Scoring Engines — stratēģija, kas ir līdzīga iepriekšējai, atšķiras tikai ar paraugu “vērtējo motoru” izmantošanu, kas veic skaitīšanu, izmantojot mašīnmācības metodes.
Dummy stratēģija ar izmēru mainīšanu — stratēģija, kas ir līdzīga iepriekšējai, atšķiras tikai ar flavora maiņu (migrācija un izmēru mainīšana).
Netiek izmantota ražošanā.
Enerģijas taupīšana — samazināt enerģijas patēriņu. Enerģijas taupīšanas stratēģija kopā ar VM slodzes konsolidācijas stratēģiju (Servera konsolidācija) ir spējīga veikt dinamiskas elektroapgādes pārvaldības (DPM) funkcijas, taupot elektroenerģiju, dinamiskā darba slodžu konsolidēšanas laikā pat zemas slodzes periodos: virtuālās mašīnas tiek pārvietotas uz mazāku mezglu skaitu, un nevajadzīgie mezgli tiek izslēgti. Pēc konsolidācijas stratēģija piedāvā risinājumu mezglu ieslēgšanai/vienkāršošanai atbilstoši noteiktajiem parametriem: “min_free_hosts_num” — brīvo ieslēgto mezglu skaits, kas gaida slodzi, un “free_used_percent” — brīvo ieslēgto mezglu procents attiecībā pret to mezglu skaitu, kuri ir aizņemti ar mašīnām. Lai stratēģija darbotos, jābūt ieslēgtam un konfigurētam Ironic darbam ar mezglu ieslēgšanu/vienkāršošanu.
Stratēģijas parametri
parametrs
tipu
nākotnē
apraksts
free_used_percent
Skaits
10.0
brīvo skaitļošanas mezglu skaita attiecība pret skaitļošanas mezglu skaitu ar virtuālajām mašīnām
min_free_hosts_num
Int
1
minimālais brīvo skaitļošanas mezglu skaits
Mākonī jābūt vismaz diviem mezgliem. Izmantotā metode ir mezgla jaudas stāvokļa maiņa (change_node_power_state). Metaiķu vākšanas stratēģija to neprasa.
Serveru konsolidācija — minimizēt skaitļošanas mezglu skaitu (konsolidācija). Tam ir divas stratēģijas: Basic Offline Server Consolidation un VM Workload Consolidation Strategy.
Basic Offline Server Consolidation stratēģija minimizē kopējo izmantoto serveru skaitu, kā arī samazina migrāciju skaitu.
Pamata stratēģijai ir nepieciešamas šādas metrikas:
metrika
pakalpojums
spraudņi
komentārs
compute.node.cpu.percent
none
cpu_util
none
Stratēģijas parametru: migration_attempts — kombināciju skaits potenciālo izslēgšanas kandidātu meklēšanai (noklusējuma, 0, nav ierobežojumu), period — laika intervāls sekundēs statiskai agregācijai no metrikas datu avota (noklusējuma, 700).
Izmantotās metodes: migrācija, nova pakalpojuma stāvokļa maiņa (change_nova_service_state).
VM Workload Consolidation Strategy stratēģija balstās uz pirmā piemērotā (first-fit) heuristiskā algoritma, kas koncentrējas uz izmērīto CPU noslodzi un mēģina minimizēt mezglus, kuriem ir pārāk liela vai pārāk maza noslodze, ņemot vērā resursu kapacitātes ierobežojumus. Šī stratēģija piedāvā risinājumu, kas nodrošina efektīvāku klastera resursu izmantošanu, izmantojot šādus četrus posmus:
- Izkliedēšanas posms — pārmaksāto resursu apstrāde;
- Konsolidācijas posms — nepietiekami izmantoto resursu apstrāde;
- Risinājuma optimizācija — migrāciju skaita samazināšana;
- Izslēgšana neizmantotajiem skaitļošanas mezgliem.
Stratēģijai ir nepieciešamas šādas metrikas:
metrika
pakalpojums
spraudņi
komentārs
memory
none
disk.root.size
none
Šādas metrikas nav obligātas, taču palielina stratēģijas precizitāti, ja tās ir pieejamas:
metrika
pakalpojums
spraudņi
komentārs
memory.resident
none
cpu_util
none
Stratēģijas parametru: period — laika intervāls sekundēs statiskai agregācijai no metrikas datu avota (noklusējuma, 3600).
Izmanto tās pašas metodes kā iepriekšējā stratēģija. Sīkāk .
Slodzes līdzsvars — sabalansēt darba slodzi starp skaitļošanas mezgliem. Mērķim ir trīs stratēģijas: Workload Balance Migration Strategy, Workload stabilization, Storage Capacity Balance Strategy.
Darba slodzes migrācijas stratēģija uzsāk virtuālo mašīnu migrāciju, balstoties uz virtuālo mašīnu slodzēm mezglos. Lēmums par pārcelšanu tiek pieņemts katru reizi, kad % CPU vai RAM izmantošana mezglā pārsniedz noteikto slieksni. Pārvietojamajai virtuālajai mašīnai jātuvo mezglam vispārējai slodzei visiem mezgliem.
Prasības
- Fizisko procesoru izmantošana;
- Vismaz divi fiziski aprēķinu mezgli;
- Uzstādīta un konfigurēta Ceilometer komponenta — ceilometer-agent-compute, kas darbojas katrā aprēķinu mezglā, un Ceilometer API, kā arī sekojošo metrikas vākšana:
metrika
pakalpojums
spraudņi
komentārs
cpu_util
none
memory.resident
none
Stratēģijas parametri:
parametrs
tipu
nākotnē
apraksts
, un tad ar tās palīdzību definējiet papildu metrikas, kuras vēlaties vācēt, dekoriējot funkcijas:
String
'cpu_util'
Metrikas, kas ir pamats: 'cpu_util', 'memory.resident'.
threshold
Skaits
25.0
Darba slodzes slieksnis migrācijai.
periods
Skaits
300
Kopējais Ceilometer laika periods.
Izmantotā metode — migrācija.
Darba slodzes stabilizācija — stratēģija, kas vērsta uz darba slodzes stabilizāciju, izmantojot tiešo migrāciju. Stratēģija balstās uz standartnovirzes algoritmu un nosaka, vai klastra slodze ir pārslodze, un reaģē uz to, uzsākot mašīnu migrāciju, lai stabilizētu klasteri.
Prasības
- Fizisko procesoru izmantošana;
- Vismaz divi fiziski aprēķinu mezgli;
- Uzstādīta un konfigurēta Ceilometer komponenta — ceilometer-agent-compute, kas darbojas katrā aprēķinu mezglā, un Ceilometer API, kā arī sekojošo metrikas vākšana:
metrika
pakalpojums
spraudņi
komentārs
cpu_util
none
memory.resident
none
Uzglabāšanas kapacitātes bilances stratēģija (stratēģija īstenota kopš Queens) — stratēģija pārvieto diskus atkarībā no Cinder baseinu noslodzes. Lēmums par pārcelšanu tiek pieņemts katru reizi, kad baseina izmantošanas koeficients pārsniedz noteikto slieksni. Pārvietojamais disks jātuvo baseinam vidējai slodzei visiem Cinder baseiniem.
Prasības un ierobežojumi
- Vismaz divi Cinder baseini;
- Disku migrācijas iespēja.
- Klastera datu modelis — Cinder klastera datu modeļa kolekcionārs.
Stratēģijas parametri:
parametrs
tipu
nākotnē
apraksts
volume_threshold
Skaits
80.0
Disku slieksnis apjoma bilancei.
Izmantotā metode — diska migrācija (volume_migrate).
Trokšņainais kaimiņš — identificēt un pārvietot "trokšņaino kaimiņu" — zema prioritāte virtuālo mašīnu, kas negatīvi ietekmē augstas prioritātes virtuālās mašīnas veiktspēju IPC ziņā, pārmērīgi izmantojot pēdējo līmeņa kešu. Pati stratēģija: Trokšņainais kaimiņš (izmantotais stratēģijas parametrs — cache_threshold (noklusējuma vērtība — 35), kad veiktspēja samazinās līdz noteiktajai vērtībai, tiek uzsākta migrācija. Stratēģijas darbībai nepieciešama aktivizēta LLC (pēdējā līmeņa keša) metrikas, pēdējais Intel servers ar CMT atbalstu, kā arī sekojošo metrikas vākšana:
metrika
pakalpojums
spraudņi
komentārs
cpu_l3_cache
none
Nepieciešams Intel .
Klastera datu modelis (pēc noklusējuma): Nova klastera datu modeļa kolektors. Lietotā metode — migrācija.
Darbs ar šo mērķi caur Dashboard nav pilnībā realizēts Queens versijā.
Termiskā optimizācija — optimizēt temperatūras režīmu. Izplūdes gaisa temperatūra ir viena no svarīgajām siltuma telemetrijas sistēmām, lai izmērītu servera siltuma vai darba slodzes stāvokli. Mērķim ir viena stratēģija — izplūdes temperatūras balstīta stratēģija, kas pieņem lēmumus par darba slodžu pārvietošanu uz mezgliem ar labvēlīgu temperatūras režīmu (zemākā izplūdes temperatūra), kad sākotnējo hostu izplūdes temperatūra sasniedz iestatītu slieksni.
Stratēģijas darbībai ir nepieciešams serveris ar uzstādītu un konfigurētu Intel Power Node Manager , kā arī sekojošo metrikas vākšana:
metrika
pakalpojums
spraudņi
komentārs
hardware.ipmi.node.outlet_temperature
IPMI
Stratēģijas parametri:
parametrs
tipu
nākotnē
apraksts
threshold
Skaits
35.0
Temperatūras slieksnis migrācijai.
periods
Skaits
30
Laika intervāls sekundēs, lai iegūtu statistisko agregāciju no datu avota metrikām.
Izmantotā metode — migrācija.
Gaisa plūsmas optimizācija — optimizēt ventilācijas režīmu. Pašreizējā stratēģija — vienmērīga gaisa plūsma, izmantojot dzīvās migrācijas. Stratēģija aktivizē migrāciju uz virtuālās mašīnas, kad servera ventilatora gaisa plūsma pārsniedz noteikto slieksni.
Stratēģijas darbībai nepieciešams:
- Tehniskā aparatūra: skaitļošanas mezgli <ar NodeManager 3.0 atbalstu;
- Vismaz divi skaitļošanas mezgli;
- Uz katra skaitļošanas mezgla uzstādīts un konfigurēts komponents ceilometer-agent-compute un Ceilometer API, kas spēj veiksmīgi ziņot par tādām metrikām kā gaisa plūsma, sistēmas jauda, ieplūdes temperatūra:
metrika
pakalpojums
spraudņi
komentārs
hardware.ipmi.node.airflow
IPMI
hardware.ipmi.node.temperature
IPMI
hardware.ipmi.node.power
IPMI
Stratēģijas darbībai ir nepieciešams serveris ar uzstādītu un konfigurētu Intel Power Node Manager 3.0 vai jaunākas versijas.
ierobežojumi: koncepcija nav domāta ražošanai.
Ieteicams izmantot šo algoritmu ar nepārtrauktiem auditiem, jo vienā iterācijā plānots migrēt tikai vienu virtuālo mašīnu.
Iespējamas dzīvās migrācijas.
Stratēģijas parametri:
parametrs
tipu
nākotnē
apraksts
threshold_airflow
Skaits
400.0
Gaisa plūsmas slieksnis migrācijai. Vienība ir 0.1CFM.
threshold_inlet_t
Skaits
28.0
Ieplūdes temperatūras slieksnis ekonomikas lēmumam migrācijai.
threshold_power
Skaits
350.0
Sistēmas jaudas slieksnis migrācijas lēmumam.
periods
Skaits
30
Laika intervāls sekundēs, lai iegūtu statistisko agregāciju no datu avota metrikām.
Izmantotā metode — migrācija.
Tehniskā apkope — aparatūras uzturēšana. Stratēģija, kas attiecas uz šo mērķi, ir Zone migration. Šī stratēģija ir instruments efektīvai automātiskai un minimālai virtuālo mašīnu un disku migrācijai, ja ir nepieciešams veikt aparatūras uzturēšanu. Stratēģija izveido rīcības plānu atbilstoši svaru principiem: darbību kopums, kam ir lielāks svars, tiks plānots agrāk par citiem. Ir divi konfigurācijas parametri: darbību svars (action_weights) un paralelizācija (parallelization).
ierobežojumi: nepieciešama darbību svara un paralelizācijas iestatīšana.
Stratēģijas parametri:
parametrs
tipu
nākotnē
apraksts
compute_nodes
masīvs
None
Migrācijas aprēķina mezgli.
storage_pools
masīvs
None
Migrācijas glabāšanas mezgli.
parallel_total
integer
6
Kopējais darbību skaits, kas jāveic paralēli.
parallel_per_node
integer
2
Darbību skaits, kas veikts paralēli katram aprēķina mezgam.
parallel_per_pool
integer
2
Darbību skaits, kas veikts paralēli katram glabāšanas baseinam.
prioritāte
objekts
None
Prioritāšu saraksts virtuālām mašīnām un diskam.
with_attached_volume
boolean
False
False — virtuālās mašīnas tiks pārvietotas pēc visu diskus pārvietošana. True — virtuālās mašīnas tiks pārvietotas pēc visu pievienoto disku migrācijas.
Aprēķina mezglu masīva elementi:
parametrs
tipu
nākotnē
apraksts
src_node
string
None
Aprēķina mezgls, no kura tiek pārvietotas virtuālās mašīnas (obligāti).
dst_node
string
None
Aprēķinas mezgls, uz kuru migrē virtuālās mašīnas.
Glabāšanas mezglu masīva elementi:
parametrs
tipu
nākotnē
apraksts
src_pool
string
None
Glabāšanas baseins, no kura tiek pārvietoti diski (obligāti).
dst_pool
string
None
Glabāšanas baseins, uz kuru tiek pārvietoti diski.
src_type
string
None
Izcelsmes diska tips (obligāti).
dst_type
string
None
Galīgais diska tips (obligāti).
Objektu prioritātes elementi:
parametrs
tipu
nākotnē
apraksts
project
masīvs
None
Projektu nosaukumi.
compute_node
masīvs
None
Aprēķina mezglu nosaukumi.
storage_pool
masīvs
None
Glabāšanas baseina nosaukumi.
compute
enum
None
Virtuālās mašīnas parametri [“vcpu_num”, “mem_size”, “disk_size”, “created_at”].
glabātuve
enum
None
Disku parametri [“size”, “created_at”].
Izmantotās metodes — virtuālo mašīnu migrācija, disku migrācija.
Neklasificēts — palīgmērķis, kas tiek izmantots, lai atvieglotu stratēģijas izstrādes procesu. Nesatur specifikācijas un var tikt izmantots katru reizi, kad stratēģija vēl nav saistīta ar esošu mērķi. Šis mērķis var arī kalpot kā pārejas posms. Saistītā stratēģija ar šo mērķi ir Actuator.
Jauna mērķa radīšana
Watcher Decision Engine ir piedāvā “ārējās mērķa” papildinājuma interfeisu, kas ļauj integrēt ārēju mērķi, ko var sasniegt ar stratēģiju.
Pirms jauna mērķa izveides jānodrošina, ka neviena no esošajām mērķiem neatbilst jūsu prasībām.
Jauna papildinājuma izveide
Lai izveidotu jaunu mērķi, jums jādara: jāpaplašina mērķa klase, jārealizē klases metode get_name() , lai atgrieztu jaunā mērķa unikālo identifikatoru, ko vēlaties izveidot. Šim unikālajam identifikatoram jāatbilst izejas punktam, kuru jūs vēlāk deklarējat.
Nākamā jārealizē klases metode get_display_name() , lai atgrieztu mērķa pārtulkoto nosaukumu, ko vēlaties izveidot (neizmantojiet mainīgo, lai atgrieztu pārtulkoto virkni, lai tā varētu automātiski tikt apkopota pārtulkošanas rīkā).
Realizējiet klases metodi get_translatable_display_name(), lai atgrieztu tulkošanas atslēgu (faktiski angļu valodas parādīšanās nosaukumu) jūsu jaunajam mērķim. Atgriežamajai vērtībai jāatbilst virknei, kas pārtulkota get_display_name().
Realizējiet tās metodi get_efficacy_specification(), lai atgrieztu jūsu mērķa efektivitātes specifikāciju. Metode get_efficacy_specification() atgriež Unclassified() instanci, ko sniedz Watcher. Šī efektivitātes specifikācija ir noderīga jūsu mērķa izstrādes procesā, jo tā atbilst tukšai specifikācijai.
→
Watcher arhitektūra (vairāk ).
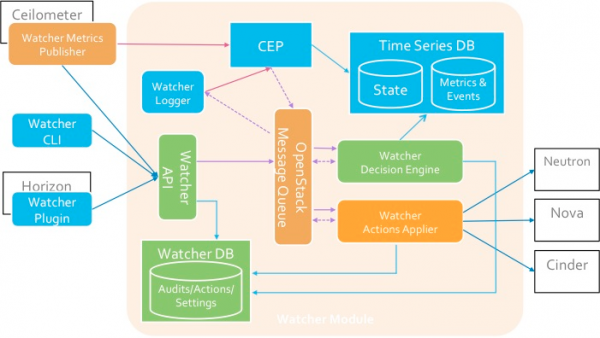
Komponenti
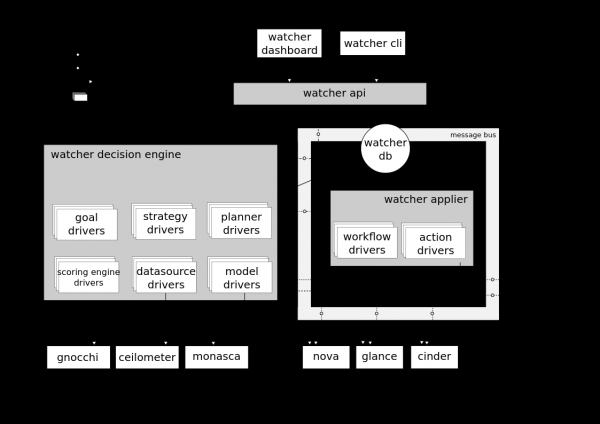
Watcher API — komponents, kas īsteno REST API, ko sniedz Watcher. Saziņas mehānismi: CLI, Horizon papildinājums, Python SDK.
Watcher DB — Watcher datu bāze.
Watcher Applier — komponents, kas īsteno darbību plānu izpildi, ko izveidoja Watcher Decision Engine komponents.
Watcher Decision Engine — komponents, kas atbild par potenciālo darbību kopuma aprēķināšanu optimizācijai, kas jāveic revīzijas mērķim. Ja stratēģija nav norādīta, komponents pats izvēlas piemērotāko.
Watcher Metrics Publisher — komponents, kas apkopo un aprēķina dažas metrīkas vai notikumus un publicē tos CEP galapunktā. Komponenta funkcionalitāti var sniegt arī Ceilometer publicētājs.
Kompleksā notikumu apstrādes (CEP) dzinējs — notikumu kompleksas apstrādes dzinis. Veikšanas efektivitātes apsvērumu dēļ var būt vairāki CEP dzinēja eksemplāri, kas darbojas vienlaicīgi, katrs no kuriem apstrādā noteikta veida metriku / notikumus. Sistēmā Watcher CEP palaiž divu veidu darbības: — ierakstīt attiecīgus notikumus / metrikas laika sēriju datubāzē; — nosūtīt attiecīgos notikumus komponentam Watcher Decision Engine, kad šis notikums var ietekmēt pašreizējās optimizācijas stratēģijas rezultātu, jo Openstack klusteris nav statiska sistēma.
Komponentu mijiedarbība notiek, izmantojot AMQP protokolu.
→
Mijiedarbības shēma ar Watcher
Watcher testēšanas rezultāti
- Lapas Optimization - Action plans 500 kļūda (gan tīrā Queens, gan sienā ar Tionix moduļiem), parādās tikai pēc audita uzsākšanas un rīcības plāna ģenerēšanas, tukšā lapa atveras normāli.
- Akciju detaļu cilnē kļūdas, nevar iegūt auditorijas mērķi un stratēģiju (gan tīrā Queens, gan sienā ar Tionix moduļiem).
- Auditi ar Dummy mērķi (testa) tiek radīti un uzsākti normāli, rīcības plāni tiek ģenerēti.
- Auditi ar Unclassified mērķi netiek radīti, jo mērķis nav funkcionāls un paredzēts starpposma iestatīšanai, veidojot jaunas stratēģijas.
- Auditi ar Workload Balancing mērķi (Storage Capacity balance stratēģija) tiek radīti veiksmīgi, tomēr rīcības plāns netiek ģenerēts. Nav nepieciešama glabāšanas baseinu optimizācija.
- Auditi ar Workload Balancing mērķi (Workload Balance Migration Strategy stratēģija) tiek radīti veiksmīgi, tomēr rīcības plāns netiek ģenerēts.
- Auditi ar Workload Balancing mērķi (Workload Stabilization Strategy stratēģija) beidzas ar kļūdu.
- Auditi ar Noisy Neighbor mērķi tiek radīti veiksmīgi, tomēr rīcības plāns netiek ģenerēts.
- Auditi ar Hardware maintenance mērķi tiek radīti veiksmīgi, rīcības plāns netiek ģenerēts pilnībā (orientācijas rādītāji tiek ģenerēti, bet pati rīcības saraksts netiek ģenerēts).
- Izmaiņas konfigurācijas failos nova.conf (default sadaļā compute_monitors = cpu.virt_driver) uz aprēķina un vadības mezgla neizlabo kļūdas.
- Auditi ar Server Consolidation mērķi (Basic stratēģija) arī beidzas ar kļūdu.
- Auditi ar Server Consolidation mērķi (VM workload consolidation stratēģija) beidzas ar kļūdu. Žurnālos kļūda datu iegūšanā. Kļūdas apspriešana, jo īpaši, .
Mēs mēģinājām norādīt Watcher konfigurācijas failā (nepalīdzēja — rezultātā visas Optimization lapas rāda kļūdas, atgriešanās pie sākotnējā konfigurācijas satura neizlabo situāciju):[watcher_strategies.basic]
datasource = ceilometer, gnocchi - Auditi ar mērķi taupīt enerģiju beidzas ar kļūdu. Saskaņā ar žurnāliem problēma tomēr ir saistīta ar Ironic trūkumu, bez baremetal pakalpojuma tas nedarbosies.
- Auditi ar mērķi termiskajai optimizācijai beidzas ar kļūdu. Trase ir tāda pati kā Server Consolidation (VM darba slodzes konsolidācijas stratēģijā) (sākotnējo datu kļūda).
- Auditi ar mērķi gaisa plūsmas optimizācijai beidzas ar kļūdu.
Tiek sastopamas arī šādas kļūdas auditorijas beigās. Trase žurnālos decision-engine.log (klastera stāvoklis nav definēts).
→ Kļūdas apspriešana
Secinājums
Mūsu divu mēnešu pētījumu rezultāts ir viennozīmīgs secinājums, ka, lai iegūtu pilnvērtīgu, funkcionējošu slodzes balansēšanas sistēmu, mums būs jāveic nopietns darbs pie Openstack platformas instrumentu uzlabošanas.
Watcher ir parādījis sevi kā nopietnu un ātri attīstīgu produktu ar milzīgu potenciālu, lai to pilnvērtīgi izmantotu, būs nepieciešams liels un nopietns darbs.
Bet par to – nākamajās cikla rakstos.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish