

Kā var biznesa prasības pārvērst konkrētās datu struktūrās ar piemēru, projektējot "no nulles" datu bāzi ziņojumapmaiņas lietotnei.
- 1. daļa: izstrādājam datubāzes karkasu
Mūsu datu bāze nebūs tik apjomīga un sadalīta, vai , bet "lai būtu", tomēr tai jābūt labai – funkcionālai, ātrai un ietilpīgai vienā serverī. PostgreSQL – lai varētu izvietot atsevišķu servisa eksemplāru kaut kur citur, piemēram.
Tāpēc nerunāsim par shardingu, replikāciju un ģeodistribūtām sistēmām, bet koncentrēsimies uz shēmām DB iekšienē.
1. solis: Mazliet biznesa specifikas
Mēs projektēsim mūsu ziņojumu apmaiņu nevis abstrakti, bet veiksim to iekšējā kontekstā Citiem vārdiem sakot, cilvēki mūsu gadījumā ne "vienkārši sarakstās", bet sazinās savā starpā, risinot noteiktas biznesa problēmas.
Kādas ir uzņēmuma problēmas?.. Apskatīsim piemēru ar Vasīliju – izstrādes nodaļas vadītāju.
- "Nikolaj, šai uzdevumam steidzami vajag plāksteri šodien!"
Tātad, sarakste var notikt kāda kontekstā Dokumenta. - "Kola, ejam šovakar doto spēlēt?"
Tas nozīmē, ka pat vienai pāri sarunbiedru saruna var vienlaikus norisināties par dažādām tēmām. - "Pēter, Nikolaj, lūdzu, paskaties pievienotajā failā uz jauno serveri. "
Tādējādi vienam ziņojumam var būt vairāki adresāti.Šajā laikā ziņojums var saturēt pievienotus failus. - "Semen, tu arī paskaties."
Un var būt iespēja jau esošajā sarakstē uzaicināt jaunu dalībnieku..
Paiesim pagaidām pie šī "acīmredzamo" vajadzību saraksta.
Bez pienācīgas uzdevuma specifikas izpratnes un uzdotajiem ierobežojumiem izstrādāt efektīvu DB shēmu tās risināšanai ir praktiski neiespējami.
2. solis: Minimālā loģiskā shēma
Pašreizējā shēma izskatās ļoti līdzīga e-pasta sarakstei – tradicionālais biznesa rīks. Patiešām, "algotriski" daudzas biznesa problēmas ir līdzīgas, tāpēc arī rīki to risināšanai būs strukturāli līdzīgi.
Fiksēsim jau iegūto loģisko attiecību shēmu. Lai vieglāk izprastu mūsu modeli, izmantosim visvienkāršāko attēlošanas bez UML vai IDEF notācijas sarežģījumiem:
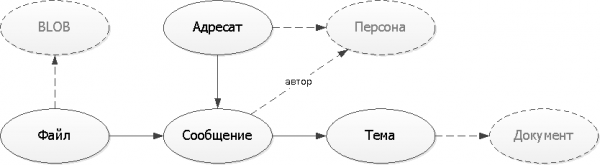
Mūsu piemērā persona, dokuments un binārais „ķermenis” fails ir „ārējās” entitātes, kas pastāv neatkarīgi no mūsu pakalpojuma. Tādēļ turpmāk mēs tās vienkārši uzskatīsim par saites „kurp” pa UUID.
Zīmējiet shēmas pēc iespējas vienkāršāk — lielākā daļa no tiem, kam jūs tās rādīsiet, nav eksperti UML/IDEF lasīšanā. Bet — noteikti zīmējiet.
3. solis: Uzbūvējam tabulu struktūru
Par tabulu un lauku nosaukumiemUz „krievu” tabulu un lauku nosaukumiem var attiekties dažādi, bet tas ir gaumes jautājums. Ņemot vērā nav ārvalstu izstrādātāju un PostgreSQL mums ļauj dot nosaukumus pat ķīniešu rakstzīmēm, ja tās ir pēdiņās, tad mēs dodam priekšroku nosaukumiem, kas ir skaidri un saprotami, lai nerastos neskaidrības.
Tā kā ziņojumus raksta daudzi cilvēki vienlaicīgi, daži no tiem pat var to darīt offline režīmā, tad vienkāršākais variants ir izmantot UUID kā identifikatorus ne tikai ārējām entitātēm, bet arī visiem objektiem mūsu pakalpojumā. Turklāt tos var ģenerēt pat klienta pusē — tas palīdzēs mums atbalstīt ziņojumu nosūtīšanu īslaicīgas DB nepieejamības laikā, un kolīziju varbūtība ir ļoti maza.
Mūsu datubāzes melnraksta tabulu struktūra izskatīsies šādi:
Tabulas : RU
CREATE TABLE "Tēma"(
  "Tēma"
    uuid
      PRIMARY KEY
, "Dokuments"
    uuid
, "Nosaukums"
    text
);

CREATE TABLE "Ziņojums"(
  "Ziņojums"
    uuid
      PRIMARY KEY
, "Tēma"
    uuid
, "Autors"
    uuid
, "DatumsLaiks"
    timestamp
, "Teksts"
    text
);

CREATE TABLE "Adresāts"(
  "Ziņojums"
    uuid
, "Persona"
    uuid
, PRIMARY KEY("Ziņojums", "Persona")
);

CREATE TABLE "Fails"(
  "Fails"
    uuid
      PRIMARY KEY
, "Ziņojums"
    uuid
, "BLOB"
    uuid
, "Nosaukums"
    text
);
Tabulas : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
Visvienkāršākā pieeja formāta aprakstīšanai — sākt „izvērst” saistību grafu no tabulām, kas nesauc nevienu citu.
4. solis: Noskaidrot neuzkrītošās vajadzības
Viss, mēs esam izstrādājuši datubāzi, kurā var lieliski rakstīt un kā nu katrs lasīt.
Ievietosim sevi lietotāja vietā, kas izmanto mūsu pakalpojumu — ko mēs vēlētos darīt, izmantojot to?
- Pēdējie ziņojumi
Tas ir hronoloģiski sakārtoti saskaņā ar dažādiem kritērijiem reģistrs "maniem" ziņojumiem. Kur es esmu viens no adresātiem, kur esmu autors, kur man ir uzrakstīts, bet es neatbildēju, kur man nav atbildēts, ... - Sarunu dalībnieki
Kas vispār piedalās šajā garajā sarunā?
Mūsu struktūra ļauj atrisināt abus šos uzdevumus "vispār", bet ātri — nē. Problēma ir tā, ka, lai sakārtotu pirmā uzdevuma ietvaros nav iespējams izveidot indeksu, kas derētu katram no dalībniekiem (un būs jāizdodas visas ieraksti), bet otrā uzdevuma izpildei nepieciešams izdodas visus ziņojumus pa tēmu.
Neplānotas lietotāja uzdevumi var smagi ietekmēt veiktspēju.
Sol 5: Pārdomāta denormalizācija
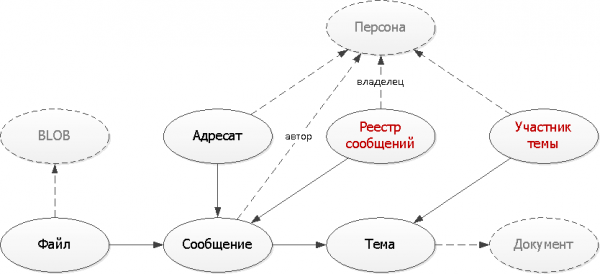
Abas mūsu problēmas varēs atrisināt papildus tabulas, kurās mēs dubulēsim daļu datu, kas nepieciešami, lai uz tām veidotu atbilstošus mūsu uzdevumiem indeksus.
Tabulas : RU
CREATE TABLE "ZiņojumuReģistrs"(
  "Īpašnieks"
    uuid
, "ReģistraTips"
    smallint
, "DatumsLaiks"
    timestamp
, "Ziņojums"
    uuid
, PRIMARY KEY("Īpašnieks", "ReģistraTips", "Ziņojums")
);
CREATE INDEX ON "ZiņojumuReģistrs"("Īpašnieks", "ReģistraTips", "DatumsLaiks" DESC);

CREATE TABLE "TēmasDalībnieks"(
  "Tēma"
    uuid
, "Persona"
    uuid
, PRIMARY KEY("Tēma", "Persona")
);
Tabulas : EN
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Šeit mēs izmantojam divus tipiskus pieejas, kas tiek pielietotas palīgtabulu izveidē:
- Ierakstu pavairošana
Izveidojam no vienas sākotnējās ziņojuma ieraksta vairākas sekojošas ierakstu formas dažādiem īpašniekiem — gan sūtītājam, gan saņēmējam. Bet tagad katrs no reģistriem atbilst indeksam — jo tipiskā gadījumā mēs vēlamies redzēt tikai pirmo lapu. - Ierakstu unikizācija
Katru reizi, kad tiek nosūtīts ziņojums konkrētā tēmā, pietiek pārbaudīt, vai jau ir tāds ieraksts. Ja nav — pievienojam to mūsu "vārdnīcai".
Nākamajā raksta daļā tiks runāts par mūsu datu bāzes struktūrā.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish