

9. janvārī tika izlaista Pandas 1.0.0rc. Iepriekšējā bibliotēkas versija — 0.25.
Pirmajā lielajā izlaidumā ir daudz lielisku jauninājumu, tostarp uzlabota datu rāmju automātiskā kopsumma, vairāk izvades formātu, jauni datu tipi un pat jauna dokumentācijas vietne.
Visas izmaiņas var apskatīt , šajā rakstā mēs ierobežosimies ar nelielu, mazāk tehnisku pārskatu par svarīgāko.
Bibliotēku var instalēt tāpat kā parasti, izmantojot pip, bet, tā kā raksta rakstīšanas laikā Pandas 1.0 vēl joprojām ir release candidate, būs jānorāda versija:
pip install --upgrade pandas==1.0.0rc0Esiet uzmanīgi: tā kā tas ir liels izlaidums, atjauninājums var sabojāt veco kodu!
Jāatzīmē, ka ar šo versiju pilnībā tiek pārtraukta Python 2 atbalsts (kas var būt labs iemesls — piezīme tulkotājam.). Pandas 1.0 prasa vismaz Python 3.6+, tāpēc, ja neesat pārliecināts, noskaidrojiet, kāds tieši jums ir instalēts:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Pārbaudīt Pandas versiju ir visvieglāk šādi:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Uzlabota automātiskā kopsumma ar DataFrame.info
Mani iecienītā jaunā funkcija ir atjauninātā metode DataFrame.info. Funkcija ir kļuvusi daudz saprotamāka, padarot datu izpēti vēl vieglāku:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Tabulu izvade Markdown formātā
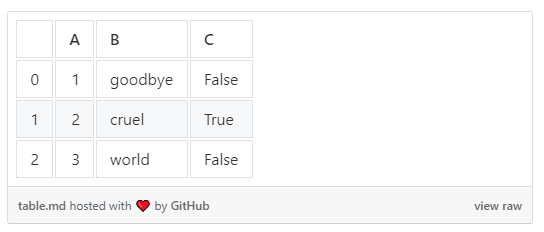
Nebija mazāk patīkams jaunums, iespēja eksportēt datu rāmjus Markdown tabulās, izmantojot DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Tas ļoti atvieglo tabulu publicēšanu tādos tīmekļa vietnēs kā Medium, izmantojot github gists.
Jauni tipi virknēm un loģiskām vērtībām
Pandas 1.0 izlaidumā bija pievienoti arī jauni eksperimentālie tipi. To API vēl var mainīt, tāpēc izmantojiet to ar piesardzību. Bet vispārīgi Papandas iesaka izmantot jaunās tipi visur, kur tas ir jēgpilni.
Pagājušajā laikā jāveic skaidra pārvēršana:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Pievērsiet uzmanību, kā kolonnu Datu tips parāda jaunus tipus — string un bool.
Visnoderīgākā jaunā tekstu veida iezīme ir iespēja izvēlēties tikai teksta kolonnas no datu rāmjiem. Tas var ievērojami atvieglot tekstu datu analīzi:
df.select_dtypes("string")Iepriekš teksta kolonnas nevarēja izvēlēties bez skaidriem nosaukumiem.
Vairāk par jaunajiem tipiem var izlasīt .
Paldies, ka izlasījāt! Pilnu izmaiņu sarakstu, kā jau tika minēts, var aplūkot .
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish