

DevOps definīcija ir ļoti sarežģīta, tāpēc katru reizi ir jāsāk diskusija par to no jauna. Tikai Habrā ir tūkstoš publikāciju par šo tēmu. Bet, ja tu to lasi, tu, visticamāk, zini, kas ir DevOps. Jo es – nē. Sveiks, mans vārds ir Aleksandrs Titovs (@), un mēs vienkārši parunāsim par DevOps un es padalīšos ar savu pieredzi.
Es ilgi domāju, kā padarīt manu stāstu noderīgu, tāpēc šeit būs daudz jautājumu – gan tos, kurus es pats sev uzdodu, gan tos, kurus es uzdodu mūsu uzņēmuma klientiem. Atbildot uz šiem jautājumiem, izpratne kļūst labāka. Es pastāstīšu, kāpēc DevOps ir nepieciešams no manas skatupunkta, kas tas ir, atkal no manas pozīcijas, un kā saprast, vai jūsu uzņēmums virzās uz DevOps vēlreiz no manas skatupunkta. Pēdējais punkts būs caur jautājumiem. Atbildot uz tiem pašam sev, jūs varēsiet saprast, vai jūsu uzņēmums virzās uz DevOps vai kaut kas nav kārtībā.
Kādu laiku es pavadīju iepazīstoties ar apvienošanās un iegādes viļņiem. Sākumā es strādāju mazā start-up uzņēmumā Qik, kuru vēlāk iegādājās mazliet lielāka kompānija Skype, kuru vēlāk iegādājās vēl mazliet lielāka kompānija Microsoft. Šajā brīdī man kļuva pieejama izpratne, kā tiek pārveidota izpratne par DevOps dažādu lielumu uzņēmumos. Pēc tam man kļuva interesanti jau tirgus skatījumā aplūkot DevOps, un mēs ar kolēģiem izveidojām uzņēmumu Ekspress 42. Jau 6 gadus mēs virzamies tajā pa tirgus viļņiem.
Turklāt es esmu viens no DevOps Moscow kopienas organizatoriem un DevOps -Days 2017 organizators, bet 2018. gadā es organizēju. Ekspress 42 sadarbojas ar daudziem uzņēmumiem. Mēs rūpējamies par DevOps attīstību, skatāmies, kā tas notiek, izdarām secinājumus, analizējam, pastāstām savus secinājumus visiem, mācām cilvēkus DevOps praksi. Vispār, mums ir ļoti svarīgi pilnveidot pieredzi un ekspertīzi šajā jomā.
Kāpēc DevOps
Pirmais jautājums, kas vajā visus un vienmēr – kāpēc? Daudzi uzskata, ka DevOps ir tikai automatizācija vai līdzīga lieta, kas jau bija katrā uzņēmumā.
– Mums bija Continuous Integration – tas nozīmē, ka jau bija DevOps, un kāpēc visu šo muldēšanu vajag? Tur ārzemēs izklaidējas, bet mums traucē strādāt!
Pēc 9 gadu attīstības sabiedrības un metodoloģijas jau ir skaidrs, ka tas tomēr nav tikai mārketinga mirdzums, bet joprojām nav pilnībā skaidrs, kāpēc tas ir nepieciešams. Kā jebkuram instrumentam un procesam, DevOps ir konkrēti mērķi, kurus tas galu galā risina.
Tas viss ir saistīts ar to, ka pasaule mainās. Tā pāriet no uzņēmumu pieejas, kad kompānijas tiecas uz sapni, kā dziedāja mūsu Pēterburgas klasiķis, no punkta A uz punktu B, saskaņā ar noteiktu stratēģiju, ar šim mērķim izveidotu struktūru.
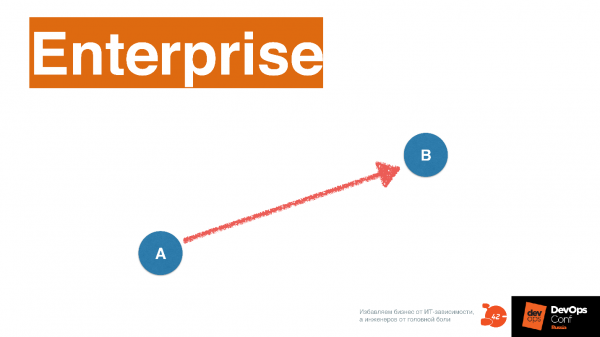
Principā IT viss ir jābūvē atbilstoši šai pieejai. Šeit IT tiek izmantots tikai procesu automatizācijai.
Automatizācija nemainās bieži, jo, kad kompānija ripina pa iepriekš izveidoto taciņu – ko tad tur mainīt? Ja viss darbojas – netraucē. Tagad pasaulē pieejas mainās, un tā, ko sauc par Agile, norāda, ka beigu punkts B nav uzreiz redzams.
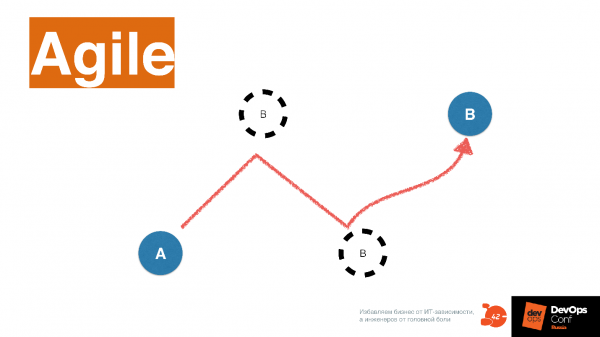
Kad kompānija iet tirgū, strādā ar klientu – tā pastāvīgi pēta tirgu un maina beigu punktu B. Turklāt, jo biežāk kompānija maina savu virzienu, jo veiksmīgāka tā galu galā ir, jo tā izvēlas vairāk tirgus nišu.
Stratēģiju demonstrē interesanta kompānija, par kuru es uzzināju nesen. One Box Shave – tas ir pakalpojums, kas piedāvā skūšanās mašīnas un piederumus, kas pieejami pa abonementu kastītē. Viņi prot pielāgot savu "kastīti" dažādiem klientiem. Ar to nodarbojas noteikts programs, kas pēc tam nosūta pasūtījumu uz korejiešu fabriku, kas ražo produktu.
Šo produktu iegādājās kompānija Unilever par 1 miljardu dolāru. Tagad tas konkurē ar Gillette un ir izsitis no tirgus ievērojamu pircēju daļu Amerikā. One Box Shave teikt:
— 4 asmeņi? Vai jūs nopietni? Kāpēc tas jums vajadzīgs – tas nemaz neuzlabo skūšanās kvalitāti. Speciāli izvēlēts krēms, smarža un kvalitatīvs skuveklis ar diviem asmeņiem risina daudz vairāk jautājumu nekā šie muļķīgie 4 asmeņi Gillette! Kamēr mēs tik drīz nonāksim līdz 10?
Tā pasaule mainās. Unilever paziņo, ka viņiem ir lieliska IT sistēma, kas to ļauj paveikt. Galu galā tas izskatās pēc koncepcijas Time-to-market, par kuru jau ir runājuši daudzi.
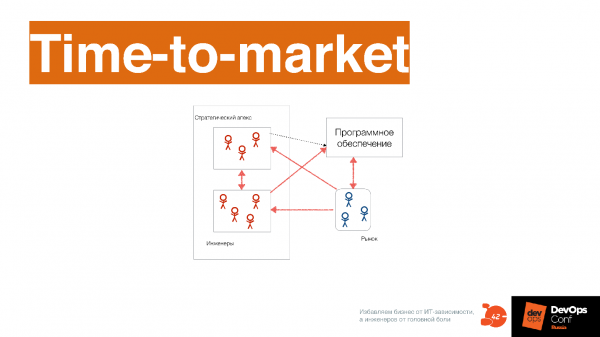
Time-to-market nozīmē nevis to, cik bieži mēs veicam izvietošanu. Dažreiz var būt bieža izvietošana, bet izlaišanas cikli var būt gari. Ja trīs mēnešu izlaišanas ciklus viena pēc otra pārvieto nedēļā, tad iznāk, ka uzņēmums it kā izvieto reizi nedēļā. Bet ideja līdz galīgajai realizācijai aizņem 3 mēnešus.
Time-to-market ir par laika minimizēšanu no idejas līdz galīgajai realizācijai.
Šajā gadījumā ar tirgu mijiedarbojas programmatūra. Piemēram, One Box Shave mājaslapa mijiedarbojas ar klientu. Viņiem nav pārdevēju — tikai mājaslapa, kur apmeklētājs spiež un atstāj vēlmes. Tāpēc mājaslapā ir pastāvīgi jāpublicē kaut kas jauns, jāatjauno tas atbilstoši vēlmēm. Piemēram, Dienvidkorejā skūstas ne tā, kā Krievijā, un viņiem nepatīk aromāts no priedēm, bet gan, piemēram, burkāni un vaniļa.
Tā kā nepieciešams ātri mainīt mājaslapas saturu, programmatūras izstrāde ievērojami mainās. Caur programmatūru mums jānoskaidro, ko vēlas klients. Agrāk mēs to uzzinājām dažādos veidos, piemēram, caur biznesa menedžmentu. Pēc tam projektējām, iekļāvām prasības IT sistēmā, un viss bija lieliski. Tagad viss ir citādi – programmatūru projektē visi, kas iesaistīti procesā, tostarp inženieri, jo viņi, izmantojot tehniskās specifikācijas, uzzina, kā darbojas tirgus, un arī dalās ar biznesu savos ieskatos.
Piemēram, uzņēmumā Qik mēs pēkšņi uzzinājām, ka cilvēkiem ļoti patīk augšupielādēt kontaktu sarakstus serverī, un viņi mums izstrādāja lietotni. Sākotnēji mēs par to nebijām domājuši. Klasiskā uzņēmumā visi teiktu, ka tas ir kļūda, jo specifikācijās nav norādīts, ka tas jādarbojas labi un tas vispār tika realizēts uz ceļiem, tādēļ tiktu izslēgta funkcija un teikts: “Tas nevienam nav vajadzīgs, svarīgākais ir tas, ka galvenā funkcionalitāte darbojas.” Bet tehnoloģiju uzņēmums šajā redz iespēju un sāk mainīt programmatūru saskaņā ar to.
1968. gadā prozorojošs puisis Melvins Konvejs formulēja sekojošo ideju.
Organizācija, kas izveido sistēmu, ir ierobežota dizainā, kas atspoguļo saziņas struktūru šajā organizācijā.
Ja detalizētāk, lai izveidotu cita tipa sistēmas, ir nepieciešama citu veidu komunikācijas struktūra uzņēmumā. Ja jums ir augšējā hierarhiskā komunikācijas struktūra, tā neļaus jums veidot sistēmas, kas var nodrošināt ļoti augstu Time-to-market rādītāju.
Lasīt var . Tas ir svarīgi, lai saprastu DevOps kultūru vai filozofiju, jo vienīgais, kas pamatīgi mainās DevOps, ir tieši komunikācijas struktūra starp komandām.
Procesa skatījumā pirms DevOps visas stadijas: analīze, izstrāde, testēšana, ekspluatācija, notika lineāri.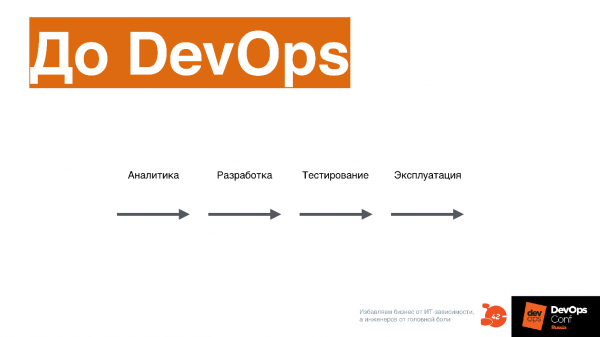
DevOps gadījumā visi šie procesi notiek vienlaikus.
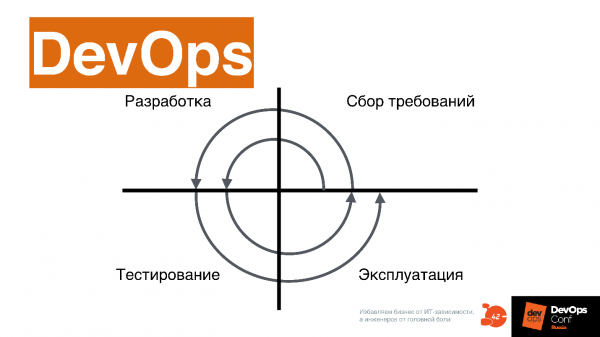
Time-to-market tikai tā var tikt izpildīts. Cilvēkiem, kuri strādājuši vecajā procesā, tas šķiet nedaudz kosmiski un vispār tāds sev.
Tad kāpēc nepieciešams DevOps?
Digitālo produktu izstrādei. Ja jums uzņēmumā nav digitālā produkta, DevOps nav vajadzīgs — tas ir ļoti svarīgi.
DevOps pārvar programmatūras ražošanas secīgas shēmas ātruma ierobežojumus. Tajā visi procesi notiek vienlaikus.
Piecelties sarežģītība. Kad DevOps evaņģēlisti stāsta, ka ar to jums būs vieglāk laist programmatūru tirgū — tas ir muļķības.
Ar DevOps viss būs tikai sarežģītāk.
Konferencē pie Avito stenda varēja redzēt, kas ir Docker konteineru izvietošana — nereāls uzdevums. Sarežģītība kļūst nepanesama, ir jāžonglē ar daudziem bumbām vienlaikus.
DevOps pilnībā maina procesu un organizāciju uzņēmumā — precīzāk, nevis DevOps maina, bet gan digitālais produkts. Lai nonāktu pie DevOps, tomēr šim procesam ir jāmainās pilnībā.
Jautājumi speciālistam
Bet kā jūs? Jautājumi, kurus varat uzdot sev, strādājot uzņēmumā un attīstoties kā speciālists.
Vai jums ir stratēģija digitālā produkta izveidei? Ja ir — jau labi. Tas nozīmē, ka jūsu uzņēmums virzās uz DevOps.
Jūsu uzņēmums jau izstrādā digitālo produktu? Tas nozīmē, ka jūs varat uzkāpt vēl par vienu pakāpi augstāk, darboties interesantākā jomā — no DevOps skatupunkta atkal. Es tikai no šī skatupunkta runāju.
Vai jūsu uzņēmums ir viens no tirgus līderiem digitālā produkta nišā? Spotify, Yandex, Uber — kompānijas, kas šobrīd ir tehnoloģiju progresā augstākajā punktā.
Uzdodiet sev šos jautājumus, un, ja visi atbildes ir negatīvas, tad iespējams, jums nevajadzētu darboties DevOps šajā uzņēmumā. Ja temats par DevOps tiešām jums interesē, varbūt… jums vajadzētu pārstāties kādā citā uzņēmumā? Ja jūsu uzņēmums vēlas uzsākt DevOps, bet uz visiem jautājumiem jūs esat atbildējuši „Nē”, tad tas atgādina šo skaisto rinoceros, kas nekad nemainīsies.
Organizācija
Kā jau teicu, saskaņā ar Konveja likumu uzņēmumā mainās organizācija. Sākušu ar to, kas traucē DevOps iekļūt uzņēmumā tieši no organizācijas viedokļa.
Problema „silos”
Angļu vārds „Silo” šeit ir tulkots uz krievu valodu kā „kolodiets”. Jēga šai problēmai ir tāda, ka starp komandām nav informācijas apmaiņas. Katrs komanda izrok savu ekspertīzi, neizveidojot kopēju karti, kurā var orientēties.
Tas kaut ko atgādina par cilvēku, kurš tikko ir ieradies Maskavā un vēl nezina, kā orientēties metro kartē. Maskavieši parasti lieliski zina savu rajonu, bet visā Maskavā orientējas pēc metro kartes. Kad tu ierodies Maskavā pirmo reizi, šī prasme nav pieejama, un tu esi vienkārši dezorientēts.
DevOps piedāvā iet cauri šim dezorientācijas mirklim un visām struktūrām kopā izveidot kopēju mijiedarbības karti.
Tam traucē divi faktori.
Sekas korporatīvās pārvaldības sistēmas. Tā ir izveidota atsevišķos hierarhiskos „kolodietos”. Piemēram, uzņēmumos ir noteikti KPI, kas atbalsta šo sistēmu. No otras puses, traucē cilvēka domāšana, kuram ir grūti izkāpt no savas ekspertīzes robežām un orientēties visā sistēmā. Tas ir vienkārši neērti. Iedomājieties, ka esat nonākuši Bangkokas lidostā — tur ātri neorientēsities. Arī DevOps ir grūti orientēties, un tāpēc cilvēki saka, ka nepieciešams atrast ceļvedi, lai tur nokļūtu.
Bet pats galvenais, ka problēma „kolodiets” inženierim, kurš ir iedvesmojies ar DevOps garu, izlasījis Foulira un daudz citu grāmatu, izpaužas tajā, ka „kolodieti” neļauj veikt „acīmredzamas” lietas. Mēs bieži sanākam kopā pēc DevOps Maskava, runājam viens ar otru, un cilvēki sūdzas:
Mēs vienkārši gribējām palaist CI, bet izrādījās, ka vadībai tas nav nepieciešams.
Tas notiek tieši tāpēc, ka CI un Continuous Delivery process atrodas daudzu ekspertīžu robežās. Vienkārši nepārvarot "stāvokļa" problēmu organizācijas līmenī, neizdosies virzīties uz priekšu, lai ko jūs darītu un cik skumji tas neizklausītos.
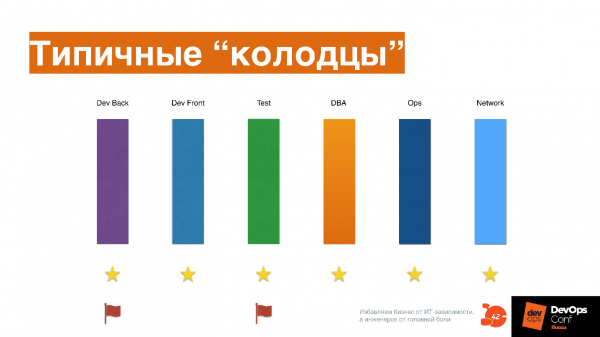
Katrs procesa dalībnieks uzņēmumā: atpakaļ un priekšpuses izstrādātāji, testēšana, DBA, ekspluatācija, tīkls, rakt savā virzienā, bet kopīgas kartes neviens neiegūst, izņemot vadītāju, kurš kaut kā viņus uzrauga un pārvalda ar metodi "dalīšanās un valdīšana."
Cilvēki cīnās par kaut kādām zvaigznītēm vai karogiem, katrs rakt savu ekspertīzi.
Galu galā, kad parādās uzdevums apvienot visu kopā un izveidot kopējo cauruļvadu, un par zvaigznītēm un karogiem vairs nav jācīnās, rodas jautājums - ko tad darīt? Jāvienojas, bet kā to izdarīt, mūs skolā neviens nemācīja. Mēs vēl no skolas esam mācīti: astotais klases - vau! - salīdzinājumā ar septīto klasi! Šeit ir līdzīgi.
Jūsu uzņēmumā ir tāpat?
Lai to pārbaudītu, varat uzdot sev šādus jautājumus.
Vai komandas izmanto kopējos rīkus, vai iegulda izmaiņās šajos kopējos rīkos?
Cik bieži komandas pārveidojas - daži speciālisti no vienas komandas pāriet uz citu? Tieši DevOps vidē tas kļūst normāli, jo dažreiz cilvēks vienkārši nevar saprast, ar ko nodarbojas cita ekspertīzes joma. Viņš pāriet uz citu nodaļu, divas nedēļas tur strādā, lai radītu sev orientācijas un mijiedarbības karti ar šo nodaļu.
Vai ir iespējams izveidot izmaiņu komiteju un kaut ko mainīt? Vai tam ir nepieciešama spēcīga augstākās vadības roka un rīkojums? Nesen es uzrakstīju Facebook, kā viens mazāk zināms banka ievieš rīkus, izdot rīkojumu, gadu ievieš, skatāmies, kas notiek. Tas, protams, ir ilgi un skumji.
Cik svarīgi ir vadītājiem gūt personiskus sasniegumus, neņemot vērā uzņēmuma sasniegumus?
Ja jūs sev atbildēsiet uz šiem jautājumiem, kļūs skaidrāk, vai jums ir tāda problēma uzņēmumā.
Infrastruktūra kā kods
Pēc tam, kad šī problēma ir atrisināta, pirmā svarīgā prakse, bez kuras ir grūti virzīties uz priekšu DevOps, ir infrastruktūra kā kods.
Visbiežāk infrastruktūra kā kods tiek uztverta šādi:
— Ļaujiet visu automatizēt ar bash, piesātināsim ar skriptiem, lai administratoriem būtu mazāk manuālā darba!
Bet tā nav.
Infrastruktūra kā kods nozīmē, ka IT sistēmu, ar kuru strādājat, jūs aprakstat kā kodu, lai nepārtraukti saprastu tās stāvokli.
Kopā ar citām komandām jūs izveidojat karti kā koda formā, kas ir visiem saprotama, pēc kuras var orientēties un navigēt. Nav svarīgi, uz kā tā ir izveidota — Chef, Ansible, Salt, vai arī tiek izmantoti YAML faili Kubernetes — nav nekādas atšķirības.
Konferencē kolēģis no 2GIS stāstīja, kā viņi izstrādāja savu iekšējo rīku Kubernetes, kas apraksta atsevišķu sistēmu uzbūvi. Lai aprakstītu 500 sistēmas, viņiem bija nepieciešams īpašs rīks, kas ģenerē šo aprakstu. Kad šis apraksts ir pieejams, ikviens var salīdzināt ar citiem, uzraudzīt izmaiņas, kā to mainīt un uzlabot, kā arī saprast, kādā veidā tas trūkst.
Piekrītat, atsevišķi bash skripti parasti nedod šo izpratni. Vienā no uzņēmumiem, kur es strādāju, bija pat nosaukums "write only" skripts — kad skripts ir uzrakstīts, bet to vairs nav iespējams izlasīt. Domāju, tas jums arī būs pazīstams.
Infrastruktūra kā kods ir kods, kas apraksta aktuālo infrastruktūras stāvokli. Pār šo kodu kopā strādā daudzas produktu, infrastruktūras un pakalpojumu komandas, un, galvenais, visiem tiem jāizprot, kā šis kods vispār darbojas.
Kods tiek uzturēts saskaņā ar labākajām prakses prasībām saistībā ar kodu: kopīga izstrāde, kods-pārbaude, XP-programming, testēšana, pull pieprasījumi, CI infrastruktūras kodam — tas viss ir derīgs un var tikt izmantots.
Kods kļūst par kopīgu valodu visiem inženieriem.
Izmaiņas infrastruktūrā kodā neprasa daudz laika. Jā, infrastruktūras kodā arī var būt tehniskais parāds. Parasti komandas ar to saskaras pēc pusotra gada, kad sāk ieviest "infrastruktūru kā kodu" kā virkni skriptu vai pat Ansible, kuru viņi raksta kā nūdeles-kodu, un vēl bash skriptus pievieno visam.
Svarīgi: ja jūs vēl neesat izmēģinājuši šo lietu, atcerieties, ka Ansible nav bash! Lūdzu, rūpīgi izlasiet dokumentāciju un izpētiet, ko par to raksta.
Infrastruktūra kā kods — tā ir infrastruktūras koda dalīšana atsevišķās slāņos.
Mūsu uzņēmumā mēs izdalām 3 pamata slāņus, kas ir ļoti saprotami un vienkārši, bet var būt arī vairāk. Jūs varat aplūkot savu infrastruktūras kodu un noteikt, vai jums ir šis nosacījums vai nē. Ja nav izdalīti nekādi slāņi, tad ir jāizvēlās laiks un nedaudz jāpārstrādā.
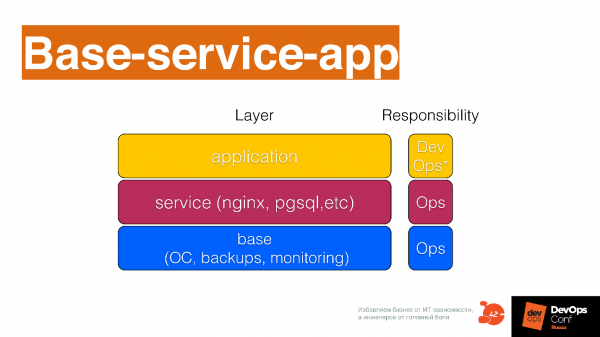
Pamata slānis — tas ir, kā tiek konfigurēta OS, rezerves kopijas un citas zemas līmeņa lietas, piemēram, kā tiek uzstādīts Kubernetes pamata līmenī.
Servisu līmenis — tie ir pakalpojumi, kurus jūs sniedzat izstrādātājam: žurnālu kā pakalpojumu, uzraudzību kā pakalpojumu, datu bāzi kā pakalpojumu, slodzes balansēšanu kā pakalpojumu, rindu kā pakalpojumu, Pastāvīgu piegādi kā pakalpojumu — daudzus pakalpojumus, kurus atsevišķas komandas var nodrošināt izstrādei. Viss tas ir jāapraksta atsevišķos moduļos jūsu konfigurācijas pārvaldības sistēmā.
Slānis, kurā tiek veidotas lietotnes un tiek aprakstīts, kā tās tiks izvietotas virs diviem iepriekšējiem slāņiem.
Kontroles jautājumi
Vai jūsu uzņēmumam ir kopīgs infrastruktūras repozitorijs? Vai jūs kontrolējat tehnisko parādu infrastruktūrā? Vai jūs izmantojat izstrādes praksi infrastruktūras repozitorijā? Vai jūsu infrastruktūra ir sadalīta slāņos? Var pārbaudīt saskaņā ar shēmu Base-service-APP. Cik grūti ir veikt izmaiņas?
Ja jums ir bijusi pieredze, kad izmaiņu izdarīšana ilga pusotru dienu, tas nozīmē, ka jums ir radies tehniskais parāds, ar kuru jāstrādā. Jūs tieši esat saskārušies ar tehniskā parāda grūtībām infrastruktūras kodā. Es atceros daudz tādu stāstu, kad, lai mainītu kādu CCTL, bija jā pārstrādā puse infrastruktūras koda, jo radošums un vēlme visu automatizēt noveda pie tā, ka visur ir viss aizsērējis, visas rokas ir noņemtas un nepieciešams pārstrādāt.
Pastāvīga piegāde
Apskatīsim debetu pret kredītu. Vispirms tiek sniegta infrastruktūras apraksts, kas var būt diezgan pamata. Nav obligāti viss jādetaļo, bet kāds pamata apraksts ir nepieciešams, lai jūs varētu ar to strādāt. Pretējā gadījumā nav skaidrs, uz kā tālāk veidot nepārtrauktu piegādi. Visas šīs prakses tiek īstenotas vienlaikus, kad jūs pievēršaties DevOps, bet jāsāk ar izpratni par to, kas jums ir, un kā to pārvaldīt. Tas ir tieši prakse 'infrastruktūra kā kods'.
Kad saprasts, kas jums ir un kā to pārvaldīt, jūs sākat domāt, kā izstrādātāja kodu visātrāk nosūtīt uz produkciju. Proti, kopā ar izstrādātāju — atcerieties par «akmeņiem» problēmu, tas ir, nevis atsevišķi cilvēki to izdomā, bet komanda.
Kad mēs ar Ivanu Jevtuhoviču redzējām pirmo grāmatu Džesa Hambla un autora grupas «Nepārtraukta piegāde», kas iznāca 2009. gadā, mēs ilgi domājām, kā pārtulkot tās nosaukumu krievu valodā. Gribējām to tulkot kā «Pastāvīgi piegādāt», bet, diemžēl, to pārtulkojām kā «Nepārtraukta piegāde». Man šķiet, ka mūsu nosaukumā ir kaut kas krievisks, ar spēku.
Pastāvīgi piegādāt — tas nozīmē
Kods, kas atrodas produktā krātuvē, vienmēr var tikt izlaists produkcijā. Tas var arī netikt izlaists, bet vienmēr ir gatavs tam. Attiecīgi, jūs vienmēr rakstāt kodu ar grūti izskaidrojamu satraukuma sajūtu. Tā bieži parādās, kad izsūtāt infrastruktūras kodu. Šī satraukuma sajūtai ir jābūt — tā iedarbina domāšanas procesus, kas ļauj rakstīt kodu nedaudz savādāk. Tas jānostiprina noteikumos izstrādes procesā.
Lai vienmēr piegādātu, nepieciešams artefakta formāts, kas iet cauri infrastruktūras platformai. Ja jūs uz infrastruktūras platformu mestat dažāda formāta «dzīves atkritumus», tad tā kļūst neviendabīga, to ir grūti uzturēt, rada tehniskā parāda problēmu. Artefakta formātu nepieciešams izlīdzināt — tas ir arī kolektīvs uzdevums: visiem kopā jāsapulcējas, jāaktivizē smadzenes un jāizdomā šis formāts.
Artefakts nepārtraukti uzlabojas un mainās, pārejot cauri piegādes cauruļvadam. Kad artefakts pārvietojas cauri cauruļvadam, tam vienmēr traucē neērtas lietas, kas līdzīgas tiem izaicinājumiem, ar kuriem saskaras artefakts, ko jūs izlaidāt ražošanā. Ja klasiskā izstrādē ar to nodarbojas sistēmu administrators, kurš veic izlaidi, tad DevOps procesā tas notiek pastāvīgi: šeit tas tiek pārbaudīts ar testiem, tur - ievietots Kubernetes klasterī, kas ir vairāk vai mazāk līdzīgs ražošanai, un šeit pēkšņi sākas slodzes testēšana.
Tas nedaudz atgādina spēli Pac-Man - artefakts iziet cauri kādai stāstij. Ir svarīgi kontrolēt, vai kods faktiski iziet stāstu un vai tas ir saistīts ar jūsu ražošanu. Notikumus ar ražošanu var iekļaut Continuous Delivery procesā: kādam tā ir bijis, kad kaut kas sabojājās, tagad mēs vienkārši programmēsim šo scenāriju sistēmā. Katru reizi kods iziet šo scenāriju un jūs nesaskaraties ar šo problēmu nākamreiz. Jūs uzzināsiet par to daudz agrāk, pirms tas nonāks pie jūsu klienta.
Dažādas izvietošanas stratēģijas. Piemēram, jūs izmantojat AB testēšanu vai kanariešu izvietojumus, lai dažādi "pārbaudītu" kodu pie dažādiem klientiem, iegūtu informāciju par to, kā kods darbojas, un daudz agrāk, pirms tas tiks izlaists uz 100 miljoniem lietotāju.
"Nepārtraukti piegādāt" izskatās šādi.
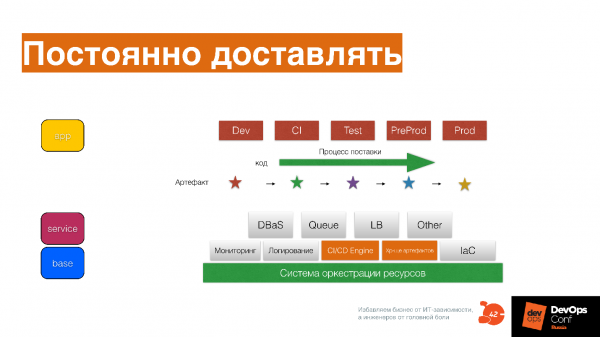
Izstrādes, CI, testēšanas, priekšprodukcijas un ražošanas piegādes process - tas nav atsevišķa vide, bet gan posmi vai stacijas ar nedegošām sumām, pa kurām pārvietojas jūsu artefakts.
Ja jums ir infrastruktūras kods, kas ir aprakstīts kā Base Service APP, tas palīdz neaizmirst visus scenārijus,, un ierakstīt tos arī kā kodu šim artefaktam, virzīt artefaktu un mainīt to kustības gaitā.
Jautājumi pašpārbaudei
Laiks no funkcionalitātes apraksta līdz izlaidei ražošanā ir 95% gadījumu mazāk par nedēļu? Vai artefakta kvalitāte palielinās katrā cauruļvada posmā? Vai ir stāsts, pa kuru tas pārvietojas? Vai jūs izmantojat dažādas izvietošanas stratēģijas?
Ja uz visiem jautājumiem ir atbilde jā, tad jūs esat neticami forši! Lūdzu, ierakstiet atbildes komentāros - es būšu priecīgs).
Atsauksmes
Šī ir pati grūtākā prakse no visām. Konferencē DevOpsConf kolēģis no Infobip, runājot par to, nedaudz mulsāja vārdos, jo tas patiešām ir ļoti sarežģīta prakse par to, ka jāuzrauga faktiski viss!
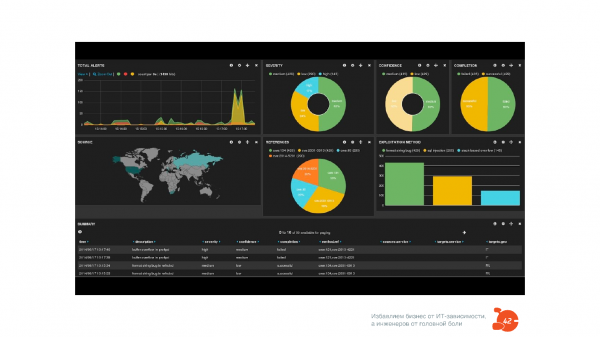
Piemēram, sen, kad es strādāju Qik un sapratām, ka jāuzrauga faktiski viss. Mēs to izdarījām, un Zabbix mums bija 150 000 vienību, kuras tiek nepārtraukti uzraudzītas. Tas bija biedējoši, tehniskais direktors grozīja pirkstu pie tempļa:
— Puiši, kāpēc jūs serveri nomocāt ar neskaidru lietu?
Bet tad notika gadījums, kas parādīja, ka tas patiešām ir ļoti forša stratēģija.
Pastāvīgi sāka zust viens no pakalpojumiem. Sākotnēji viņš nekrīt, kas ir interesanti, tur kods netika rakstīts, jo tas bija pamata brokera, kurā praktiski nebija biznesa funkcionalitātes — viņš vienkārši sūtīja ziņojumus starp atsevišķiem pakalpojumiem. Pakalpojums nemainījās 4 mēnešus, un pēkšņi sāka krist, ar kļūdu "Segmentation fault".
Mēs bijām šokēti, atvērām mūsu grafikus Zabbix, un noskaidrojām, ka pirms pusotras nedēļas būtiski mainījās pieprasījumu uzvedība API pakalpojumā, kas izmanto šo brokeri. Tālāk mēs paskatījāmies, ka mainījās noteiktā ziņojumu veida nosūtīšanas biežums. Pēc tam noskaidrojām, ka tas bija Android klienti. Mēs jautājām:
— Puiši, kas jums notika pusotras nedēļas laikā?
Atbildē dzirdējām interesantu stāstu par to, ka viņi pārbūvēja UI. Maz ticams, ka kāds uzreiz pateiks, ka mainījās HTTP bibliotēka. Android klientiem tas ir kā ziepes vannā — viņi to vienkārši neatceras. Galu galā, pēc 40 minūšu sarunas mēs noskaidrojām, ka viņi tomēr nomainīja HTTP bibliotēku, un tai mainījās noklusējuma laiki. Tas noveda pie tā, ka mainījās trafika uzvedība pie API servera, kas savukārt noveda pie situācijas, kas izraisīja sacensību iekšējo brokerī, un viņš sāka krist.
Bez dziļas uzraudzības to vispār ir neiespējami atklāt.. Ja organizācijā ir vēl viena problēma ar "ūdenstecēm", kad visi met viens uz otru, tas var ilgstoši turpināties. Jūs vienkārši restartējat serveri, jo problēmu nav iespējams atrisināt. Kad jūs monitorējat, sekojat līdzi un reģistrējat visus notikumus, kas jums ir, un izmantojat monitoringu kā testēšanu — rakstāt kodu un tūlīt norādāt, kā to monitorēt, arī kodā (mums jau ir infrastruktūra kā kods), viss kļūst skaidrs kā plaukstā. Pat tādas sarežģītas problēmas ir viegli izsekojamas.
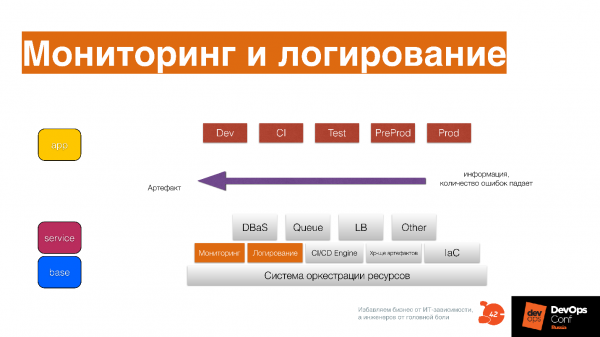
Vāciet visu informāciju par to, kas notiek ar artefaktu katrā piegādes procesa posmā — ne ražošanā.
Ielieciet monitoringu CI, un tur jau būs redzamas dažas pamata lietas. Tālrakstīja jūs tās ieraudzīsiet gan Test, gan PredProd, gan slodzes testēšanā. Vāciet informāciju visos posmos, un ne tikai metriku, statistiku, bet arī žurnālus: kā tika palaikts lietojums, anomālijas — vācat visu.
Pretējā gadījumā būs grūti saprast. Es jau teicu, ka DevOps ir lielāka kompleksitāte. Lai tiktu galā ar šo kompleksitāti, nepieciešama normāla analītika..
Pašnovērtēšanas jautājumi.
Vai jūsu monitorings un žurnāla ieraksti ir izstrādes instruments jums? Vai jūsu izstrādātāji, un jūs pats, rakstot kodu, domājat par to, kā to monitorēt?
Vai jūs uzzināt par problēmām no klientiem? Vai jūs labāk saprotat klientu no monitoringa un žurnāla ierakstiem? Vai jūs labāk saprotat sistēmu no monitoringa un žurnāla ierakstiem? Vai jūs maināt sistēmu tikai tāpēc, ka redzat pieaugumu sistēmā un saprotat, ka vēl trīs nedēļas un viss sabruks?
Kad jums ir šie trīs komponenti, varat padomāt par to, kāda ir jūsu uzņēmuma infrastruktūras platforma.
Infrastruktūras platforma.
Jēga nav tajā, ka tas ir atsevišķu instrumentu kopums, kas ir katrā uzņēmumā.
Infrastruktūras platformas jēga ir tāda, ka visas komandas izmanto šos instrumentus un attīsta tos kopīgi.
Ir skaidrs, ka ir atsevišķas komandas, kas ir atbildīgas par atsevišķu infrastruktūras platformas daļu attīstību. Bet tajā pašā laikā atbildība par attīstību, darbspēju, infrastruktūras platformas popularizēšanu ir katra inženiera ziņā. Iekšējā līmenī tas kļūst par kopīgu instrumentu.
Visas komandas attīsta infrastruktūras platformu, izturas pret to kā pret savu IDE. Savā IDE jūs instalējat dažādus spraudņus, lai viss būtu skaisti un ātri, iestatāt saīsinājumtaustiņus. Kad atverat Sublime, Atom vai Visual Studio Code, jūs tur redzat koda kļūdas un saprotat, ka nav iespējams strādāt, jūs uzreiz sajūtat skumjas un skrienat labot savu IDE.
Tieši tāpat izturieties pret savu infrastruktūras platformu. Ja saprotat, ka ar to kaut kas nav kārtībā, iesniedziet pieteikumu, ja paši nevarat labot. Ja tur ir kaut kas vienkāršs - labojiet paši, nosūtiet pull request - puiši to izskatīs, pievienos. Tas ir nedaudz atšķirīgs pieejas veids inženiertehniskajiem rīkiem izstrādātāja prāta ietvaros.
Infrastruktūras platforma nodrošina artefakta pārvietošanu no izstrādes uz klientu ar pastāvīgu kvalitātes uzlabošanu. IP ir ieprogrammēts stāstu kopums, kas attiecas uz kodu ražošanā. Gadu gaitā šo stāstu kļūst ļoti daudz, daļa no tiem ir unikāli un attiecas tikai uz jums - tos nav iespējams sameklēt.
Šajā brīdī infrastruktūras platforma kļūst par jūsu konkurences priekšrocību, jo tajā ir iekļauts tas, kāda nav konkurenta rīkos. Jo dziļāka ir jūsu IP, jo lielāka ir jūsu konkurences priekšrocība attiecībā uz Time-to-market. Šeit radīsies vendora slēgšanas problēma: jūs varat ņemt sev svešu platformu, bet, izmantojot svešu pieredzi, jūs nesapratīsit, cik tā ir attiecināma uz jums. Jā, ne katra kompānija var uzbūvēt platformu, kas ir līdzīga Amazonai. Tas ir sarežģīts aspekts, kur uzņēmuma pieredze ir atbilstoša tā pozīcijai tirgū, un šeit nevajadzētu atslābināt vendor lock. Par to arī ir svarīgi padomāt.
Shēma
Šī ir pamata infrastruktūras platformas shēma, kas palīdzēs jums sakārtot visas prakses un procesus DevOps uzņēmumā.
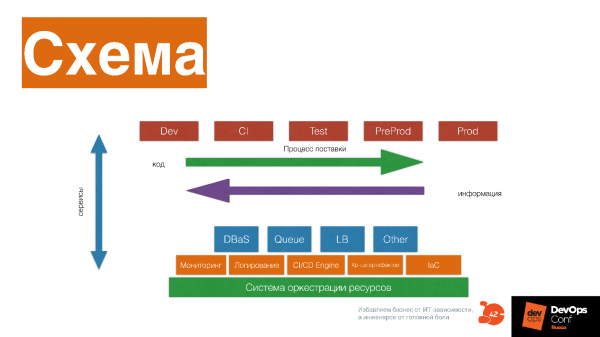
Apskatīsim, no kā tā sastāv.
Resursu orķestrēšanas sistēma, kas nodrošina CPU, atmiņu, disku lietojumprogrammām un citām pakalpojumu sistēmām. Virs tā - zemāka līmeņa pakalpojumi: uzraudzība, žurnālu saglabāšana, CI/CD dzinējs, artefaktu krātuve, infrastruktūra kā kods sistēmām.
Augstāka līmeņa pakalpojumi: datu bāze kā pakalpojums, rindas kā pakalpojums, Load Balance kā pakalpojums, attēlu pārveidošana kā pakalpojums, Big Data fabrika kā pakalpojums. Virs tā — pipeline, kas nepārtraukti piegādā modificētu kodu jūsu klientam.
Jūs saņemat informāciju par to, kā jūsu programmatūra darbojas pie klienta, veicat izmaiņas, atkārtoti piegādājat šo kodu, saņemat informāciju — un tā nepārtraukti attīstāt gan infrastruktūras platformu, gan savu programmatūru.
Diagrammā piegādes pipeline sastāv no daudziem posmiem. Bet tas ir principāls shēma, kas sniegta piemēram — nav nepieciešams to atkārtot tieši tāpat. Posmi mijiedarbojas ar pakalpojumiem, kā ar pakalpojumiem — katram platformas blokam ir sava vēsture: kā tiek piešķirti resursi, kā lietojumprogramma startē, strādā ar resursiem, tiek uzraudzīta un mainīta.
Ir svarīgi saprast, ka katra platformas daļa nes savu stāstu, un uzdot sev jautājumu — kādu stāstu nes šis bloks, varbūt to vajadzētu izmest un aizstāt ar trešo pušu pakalpojumu. Piemēram, vai varam vietā šī bloka izmantot Okmeter? Varbūt puņi ir attīstījuši šo ekspertīzi daudz labāk nekā mēs. Bet varbūt nav — iespējams, mums ir unikāla ekspertīze, mums ir jāievieš Prometheus un jāturpina attīstīt to tālāk.
Platformas izveide
Tas ir sarežģīts komunikācijas process. Kad jums ir pamata prakses, jūs uzsākat saziņu starp dažādiem inženieriem un speciālistiem, kuri izstrādā prasības un standartus, un pastāvīgi tos maina attiecībā uz dažādiem rīkiem un pieejām. Šeit svarīga ir kultūra, kas pastāv DevOps.
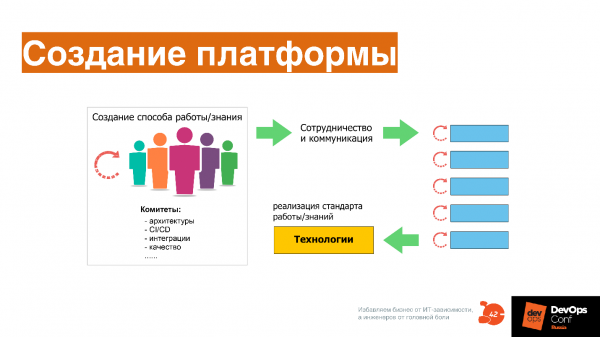
Par kultūru viss ir ļoti vienkārši — tas ir sadarbība un komunikācija, t.i., vēlme strādāt kopējā lauciņā viens ar otru, vēlme kopīgi lietot vienu rīku. Te nav nekādas ezotēriskas zinātnes — viss ir ļoti vienkārši, banāli. Piemēram, mēs visi dzīvojam kāpņu telpā un uzturam tās tīrību — tāds kultūras līmenis.
Bet kā jums?
Atkal jautājumi, kurus varat sev uzdot.
Vai infrastruktūras platforma ir izdalīta? Kurš atbild par tās attīstību? Vai jūs saprotat savas infrastruktūras platformas konkurences priekšrocības?
Šos jautājumus ir jāuzdod pastāvīgi. Ja kaut ko var pārcelt uz ārējiem pakalpojumiem – jā, tas ir jāizdara; ja ārējais pakalpojums sāk bloķēt jūsu darbību, tad jāveido sistēma sevī.
Tātad, DevOps…
… tas ir sarežģīta sistēma, kurā jābūt:
- Digitālais produkts.
- Biznesa moduļi, kas attīsta šo digitālo produktu.
- Produktu komandas, kas raksta kodu.
- Continuous Delivery prakses.
- Platformas kā pakalpojums.
- Infrastruktūra kā pakalpojums.
- Infrastruktūra kā kods.
- Atsevišķas uzticamības uzturēšanas prakses, kas ir iebūvētas DevOps.
- Atsauksmes prakse, kas visu to apraksta.
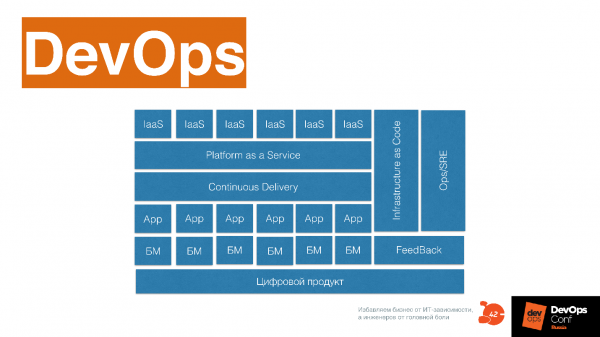
Šo shēmu var izmantot, akcentējot to, kas jums jau ir uzņēmumā kādā formā: tas ir attīstījies vai vēl jāattīsta.
Jau pēc dažām nedēļām notiks . RIT++ sastāvā. Nāciet uz konferenci, kur jūs gaida daudz lielisku ziņojumu par nepārtrauktu piegādi, infrastruktūru kā kodu un DevOps pārveidi. , pēdējais cenas termiņš ir 20. maijs
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish