

SQL, kas var būt vienkāršāk? Ikviens no mums var uzrakstīt vienkāršu vaicājumu — ierakstām select, uzskaitām nepieciešamās kolonnas, tad no, tabulas nosaukumu, nedaudz nosacījumu sadaļā where un viss — noderīgie dati ir mūsu rīcībā, gandrīz (līdzīgi) neatkarīgi no tā, kāda datubāze šobrīd tiek izmantota (un varbūt tas nav ). Rezultātā darbu praktiski ar jebkuru datu avotu (attiecīgā un ne tikai) var apsvērt no parasta koda skatpunkta (ar visām sekām — versiju kontrole, koda pārskats, statiska analīze, automātiskie testi un viss pārējais). Un tas attiecas ne tikai uz datiem, shēmām un migrācijām, bet vispār uz visu noliktavas dzīves ciklu. Šajā rakstā runāsim par ikdienas uzdevumiem un problēmām, strādājot ar dažādām datubāzēm no 'datubāze kā kods' perspektīvas.
Un sāksim tieši ar . Pirmie konflikti starp 'SQL vs ORM' tika novēroti jau .
Objektu-relāciju kartēšana
ORM atbalstītāji tradicionāli novērtē izstrādes ātrumu un vienkāršību, neatkarību no datubāzes, un koda tīrību. Daudziem no mums datu apstrādes kods (un bieži arī pati datubāze)
parasti izskatās aptuveni šādi…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Modelis ir piepildīts ar gudrām anotācijām, un kaut kur aiz ainas varonīgais ORM ģenerē un izpilda tonnas kāda SQL koda. Starp citu, izstrādātāji visiem spēkiem cenšas atdalīties no savas datubāzes ar kilometriem abstrakciju, kas liecina par zināmu .
Otrā pusē atbalstītājiem tīrā 'roku darbs' SQL izceļ iespēju izspiest visus sulas no savas datubāzes bez papildu slāņiem un abstrakcijām. Rezultātā rodas 'data-centric' projekti, kur datubāzēm strādā speciāli apmācīti cilvēki (tie ir 'bāzisti', tie paši 'bāzoviki', tie paši 'bāzdenši' utt.), un izstrādātājiem tikai jātiekas ar gatavām skatījumiem un glabātajām procedūrām, neiedziļinoties detaļās.
Bet ko, ja ņem to labāko no abām pasaulēm? Kā tas ir izdarīts lieliskajā rīkā ar dzīvotspējīgu nosaukumu . Sniedzu dažus teikumus no vispārējās koncepcijas manā brīvā tulkojumā, bet plašāk ar to var iepazīties .
Clojure ir lieliska valoda, lai veidotu DSL, taču SQL ir jau pats par sevi lielisks DSL, un mums nevajag vēl vienu. S-expression ir izcilas, bet šeit tās nekādā ziņā nenodrošina jaunus risinājumus. Rezultātā saņemam tikai vaļīgas iekavas. Nepiekrītat? Tad gaidiet brīdi, kad abstrakcija virs datubāzes sāks plūst, un jūs uzsāksiet cīņu ar funkcijām. (raw-sql)
Un ko darīt? Atstājiet SQL tādā formā, kādā tas ir — viens fails vienam pieprasījumam:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… un pēc tam izlasiet šo failu, pārvēršot to par parastu Clojure funkciju:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Ir izveidota funkcija ar nosaukumu `users-by-country`.
;;; Izmantosim to:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Pierakstot principu "SQL atsevišķi, Clojure atsevišķi", jūs iegūsiet:
- Nav sintaktisku pārsteigumu. Jūsu datubāze (tāpat kā jebkura cita) nav 100% saderīga ar SQL standartu — bet Yesql tas nav svarīgi. Jūs nekad netērēsiet laiku, meklējot funkcijas ar SQL līdzīgu sintaksi. Jums nekad nebūs jāatgriežas pie funkcijas (raw-sql "some (‘funky’ :: SYNTAX)").
- Labākā redaktora atbalsts. Jūsu redaktors jau nodrošina izcilu SQL atbalstu. Saglabājot SQL kā SQL, jūs to varat vienkārši izmantot.
- Komandas saderība. Jūsu DBA var lasīt un rakstīt SQL, ko jūs izmantojat savā Clojure projektā.
- Vienkāršāka veiktspējas konfigurācija. Vai nepieciešams izveidot plānu problemātiskam pieprasījumam? Nav problēmu, ja jūsu pieprasījums ir parasts SQL.
- Pārstrādes pieprasījumi. Pārvietojiet šos pašus SQL failus uz citiem projektiem, jo tas ir tikai vecais labs SQL — vienkārši dalieties ar to.
Manuprāt, ideja ir ļoti laba un vienlaikus ļoti vienkārša, pateicoties kurai projekts ir ieguvis daudzus dažādās valodās. Un mēs turpināsim mēģināt pielietot līdzīgu filozofiju, atdalot SQL kodu no visa pārējā tālu aiz ORM.
IDE & DB-pārvaldnieki
Sāksim ar vienkāršu ikdienas uzdevumu. Bieži vien mums jāmeklē objekti datu bāzē, piemēram, atrast tabulu shēmā un izpētīt tās struktūru (kādas kolonnas, atslēgas, indeksi, ierobežojumi utt.). Un no jebkuras grafiskās IDE vai pat vismazākā DB-menedžera, pirmkārt, mēs gaidām tieši šīs spējas. Lai būtu ātri un nebūtu jāpagaida pusstunda, kamēr parādās logs ar nepieciešamo informāciju (īpaši, ja savienojums ar attālo datu bāzi ir lēns), un tajā pašā laikā, lai iegūtā informācija būtu svaiga un aktuāla, nevis kešota veca informācija. Proti, jo sarežģītāka un lielāka ir datu bāze un jo vairāk to ir, jo grūtāk to izdarīt.
Bet parasti es novedu peli malā un vienkārši rakstu kodu. Pieņemsim, ka ir nepieciešams uzzināt, kādas tabulas (un ar kādām īpašībām) ir shēmā "HR". Lielākajā daļā DBMS nepieciešamo rezultātu var iegūt ar šādu vienkāršu vaicājumu no information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
No datu bāzes uz datu bāzi tādu tabulu-sarakstu saturs variē atkarībā no katra DBMS spējām. Un, piemēram, MySQL no šī paša saraksta var iegūt šai DBMS specifiskus tabulas parametrus:
select table_name
     , storage_engine -- Izmantotais "dzinējs" ("MyISAM", "InnoDB" utt.)
     , row_format     -- Rindas formāts ("Fixed", "Dynamic" utt.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle neizmanto information_schema, bet tam ir , un lielas problēmas nerodas:
select table_name
     , pct_free       -- Minimālais brīvas vietas procents datu blokā
     , pct_used       -- Minimālais izmantotās vietas procents datu blokā
     , last_analyzed  -- Pēdējā statistikas apkopošanas datums
     , ...
  from all_tables
 where owner = 'HR'
Neizņēmums ir arī ClickHouse:
select name
     , engine -- Izmantotais "dzinējs" ("MergeTree", "Dictionary" utt.)
     , ...
  from system.tables
 where database = 'HR'
Kaut ko līdzīgu var izdarīt arī Cassandra (kur ir columnfamilies vietā tabulām un keyspace’iem vietā shēmām):
select columnfamily_name
     , compaction_strategy_class  -- Atkritumu kompakcijas stratēģija
     , gc_grace_seconds           -- Atkritumu dzīves laiks
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Lielākajai daļai citu DB arī var izdomāt līdzīgus vaicājumus (pat Mongo ir , kas satur informāciju par visām kolekcijām sistēmā).
Protams, ar šādu metodi var iegūt informāciju ne tikai par tabulām, bet vispār par jebkuru objektu. Periodiski labvēļu cilvēki dalās ar šādu kodu dažādām DB, piemēram, sērijā rakstu "Funkcijas datu bāzu dokumentēšanai PostgreSQL" (, , ). Protams, turēt visu šo milzīgo pieprasījumu apjomu galvā un nepārtraukti tos rakstīt — tas ir "tāds sev" prieks, tāpēc manā iecienītajā IDE/redaktorā ir iepriekš sagatavots komplekts fragmentiem bieži izmantotiem pieprasījumiem, un ir jāievada tikai objektu nosaukumi veidnē.
Galu galā šāds navigācijas un objektu meklēšanas veids ir daudz elastīgāks, ietaupa laiku, ļauj iegūt tieši to informāciju un tajā formā, kādā tā pašlaik ir nepieciešama (kā, piemēram, aprakstīts ierakstā ).
Darbības ar objektiem
Pēc tam, kad esam atraduši un izpētījuši vajadzīgos objektus, ir laiks ar tiem paveikt kaut ko noderīgu. Protams, arī neatraujot pirkstus no tastatūras.
Nav noslēpums, ka vienkārša tabulas dzēšana izskatīsies vienādi gandrīz visās DB:
drop table hr.personsBet ar tabulas izveidi jau ir interesantāk. Praktiski jebkura DBMS (tostarp arī daudzas NoSQL) šādā vai citādā veidā spēj "create table", un tās pamatdaļa pat maz atšķirsies (nosaukums, kolonnu saraksts, datu tipi), taču pārējās detaļas var būt krasi atšķirīgas un atkarīgas no konkrētās DBMS iekšējās struktūras un iespējām. Mans mīļākais piemērs — Oracle dokumentācijā tikai viena "tīra" BNF sintakse "create table" . Citas DBMS ir ar skrommākām iespējām, bet katra no tām arī piedāvā vairākas interesantas un unikālas funkcijas tabulu izveidē (, , , ). Grūti iedomāties, ka kāds grafiskais "wizard" no kādas jaunākas IDE (īpaši universālas) spētu pilnībā segt visas šīs iespējas, un, ja arī spētu, tad tas būtu skats ne vājš nerviem. Tajā pašā laikā pareizi un savlaicīgi uzrakstīts operators create table atļaus bez piepūles izmantot visas no tām, nodrošinot jūsu datu glabāšanu un piekļuvi droši, optimāli un maksimāli ērti.
Daudzās DBMS ir specifiski objekta tipi, kas trūkst citās DBMS. Mēs varam veikt operācijas ne tikai ar datu bāzes objektiem, bet arī ar pašu DBMS, piemēram, "nogalināt" procesu, atbrīvot noteiktu atmiņas daļu, ieslēgt izsekošanu, pāriet "lasīšanas režīmā" un daudz ko citu.
Tagad nedaudz zīmēsim
Viena no izplatītākajām uzdevumu veikšanas metodēm ir izveidot diagrammu ar datu bāzes objektiem un redzēt objektus un to attiecības skaistā attēlā. To spēj praktiski jebkura grafiskā IDE, dažādas „komandrindas” utilītē, specializēti grafiskie rīki un modelētāji. Tie jums kaut ko zīmēs „kā prot”, un nelielu ietekmi uz šo procesu var panākt tikai ar dažiem parametriem konfigurācijas failā vai ar atzīmēm saskarnē.
Tomēr šo problēmu var atrisināt daudz vienkāršāk, elastīgāk un eleganti, un, protams, ar koda palīdzību. Ļoti dažādu sarežģītību diagrammu izveidei mums ir vairākas specializētas iezīmēšanas valodas (DOT, GraphML utt.), un identifikatori tiek lasīti kopā ar milzīgu lietojumprogrammu skaitu (GraphViz, PlantUML, Mermaid), kas spēj interpretēt šādas instrukcijas un vizualizēt dažādos formātos. Bet informāciju par objektiem un to attiecībām mēs jau zinām, kā iegūt.
Sniedzam nelielu piemēru tam, kā tas varētu izskatīties, izmantojot PlantUML un (pa kreisi SQL vaicājums, kas ģenerēs nepieciešamo instrukciju PlantUML, bet pa labi ir rezultāts):
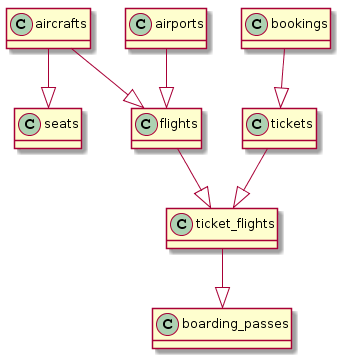
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Un, ja nedaudz piestrādā, tad, izmantojot var iegūt kaut ko, kas stipri līdzinās īstai ER diagrammai:
SQL vaicājums būs nedaudz sarežģītāks
-- Galvene
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabulas
select format('Table(%s, "%s n informācija par %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Attiecības starp tabulām
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s var būt daudz %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Apakšgalvene
select '@enduml' 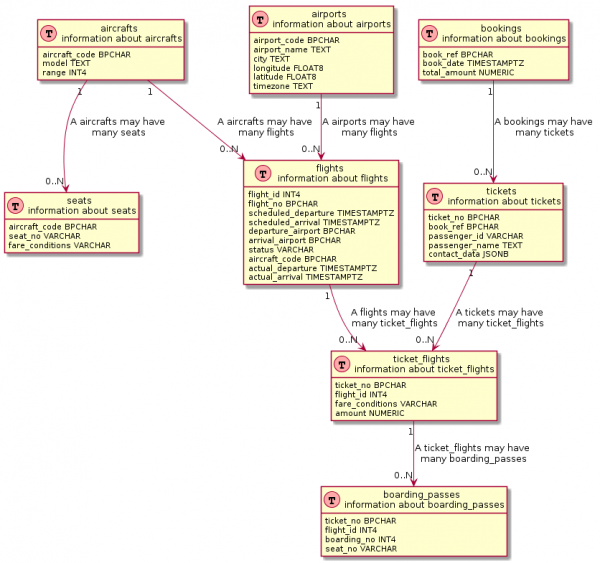
Ja uzmanīgi paskatās, tad daudzi vizualizācijas rīki zem vāka tieši tāpat izmanto līdzīgus vaicājumus. Tomēr šie vaicājumi parasti ir dziļi , nerunājot jau par to, lai tos mainītu.
Metricas un uzraudzība
Pārslēgsimies pie tradicionāli sarežģītas tēmas — datu bāzu veiktspējas uzraudzība. Atceros nelielu patiesu stāstu, ko man pastāstīja "viens mans draugs". Vienā projektā dzīvoja varens DBA, un maz kurš no izstrādātājiem bija ar viņu personīgi pazīstams vai vispār kādreiz bija viņu redzējis (lai arī, pēc baumām, viņš strādāja kaut kur blakus korpusā). Brīdī "X", kad liela mazumtirdzniecības uzņēmuma ražošanas sistēma atkal sāka "sliktāk justies", viņš klusi sūtīja ekrānšāviņus ar grafikiem no Oracle Enterprise Manager, kuros uzmanīgi izcēla kritiskās vietas ar sarkano marķieri, lai "būtu skaidrāk" (tas, maigi sakot, maz palīdzēja). Un tad pēc šī "fotoattēla" nācās ārstēt. Tajā pašā laikā piekļuve dārgajam (kā šī vārda patiesajā nozīmē) Enterprise Manager nebija nevienam, jo sistēma bija sarežģīta un dārga, pēkšņi "izstrādātāji kaut ko atrod un visu saplēš". Tāpēc izstrādātāji "empiriskā" ceļā atrada vietu un iemeslu aizkavēšanās un izlaida labojumus. Ja draudoša vēstule no DBA tuvākajā laikā nenāca atkārtoti, tad visi ar atvieglojumu nopūtās un atgriezās pie saviem aktuālajiem uzdevumiem (līdz jaunai vēstulei).
Taču uzraudzības process var būt daudz jautrāks un draudzīgāks, un, galvenais, pieejamāks un caurredzams visiem. Vismaz tās pamatā, kā papildinājums galvenajiem uzraudzības sistēmām (kuras noteikti ir noderīgas un daudzos gadījumos neaizvietojamas). Jebkura DBMS brīvi un pilnīgi bezmaksas gatava dalīties ar informāciju par savu pašreizējo stāvokli un veiktspēju. Tajā pašā "asiņainajā" Oracle DB praktiski jebkuru informāciju par veiktspēju var iegūt no sistēmas skatpunktiem, sākot no procesiem un sesijām līdz buferu keša stāvoklim (piemēram, , sadaļa "Uzraudzība"). PostgreSQL arī ir vesela rinda sistēmas skatu uzraudzībai, , īpaši tādi, kas ir neaizvietojami ikdienas dzīvē jebkuram DBA, piemēram, , , . MySQL šim nolūkam ir pat atsevišķa shēma . Bet Mongo iebūvētais apkopo veiktspējas datus sistēmas kolekcijā .
Tātad, apgūstot kādu metrikas apkopotāju (Telegraf, Metricbeat, Collectd), kas spēj izpildīt pielāgotus sql pieprasījumus, metrikas glabātuvi (InfluxDB, Elasticsearch, Timescaledb) un vizualizatoru (Grafana, Kibana), var izveidot pietiekami vieglu un elastīgu uzraudzības sistēmu, kas cieši integrēta ar citām vispārējām metrikām (saņemtām, piemēram, no lietojumprogrammu servera, no operētājsistēmas utt.). Kā, piemēram, tas ir izdarīts pgwatch2, kur tiek izmantota saikne InfluxDB + Grafana un komplekts pieprasījumu uz sistēmiskajiem skatiem, kuriem var pievienot arī pielāgotus pieprasījumus. .
Kopējā summa
Un tas ir tikai aptuvens saraksts no tā, ko var izdarīt ar mūsu datu bāzi, izmantojot parasto SQL kodu. Esmu pārliecināts, ka var atrast vēl daudz pielietojumu, rakstiet komentāros. Par to, kā (un galvenais, kādēļ) to visu automatizēt un iekļaut savā CI/CD pipeline, mēs runāsim nākamreiz.
Avots: habr.com
