

Kā backend izstrādātājs saprot, ka SQL vaicājums labi darbosies "prod"? Lielās vai strauji augošās kompanijās piekļuve "prod" nav pieejama visiem. Un pat ar piekļuvi ne visus vaicājumus var bezbailīgi pārbaudīt, turklāt datubāzes kopiju izveidošana bieži aizņem stundas. Lai risinātu šīs problēmas, mēs izveidojām mākslīgu DBA — Joe. Viņš jau ir sekmīgi ieviests vairākās kompanijās un palīdz ne vienam desmitam izstrādātāju.
Video:
Sveiki visiem! Mani sauc Anatolijs Stansler. Es strādāju uzņēmumā . Mēs piedāvājam risinājumus, kas paātrina izstrādes procesu, novēršot aiztures, kas saistītas ar Postgres darbu, izstrādātājiem, DBA un QA.
Mums ir lieliski klienti, un šodien daļa no mūsu prezentācijas būs veltīta gadījumiem, ar kuriem esam saskārušies, strādājot ar viņiem. Es pastāstīšu, kā mēs palīdzējām viņiem atrisināt diezgan nopietnas problēmas.
Kad mēs veicam izstrādi un veicam sarežģītas slodzes migrācijas, uzdodam sev jautājumu: "Vai migrācija nostrādās?". Mēs izmantojam apskatus, mēs izmantojam pieredzējušo kolēģu un DBA ekspertu zināšanas. Un viņi var teikt – vai tā nostrādās vai nē.
Bet, iespējams, būtu labāk, ja mēs varētu paši to pārbaudīt uz pilna apjoma kopijām. Un šodien mēs tieši runāsim par to, kādi ir šobrīd pieejamie pieejas veidi testēšanai un kā to var labāk darīt un ar kādiem instrumentiem. Tāpat mēs runāsim par to, kādi ir šādu pieeju plusi un mīnusi, un ko mēs varam uzlabot šajā jomā.
Kurš kādreiz tieši uz prod ir veicis indeksus vai veicis kādas izmaiņas? Salīdzinoši daudz. Un cik bieži tas ir novedis pie datu zuduma vai dīkstāves? Tāpēc jums ir pazīstama šī sāpe. Paldies Dievam, ir dublējumi.
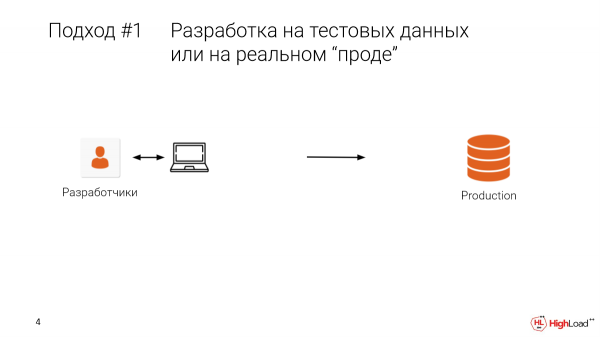
Pirmais pieejas veids ir testēšana prod. Vai tas, kad izstrādātājs sēž ar savu vietējo mašīnu, viņam ir testēšanas dati, ir kāda ierobežota izlase. Mēs izlaižam uz prod, un rodas šāda situācija.
Tas ir sāpīgi, tas ir dārgi. Varbūt tā labāk nedarīt.
Bet kā labāk rīkoties?
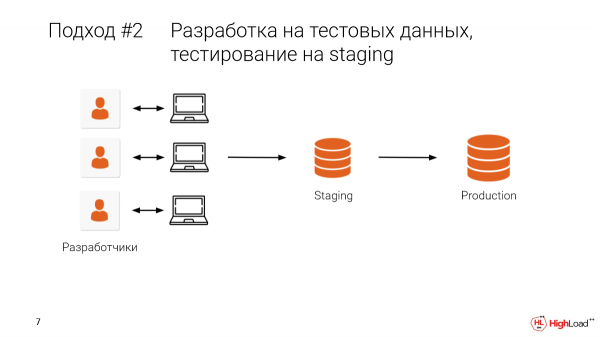
Ņemsim staging un novirzīsim uz turieni kādu daļu no prod. Vai labākajā gadījumā ņemsim patiesu prod, visus datus. Un pēc tam, kad esam izstrādājuši lokāli, papildus pārbaudīsim arī staging.
Tas ļaus mums novērst kādu daļu kļūdu, t.i., nepieļaut tās uz prod.
Kādas ir problēmas?
- Problēma ir tā, ka mēs šo staging kopā dalām ar kolēģiem. Un ļoti bieži notiek tā, ka tu veic kādu izmaiņu, un pēkšņi – nav nevienu datu, darbs vējā. Staging bija vairāku terabaitu izmērā. Un ir jāgaida, kamēr tas atkal uzsāksies. Un mēs nolemjam, ka to uzlabosim rīt. Viss, mūsu izstrāde ir apstājusies.
- Un, protams, tur strādā daudz kolēģu, daudz komandu. Un ir jāsaskaņo roku darbā. Tas ir neērti.
Un jāsaka, ka mums ir tikai viena iespēja, viens šāviens, ja mēs vēlamies veikt kādas izmaiņas datu bāzē, pieskarties datiem, mainīt struktūru. Un, ja kaut kas noiet greizi, ja migrācijā bija kļūda, tad mēs ātri vairs nevarēsim atgriezties.
Tas ir labāk nekā iepriekšējā pieeja, bet joprojām pastāv liela iespēja, ka kāda kļūda nonāks ražošanas vidē.
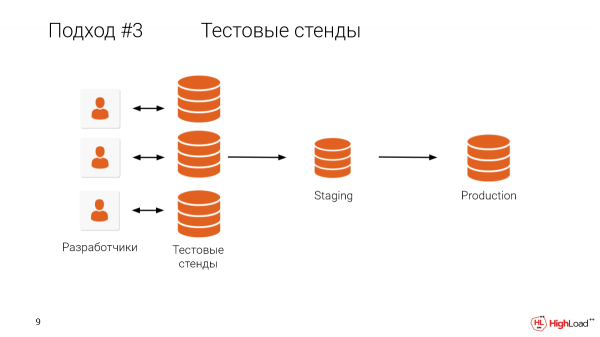
Kas mums traucē dot katram izstrādātājam testēšanas vidē, pilnīgu kopiju? Es domāju, ka ir skaidrs, kas traucē.
Kam ir datu bāze, kas pārsniedz terabaitu? Vairāk nekā pusei zāles.
Un, protams, ir skaidrs, ka uzturēt mašīnas katram izstrādātājam, kad ir tik liela ražošana, ir ļoti dārgi, turklāt tas aizņem ilgu laiku.
Mums ir klienti, kuri sapratuši, ka ir ļoti svarīgi testēt visas izmaiņas uz pilnām kopijām, bet viņiem datu bāze ir mazāka par terabaitu, un nav resursu, lai katram izstrādātājam uzturētu testēšanas vidi. Tāpēc viņiem ir jālejupielādē dublējumi lokāli uz mašīnu un jāveic testēšana šādā veidā. Tas aizņem lielu laiku.
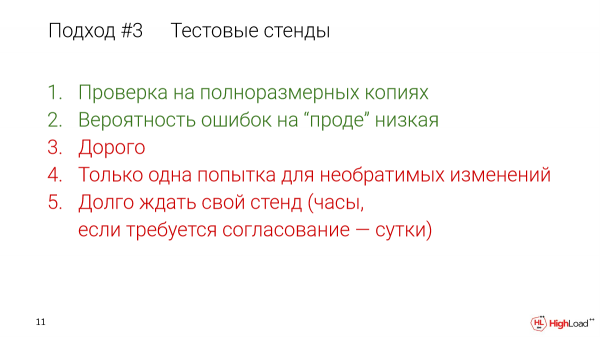
Pat ja jūs to darāt iekšējā infrastruktūrā, lejuplādēt vienu terabaitu datu stundā – tas jau ir ļoti labi. Bet viņi izmanto loģiskos dublējumus, viņi lejupielādē lokāli no mākoņa. Viņu ātrums ir apmēram 200 gigabaiti stundā. Un vēl ir jāņem laiks, lai no loģiskā dublējuma atvērts, uzliktu indeksus utt.
Bet viņi šo pieeju izmanto, jo tas ļauj uzturēt ražošanas vidi uzticamu.
Ko mēs šeit varam darīt? Apskatīsim, kā padarīt testēšanas vidē lētus un dot katram izstrādātājam savu individuālo testēšanas vidi.
Un tas ir iespējams.
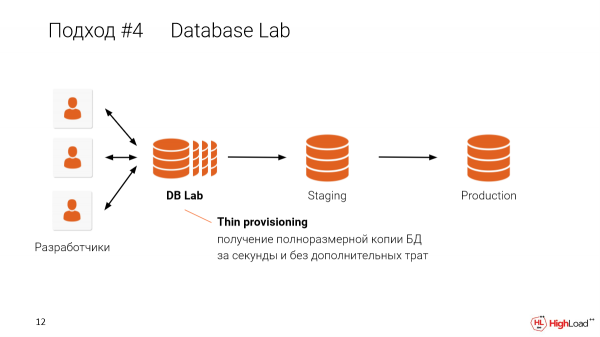
Un šajā pieejā, kad mēs veidojam plānus klonus katram izstrādātājam, mēs to varam koplietot uz vienas mašīnas. Piemēram, ja jums ir četru terabaitu datu bāze un jūs vēlaties to dot 10 izstrādātājiem, jums nav nepieciešams 10 x četru terabaitu datu bāzes. Pietiks ar vienu mašīnu, lai veidotu plānus izolētus kopijas katram izstrādātājam, izmantojot vienu mašīnu. Kā tas darbojas, es pastāstīšu nedaudz vēlāk.
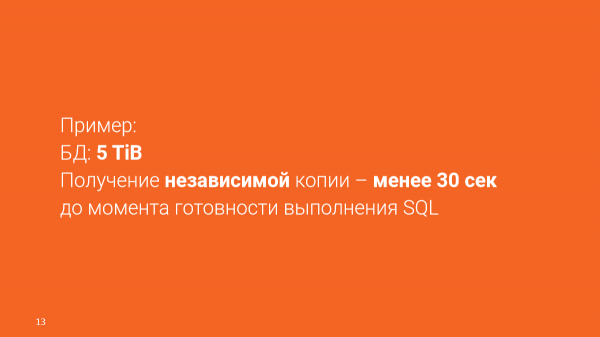
Reāls piemērs:
Datu bāze – 4,5 terabaiti.
Mēs varam iegūt neatkarīgas kopijas 30 sekunžu laikā.
Nav jāgaida uz testēšanas vidi un jāpieder pie tā, cik liela tā ir. Jūs varat to iegūt sekundēs. Tas būs pilnībā izolēts vidēs, bet tie dalīs datus starp sevi.
Tas ir lieliski. Šeit mēs runājam par maģiju un paralēlo visumu.
Mūsu gadījumā tas darbojas ar OpenZFS sistēmu.
OpenZFS ir copy-on-write failu sistēma, kas pati no kastes atbalsta snapshots un klonus. Tā ir uzticama un mērogojama. To ir ļoti viegli pārvaldīt. To var uzstādīt burtiski ar divām komandām.
Ir arī citas iespējas:
LVM,
SAS (piemēram, Pure Storage).
Database Lab, par kuru es runāju, ir modulārs. To var realizēt, izmantojot šīs iespējas. Bet pagaidām mēs koncentrējamies uz OpenZFS, jo konkrēti ar LVM bija problēmas.
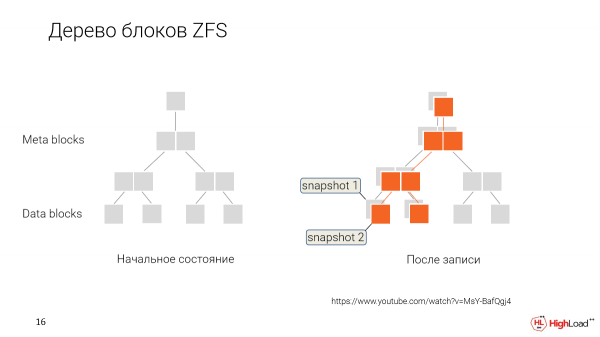
Kā tas darbojas? Tā vietā, lai katru reizi pārrakstītu datus, kad mēs tos mainām, mēs tos saglabājam, vienkārši atzīmējot, ka šie jauni dati attiecas uz jaunu laika brīdi, uz jaunu snapshot.
Un atlikušajā laikā, kad mēs vēlamies atgriezties vai vēlamies veidot jaunu klonu ar kādu vecāku versiju, mēs vienkārši sakām: „Ok, dodiet mums šos datu blokos, kuri ir šādi atzīmēti.”
Un šis lietotājs strādās ar šādu datu kopu. Viņš tos pakāpeniski mainīs, veidos savus snapshots.
Un mums būs zarošana. Katram izstrādātājam mūsu gadījumā būs iespēja iegūt savu klonu, kuru viņš rediģē, un tie dati, kas ir kopīgi, tiks dalīti starp visiem.
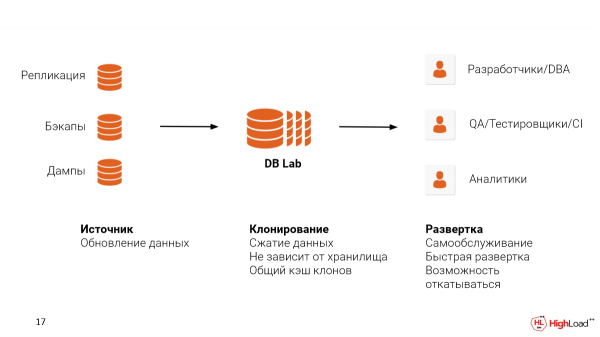
Lai uzstādītu šādu sistēmu, jārisina divas problēmas:
Pirma ir ir datu avots, no kura jūs tos ņemsiet. Varat iestatīt replikāciju no ražošanas. Varat izmantot jau izveidotos dublējumus, kuriem, cerams, jums ir iestatītas. WAL-E, WAL-G vai Barman. Un pat ja jūs izmantojat kādu mākoņu risinājumu, piemēram, RDS vai Cloud SQL, jūs varat izmantot loģiskos dublējumus. Bet mēs joprojām iesakām izmantot dublējumus, jo šādā pieejā saglabājas arī fiziskā failu struktūra, kas ļaus būt tuvāk tajām metriskajām vērtībām, ko jūs redzētu ražošanā, lai identificētu esošās problēmas.
Otrā ir vieta, kur vēlaties mitināt Database Lab. Tas var būt mākoņos, tas var būt uz vietas. Šeit svarīgi teikt, ka ZFS atbalsta datu saspiešanu. Un to tas ļoti labi dara.
Iedomājieties, ka katram šādam klonam, atkarībā no tām darbībām, kuras mēs veicam ar datu bāzi, attīstīsies kāds dev. Šim dev arī būs nepieciešama vieta. Bet pateicoties tam, ka mēs izmantojam datu bāzi ar 4,5 terabaitiem, ZFS to saspiest līdz 3,5 terabaitiem. Atkarībā no iestatījumiem to var variēt. Un mums vēl paliks vieta dev.
Šādu sistēmu var izmantot dažādiem gadījumiem.
Tas ir izstrādātājiem, DBA, lai pārbaudītu vaicājumus, optimizētu tos.
To var izmantot QA testēšanā, lai pārbaudītu konkrētu migrāciju, pirms mēs to laidīsim ražošanā. Un mēs varam izveidot īpašus vidi QA ar reāliem datiem, kur viņi var testēt jauno funkcionalitāti. Un tas aizņems sekundes, nevis stundas, varbūt pat dienas citos gadījumos, kur plānveida kopijas netiek izmantotas.
Un vēl viens atsevišķs gadījums. Ja uzņēmumā nav izveidota analītikas sistēma, mēs varam piešķirt plānu klonu produkta datu bāzei un nodot to ilgiem vaicājumiem vai īpašiem indeksiem, kurus var izmantot analītikā.
Ar šo pieeju:
Zema kļūdu varbūtība ražošanā, jo visas izmaiņas tika pārbaudītas uz pilnizmēra datiem.
Mums parādās testēšanas kultūra, jo tagad vairs nav jāgaida stundām ilgi sava stenda.
Un nav šķērsļu, nav gaidīšanas starp testēšanām. Jūs patiešām varat iet un pārbaudīt. Un tas būs labāk, jo mēs paātrinām izstrādi.
Būs mazāk refaktorizēšanas. Mazāk kļūdu nonāks ražošanā. Mēs mazāk tās refaktorizēsim vēlāk.
Mēs varam veikt neatgriezeniskas izmaiņas. Šis nav standarta pieeju sastāvdaļa.
- Tas ir izdevīgi, jo mēs dalām resursus testēšanas vidi.
Jau labi, bet ko vēl varētu paātrināt?
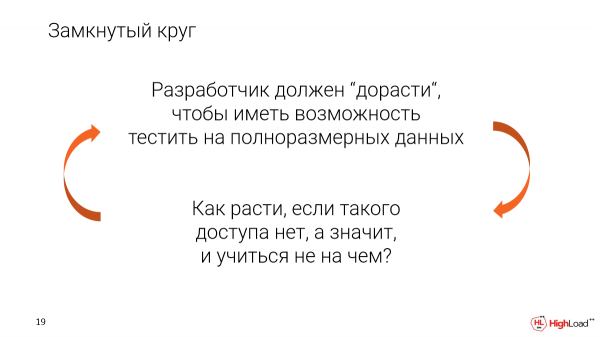
Pateicoties šādai sistēmai, mēs varam būtiski samazināt iekļūšanas slieksni šādā testēšanā.
Pašlaik pastāv apburtais loks, kurā izstrādātājam, lai iegūtu piekļuvi reāliem pilna izmēra datiem, ir jākļūst par ekspertu. Viņam jāļauj piekļūt šiem datiem.
Bet kā attīstīties, ja tāda nav. Un kas notiks, ja tev ir pieejami tikai ļoti mazi testa datu kopumi? Tad reālu pieredzi nevar iegūt.
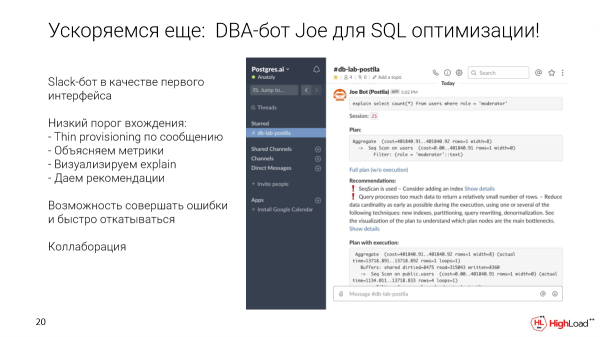
Kā izkļūt no šī loka? Kā pirmo saskarni, kas ir ērta izstrādātājiem jebkura līmeņa, mēs izvēlējāmies Slack robotu. Bet tas var būt jebkura cita saskarne.
Ko tas ļauj darīt? Var ņemt konkrētu pieprasījumu un nosūtīt to īpašā kanālā datu bāzei. Mēs automātiski pārsniegsim plāno klonu pāris sekundēs. Izpildīsim šo pieprasījumu. Savāksim metrikas un ieteikumus. Parādīsim vizualizāciju. Un pēc tam šis klons paliks, lai šo pieprasījumu varētu optimizēt, pievienot indeksus utt.
Un arī Slack mums nodrošina sadarbības iespējas no kastes. Tā kā tas ir vienkārši kanāls, tieši tur var sākt diskusiju par šo pieprasījumu thread'ā, pingot savus kolēģus, DBA, kuri ir uzņēmumā.
Bet, protams, ir arī problēmas. Tā kā tas ir reāls pasaules, un mēs izmantojam serveri, kurā vienlaicīgi mitinām daudz klonu, mums jāierobežo atmiņas un procesora jauda, kas ir pieejama kloniem.
Bet, lai šie testi būtu ticami, šī problēma ir jārisina.
Ir skaidrs, ka svarīgs moments ir vienādi dati. Bet tie mums jau ir. Un mēs vēlamies sasniegt vienāda konfigurācija. Un mēs varam piedāvāt praktiski vienādu konfigurāciju.
Būtu lieliski, ja mums būtu tāda paša aparatūra kā ražošanā, bet tā var atšķirties.
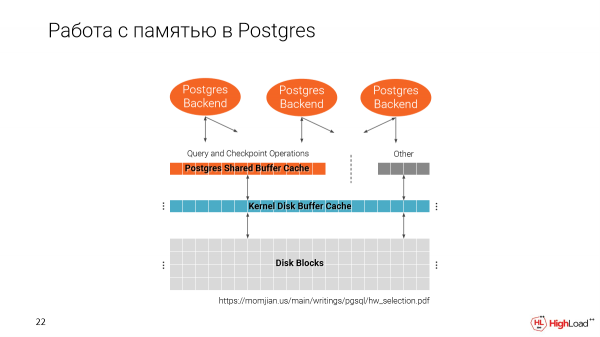
Atcerēsimies, kā Postgres strādā ar atmiņu. Mums ir divi keši. Viens no failu sistēmas un viens no paša Postgres, proti, Shared Buffer Cache.
Ir svarīgi atzīmēt, ka Shared Buffer Cache tiek piešķirts, kad tiek palaists Postgres, atkarībā no tā, kādu izmēru jūs norādīsiet konfigurācijā.
Otro kešu izmanto visas pieejamās vietas.
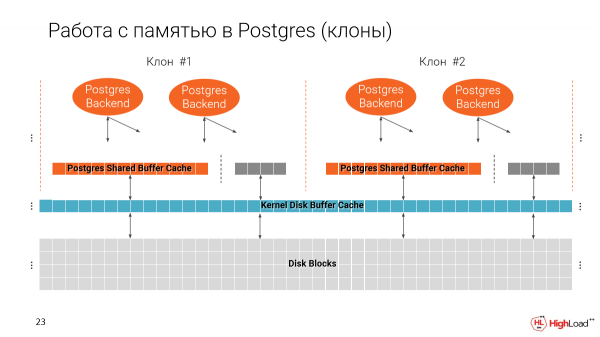
Un, kad mēs veidojam vairākus klonus vienā mašīnā, iznāk, ka pakāpeniski aizpildām atmiņu. Un, principā, Shared Buffer Cache ir 25 % no visa pieejamā atmiņas apjoma uz datora.
Līdz ar to, ja mēs nemainīsim šo parametru, mēs varēsim uz vienas mašīnas palaist tikai 4 instance, t. i., tikai 4 tādus plānus klonus. Un tas, protams, ir slikti, jo mēs vēlamies tos daudz vairāk.
Bet, no otras puses, Buffer Cache tiek izmantots vaicājumu izpildei, indeksiem, t. i., plāns ir atkarīgs no tā, cik lieli ir mūsu keši. Un, ja mēs vienkārši samazināsim šo parametru, mūsu plāni var varētu ievērojami mainīties.
Piemēram, ja mūsu prod pusē kešs ir liels, tad Postgres izvēlēsies izmantot indeksu. Ja nē, tad tiks veikta SeqScan. Un kāds būtu jēga, ja mūsu plāni nesakristu?
Taču šajā ziņā mēs nonākam pie tāda risinājuma, ka patiesībā plāns Postgres nav atkarīgs no konkrētā Shared Buffer izmēra, bet gan no effective_cache_size.
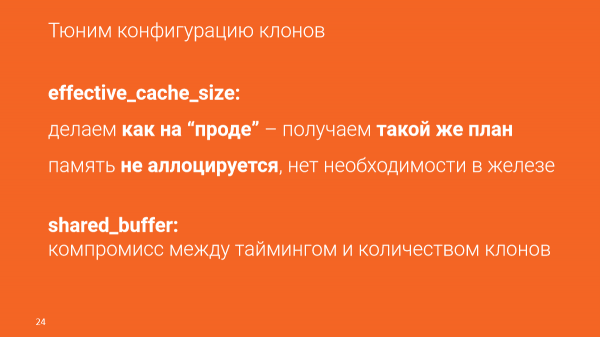
Effective_cache_size ir paredzamais keša apjoms, kas mums ir pieejams, t. i., kopējais Buffer Cache un failu sistēmas kešs. To nosaka konfigurācija. Un šī atmiņa netiek piešķirta.
Tādējādi mēs varam kaut kā apmānīt Postgres, sakot, ka mums patiesībā ir pieejami daudz dati, pat ja mums šo datu nav. Un tādējādi plāni pilnīgi sakritīs ar ražošanu.
Tomēr tas var ietekmēt laiku. Un mēs optimizējam vaicājumus pēc laika, taču ir svarīgi, ka laiks ir atkarīgs no daudziem faktoriem:
Tas ir atkarīgs no tās slodzes, kas pašlaik pastāv prod.
Tas ir atkarīgs no pašas mašīnas raksturlielumiem.
Un tas ir netiešs parametrs, taču patiesībā mēs varam optimizēt tieši pēc datu apjoma, ko šis vaicājums izlasīs, lai iegūtu rezultātu.
Un, ja vēlamies, lai laika izpilde būtu tuva tai, ko redzam ražošanā, mums jāņem pēc iespējas līdzīgāka aparatūra un, iespējams, pat vairāk, lai visi kloni ietilptu. Bet tas ir kompromiss, t.i., jūs saņemsiet tādus pašus plānus, redzēsiet, cik daudz datu konkrētais vaicājums lasīs, un varēsiet izdarīt secinājumus — vai šis vaicājums ir labs (vai migrācija) vai slikts, to vēl jāoptimizē.
Apskatīsim, kā tieši ar Joe notiek optimizācija.
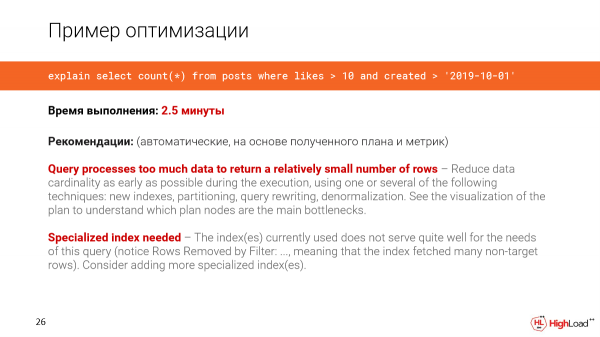
Ņemsim vaicājumu no reālās sistēmas. Šajā gadījumā datu bāze sastāv no 1 terabaita. Un mēs vēlamies saskaitīt jaunākos ierakstus, kam bija vairāk nekā 10 patīk.
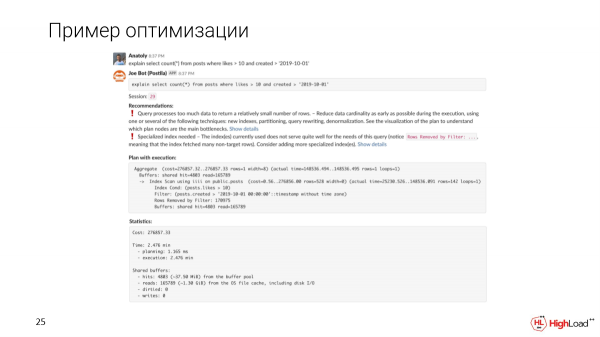
Mēs rakstām ziņojumu kanālā, klons ir izveidots. Un mēs redzēsim, ka šāds vaicājums izpildīsies 2,5 minūtēs. Tas ir pirmais, ko mēs pamanīsim.
B Joe rādīs automātiskās rekomendācijas, kas balstītas uz plānu un metrikām.
Mēs redzēsim, ka vaicājums apstrādā pārāk daudz datu, lai iegūtu relatīvi nelielu rindu skaitu. Un ir nepieciešams kāds specializēts indekss, jo mēs pamanījām, ka vaicājumā ir pārāk daudz filtrētu rindu.
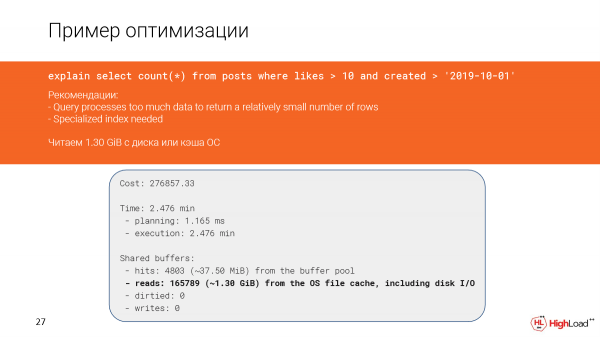
Apskatīsim sīkāk, kas notika. Patiešām, mēs redzam, ka esam izlasījuši gandrīz pusotru gigabaitu datu no failu kešatmiņas vai pat no diska. Un tas nav labi, jo mēs saņēmām tikai 142 rindas.
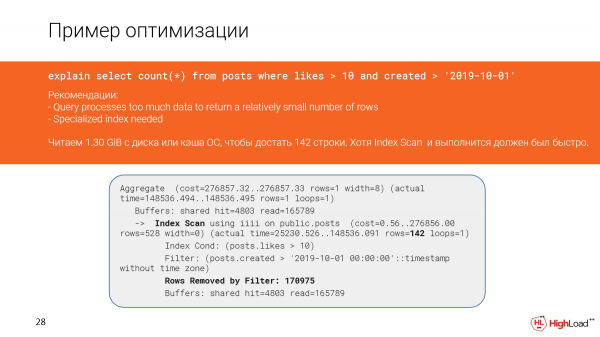
Un, šķiet, mums šeit ir indeksu skenēšana, un tam vajadzēja ātri izpildīties, bet, ņemot vērā, ka mēs filtrējām pārāk daudz rindu (mums tās bija jāsaskaita), vaicājums izpildījās lēni.
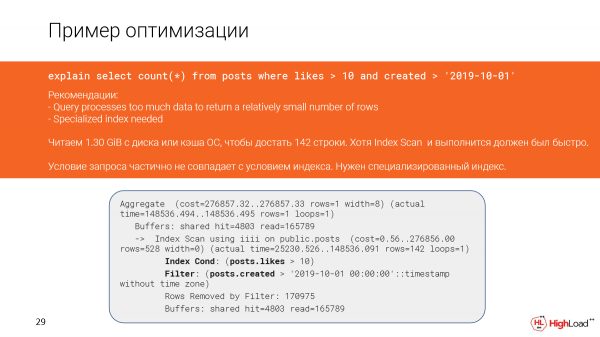
Un tas notika plāna dēļ, jo daļēji nesakrīt nosacījumi vaicājumā un nosacījumi indeksā.
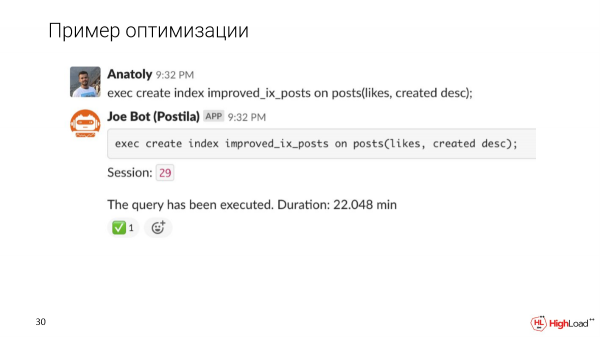
Mēģināsim izveidot precīzāku indeksu un paskatīsimies, kā izpilde mainīsies pēc tam.
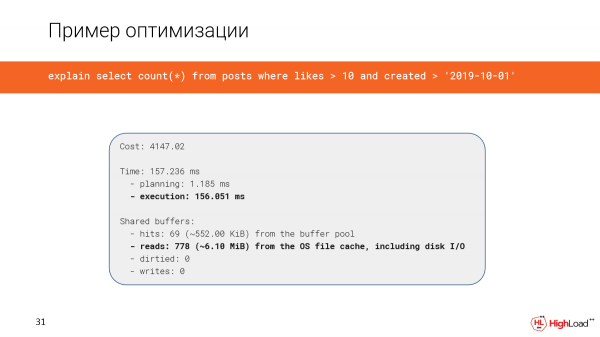
Indeksa izveide prasīja pietiekami ilgu laiku, taču tagad mēs pārbaudām vaicājumu un redzam, ka laiks vietā no 2,5 minūtēm ir kļuvis tikai 156 milisekundes, kas ir diezgan labi. Un mēs lasām tikai 6 megabaitus datu.
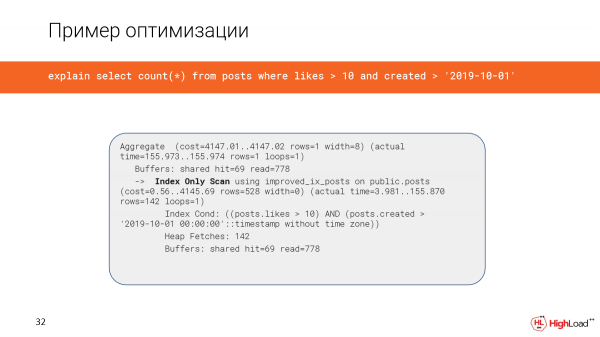
Un tagad tiek izmantota tikai indeksa skenēšana.
Vēl viena svarīga lieta ir tā, ka mēs vēlamies plānu attēlot kādā saprotamākā veidā. Mēs esam ieviesuši vizualizāciju, izmantojot Flame Graphs.
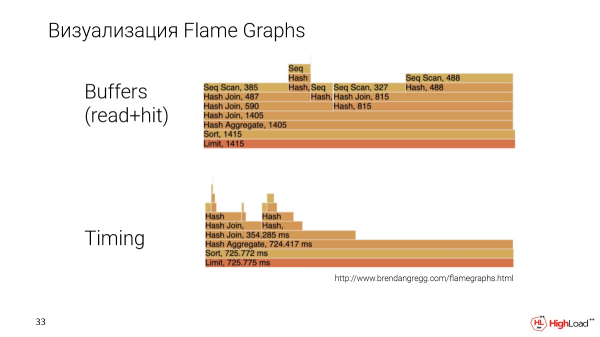
Tas ir cits vaicājums, bagātāks. Un Flame Graphs mēs veidojam pēc diviem parametriem: tas ir datu apjoms, ko konkrētā plāna noda izlasīja, un laika izpilde, t.i., mezgla izpildes laiks.
Šeit mēs varam salīdzināt konkrēti mezglus savā starpā. Būs saprotams, kurš no tiem aizņem vairāk vai mazāk, ko parasti ir grūti izdarīt citos vizualizācijas veidos.
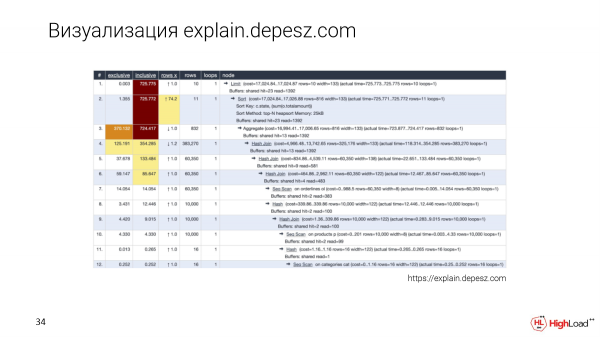
Protams, visi zina explain.depesz.com. Šīs vizualizācijas laba iezīme ir tā, ka mēs saglabājam teksta plānu un arī izvirzām dažus galvenos parametrus tabulā, lai varētu tos sakārtot.
Un izstrādātāji, kuri vēl nav padziļināti iepazinušies ar šo tēmu, arī izmanto explain.depesz.com, jo viņiem ir vieglāk saprast, kuras metriskās vērtības ir svarīgas, bet kuras ne.
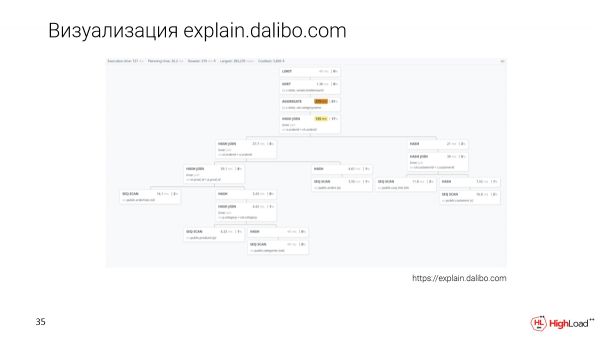
Ir jauns pieejas veids vizualizācijai – explain.dalibo.com. Viņi veido kokveida vizualizāciju, bet šeit ir ļoti grūti salīdzināt mezglus savā starpā. Šeit labi var saprast struktūru, tomēr, ja būs liels pieprasījums, tad būs jāpārvietojas uz priekšu un atpakaļ, bet arī tas ir variants.
Kopdarbs
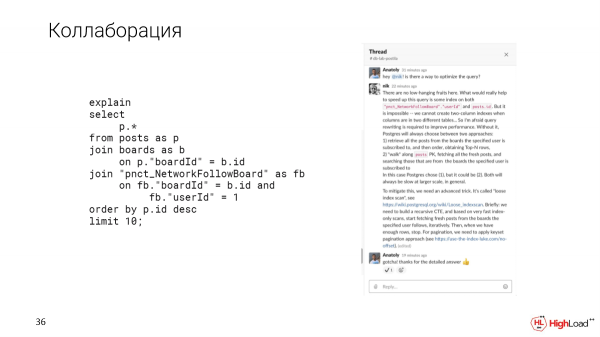
Un, kā es jau minēju, Slack mums sniedz iespēju kopdarbam. Piemēram, ja mēs sastopam sarežģītu pieprasījumu, kuru nav skaidri iespējams optimizēt, mēs varam šajā jautājumā precizēt ar kolēģiem Slack diskusijā.
Mums šķiet svarīgi testēt uz pilna izmēra datiem. Tāpēc mēs izveidojām rīku Update Database Lab, kas ir pieejams atvērtā koda. Jūs varat izmantot arī botu Joe. Jūs varat to ņemt tieši tagad un ieviest savā vidē. Visi ceļveži tur ir pieejami.
Svarīgi ir arī atzīmēt, ka pats risinājums nav nekas revolūcisks, jo ir Delphix, bet tas ir uzņēmuma risinājums. Tas ir pilnībā slēgts un ļoti dārgs. Mūsu specializācija ir Postgres. Tie ir visi atvērtā koda produkti. Pieņemiet mūs!
Ar to es beidzu. Paldies!
Jautājumi
Sveiki! Paldies par ziņojumu! Ļoti interesanti, īpaši man, jo man bija līdzīga uzdevuma risināšana kādu laiku atpakaļ. Tāpēc man ir vairāki jautājumi. Ceru, ka vismaz daļu no tiem varēšu uzdot.
Interesanti, kā jūs aprēķināt vietu šai videi? Tehnoloģija paredz, ka noteiktos apstākļos jūsu kloni var palielināties līdz maksimālajam izmēram. Vienkārši sakot, ja jums ir desmit terabaitu datu bāze un 10 kloni, tad ir viegli simulēt tādu situāciju, kad katrs klons satur 10 unikālus datus. Kā jūs aprēķināt šo vietu, t.i., to dalījumu, par kuru jūs runājāt, kurā dzīvos šie kloni?
Labs jautājums. Šeit ir svarīgi sekot līdzi konkrētiem kloniem. Un, ja kādā klonā notiek pārāk liels mainījums un tas sāk augt, mēs varam vispirms brīdināt lietotāju, vai arī uzreiz apturēt šo klonu, lai neradītu failu situāciju.
Jā, man ir papildu jautājums. Proti, kā jūs nodrošināt šo moduļu dzīves ciklu? Mums tas ir problēma un vesela atsevišķa stāsts. Kā tas notiek?
Katram klonam ir noteikts ttl. Pamatā mums ir fiksēts ttl.
Cik, ja nav noslēpums?
1 stunda, proti, bezdarbība – 1 stunda. Ja tas netiek izmantots, mēs to izdzēšam. Bet šeit nav nekāda pārsteiguma, jo mēs varam uzsākt klonu sekundēs. Un, ja tas atkal būs nepieciešams, tad – lūdzu.
Man ir interese par tehnoloģiju izvēles jautājumiem, jo mēs, piemēram, paralēli izmantojam vairākus veidus dažādu iemeslu dēļ. Kāpēc tieši ZFS? Kāpēc jūs neizmantojāt LVM? Jūs pieminējāt, ka ar LVM bija problēmas. Kādas bija problēmas? Manuprāt, visoptimālākais variants ir ar SĶD, ņemot vērā veiktspēju.
Kāda ir galvenā problēma ar ZFS? Tas, ka jums jāpaliek uz viena hosta, t. i., visi instances dzīvos vienā operētājsistēmā. Bet SĶD gadījumā, jūs varat pievienot dažādu aparatūru. Un šaurā vieta ir tikai tās vienības, kas ir uz SĶD. Un interesants jautājums ir tieši par tehnoloģiju izvēli. Kāpēc ne LVM?
Par LVM varēsim runāt meetup laikā. Par SĶD – tas ir vienkārši dārgi. Mēs varam ieviest ZFS kur vien vēlamies. Jūs varat to izveidot savā mašīnā. Jūs varat vienkārši lejupielādēt repo un uzstādīt to. ZFS var uzstādīt praktiski visur, ja runājam par Linux. T. i., mēs iegūstam ļoti elastīgu risinājumu. Un pats ZFS dabiski piedāvā ļoti daudz. Varat iekrāt tur neierobežotu datu apjomu, pievienot lielu skaitu diskus, ir snapshots. Un, kā es jau minēju, to ir vienkārši administrēt. T. i., tas šķiet ļoti patīkams lietošanā. Tas ir pārbaudīts, tam ir daudz gadi. Tam ir ļoti liela kopiena, kas aug. ZFS ir ļoti uzticams risinājums.
Nikolajs Samohvalovs: Vai varu vēl nedaudz komentēt? Mani sauc Nikolajs, mēs kopā ar Anatoliju strādājam. Es piekrītu, ka SĶD ir lielisks. Un daudziem mūsu klientiem ir Pure Storage utt.
Anatolijs pareizi norādīja, ka mēs mērķējam uz modularitāti. Un nākotnē var realizēt vienu interfeisu – izveidot momentkopiju, izveidot klonu, iznīcināt klonu. Tas viss ir viegli. Un datu glabāšanas sistēma ir lieliska, ja tā ir.
Bet ZFS ir pieejams visiem. Pietiek ar Delphix, viņiem ir 300 klientu. No tiem Fortune 100 ir 50 klienti, t.i., viņi ir vērsti uz NASA un tā tālāk. Ir pienācis laiks, kad šī tehnoloģija būs pieejama ikvienam. Tāpēc mums ir open source pamats. Mums ir daļa interfeisa, kas nav open source. Tā ir platforma, kuru mēs parādīsim. Bet mēs vēlamies, lai tas būtu pieejams ikvienam. Mēs vēlamies revolucionizēt, lai visi testētāji vairs neuzminētu uz portatīvajiem datoriem. Mums jāraksta SELECT un uzreiz jānokļūst pie tā, ka tas ir lēns. Pietiek gaidīt, kamēr DBA par to pastāstīs. Tā ir galvenā mērķis. Un es domāju, ka mēs pie tā visi nonāksim. Un šo lietu mēs darām, lai tā būtu visiem. Tāpēc ZFS, jo tas būs pieejams visur. Paldies kopienai par problēmu risināšanu un par open source licenci utt.
Sveiki! Paldies par ziņojumu! Mani sauc Maksims. Mēs risinājām tādas pašas problēmas. Mēs tās risinājām. Kā jūs sadalāt resursus starp šiem kloniem? Katrs klons katru brīdi var darboties savādāk: viens testē vienu, otrs citu, kādam tiek būvēts indekss, kādam ir smaga darba izpilde. Un, ja CPU var vēl sadalīt, tad kā ar IO, kā jūs dalāt? Tas ir pirmais jautājums.
Un otrais jautājums par stendu atšķirībām. Pieņemsim, man šeit ir ZFS un viss ir lieliski, bet klientam produkcijā nav ZFS, bet, piemēram, ext4. Kā šajā gadījumā?
Jautājumi ir ļoti labi. Es nedaudz pieminēju šo problēmu, ka mēs dalām resursus. Un risinājums ir šāds. Iedomājieties, ka jūs testējat staging vidē. Jums arī var būt tāda paša situācija, ka kāds rada vienu slodzi, kāds citu. Un beigās jūs redzat neskaidras metriskās vērtības. Pat tāda pati problēma var būt ar produkciju. Kad jūs vēlaties pārbaudīt kādu pieprasījumu un redzat, ka ar to ir kāda problēma – tas lēni izpildās, tad patiesībā problēma nav bijusi pieprasījumā, bet tajā, ka ir kāda paralēla slodze.
Tāpēc šeit svarīgi ir koncentrēties uz to, kāds būs plāns, pa kādiem soļiem mēs virzīsimies, un cik datu mēs tam pieņemsim. Tas, ka mūsu diski, piemēram, būs noslogoti ar kaut ko, tieši ietekmēs laiku. Bet mēs varam pēc datu apjoma novērtēt, cik smags ir šis pieprasījums. Nav tik būtiski, ka vienlaikus būs arī kāds izpildījums.
Man ir divi jautājumi. Tas ir ļoti foršs risinājums. Vai ir bijuši gadījumi, kad dati ražošanā ir kritiski svarīgi, piemēram, kredītkartes numuri? Vai jau ir kaut kas gatavs, vai arī tā ir atsevišķa uzdevuma lieta? Un otrais jautājums – vai ir kaut kas tāds arī MySQL?
Par datiem. Mēs veiksim obfuskāciju, kamēr to nedarām. Bet, ja jūs izvēršat tieši Joe, ja nedodat piekļuvi izstrādātājiem, tad piekļuves pie datiem nav. Kāpēc? Tāpēc, ka Joe nerāda datus. Viņš rāda tikai metrikas, plānus un viss. Tas tika speciāli izstrādāts, jo tas ir viens no mūsu klienta prasījumiem. Viņi vēlējās iespēju optimizēt, bet vienlaikus nedot piekļuvi visiem.
Par MySQL. Šo sistēmu var izmantot jebkam, kas glabā stāvokli diskā. Un, ņemot vērā, ka mēs strādājam ar Postgres, mēs pašreiz vispirms pilnībā automatizējam visus Postgres procesus. Mēs vēlamies automatizēt datu iegūšanu no dublējuma. Mēs pareizi konfigurējam Postgres. Mēs zinām, kā panākt, lai plāni sakristu utt.
Bet, ņemot vērā, ka sistēma ir paplašināma, to varēs izmantot arī MySQL. Ir tādi piemēri. Līdzīga sistēma ir Yandex, bet viņi to nepublicē nevienā vietā. Viņi to izmanto iekšēji Yandex.Metrikā. Un tieši tur ir stāsts par MySQL. Bet tehnoloģijas ir tās pašas, ZFS.
Paldies par prezentāciju! Man arī ir pāris jautājumu. Jūs pieminējāt, ka klonēšanu var izmantot analītikai, piemēram, lai veidotu tur papildu indeksus. Vai varat nedaudz sīkāk pastāstīt, kā tas darbojas?
Un otro jautājumu uzdošu par stendu un plānu konsekvenci. Plāns atkarīgs arī no statistikas, ko savāc Postgres. Kā jūs risināt šo problēmu?
Nav ir konkrētas analītikas gadījumu, jo mēs to vēl neesam izmantojuši, taču šāda iespēja pastāv. Ja runājam par indeksiem, tad iedomājieties, ka tiek izpildīts vaicājums tabulai ar simtiem miljoniem ierakstu un kolonnai, kas parasti nav indeksēta produkcijā. Un mums tur ir jāsaskaita dati. Ja šo vaicājumu izpildām produkcijā, pastāv iespēja, ka tiks radīta dīkstāve, jo vaicājums tur var darboties minūti.
Labi, izveidosim plānu klonu, kuru nav bail uz dažām minūtēm apstāt. Un, lai ērtāk būtu saskaitīt analītiku, pievienosim indeksus tām kolonnām, kurās mums interesē dati.
Indeks būs jāizveido katru reizi?
Var izdarīt tā, ka mēs pieskaramies datiem, izveidojam snapshots un pēc šī snapshots atjaunojamies un izpildām jaunus vaicājumus. T.i., var izdarīt tā, ka varam uzsākt jaunus klonus ar jau izveidotiem indeksiem.
Kas attiecas uz jautājumu par statistiku, tad, ja mēs atjaunojamies no dublējuma, ja mēs veicam replikāciju, tad mūsu statistika būs tieši tāda pati. Jo mums būs pilnīgi visa fiziskā datu struktūra, t.i., mēs pārvadāsim datus tā, kā tie ir, ar visām statistikas metriku.
Šeit ir cita problēma. Ja jums tiek izmantots mākoņu risinājums, tad tur ir pieejami tikai loģiski dublējumi, jo Google, Amazon neļauj ņemt fizisku kopiju. Tur būs tāda problēma.
Paldies par ziņojumu. Šeit izskanēja divi labi jautājumi par MySQL un par resursu sadalīšanu. Bet, būtībā, viss samazinās līdz tam, ka tas ir temats nevis konkrētām DBMS, bet kopumā failu sistēmai. Un, attiecīgi, resursu sadalīšana arī jāriskē no turienes, nevis beigu, ka tas ir Postgres, bet failu sistēmā, serveri, instancē.
Mans jautājums ir par citu tēmu. Tas ir tuvāks datu bāzes daudzslāņainībai, kur ir vairāki slāņi. Mēs, piemēram, esam konfigurējuši desmit terabaitīga attēla atjaunināšanu, mums notiek replikācija. Un mēs konkrēti izmantojam šo risinājumu datu bāzēm. Notiek replikācija, norisinās datu atjaunināšana. Šajā laikā strādā 100 darbinieku, kuri pastāvīgi izpilda dažādus šos snapshots. Ko darīt? Kā nodrošināt, ka nerodas konflikti, ka viņi izpildīja vienu, bet pēc tam failu sistēma tika aizstāta un visi šie snapshots bija nepareizi?
Viņi nebrauks, jo tā darbojas ZFS. Mēs varam atsevišķi saglabāt izmaiņas failu sistēmā, kas nonāk caur replikāciju. Un turēt klonus vecākajās datu versijās, ko izmanto izstrādātāji. Un tas pie mums darbojas, ar to viss ir kārtībā.
Sanāk, ka atjaunināšana notiks kā papildu slānis, un visi jauni attēli tiks veidoti, pamatojoties uz šo slāni, vai ne?
No iepriekšējiem slāņiem, kas bija no iepriekšējām replikācijām.
Iepriekšējie slāņi atslēgsies, bet tie norādīs uz veco slāni, un jaunās bildes tiks ņemtas no pēdējā slāņa, kas tika iegūts atjauninājumā?
Kopumā, jā.
Tad kā sekas mums būs ļoti daudz slāņu. Un ar laiku tos vajadzēs komprimēt?
Jā, viss pareizi. Ir kāds logs. Mēs saglabājam nedēļas momentuzņēmumus. Tas atkarīgs no tā, cik daudz resursu jums ir. Ja jums ir iespēja uzkrāt daudz datu, var saglabāt momentuzņēmumus ilgu laiku. Tie paši nenodzēsīsies. Nebūs nekādas datu sagrozīšanas. Ja momentuzņēmumi ir novecojuši, kā mums šķiet, t. i., tas ir atkarīgs no uzņēmuma politikas, tad mēs varam tos vienkārši dzēst un atbrīvot vietu.
Sveiki, paldies par ziņojumu! Par Joe jautājumu. Jūs teicāt, ka pasūtītājs negribēja dot piekļuvi visiem datiem. Stingri sakot, ja cilvēkam ir rezultāts Explain Analyze, viņš var redzēt datus.
Viss tā. Piemēram, mēs varam uzrakstīt: «SELECT FROM WHERE email = tas». T. i., mēs neredzēsim pašus datus, bet dažus netiešus rādītājus mēs varam apskatīt. To vajag saprast. Bet no otras puses, tas viss ir redzams. Mums ir žurnāla audits, mums ir citu kolēģu uzraudzība, kuri arī redz, ko dara izstrādātāji. Un ja kāds mēģinās tā darīt, tad drošības dienests pie viņiem ieradīsies un risinās šo jautājumu.
Labdien! Paldies par ziņojumu! Man ir īss jautājums. Ja uzņēmumā Slack netiek izmantots, vai ir kāda piesaistīšana tam šobrīd, vai var izstrādātājiem izveidot instancēs, lai pievienotu testēšanas aplikāciju datu bāzēm?
Šobrīd ir saistība ar Slack, t. i., nav neviena cita ziņojumapmaiņas lietotne, bet ļoti gribētos izveidot atbalstu arī citiem ziņojumapmaiņas rīkiem. Ko jūs varat darīt? Jūs varat ieviest DB Lab bez Joe, izmantot REST API vai mūsu platformu, lai izveidotu klonus un pieslēgtos PSQL. Bet to var izdarīt, ja esat gatavi dot saviem izstrādātājiem piekļuvi datiem, jo šeit ekrāna vairs nebūs.
Man šī starpne nav nepieciešama, bet ir nepieciešama šāda iespēja.
Tad – jā, to var izdarīt.
Avots: habr.com
