

2015. gada Alekseja Lesovska ziņojuma "Deep dive into PostgreSQL internal statistics" atšifrējums.
Ziņojuma autora atruna: Norādu, ka šis ziņojums datēts ar 2015. gada novembri — pagājuši vairāk nekā 4 gadi un ir pagājis daudz laika. Ziņojumā aplūkotā versija 9.4 vairs netiek atbalstīta. Pēdējo 4 gadu laikā ir izlaisti 5 jauni laidieni, kuros parādījās daudz jauninājumu, uzlabojumu un izmaiņu attiecībā uz statistiku, un daļa materiāla ir novecojusi un nav aktuāla. Pārskatīšanas procesā es centos iezīmēt šīs vietas, lai neievilinātu tevi, lasītāj, maldu lamatās. Tomēr es neizvēlējos pārrakstīt šīs vietas, to ir ļoti daudz, un beigās sanāks pilnīgi cits ziņojums.
Datubāze PostgreSQL ir liels mehānisms, kas sastāv no daudziem apakšsistēmām, kuru koordinēta darbība tieši ietekmē datubāzes veiktspēju. Ekspluatācijas procesā tiek nodrošināta statistikas un informācijas par komponentu darbību apkopošana, kas ļauj novērtēt PostgreSQL efektivitāti un veikt pasākumus veiktspējas uzlabošanai. Tomēr šīs informācijas ir ļoti daudz un tā tiek piedāvāta diezgan vienkāršotā veidā. Šīs informācijas apstrāde un interpretācija reizēm ir visai netriviāla uzdevums, un "zoodārzs" rīku un utilītu var viegli apjukt pat pieredzējušu DBA.
Labdien! Mans vārds ir Aleksejs. Kā Iļja teica, es stāstīšu par PostgreSQL statistiku.
PostgreSQL aktivitātes statistika. PostgreSQL ir divas statistikas. Aktivitātes statistika, par kuru būs runa. Un plānotāja statistika par datu sadalījumu. Es stāstīšu tieši par PostgreSQL aktivitātes statistiku, kas ļauj mums spriest par veiktspēju un kaut kā to uzlabot.
Pastāstīšu, kā efektīvi izmantot statistiku dažādu problēmu risināšanai, kas jums radušās vai varētu rasties.
Ko ziņojumā nebūs? Ziņojumā es netikšu pie plānotāja statistikas, jo tā ir atsevišķa tēma atsevišķam ziņojumam par to, kā dati tiek glabāti datubāzē un par to, kā plānotājs iegūst priekšstatu par šo datu kvalitatīvām un kvantitatīvām īpašībām.
Un nebūs arī rīku apskatu, es nesalīdzināšu vienu produktu ar citu. Nekādas reklāmas nebūs. Atmetīsim to.
Es vēlos jums parādīt, ka statistikas izmantošana ir noderīga. Tas ir nepieciešams. To izmantot nav grūti. Mums būs nepieciešams tikai parasts SQL un pamatzināšanas par SQL.
Un runāsim par to, kādu statistiku izvēlēties problēmu risināšanai.
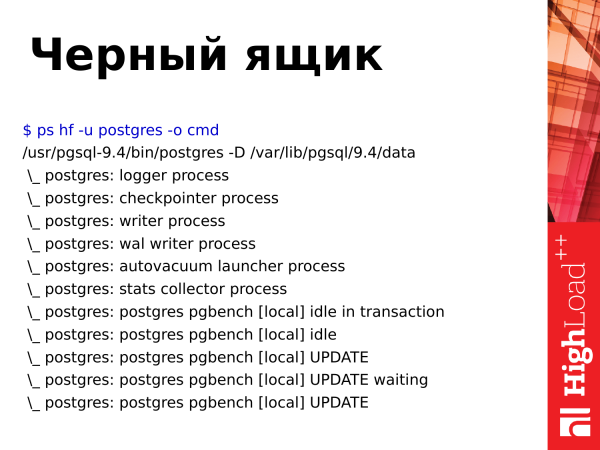
Ja mēs paskatāmies uz PostgreSQL un operētājsistēmā izpildīsim komandu, lai apskatītu procesus, mēs redzēsim "melno kārbu". Mēs redzēsim dažus procesus, kas kaut ko dara, un pēc nosaukuma varam aptuveni iedomāties, ko tie dara. Bet, būtībā, tas ir melns kārba, iekšā mēs ieskatīties nevaram.
Mēs varam aplūkot procesora slodzi top, varam pārbaudīt atmiņas izmantošanu ar kādām sistēmas utilītēm, bet ieskatīties PostgreSQL iekšpusē mēs nevarēsim. Tam mums ir nepieciešami citi rīki.
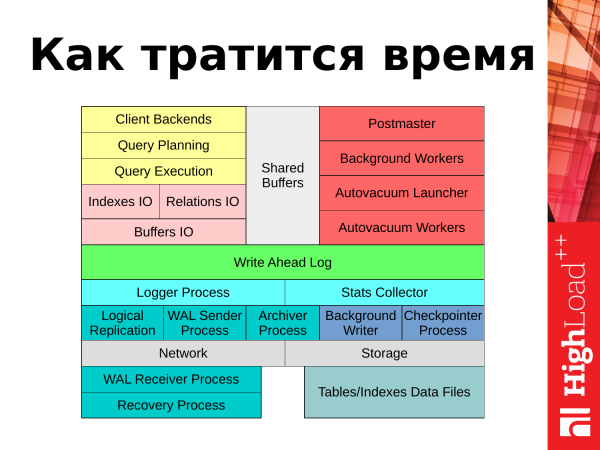
Un turpinot, es pastāstīšu, uz kurieni tiek tērēts laiks. Ja mēs iedomājamies PostgreSQL kā šādu shēmu, tad mēs varam atbildēt, uz kurieni tiek tērēts laiks. Tas ir divas lietas: klientu pieprasījumu apstrāde no lietotnēm un foniskie uzdevumi, ko PostgreSQL veic, lai nodrošinātu savu darbspēju.
Ja mēs sākam apskatīt no kreisā augšējā stūra, mēs varam izsekot, kā tiek apstrādāti klientu pieprasījumi. Pieprasījums nāk no lietotnes un nākamajai darbībai tiek atvērta klienta sesija. Pieprasījums tiek nodots plānotājam. Plānotājs izveido pieprasījuma plānu. To nosūta tālāk izpildei. Notiek kāda bloku I/O operācija, saistīta ar tabulām un indeksiem. Nepieciešamie dati tiek nolasīti no diskiem atmiņā speciālā apgabalā "shared buffers". Pieprasījuma rezultāti, ja tas ir updates, deletes, tiek fiksēti darījumu žurnālā WAL. Dažas statistikas informācija nonāk žurnālā vai statistikas kolektorā. Un pieprasījuma rezultāts tiek nodots atpakaļ klientam. Pēc tam klients var atkārtot visu ar jaunu pieprasījumu.
Kādas ir mūsu fonisko uzdevumu un fonisko procesu īpašības? Mums ir vairāki procesi, kas nodrošina darbību un uztur datu bāzi normālā darba režīmā. Šie procesi tiks skarti arī ziņojumā: tas ir autovacuum, checkpointer, procesi, kas saistīti ar replikāciju, background writer. Par katru no tiem es runāšu ziņojuma gaitā.
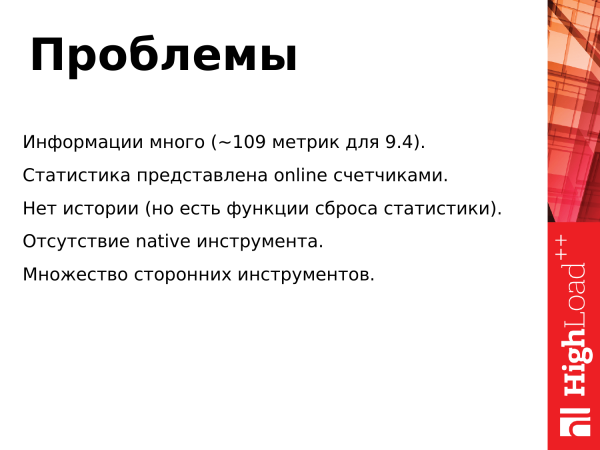
Kādas problēmas ir saistītas ar statistiku?
- Informācijas ir daudz. PostgreSQL 9.4 nodrošina 109 metriku datu statistikas skatīšanai. Tomēr, ja datubāzē ir daudz tabulu, shēmu un datubāžu, tad visas šīs metrikas būs jāreizina ar attiecīgo tabulu un datubāzu skaitu. T. i., informācijas kļūst vēl vairāk. Un tajā ļoti viegli iegrimt.
- Nākamā problēma ir tā, ka statitika tiek attēlota skaitītāju formā. Ja mēs aplūkojam šo statistiku, mēs redzēsim pastāvīgi pieaugošus skaitītājus. Ja no statistikas dzēšanas brīža ir pagājis ļoti ilgs laiks, mēs redzēsim miljardiem vērtības. Un tās mums neko nepasaka.
- Nav vēstures. Ja jums ir notikusi kāda kļūme, kas notika 15-30 minūtes atpakaļ, jūs nevarat izmantot statistiku, lai uzzinātu, kas notika 15-30 minūtes iepriekš. Tā ir problēma.
- Iekļautā rīka trūkums PostgreSQL ir problēma. Koda izstrādātāji nesniedz nekādu utilītu. Viņiem nav nekāda līdzīga. Viņi vienkārši sniedz statistiku datubāzē. Izmantojiet to, veiciet ar to pieprasījumus, dariet, ko vēlaties.
- Tā kā iekļautā rīka PostgreSQL nav, tas ir iemesls citai problēmai. Daudzas trešo pušu lietotnes. Katrs uzņēmums, kuram ir vairāk vai mazāk prasīgas rokas, mēģina izstrādāt savu programmu. Un rezultātā kopienā ir ļoti daudz rīku, kurus var izmantot statistikas apstrādei. Un vieniem rīkiem ir noteiktas iespējas, citiem rīkiem nav citu iespēju, vai arī ir kādas jaunas iespējas. Un rodas situācija, kad ir nepieciešams izmantot divus, trīs, četrus rīkus, kas viens otru pārklāj un kuriem ir dažādas funkcijas. Tas ir ļoti nepatīkami.
Ko no tā var secināt? Ir svarīgi spēt iegūt statistiku tieši, lai nepaļautos uz programmām, vai arī kādā veidā uzlabot šīs programmas: pievienojot noteiktas funkcijas, lai gūtu savu labumu.
Un ir nepieciešamas pamatzināšanas SQL. Lai iegūtu datus no statistikas, ir jāformulē SQL pieprasījumi, t. i., jums jāzina, kā sastādīt select, join.
Statistika piedāvā mums vairākas lietas. Tās var iedalīt kategorijās.
- Pirmā kategorija ir notikumi, kas notiek datubāzē. Tas ir tad, kad datubāzē notiek kāds notikums: pieprasījums, piekļuve tabulai, automātiskā vakumēšana, apstiprinājumi — tas viss ir notikumi. Attiecīgajiem notikumiem skaitītāji tiek incrementēti. Mēs varam izsekot šiem notikumiem.
- Otrā kategorija ir objektu īpašības, piemēram, tabulas, datubāzes. Tām ir īpašības. Tas ir tabulu izmērs. Mēs varam izsekot tabulu izaugsmei, indeksu pieaugumam. Mēs varam apskatīt izmaiņas dinamiskā veidā.
- Un trešā kategorija ir laiks, kas nepieciešams notikumam. Pieprasījums ir notikums. Tam ir sava konkrēta ilguma mēra. Šeit tas sākās, šeit tas beidzās. Mēs varam to izsekot. Vai arī laiks, kas nepieciešams bloka lasīšanai no diska vai ierakstīšanai. Tādas lietas arī tiek izsekotas.
Statistikas avoti ir šādi:
- Kopīgajā atmiņā (shared buffers) ir segments, lai tur ievietotu statiskos datus; tur ir arī tie paši skaitītāji, kas pastāvīgi tiek incrementēti, kad notiek kādi notikumi vai rodas kādi momenti datubāzes darbībā.
- Visi šie skaitītāji nav pieejami lietotājam un pat nav pieejami administratoram. Tie ir zema līmeņa dati. Lai pie tiem piekļūtu, PostgreSQL piedāvā interfeisu SQL funkciju veidā. Mēs varam veikt select vaicājumus, izmantojot šīs funkcijas, un iegūt kādu metriku (vai metrikas kopumu).
- Tomēr izmantot šīs funkcijas vienmēr nav ērti, tāpēc funkcijas kalpo kā pamats skatu (VIEWs) izveidošanai. Tie ir virtuāli tabulas, kas sniedz statistiku par kādu konkrētu apakšsistēmu vai kādu grupu notikumu datubāzē.
- Šie iebūvētie skatījumi (VIEWs) ir galvenais lietotāja interfeiss statistikas apstrādē. Tie ir pieejami noklusēti bez papildu konfigurācijas, varat to uzreiz izmantot, apskatīt, ņemt no turienes informāciju. Ir arī contrib pakotnes. Ir oficiālas contrib pakotnes. Jūs varat instalēt postgresql-contrib pakotni (piemēram, postgresql94-contrib), ielādēt nepieciešamo moduli konfigurācijā, norādīt tam parametrus, restartēt PostgreSQL un varat to lietot. (Piezīme. Atkarībā no izplatīšanas, pēdējās versijās contrib pakotne ir daļa no galvenās pakotnes.).
- Ir pastāv neoficiālie contrib. Tie netiek piegādāti ar standarta PostgreSQL komplektu. Tos nepieciešams vai nu kompilēt, vai instalēt kā bibliotēku. Varianti var būt ļoti dažādi, atkarībā no tā, ko izstrādātājs ir izdomājis šim neoficiālajam contrib.
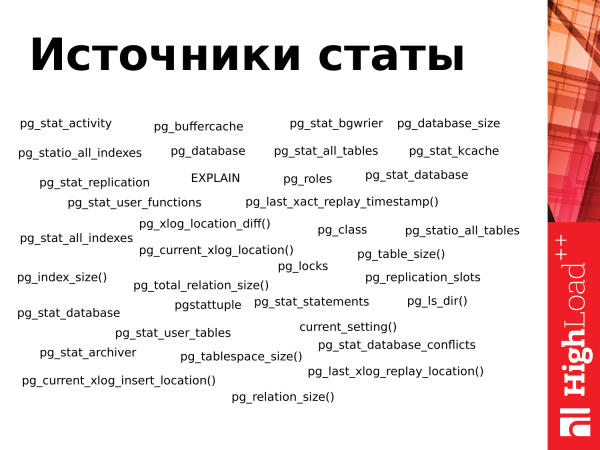
Šajā slaidā ir attēloti visi tie skati (VIEWs) un daļa no funkcijām, kas ir pieejamas PostgreSQL 9.4. Kā redzam, to ir daudz. Un ir diezgan viegli apjukt, ja ar to saskaras pirmo reizi.
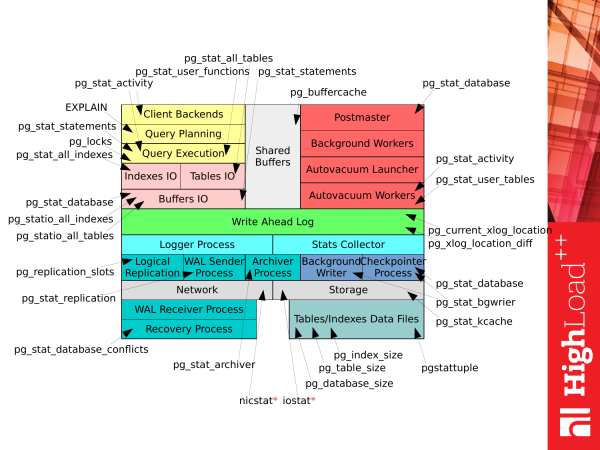
Tomēr, ja mēs paņemam iepriekšējo attēlu Kā tiek iztērēts laiks uz PostgreSQL un salīdzinām ar šo sarakstu, tad iegūstam šādu attēlu. Katru skatu (VIEWs) vai katru funkciju mēs varam izmantot dažādiem mērķiem, lai iegūtu atbilstošo statistiku, kad darbojas PostgreSQL. Un mēs varam saņemt kādu informāciju par apakšsistēmas darbību.
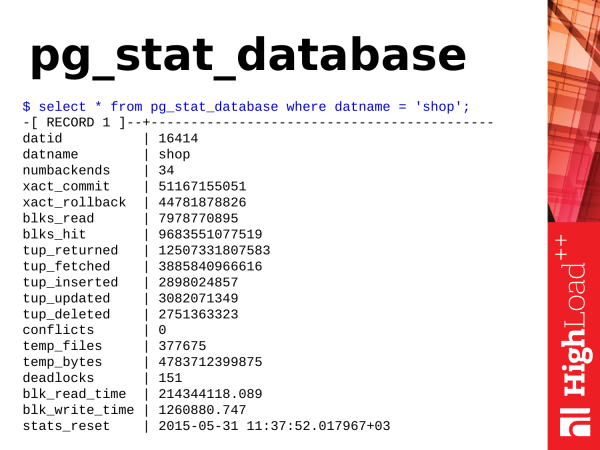
Pirmais, ko mēs aplūkosim, ir pg_stat_database. Kā redzam, šis ir skats. Tajā ir daudz informācijas. Ļoti dažāda informācija. Un tā sniedz ļoti noderīgas zināšanas par to, kas notiek mūsu datu bāzē.
Ko noderīgu mēs varam no turienes iegūt? Sāksim ar pašām vienkāršākajām lietām.
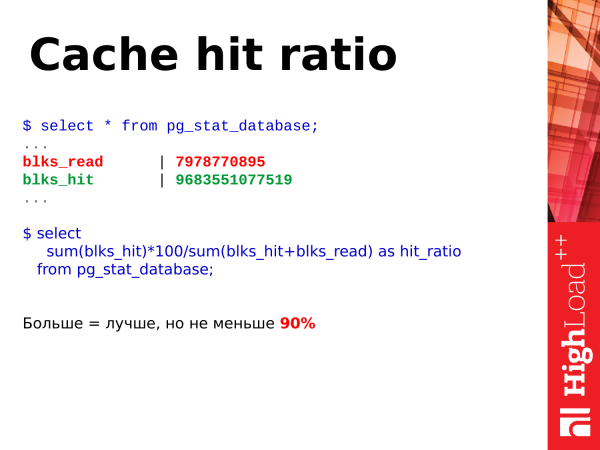
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Pirmais, ko mēs varam apskatīt, ir procentuālais kopsummas rādītājs. Procentuālais kopsummas rādītājs ir noderīga metrika. Tā ļauj novērtēt, cik liels datu apjoms tiek ņemts no shared buffers kešatmiņas, un cik liels datu apjoms tiek nolasīts no diska.
Saprotams, ka jo lielāks mūsu kešatmiņas trāpījums, jo labāk. Mēs šo metrikas rādītāju novērtējam kā procentu. Un, piemēram, ja mūsu kešatmiņas trāpījuma procents pārsniedz 90 %, tad tas ir labi. Ja tas pazeminās zem 90 %, tas nozīmē, ka mums nepietiek atmiņas, lai saglabātu karstos "datus" atmiņā. Un, lai izmantotu šos datus, PostgreSQL ir spiests piekļūt diskam, un tas ir lēnāk nekā tad, ja dati tiktu nolasīti no atmiņas. Jādomā par atmiņas palielināšanu: vai nu palielināt shared buffers, vai pievienot vairāk fiziskās atmiņas (RAM).
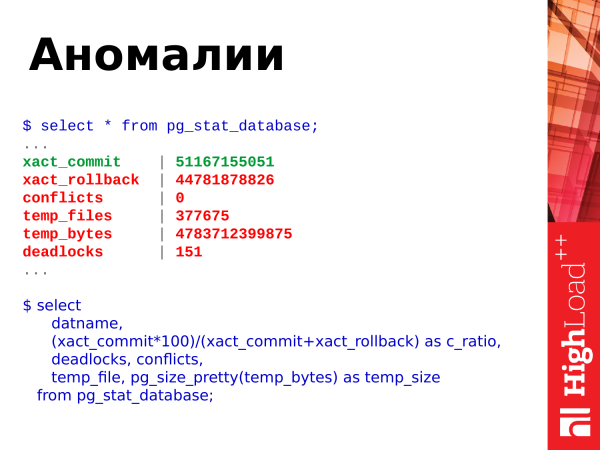
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Ko vēl varam ņemt no šī skatījuma? Varam apskatīt anomālijas, kas notiek datu bāzē. Ko šeit rāda? Šeit ir commits, rollbacks, pagaidu failu izveide, to apjoms, deadlocks un konflikti.
Mēs varam izmantot šo vaicājumu. Šis SQL ir diezgan vienkāršs. Un mēs varam apskatīt šos datus pie sevis.
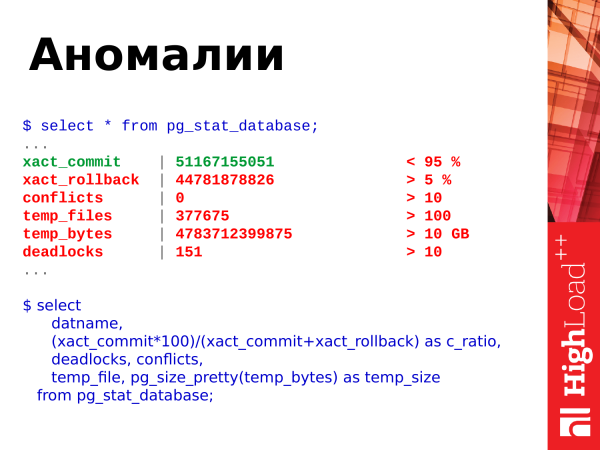
Un šeit uzreiz ir sliekšņa vērtības. Mēs skatāmies attiecību starp commits un rollbacks. Commits – tas ir veiksmīgs darījuma apstiprinājums. Rollbacks – tas ir atcelšana, t. i., darījums veica kādu darbu, noslogoja datubāzi, kaut ko skaitīja, bet pēc tam notika kļūda un darījuma rezultāti tiek noraidīti. T. i. pārāk liels skaits rollbacks ir slikti. Un būtu jāizvairās no tiem un jāpārskata kods, lai tā nenotiktu.
Konflikti (conflicts) ir saistīti ar replikāciju. Un tiem arī vajadzētu iztīrīt. Ja jums ir kādi vaicājumi, kas tiek izpildīti replikā un rodas konflikti, tad jāizpēta šie konflikti, jāskatās, kas notiek. Detalizēti var atrast žurnālos. Un jānovērš konfliktainas situācijas, lai aplikācijas vaicājumi darbotos bez kļūdām.
Deadlocks – tā ir arī slikta situācija. Kad vaicājumi sacenšas par resursiem, viens vaicājums piekļūst vienam resursam un iegūst slēgšanu, otrs vaicājums piekļūst otram resursam un arī iegūst slēgšanu, bet pēc tam abi vaicājumi piekļūst viens otra resursiem un bloķējas gaidot, kad kaimiņš atbrīvos slēgšanu. Tas ir arī problemātisks stāvoklis. Tos jārisina, pārstrādājot aplikācijas un sērijveidā piekļūstot resursiem. Un, ja jūs redzat, ka jūsu deadlocks pastāvīgi palielinās, ir jāskatās detaļas žurnālos, jāizpēta radušās situācijas un jāpārbauda, kur ir problēma.
Pagaidu faili (temp_files) – tas ir arī slikti. Kad lietotāja vaicājumam trūkst atmiņas, lai novietotu operatīvos, pagaidu datus, tas izveido diska failu. Un visas operācijas, kuras tas varēja veikt pagaidu buferī atmiņā, sāk veikt jau uz diska. Tas ir lēni. Tas palielina vaicājuma izpildes laiku. Un klients, kas nosūtīja vaicājumu uz PostgreSQL, saņems atbildi nedaudz vēlāk. Ja visas šīs operācijas tiks veiktas atmiņā, Postgres atbildēs daudz ātrāk un klients gaidīs mazāk.
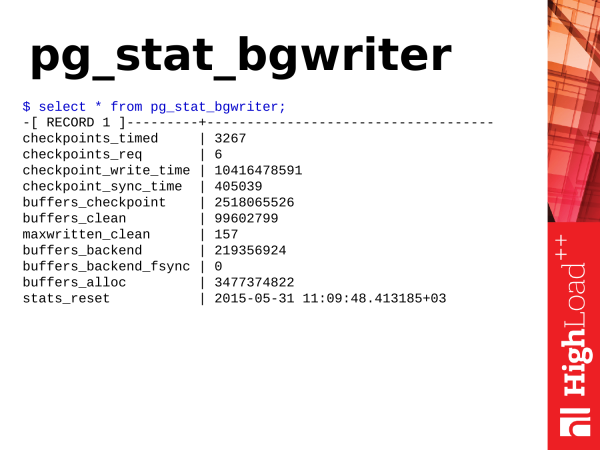
Pg_stat_bgwriter – šis skats apraksta divu fona apakšsistēmu darbu PostgreSQL: tas ir checkpointer un fona rakstītājs.
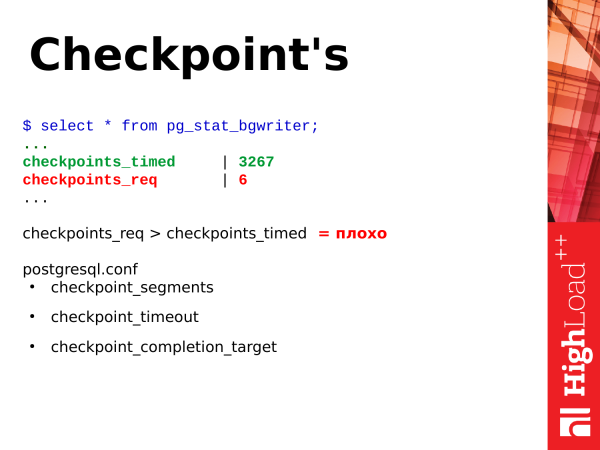
Vispirms izpētīsim kontrolpunktus, t. i. checkpoints. Kas ir kontrolpunkti? Kontrolpunkts ir pozīcija transakciju žurnālā, kas norāda, ka visi datu izmaiņas, kas fiksētas žurnālā, ir veiksmīgi sinhronizētas ar datiem diskā. Process, atkarībā no slodzes un iestatījumiem, var būt gara un lielākoties sastāv no netīro lapu sinhronizācijas koplietojamo buferu ar datu failiem diskā. Kāpēc tas ir nepieciešams? Ja PostgreSQL pastāvīgi piekļūtu diskam un ņemtu datus no turienes un rakstītu datus katru reizi, kad piekļūtu, tas būtu lēni. Tāpēc PostgreSQL ir atmiņas segments, kura lielums ir atkarīgs no konfigurācijas parametriem. Postgres šajā atmiņā ievieto operatīvos datus turpmākai apstrādei vai izsniegšanai pēc pieprasījuma. Ja notiek pieprasījumi uz datu izmaiņām, tad tās tiek mainītas. Un mēs saņemam divas datu versijas. Viena ir mūsu atmiņā, otra diskā. Un periodiski ir jāsinhronizē šie dati. Mums ir jāsinhronizē tas, kas ir mainīts atmiņā, uz disku. Tam ir nepieciešams kontrolpunkts.
Kontrolpunkts iziet cauri koplietojamiem buferiem, atzīmē netīras lapas, ka tās ir nepieciešamas kontrolpunktam. Pēc tam viņš veic otro gājienu pa koplietojamiem buferiem. Un lapas, kas ir atzīmētas kontrolpunktam, viņš jau sinhronizē. Tādējādi notiek datu sinhronizācija ar disku.
Ir divu veidu kontrolpunkti. Viens kontrolpunkts tiek veikts pēc laika intervāla. Šis kontrolpunkts ir noderīgs un labs – checkpoint_timed. Un ir kontrolpunkti pēc pieprasījuma – checkpoint required. Šāds kontrolpunkts notiek, kad mums ir ļoti liela datu rakstīšana. Mēs esam ierakstījuši ļoti daudz transakciju žurnālu. Un PostgreSQL uzskata, ka tam ir nepieciešams visu to sinhronizēt pēc iespējas ātrāk, veikt kontrolpunktu un turpināt dzīvot.
Un, ja jūs esat skatījies statistiku pg_stat_bgwriter un redzējāt, ka jums checkpoint_req ir daudz lielāks nekā checkpoint_timed, tad tas ir slikti. Kāpēc slikti? Tas nozīmē, ka PostgreSQL atrodas pastāvīgā stresa situācijā, kad tam ir jāieraksta dati diskā. Kontrolpunkts pēc laika intervāla ir mazāk stresa un tiek veikts saskaņā ar iekšējo grafiku un ir kā izstiepts laika posms. PostgreSQL ir iespēja veikt pārtraukumus darbā un nenoslogot diskusistēmu. Tas ir labvēlīgi PostgreSQL. Un pieprasījumi, kas tiek izpildīti kontrolpunkta laikā, neizjutīs stresu no tā, ka diskusistēma ir aizņemta.
Un checkpoint regulēšanai ir trīs parametri:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Tie ļauj regulēt kontrolpunktu darbību. Bet es par tiem neapstāšos. To ietekme ir jau atsevišķa tēma.
Uzmanību: Pārskatā aplūkotā versija 9.4 jau nav aktuāla. Mūsdienu PostgreSQL versijās parametrs checkpoint_segments ir aizstāts ar parametriem min_wal_size un max_wal_size.
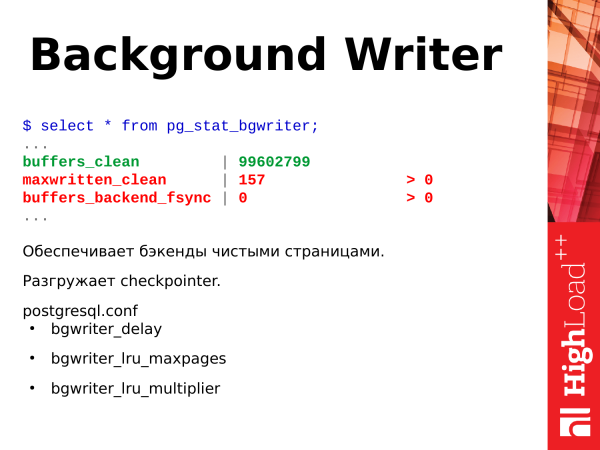
Nākamā apakšsistēma ir fona rakstītājs — fona rakstītājs. Ko viņš dara? Viņš strādā pastāvīgi bezgalīgā ciklā. Viņš skenē lapas kopshared buffers un tīras lapas, kuras viņš atrada, nospiež uz diska. Tādējādi viņš palīdz checkpointer ’am paveikt mazāk darba kontrolpunktu izpildes procesā.
Kāpēc viņš vēl ir nepieciešams? Viņš nodrošina vajadzību pēc tīrām lapām kopshared buffers, ja tās pēkšņi nepieciešamas (lielā skaitā un uzreiz) datu izvietošanai. Pieņemsim, ka radusies situācija, kad, lai izpildītu pieprasījumu, nepieciešamas tīras lapas, un tās jau ir kopshared buffers. Postgres backend to vienkārši ņem un izmanto, viņam pašam nevajag neko tīrīt. Bet, ja tādu lapu nav, backend aptur darbu un sāk meklēt lapas, lai nospiestu tās uz diska un izmantotu savām vajadzībām — tas negatīvi ietekmē izpildāmo pieprasījumu laiku. Ja redzat, ka jūsu parametrs maxwritten_clean ir liels, tas nozīmē, ka fona rakstītājs netiek galā ar savu uzdevumu un ir jāpalielina parametri bgwriter_lru_maxpages, lai viņš varētu vienā ciklā paveikt vairāk darba, vairāk notīrīt lapas.
Un vēl viens ļoti noderīgs rādītājs — tas ir buffers_backend_fsync. Backend netiek veikta fsync, jo tas ir lēni. Viņi nodod fsync augstāk IO stakā checkpointer ’am. Checkpointer ’am ir savs gaidīšanas rindas process, viņš periodiski apstrādā fsync un sinhronizē lapas atmiņā ar failiem diskā. Ja checkpointer ’a gaidīšanas rinda ir liela un piepildīta, backend ir spiests pats veikt fsync un tas lēni ietekmē backend darbību,, t.i., klients saņems atbildi vēlāk, nekā varētu. Ja redzat, ka šī vērtība ir lielāka par nulli, tad tas jau ir problēma un ir jāpieverš uzmanība fona rakstītāja iestatījumiem un arī jānovērtē diska apakšsistēmas veiktspēja.
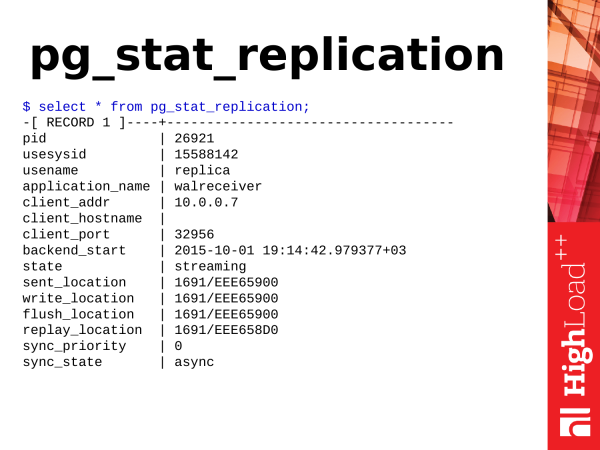
Uzmanību: _Nākamais teksts apraksta statistiskos attēlojumus, kas saistīti ar replikāciju. Lielākā daļa attēlojumu un funkciju nosaukumu tika pārdēvēti Postgres 10. Pārdēvēšanas būtība bija nosaukumu nomaiņa xlog uz wal un location uz lsn funkciju un attēlojumu nosaukumos un tamlīdzīgi. Konkretās piemērs, funkcija pg_xlog_location_diff() tika pārdēvēta kā pg_wal_lsn_diff()._
Šeit mums arī ir daudz dažādu lietu. Bet mums būs nepieciešami tikai punkti, kas saistīti ar location.
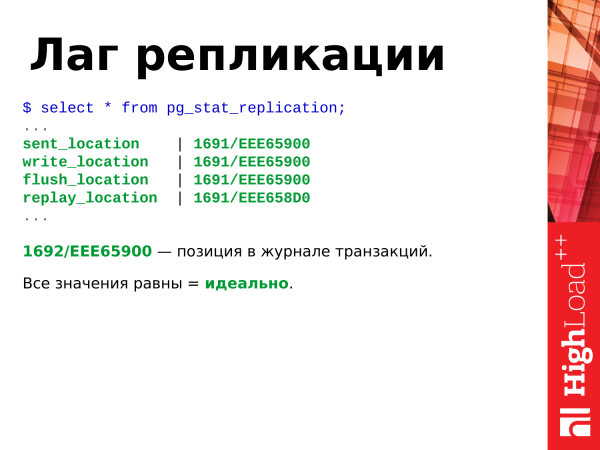
Ja mēs redzam, ka visi vērtības ir vienādas, tad tas ir ideāls variants, un replikācija nepaliek aiz meistara.
Šī sešu zīmju pozīcija ir pozīcija darījumu žurnālā. Tā pastāvīgi palielinās, ja datu bāzē ir kāda aktivitāte: insert, delete utt.
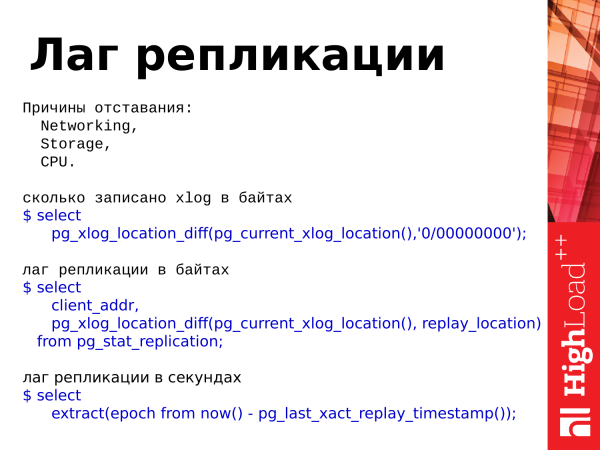
cik xlog ir uzrakstīts baitos
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
replikācijas aizture baitos
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
replikācijas aizture sekundēs
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Ja šīs lietas atšķiras, tātad ir kāda aizture. Aizture – tas ir replikas aizkavēšanās pret meistaru, tas ir, dati atšķiras starp serveriem.
Ir trīs iemesli aizkavēšanai:
- Tas ir disku subsistēmas nepietiekama jauda, lai pareizi pierakstītu failu sinhronizāciju.
- Tas var būt iespējamās tīkla kļūdas vai tīkla sastrēgumi, kad dati netiek laikus nogādāti replikā, un tas tos nevar reproducēt.
- Un procesors. Procesors ir ļoti reta situācija. Un es tādu esmu redzējis divas vai trīs reizes, bet tas tā var būt.
Un šie trīs vaicājumi, kas ļauj mums izmantot statistiku. Mēs varam novērtēt, cik daudz ir uzrakstīts mūsu darījumu žurnālā. Ir šī funkcija pg_xlog_location_diff un varam novērtēt replikācijas aizturi baitos un sekundēs. Mēs arī izmantojam šo vērtību no šī attēlojuma (VIEWs).
Piezīme: _Pār pg_xlog_locationdiff() funkcijām var izmantot atņemšanas operatoru un atņemt vienu pozīciju no otras. Tas ir ērti.
Runājot par aizturi, kas ir sekundēs, ir viens moments. Ja meistara pusē nenotiek nekāda aktivitāte, darījums tur bija pirms 15 minūtēm, un nav nekādas aktivitātes, ja mēs šajā brīdī pārbaudām šo aizturi replikā, mēs redzēsim 15 minūšu aizturi. Par to jāatceras. Tas var apmulst, kad jūs skatāties šo aizturi.
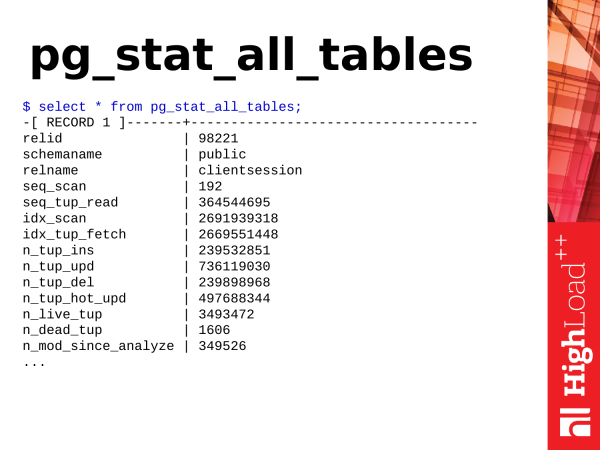
Pg_stat_all_tables – vēl viena noderīga apskate. Tā rāda statistiku par tabulām. Kad mūsu datubāzē ir tabulas, kurām ir kāda aktivitāte, kādas darbības, mēs varam šo informāciju iegūt no šīs apskates.
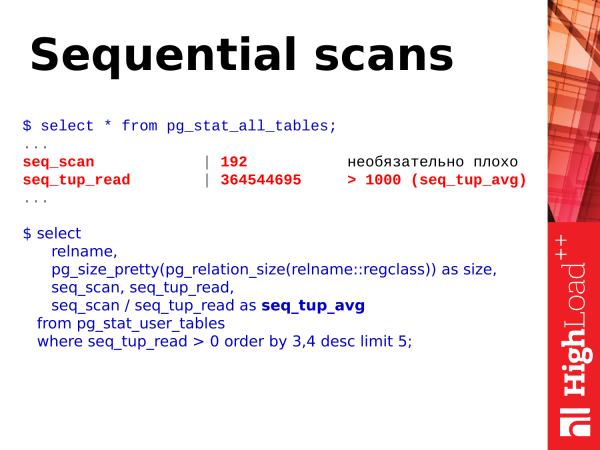
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
Pirmais, ko varam apskatīt, ir secīgās skenēšanas pēc tabulas. Pats skaitlis pēc šiem pārejām vēl nav obligāti slikts un nepierāda, ka mums jau kaut kas jādara.
Tomēr ir otrā metrika – seq_tup_read. Tas ir to rindu skaits, kas atgrieztas secīgās skenēšanas rezultātā. Ja vidējais skaitlis pārsniedz 1 000, 10 000, 50 000, 100 000, tad tas jau ir rādītājs, ka varbūt jums ir jāpievieno indekss, lai piekļuves notiktu pēc indeksa, vai varbūt optimizēt vaicājumus, kas izmanto šādas secīgas skenēšanas, lai to nepieļautu.
Vienkāršs piemērs – pieņemsim, ka vaicājums ar lielu OFFSET un LIMIT ir izpildāms. Piemēram, tiek skenētas 100 000 rindas tabulā, un pēc tam tiek apkopotas 50 000 vajadzīgās rindas, bet iepriekšējās skenētās rindas tiek noraidītas. Tas arī ir slikts gadījums. Un šādus vaicājumus ir jāoptimizē. Šeit ir tāds vienkāršs SQL vaicājums, ar kuru var apskatīt un novērtēt iegūtās ciparnotes.
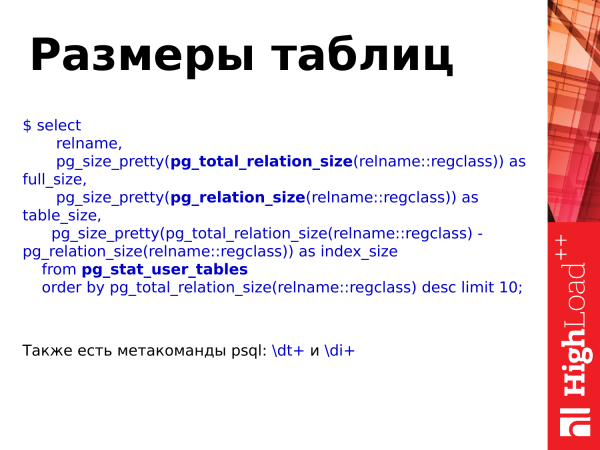
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Tabulu izmērus var iegūt arī ar šīs tabulas palīdzību un, izmantojot papildu funkcijas. pg_total_relation_size(), pg_relation_size().
Īpaši ir metakomandas dt un di, kuras var izmantot PSQL un arī apskatīt tabulu un indeksu izmērus.
Tomēr funkciju izmantošana palīdz mums apskatīt tabulu izmērus, ņemot vērā indeksus vai neņemot tos vērā, un jau veikt kādas novērtēšanas, pamatojoties uz datu bāzes pieaugumu, t.i., kā tā mums aug, ar kādu intensitāti un jau veikt secinājumus par izmēru optimizēšanu.
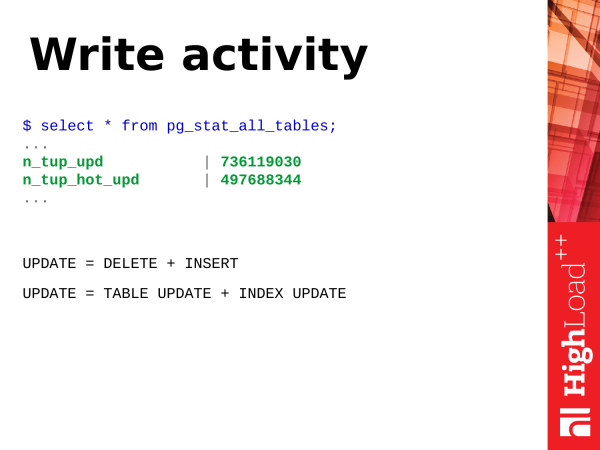
Aktivitāte rakstīšanai. Kas ir ieraksts? Apskatīsim operāciju UPDATE – rindu atjaunināšanas operācija tabulā. Faktiski update ir divas operācijas (vai pat vairāk). Tā ir jaunas rindas versijas ievietošana un vecās rindas versijas atzīmēšana kā novecojusi. Pēc tam nāks automātiska vakuuma operācija, un šīs novecojušās rindas versijas tiks izdzēstas, un šī vieta tiks atzīmēta kā pieejama atkārtotai izmantošanai.
Turklāt update nav tikai tabulas atjaunināšana. Tas ir arī indeksu atjaunināšana. Ja jums tabulā ir daudz indeksu, tad, veicot update, visi indeksi, kuros piedalās laukā atjauninātie dati, arī būs jāpiedāvā atjaunināt. Šajos indeksos arī būs novecojušas rindas versijas, kuras būs jāiztīra.
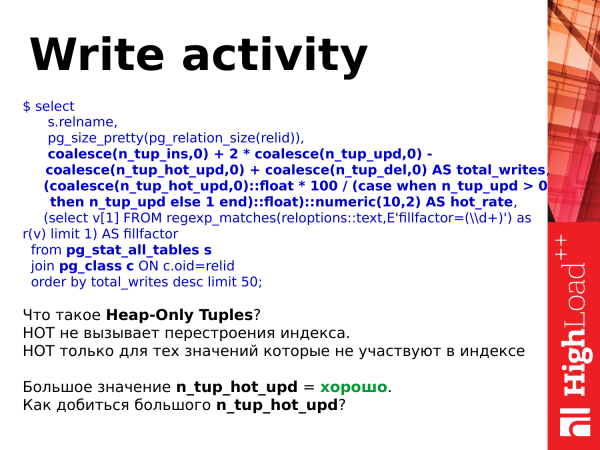
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
Un pateicoties savai struktūrai, UPDATE ir smagas operācijas. Tomēr tās var atvieglot. Ir hot updates. Tie parādījās PostgreSQL versijā 8.3. Un kas tas ir? Tas ir viegli atjaunināms update, kas neizsauc indeksu pārveidošanu. T.i., mēs atjaunojam ierakstu, bet tajā pašā laikā tiek atjaunots tikai ieraksts lapā (kura pieder tabulai), bet indeksu pirms tam norādīja uz to pašu ierakstu lapā. Tur nedaudz ir interesanta darba loģika, kad nāk vakuums, tad tas šīs saites hot pārveido un viss turpina darboties bez indeksu atjaunināšanas, un tas notiek ar mazākām resursu izmaksām.
Un kad jums ir n_tup_hot_upd liels, tas ir ļoti labi. Tas nozīmē, ka vieglie atjauninājumi pārsniedz un tas veidojas mums lētāk izmaksu ziņā, un viss ir izcili.
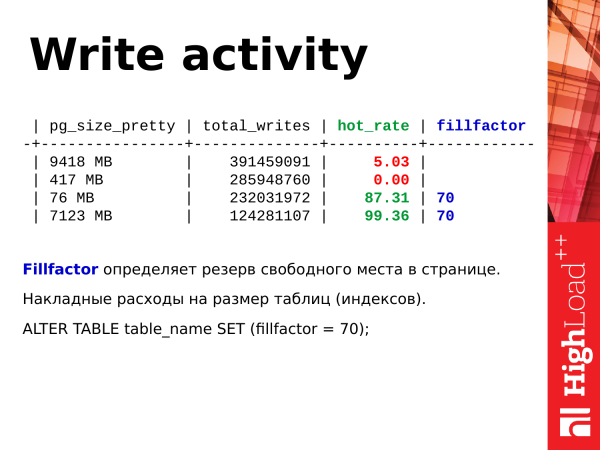
ALTER TABLE table_name SET (fillfactor = 70);Kā palielināt apjomu hot updateu? Mēs varam izmantot fillfactor. Tas nosaka rezervētā brīvā vieta apjomu, kad tiek aizpildīta lapa tabulā ar INSERT. Kad tabulā tiek veiktas ievadīšanas, tās pilnībā aizpilda lapu, neatstājot tajā tukšu vietu. Pēc tam tiek piešķirta jauna lapa. Atkal dati tiek aizpildīti. Un šī uzvedība pēc noklusējuma ir fillfactor = 100 %.
Mēs varam iestatīt fillfactor uz 70%. T.i., kad tiek veiktas ievades, tiek izveidota jauna lapa, bet tiek aizpildīti tikai 70% lapas. Un 30% paliek rezerves. Kad būs nepieciešams veikt atjauninājumu, ir ļoti liela varbūtība, ka tas notiks tajā pašā lapā, un jaunā versija rindiņas tiks ievietota tajā pašā lapā. Tiks veikta hot_update. Tādējādi tiek atvieglota ierakstīšana tabulās.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
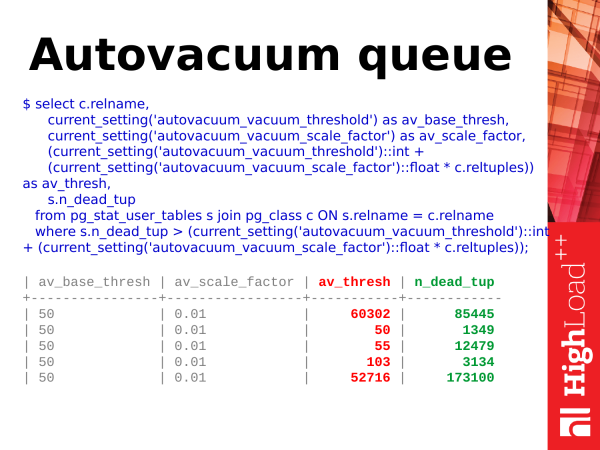
Avotovakuuma rinda. Avotovakuums ir tāda apakšsistēma, par kuru PostgreSQL statistikā ir ļoti maz informācijas. Mēs varam redzēt tabulās tikai pg_stat_activity, cik daudz avotovakuuma pašlaik notiek. Tomēr saprast, cik daudz tabulu ir rinda, ir ļoti grūti.
Piezīme: _Sākot ar PostgreSQL versiju 10, situācija avotovakuuma uzraudzībā ir ievērojami uzlabojusies — ir parādījusies pg_stat_progressvacuum, kas būtiski atvieglo avotovakuuma uzraudzību.
Mēs varam izmantot šādu vienkāršotu vaicājumu. Un mēs varam paskatīties, kad vajadzētu veikt vakuumu. Bet kā un kad vajadzētu darboties vakuumam? Tie ir novecojuši rindiņu varianti, par kuriem es runāju iepriekš. Tika veiktas atjauninājums, jauna rindiņas versija tika ievietota. Parādījās novecojusi rindiņas versija. Tabulā pg_stat_user_tables ir tāds parametrs n_dead_tup. Tas parāda "mirušo" rindiņu skaitu. Un tiklīdz mirušo rindiņu skaits kļūst lielāks par noteiktu slieksni, avotovakuums ieradīsies pie tabulas.
Un kā tiek aprēķināts šis slieksnis? Tas ir konkrēts procentuālais attiecība no kopējā rindiņu skaita tabulā. Ir parametrs autovacuum_vacuum_scale_factor. Tas nosaka procentuālo attiecību. Pieņemsim, 10% + tur klāt ir 50 rindiņu pamata slieksnis. Un kas notiek? Kad mums mirušo rindiņu skaits ir lielāks par "10% + 50" no visām rindiņām tabulā, mēs iestatām tabulu uz avotovakuumu.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
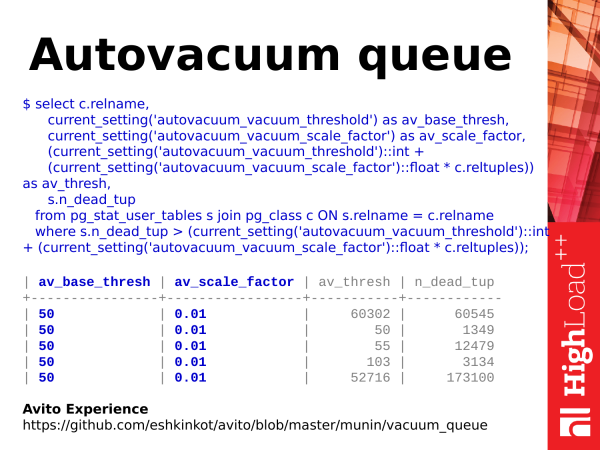
Tomēr te ir viens moments. Pamata slieksņi parametriem av_base_thresh un av_scale_factor var varēji noteikt individuāli. Un attiecīgi slieksnis nebūs globāls, bet individuāls tabulai. Tāpēc, lai aprēķinātu, tur jāizmanto viltības un triki. Un, ja jūs interesē, varat apskatīt mūsu kolēģu pieredzi no Avito (saite slaidā ir nederīga un atjaunināta tekstā).
Viņi uzrakstīja priekš , kas ņem vērā šos faktorus. Tur ir divlapu garš saraksts. Bet tas aprēķina pareizi un diezgan efektīvi ļauj novērtēt, kur mums nepieciešams daudz vakuuma tabulām, kur maz.
Ko mēs ar to varam darīt? Ja mums ir liela rinda un automātiskais vakuums netiek galā, mēs varam palielināt vakuuma darbinieku skaitu vai vienkārši padarīt vakuumu agresīvāku, lai tas tiktu aktivizēts ātrāk, apstrādājot tabulu mazākos gabalos. Tādējādi rinda samazināsies. — Galvenais ir uzraudzīt slodzi uz diskdzinēm, jo vakuums ir dārgs, lai gan ar SSD/NVMe ierīču parādīšanos šī problēma kļuva mazāk pamanāma.
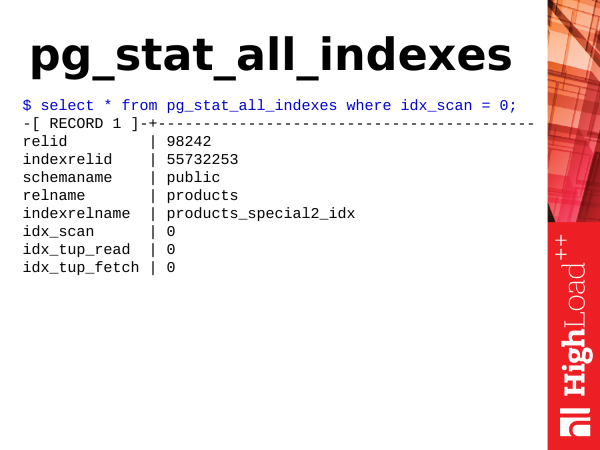
Pg_stat_all_indexes – tas ir statistikas rādītājs par indeksiem. Tas ir neliels. Un mēs varam to izmantot, lai saņemtu informāciju par indeksu izmantošanu. Un piemēram, varam noteikt, kuri indeksi mums ir lieki.
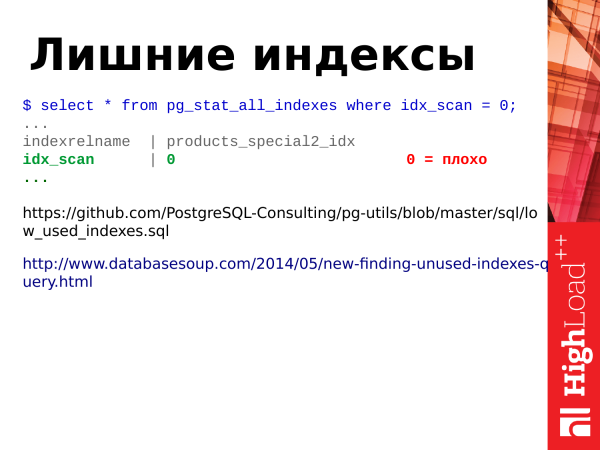
Kā jau teicu, update – tas ne tikai atjauno tabulas, tas arī atjauno indeksus. Atbilstoši, ja mūsu tabulai ir daudz indeksu, tad, atjaunojot rindas tabulā, ir jātiek atjaunotiem arī indeksētajiem laukiem, un ja mums ir neizmantoti indeksi, par kuriem nav indeksu skenēšanas, tad tie ir pārāk smagi. Un no tiem ir jāatbrīvojas. Tāpēc mums nepieciešams lauks idx_scan. Mēs vienkārši skatāmies indeksu skenēšanas skaitu. Ja indekss tam ir nulles skenēšana relatīvi garā statiskās informācijas uzglabāšanas periodā (ne mazāk kā 2-3 nedēļas), visticamāk, tie ir sliktie indeksi, no kuriem mums jāatbrīvojas.
Piezīme: Meklējot neizmantotus indeksus klasteru plūstošās replikācijas gadījumā, ir jāpārbauda visi klastera mezgli, jo statistika nav globāla, un, ja indekss netiek izmantots uz galvenā, tas var tikt izmantots uz replikām (ja tur ir slodze).
Divas saites:
Tās ir progresīvākas pieprasījumu piemēri, kā meklēt neizmantotus indeksus.
Otrā saite ir diezgan interesants pieprasījums. Tur ir ļoti netipiska loģika. Ieteicu to iepazīt.
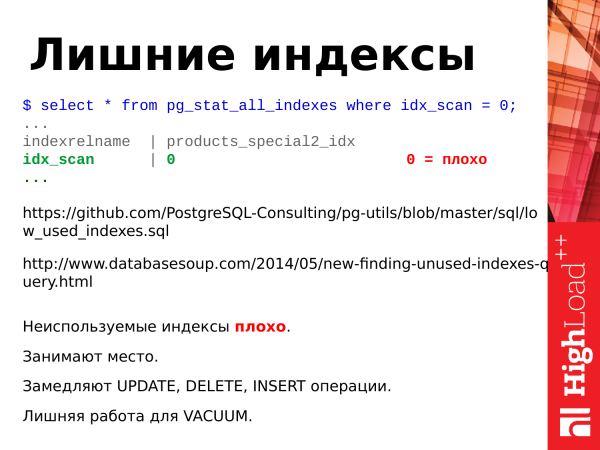
Kas vēl jāpiezīmē par indeksem?
Neizmantotie indeksi ir slikti.
Viņi aizņem vietu.
Viņi palēnina atjaunināšanas operācijas.
Liekas lieka darba vakumam.
Ja mēs likvidēsim neizmantotos indeksus, mēs tikai uzlabosim datu bāzi.
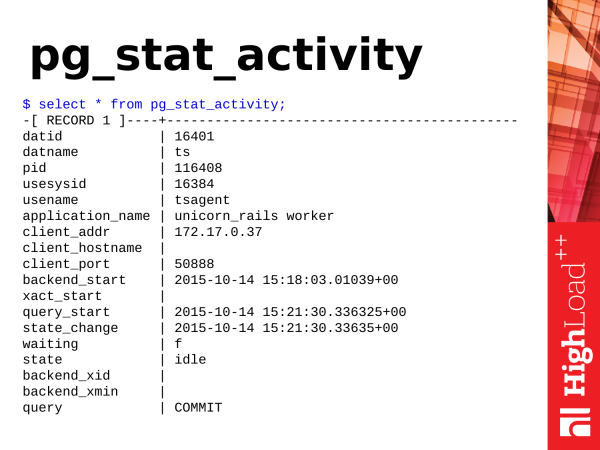
Nākamais attēlojums ir pg_stat_activity. Tas ir līdzīgs rīkam ps, tikai PostgreSQL. Ja ps'os jūs skatāties procesus operētājsistēmā, tad pg_stat_activity tas parādīs aktivitāti iekš PostgreSQL.
Ko mēs varam noderīgu iegūt no turienes?
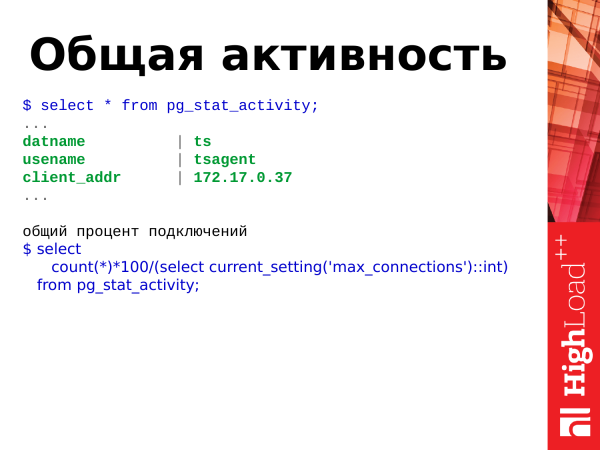
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Mēs varam aplūkot kopējo aktivitāti, kas notiek datu bāzē. Mēs varam veikt jaunu izvietojumu. Mums tur viss ir sabojāts, jauni savienojumi netiek pieņemti, kļūdas krīt aplikācijā.
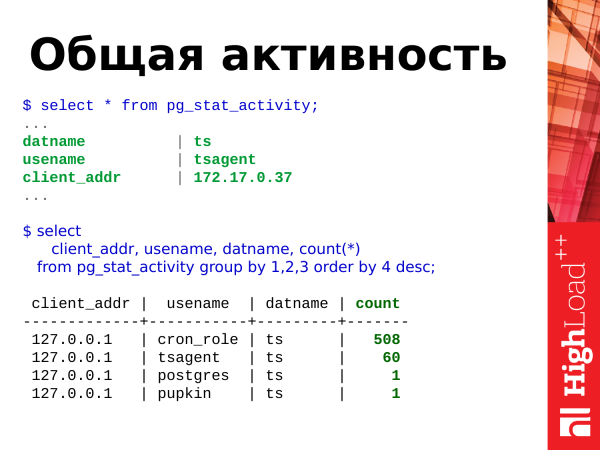
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Mēs varam izpildīt šādu pieprasījumu un apskatīt kopējo savienojumu procentu attiecībā pret maksimālo savienojumu limitu un redzēt, kurš no mums ir aizņēmis visvairāk savienojumu. Un šajā gadījumā mēs redzam, ka lietotājs cron_role atvēra 508 savienojumus. Un kaut kas ar viņu tur notika. Jārisina, jāpārbauda. Un diezgan iespējams, ka tas ir kāds anomāls savienojumu skaits.
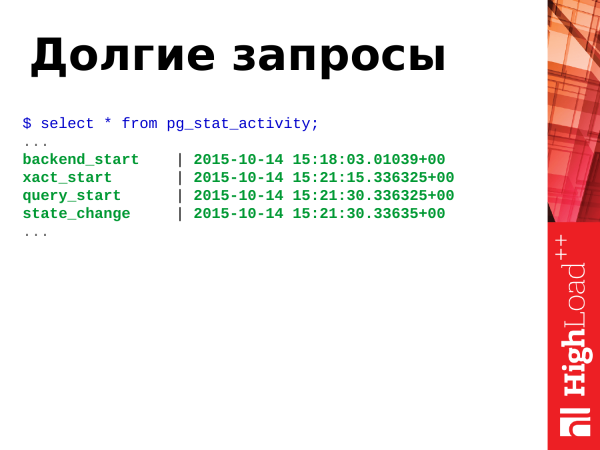
Ja mums ir OLTP slodze, pieprasījumiem jāizpildās ātri, ļoti ātri, un nedrīkst būt garu pieprasījumu. Tomēr, ja rodas gari pieprasījumi, tad īstermiņā nekas traks nav, bet ilgtermiņā gari pieprasījumi kaitē datu bāzei, tie palielina tabulu bloat efektu, kad notiek tabulu fragmentācija. No bloat un garu pieprasījumu jāatbrīvojas.
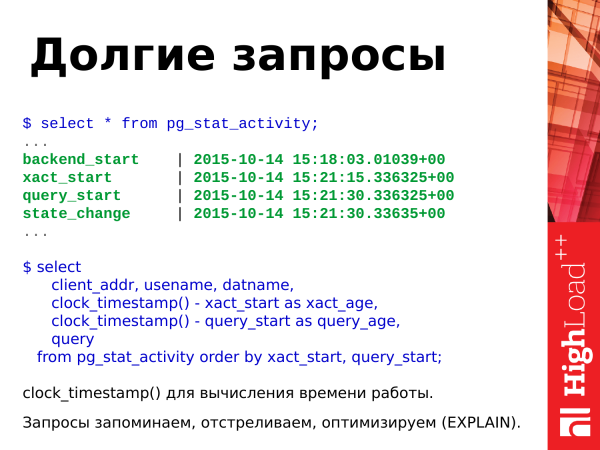
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Pievērsiet uzmanību: ar šādu pieprasījumu mēs varam noteikt garos pieprasījumus un darījumus. Mēs izmantojam funkciju clock_timestamp() lai noteiktu izpildes laiku. Garos pieprasījumus, kurus mēs atradām, mēs varam atcerēties, izpildīt explain, apskatīt plānus un kaut kā optimizēt. Pašreizējos garos pieprasījumus mēs iznīcinām un turpinām dzīvot.
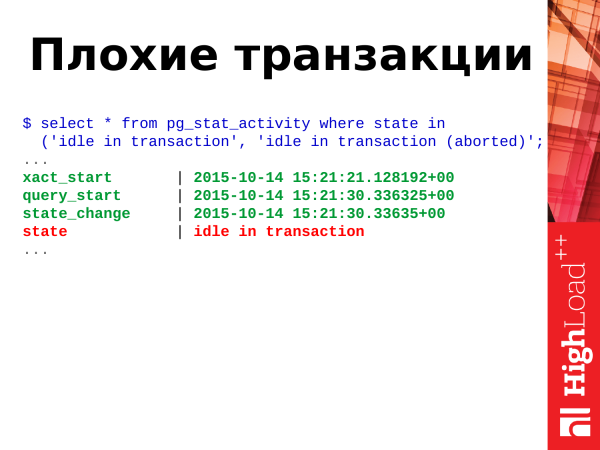
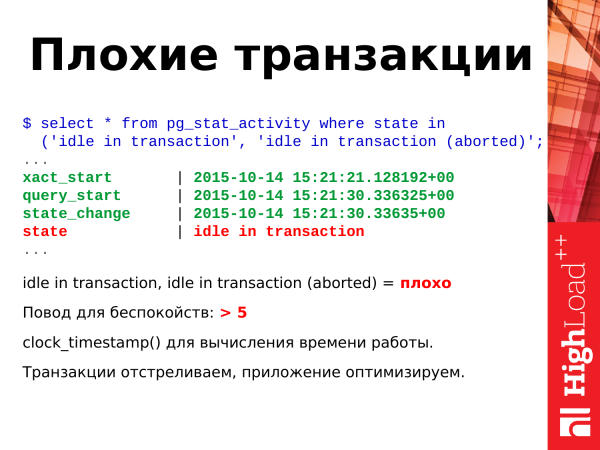
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Slikti darījumi ir darījumi stāvoklī idle in transaction un idle in transaction (aborted).
Ko tas nozīmē? Tranzakcijām ir vairākas stāvokļa situācijas. Un viens no šiem stāvokļiem var mainīties jebkurā brīdī. Lai noteiktu stāvokļus, ir lauks state šajā skatījumā. Un mēs to izmantojam, lai noteiktu stāvokli.
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Un, kā jau iepriekš minēju, šie divi stāvokļi idle in transaction un idle in transaction (aborted) – tas ir slikti. Kas tas ir? Tas ir tad, kad pielietojums ir atvēris tranzakciju, veicis kādas darbības un devies savās lietās. Tranzakcija ir palikusi atvērta. Tā karājas, tajā nekas nenotiek, tā aizņem savienojumu, bloķē modificētās rindas un potenciāli vēl palielina bloat citu tabulu dēļ, pateicoties Postgres tranzakciju dzinēja arhitektūrai. Un šādas tranzakcijas arī ir jānovērš, jo tās ir kaitīgas visās jomās.
Ja jūs redzat, ka jūsu datu bāzē ir vairāk par 5-10-20, tad jāsāk uztraukties un kaut kas ir jādara.
Šeit mēs arī laika aprēķinam izmantojam clock_timestamp(). Tranzakcijas novēršam, pielietojumu optimizējam.
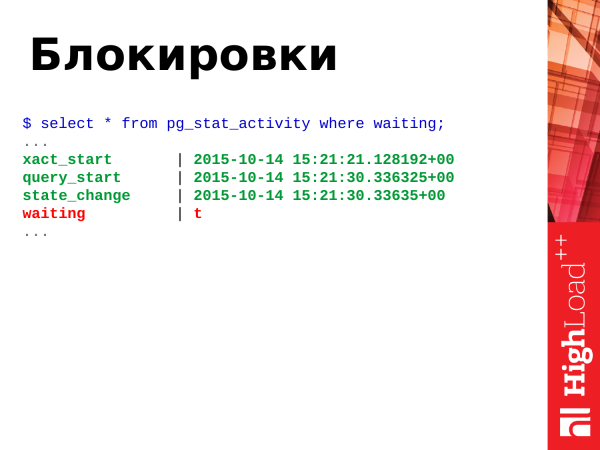
Kā jau iepriekš minēju, bloķēšana – tas ir tad, kad divas vai vairāk tranzakcijas cīnās par vienu vai grupu resursu. Tāpēc mums ir lauks waiting ar loģisko vērtību true vai false.
True – tas nozīmē, ka process ir gaidīšanas režīmā, jāveic kaut kas. Kad process ir gaidīšanas režīmā, tas nozīmē, ka klients, kurš iniciējis šo procesu, arī gaida. Klients pārlūkprogrammā arī sēž un gaida.
Uzmanību: _Sākot no Postgres 9.6 versijas, lauks waiting ir dzēsts un tā vietā ir pievienoti divi informatīvāki lauki wait_event_type un wait_event._
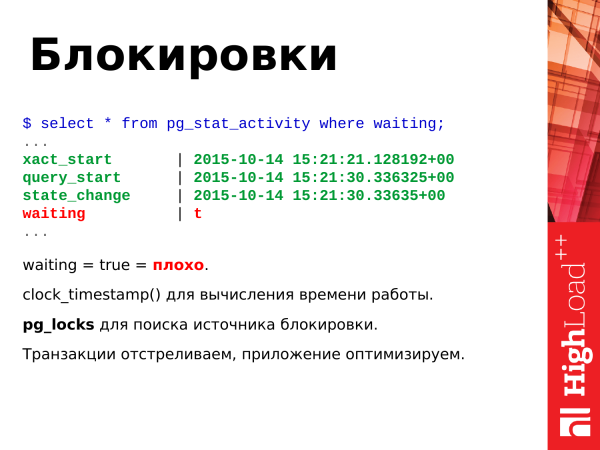
Ko darīt? Ja jūs redzat true ilgu laiku, tas nozīmē, ka no šādiem pieprasījumiem jāatbrīvojas. Mēs vienkārši novēršam šādas tranzakcijas. Programmatūras izstrādātājiem informējam, ka kaut kā jāoptimizē, lai nebūtu resursu konkurences. Un turpinājumā izstrādātāji optimizē lietotni, lai šādas situācijas neradītos.
Un pēdējais, bet potenciāli ne fatāls gadījums – tas ir deadlocks rašanās. Divas tranzakcijas atjaunināja divus resursus, pēc tam atkal piekļūst tiem, jau pretējiem resursiem. PostgreSQL šajā gadījumā paņems un pats novērsīs tranzakciju, lai cita varētu turpināt darbu. Tā ir slēgta situācija, un tā pati nesakārtosies. Tāpēc PostgreSQL ir spiests pieņemt galējus pasākumus.
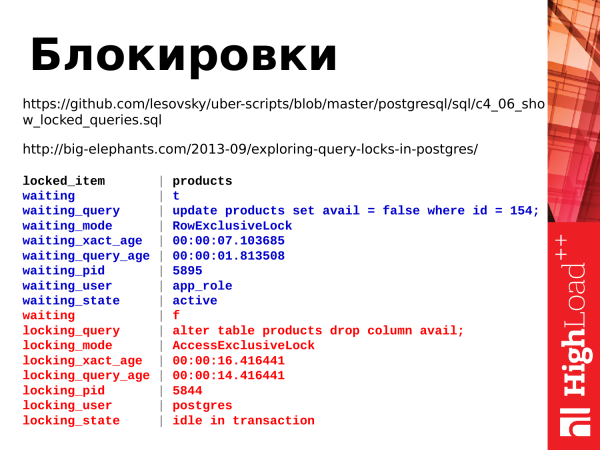
Un šeit ir divi pieprasījumi, kas ļauj izsekot bloķēšanām. Mēs izmantojam skatu pg_locks, kas ļauj izsekot smagas bloķēšanas.
Un pirmais saite – tas ir pats jautājuma teksts. Tas ir diezgan garš.
Un otra saite – tas ir raksts par bloķēšanām. To ir lietderīgi izlasīt, tas ir ļoti interesants.
Tātad, ko mēs redzam? Mēs redzam divus pieprasījumus. Transakcija ar ALTER TABLE – tas ir bloķējošs transakcija. Tā ir uzsākta, bet nav pabeigta, un lietojumprogramma, kas uzsāka šo transakciju, kaut kur nodarbojas ar citām lietām. Un otrais pieprasījums – update. Tas gaida, kad pabeigsies alter table, lai varētu turpināt savu darbu.
Tālāk mēs varam noskaidrot, kurš kādu ir aizķēris, tur un varam ar to strādāt tālāk.
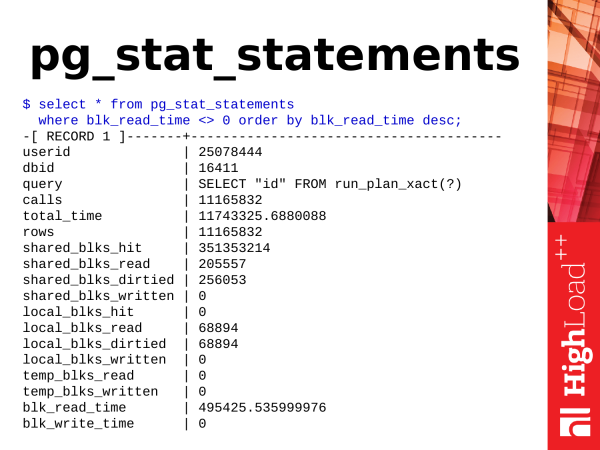
Nākamais modulis – tas ir pg_stat_statements. Kā jau teicu, tas ir modulis. Lai to izmantotu, ir jāielādē tā bibliotēka konfigurācijā, jāpārstartē PostgreSQL, jāinstalē modulis (vienā komandā) un tad mums parādīsies jauns skatījums.
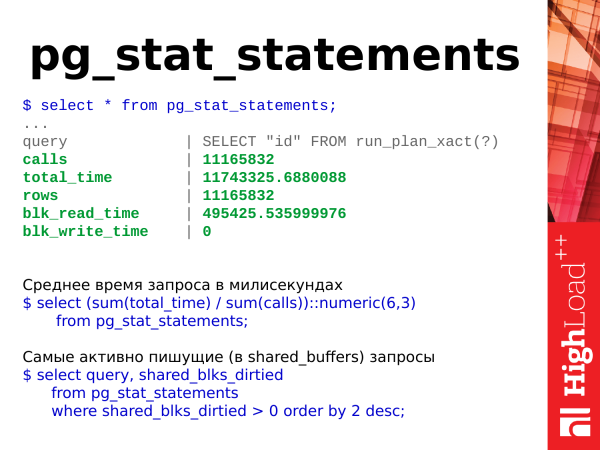
Vidējais pieprasījuma laiks milisekundēs
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Visaktīvākie rakstīšanas pieprasījumi (shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Ko mēs varam no turienes ņemt? Ja runājam par vienkāršām lietām, mēs varam ņemt vidējo pieprasījuma izpildes laiku. Ja laiks pieaug, tas nozīmē, ka PostgreSQL atbild lēni, un mums jāveic kādi pasākumi.
Mēs varam aplūkot visaktīvākās rakstīšanas transakcijas datu bāzē, kas maina datus shared buffers. Aplūkot, kas mums tur atjaunina vai dzēš datus.
Un mēs varam vienkārši aplūkot dažādu statistiku par šiem pieprasījumiem.
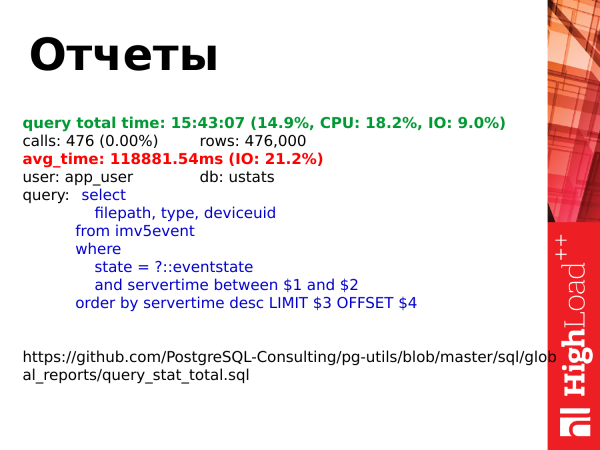
Mēs pg_stat_statements izmantojam ziņojumu veidošanai. Reizi dienā atiestatām statistiku. Uzkrājam to. Pirms nākamās statistikas atiestatīšanas veidojam ziņojumu. Šeit ir saite uz ziņojumu. Jūs to varat apskatīt.
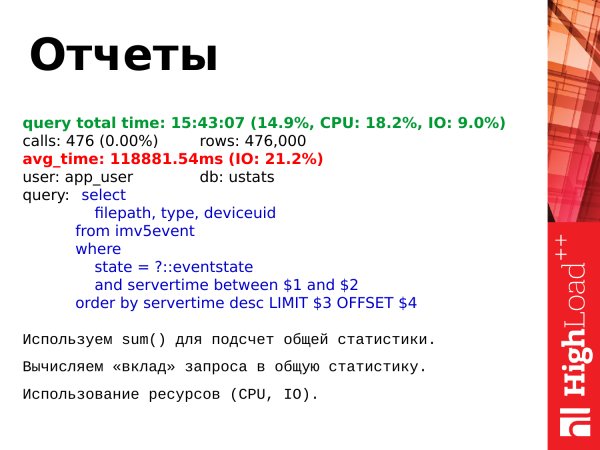
Ko mēs darām? Mēs saskaitām kopējo statistiku par visiem pieprasījumiem. Pēc tam katram pieprasījumam mēs aprēķinām tā individuālo ieguldījumu šajā kopējā statistikā.
Un ko mēs varam aplūkot? Mēs varam aplūkot kopējo visu konkrēta veida pieprasījumu izpildes laiku pret visiem pārējiem pieprasījumiem. Mēs varam aplūkot procesora un ievades-izejas resursu izmantošanu attiecībā pret kopējo ainu. Un pēc tam optimizēt šos pieprasījumus. Mēs veidojam TOP pieprasījumus pēc šī ziņojuma un jau saņemam ierosinājumu tam, kas jāoptimizē.
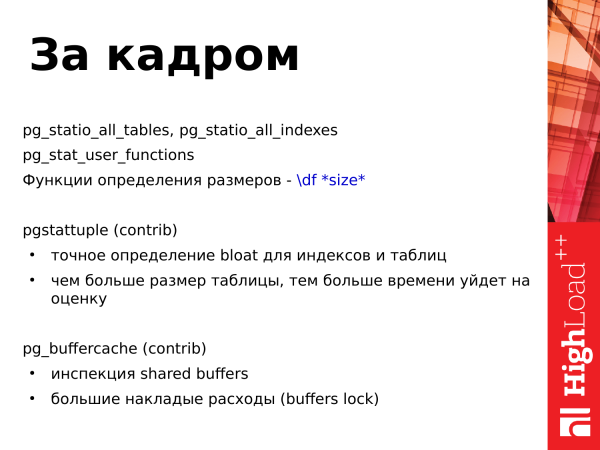
Ko mums ir atliek no kadra? Ir palikušas vēl dažas prezentācijas, kuras es neapskatīju, jo laiks ir ierobežots.
Ir pgstattuple – tas ir arī papildu modulis no standarta pakas contribs. Tas ļauj novērtēt bloat tabulas, t.s. tabulu fragmentāciju. Un, ja fragmentācija ir liela, to nepieciešams novērst, izmantojot dažādus rīkus. Un funkcija pgstattuple strādā ilgstoši. Un, jo vairāk ir tabulu, jo ilgāk tā strādās.
Nākamais contrib – tas ir pg_buffercache. Tas ļauj veikt pārbaudi shared buffers: cik intensīvi un uz kurām tabulām tiek izmantotas buferu lapas. Un vienkārši ļauj ieskatīties shared buffers un novērtēt, kas tur notiek.
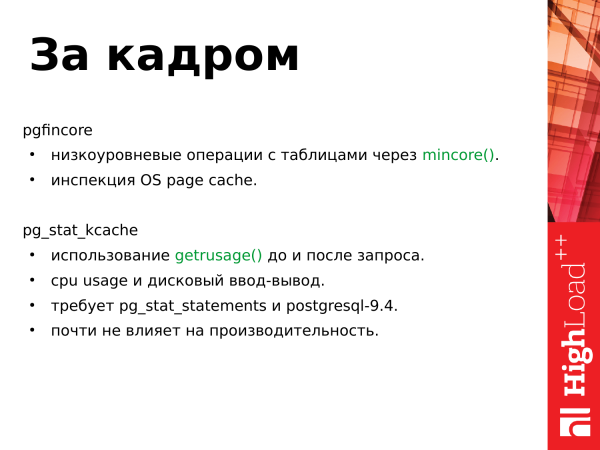
Nākamais modulis – tas ir pgfincore. Tas ļauj veikt zema līmeņa operācijas ar tabulām, izmantojot sistēmas izsaukumu mincore(), t.i., tas ļauj ielādēt tabulu shared buffers, vai to izsist. Un, starp citu, ļauj veikt operāciju sistēmas lapu kešatmiņas pārbaudi, t.i., kādā apjomā mūsu tabula aizņem page cache, shared buffers un vienkārši ļauj novērtēt tabulas noslogojumu.
Nākamais modulis – pg_stat_kcache. Tas arī izmanto sistēmas izsaukumu getrusage(). Un veic to pirms un pēc vaicājuma izpildes. Un iegūtajā statistikā ļauj novērtēt, cik daudz mūsu vaicājums ir tērējis uz diska I/O veikšanu, t.i., operācijām ar failu sistēmu, un skatās, kā tiek izmantots procesors. Tomēr modulis ir jauns (khem-khem) un tā darbībai nepieciešams PostgreSQL 9.4 un pg_stat_statements, par ko es runāju iepriekš.
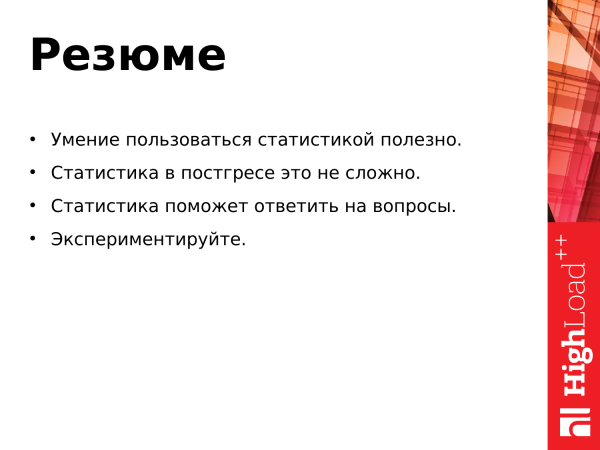
Spēja izmantot statistiku – ir noderīga. Jums nav nepieciešamas trešo pušu programmas. Jūs varat pats ieskatīties, apskatīt, kaut ko izdarīt, veikt.
Izmantot statistiku nav grūti, tas ir parasts SQL. Jūs esat savākuši vaicājumu, sastādījuši, nosūtījuši, apskatījuši.
Statistika palīdz atbildēt uz jautājumiem. Ja jums rodas jautājumi, jūs vēršaties pie statistikas – skatāties, izdarāt secinājumus, analizējat rezultātus.
Un eksperimentējiet. Ir daudz vaicājumu, daudz datu. Vienmēr var optimizēt kādu jau esošu vaicājumu. Var izveidot savu versiju vaicājuma, kas jums ir piemērotāka nekā oriģināls, un izmantot to.
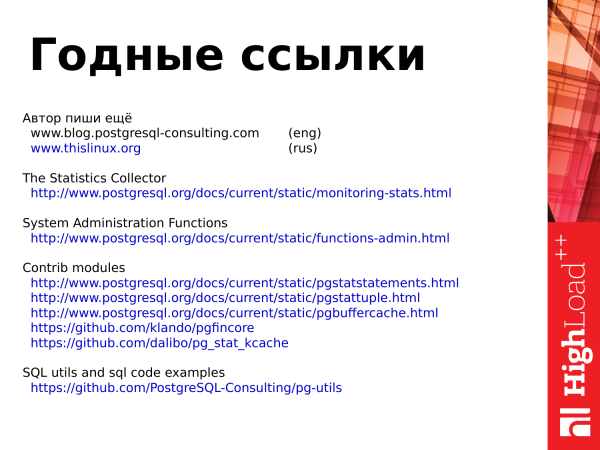
Saites
Drošas saites, kas tika minētas rakstā, kurā bija materiāli, kas tika izmantoti ziņojumā.
Autors raksta vēl
(eng)
Statistikas kolektors
Sistēmas administrēšanas funkcijas
Contrib moduļi
SQL rīki un SQL koda piemēri
Paldies visiem par uzmanību!
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish