

Man vienmēr bija interesanti, kā labāk izvietot grāmatas manā elektroniskajā bibliotēkā. Beigās es nonācu pie tāda risinājuma ar automātisku lapu skaita skaitīšanu un citiem labumiem. Visus interesentus aicinu zemāk.
1. daļa. Dropbox
Visas grāmatas man ir Dropbox. Ir četras kategorijas, uz kurām es visu sadalīju: Mācību grāmata, Rokasgrāmata, literāra, nenovizuot. Taču rokasgrāmatas es tabulā neiekļauju.
Lielākā daļa grāmatu ir .epub, pārējās – .pdf. Tāpēc gala risinājumam jāsedz abi varianti.
Grāmatu ceļi izskatās aptuveni šādi:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Ja grāmata ir literāra, tad kategorija (t.i., "Dizains", ja runājam par iepriekš minēto) tiek izņemta.
Es nolēmu nenodarboties ar Dropbox API, jo man ir viņu aplikācija, kas sinhronizē mapi. Tātad plāns ir šāds: ņemam grāmatas no mapes, katru grāmatu palaidīsim cauri vārdu skaitītājam, pievienojam Notion.
2. daļa. Pievienojam rindu
Pašai tabulai jāizskatās aptuveni šādi. UZMANĪBU: kolonu nosaukumus labāk veidot latīņu burtiem.
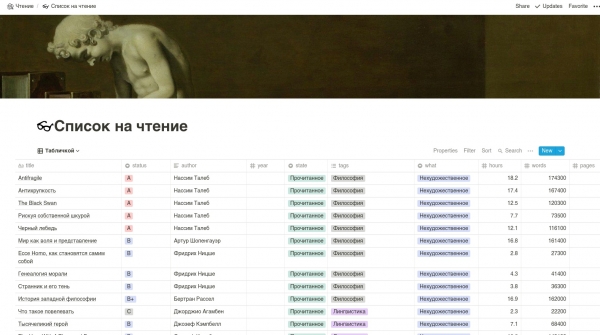
Mēs izmantosim neoficiālo Notion API, jo oficiālais vēl nav pieejams.

Iepriekš dodamies uz Notion, nospiežam Ctrl + Shift + J, ejam uz Application -> Cookies, kopējam token_v2 un nosaucam to par TOKEN. Pēc tam dodamies uz nepieciešamo lapu ar bibliotēkas tabulu un kopējam saiti. Nosaucam NATION.
Pēc tam rakstām kodu savienojumam ar Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Pēc tam uzrakstīsim funkciju rindu pievienošanai tabulā.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Literāra":
            row.author = tags[2]

        elif tags[0] == "Nenovizuot":
            row.tags = tags[2]

        elif tags[0] == "Mācību grāmatas":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Kas šeit notiek. Mēs ņemam un pievienojam jaunu rindu tabulas pirmajā rindā. Pēc tam sadalām mūsu ceļu pa “/” un iegūstam tagus. Tagus — tādā izpratnē kā “Literāra”, “Dizains”, kurš ir autors un tā tālāk. Pēc tam norādām visus nepieciešamos tabulas laukus.
3. daļa. Skaitām vārdus, stundas un citus labumus
Tas jau ir sarežģītāks uzdevums. Kā mēs atceramies, mums ir divi formāti: ePub un PDF. Ja par ePub viss ir skaidrs — tajā, visticamāk, tiešām ir vārdi, tad attiecībā uz PDF viss nav tik vienkārši: tas var sastāvēt tikai no saliktām bildēm.
Tāpēc PDF vārdu skaita funkcija izskatīsies šādi: mēs ņemam lapu skaitu un reizinām to ar noteiktu konstanti (vidējais vārdu skaits lapā).
Šeit tā ir:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Tas pats WORDS_PER_PAGE A4 lapai ir apmēram 300.
Tagad uzrakstīsim funkciju lapu skaita noteikšanai. Izmantosim .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Tālāk uzrakstīsim lietu, lai saskaitītu lapas ePub formātā. Izmantosim . Šeit mēs ņemam grāmatu, pārvēršam to rindās, un katrai rindai saskaitām vārdus.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Tagad aprēķināsim laiku. Ņemam mūsu iecienīto vārdu skaitu un dalām to ar jūsu lasīšanas ātrumu.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
4. daļa. Apvienojam visas daļas
Mums jāapiet visi iespējamie ceļi mūsu grāmatu mapē. Jāpārbauda, vai grāmata jau ir Notion: ja ir — rindu jau neizveidosim.
Pēc tam mums jānosaka faila tips, atkarībā no tā jāsaskaita vārdu skaits. Beigās jāpievieno grāmata.
Šāds kods mums sanāk:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Savukārt funkcija, lai pārbaudītu, vai grāmata ir pievienota, izskatās šādi:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Secinājums
Paldies visiem, kas izlasīja šo rakstu. Ceru, ka tas palīdzēs jums lasīt vairāk 🙂
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish