

Ievads
Informācijas sistēma no lietotāja skatpunkta tiek labi definēta GOST RV 51987 — „automātizēta sistēma, kuras darbības rezultāts ir izejas informācijas sniegšana turpmākai izmantošanai”. Ja aplūkojam iekšējo struktūru, tad būtībā jebkura IS ir sistēma, kurā ir realizēti saistīti algoritmi kodā. Plašā nozīmē Tjūringa-Čērča tēzes ietvaros algoritms (un līdz ar to IS) veic daudzuma ievades datu transformāciju uz daudzumu izejas datu.
Var pat teikt, ka ievades datu transformācijā slēpjas informācijas sistēmas eksistences jēga. Tādējādi IS un visa IS kompleksa vērtība tiek noteikta caur ievades un izejas datu vērtību.
Ņemot to vērā, projektēšana būtu jāsāk ar datu izpēti, pielāgojot arhitektūru un metodes atbilstoši datu struktūrai un nozīmīgumam.
Uzglabātie dati
Galvenais posms sagatavošanās projektēšanai ir visu datu kopu, kuras plānots apstrādāt un uzglabāt, raksturojuma iegūšana. Šie raksturojumi ietver:
— Datu apjoms;
— Informācija par datu dzīves ciklu (jauno datu pieaugums, mūža ilgums, novecojušo datu apstrāde);
— Datu klasifikācija no uzņēmuma pamatbiznesa ietekmes viedokļa (trijās aspektos — konfidencialitāte, integritāte, pieejamība) kopā ar finansiālajiem rādītājiem (piemēram, datu zaudēšanas izmaksas pēdējā stundā);
— Datu apstrādes ģeogrāfija (fiziskā sistēmu atrašanās vieta);
— Regulējošo iestāžu prasības katram datu klasim (piemēram, FZ-152, PCI DSS).
Informācijas sistēmas
Dati ne tikai tiek uzglabāti, bet arī tiek apstrādāti (transformēti) ar informācijas sistēmām. Nākamais solis pēc datu raksturojumu iegūšanas ir maksimāli pilna informācijas sistēmu inventarizācija, to arhitektūras īpatnību, savstarpējām saistībām un prasībām pret infrastruktūru par četriem resursu veidiem:
— Procesoru skaitļošanas jauda;
— Operatīvās atmiņas apjoms;
— Prasības attiecībā uz uzglabāšanas sistēmas apjomu un veiktspēju;
— Datu pārsūtīšanas tīkla prasības (ārējie kanāli, kanāli starp IS komponentēm).
Prasības tam ir jābūt katram pakalpojumam / mikroservisam informācijas sistēmā.
Atsevišķi jānorāda, ka, lai pareizi projektētu, ir nepieciešami dati par informācijas sistēmas ietekmi uz uzņēmuma pamatbiznesu, piemēram, informācija par dīkstāves izmaksām (rubļos stundā).
Draudu modelis
Obligāti jābūt formālai apdraudējuma modelim, no kura plānots aizsargāt datus / pakalpojumus. Šis apdraudējuma modelis ietver ne tikai konfidencialitātes aspektus, bet arī integritāti un pieejamību. Proti, piemēram:
— Fiziša servera bojājums;
— Top-of-the-rack komutatora bojājums;
— Optiskā sakaru kanāla pārtraukums starp datu centriem;
— Darbības traucējumi operatīvajā glabāšanas sistēmā kopumā.
Dažos gadījumos apdraudējuma modeļi tiek izstrādāti ne tikai infrastruktūras komponentiem, bet arī konkrētām informācijas sistēmām vai to komponentiem, piemēram, datu bāzu vadības sistēmas (DVVS) atteice ar loģisku datu struktūras sabrukumu.
Visi lēmumi projekta ietvaros par aizsardzību pret neaprakstītu apdraudējumu ir lieki.
Regulatoru prasības
Ja apstrādājamie dati ietilpst īpašu noteikumu darbības jomā, ko nosaka regulatori, noteikti nepieciešama informācija par datu kopām un apstrādes / glabāšanas noteikumiem.
Mērķrādītāji RPO / RTO
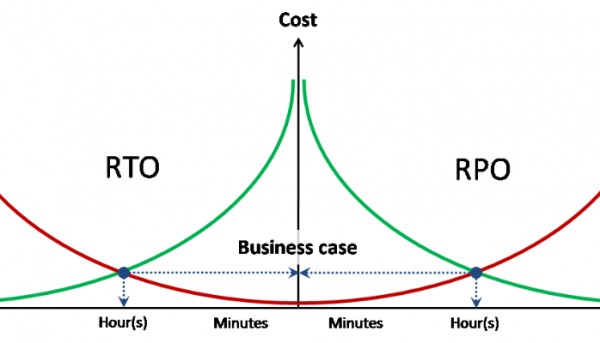
Jebkura veida aizsardzības projektēšana prasa mērķrādītājus attiecībā uz mērķa datu zudumu un mērķa pakalpojuma atjaunošanas laiku katram no aprakstītajiem apdraudējumiem.
Ideālā gadījumā RPO un RTO jābūt saistītiem ar datu zuduma un dīkstāves izmaksām laika vienībā.
Sadale resursu kopās.
Pēc visu sākotnējo ievaddatu apkopošanas pirmais solis ir datu kopu un informācijas sistēmu grupēšana krogā atbilstoši apdraudējuma modeļiem un regulatoru prasībām. Tiek noteikts resursu kopu sadalījuma veids – programmatically uz sistēmas programmatūras līmeņa vai fiziski.
Piemēri:
— Kontūrs, kas apstrādā personas datus, ir pilnībā fiziski atdalīts no pārējām sistēmām;
— Dublējumkopijas tiek glabātas atsevišķā glabāšanas sistēmā.
Tomēr kopām var būt nepilnīga neatkarība, piemēram, tiek noteikti divi skaitļošanas resursu kopas (procesora jauda + operatīvā atmiņa), kas izmanto vienu datu glabāšanas un vienu datu pārsūtīšanas resursu kopu.
Procesora jauda
Abstraktās vajadzības pēc virtuālās datu centra procesora jaudas tiek mērītas kā virtuālo procesoru (vCPU) skaits un to konsolidācijas koeficients uz fiziskajiem procesoriem (pCPU). Šajā konkrētajā gadījumā 1 pCPU = 1 fiziskā procesora kodols (neņemot vērā Hyper-Threading). vCPU skaits tiek summēts visiem noteiktajiem resursu pūļiem (katram no kuriem var būt savs konsolidācijas koeficients).
Konsolidācijas koeficients noslogotām sistēmām tiek iegūts empīriski, balstoties uz jau esošo infrastruktūru, vai pilota instalācijas un slodzes testēšanas laikā. Nenoslogotām sistēmām tiek piemērotas «best practice». Piemēram, VMware norāda, ka vidējais koeficients ir 8:1.
Operatīvā atmiņa
Kopējā pieprasījuma pēc operatīvās atmiņas iegūšana notiek, vienkārši summējot. Operatīvās atmiņas pārsniegšanas izmantošana netiek ieteikta.
Glabāšanas resursi
Glabāšanas resursu prasības tiek iegūtas, vienkārši summējot visu pūļu apjomu un veiktspēju.
Veiktspējas prasības izsaka kā IOPS kombinācijā ar vidējo lasīšanas/ierakstīšanas attiecību un, ja nepieciešams, maksimālo reakcijas laiku.
Atsevišķi jānorāda prasības attiecībā uz pakalpojumu kvalitātes nodrošināšanu (QoS) konkrētiem pūļiem vai sistēmām.
Datu pārsūtīšanas tīkla resursi
Datu pārsūtīšanas tīkla prasības tiek iegūtas, vienkārši summējot visu pūļu caurlaidspēju.
Atsevišķi jānorāda prasības attiecībā uz pakalpojumu kvalitātes nodrošināšanu (QoS) un aizkaves (RTT) konkrētiem pūļiem vai sistēmām.
Resursu prasībās attiecībā uz datu pārsūtīšanas tīklu arī jānorāda prasības attiecībā uz izolāciju un/vai tīkla datu šifrēšanu un vēlamiem mehānismiem (802.1q, IPSec utt.)
Arhitektūras izvēle
Šajā rokasgrāmatā netiek apspriests cits variants, izņemot x86 arhitektūru un 100% serveru virtualizāciju. Tādēļ datorsistēmas arhitektūras izvēle aprobežojas ar serveru virtualizācijas platformas, serveru formfaktora un vispārējām serveru konfigurācijas prasībām.
Svarīgākais punkts izvēlē ir skaidrība, vai izmantot klasisko pieeju ar funkciju sadalīšanu datu apstrādē, glabāšanā un pārsūtīšanā vai konverģento pieeju.
Klasiskā arhitektūra uzņēmums izmanto inteliģentas ārējās datu uzglabāšanas un pārsūtīšanas sistēmas, kamēr serveri nodrošina tikai procesora jaudu un operatīvo atmiņu kopējā fizisko resursu apjomā. Ekstremālā gadījumā serveri kļūst pilnīgi anonīmi, bez saviem diskiem vai pat sistēmas identifikatoriem. Šādā gadījumā tiek izmantota operētājsistēmas vai hipervizora ielāde no iebūvētiem flash datu nesējiem vai no ārējās datu uzglabāšanas sistēmas (boot from SAN).
Klasiskās arhitektūras ietvaros izvēle starp blade un rack vispirms balstās uz šādiem principiem:
— Ekonomiskā efektivitāte (vidēji rack serveri ir lētāki);
— Aprēķinu blīvums (blade ir lielāks);
— Enerģijas patēriņš un siltuma izlaidums (blade ir lielāki rādītāji uz vienību);
— Mērķtiecība un pārvaldāmība (blade kopumā prasa mazāk pūļu lielos uzstādījumos);
— Paplašināmo karšu izmantošana (blade ir ļoti ierobežots izvēles klāsts).
Konverģentā arhitektūra (pazīstama arī kā hiper-konverģentā) ietver apstrādes un datu uzglabāšanas funkciju apvienošanu, kas noved pie serveru iekšējo disku izmantošanas un kā rezultātā atsakšanās no klasisko blade formāta. Konverģentajām sistēmām tiek izmantoti vai nu rack serveri, vai klasteru sistēmas, kas apvieno vairāku blade serveru un vietējo disku funkcionalitāti vienā korpusā.
CPU / Atmiņa
Lai pareizi aprēķinātu konfigurāciju, ir nepieciešams saprast slodzes veidu videi vai katram neatkarīgajam klasterim.
CPU bound – vide, kuras veiktspēju ierobežo procesora jauda. Papildu operatīvā atmiņa neko mainīs veiktspējas ziņā (VM skaits uz servera).
Memory bound – vide, kuras veiktspēja ir ierobežota ar operatīvo atmiņu. Lielāks operatīvās atmiņas daudzums serverī ļauj palaist lielāku VM skaitu.
GB / MHz (GB / pCPU) – vidējā attiecība starp konkrētā slodzes CPU un operatīvās atmiņas patēriņu. To var izmantot, lai aprēķinātu nepieciešamo atmiņas apjomu, balstoties uz noteiktu veiktspēju, un otrādi.
Servera konfigurācijas aprēķins
Vispirms ir jāsaprot visi slodžu veidi un jāpieņem lēmums par dažādu aprēķinu recepšu apvienošanu vai dalīšanu pa dažādiem klasteriem.
Tālāk katram no noteiktajiem klasteriem nosaka GB / MHz attiecību, ja slodze ir iepriekš zināma. Ja slodze nav iepriekš zināma, tomēr ir aptuvens izpratne par procesoru jaudas līmeni, var izmantot standarta vCPU:pCPU koeficientus, lai pārveidotu prasības saimēm fiziskajās.
Katram klasterim vCPU prasību kopumu dala ar koeficientu:
vCPUkopā / vCPU:pCPU = pCPUkopā – nepieciešamais fizisko kodolu skaits
pCPUkopā / 1.25 = pCPUHT – kodolu skaits, ņemot vērā Hyper-Threading
Pieņemsim, ka jāsaskaita klasteris ar 190 kodoliem / 3.5TB RAM. Pieņemam mērķa 50% procesora jaudas slodzi un 75% operatīvās atmiņas.
pCPU
190
CPU izmantošana
50%
Mem
3500
Atmiņas izmantošana
75%
Sokets
Core
Srv / CPU
Srv Atmiņa
Srv / Atmiņa
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
Šajā gadījumā vienmēr izmantosim kārtot uz augšu līdz tuvākajam veselajam skaitlim (=ROUNDUP(A1;0)).
No tabulas kļūst acīmredzams, ka vairāki serveru konfigurācijas ir līdzsvarotas attiecībā uz mērķauditoriju:
— 26 serveri 2*6c / 192 GB
— 19 serveri 2*10c / 256 GB
— 10 serveri 2*18c / 512 GB
Izvēloties no šīm konfigurācijām, nākotnē jāvadās pēc papildu faktoriem, piemēram, siltuma paketes un pieejamā dzesēšanas, jau izmantotajiem serveriem vai izmaksām.
Servera konfigurācijas izvēles īpatnības
Platas VM. Ja nepieciešams izvietot platas VM (salīdzināmas ar 1 NUMA mezglu un vairāk), ieteicams, kur vien iespējams, izvēlēties serveri ar konfigurāciju, kas ļauj šādām VM palikt NUMA mezgla ietvaros. Lielā skaitā plašu VM pastāv risks, ka klastera resursi fragmentējas, un šādos gadījumos izvēlas serverus, kas ļauj izvietot platas VM pēc iespējas blīvāk.
Vienas kļūmes domēna lielums.
Servera lieluma izvēle arī tiek veikta, balstoties uz vienas kļūmes domēna minimizēšanas principu. Piemēram, izvēloties starp:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Ja visi citi faktori ir vienādi, jāpārtrauc otrā varianta izvēle, jo, ja kāds servers izgāžas (vai tiek apkalpots), klastera resursu zudums ir nevis 33%, bet tikai 17%. Tieši tāpat dubultojas VM un IT skaits, uz kuriem ietekmējas avārija.
Klasiskās uzglabāšanas sistēmas veiktspējas aprēķins
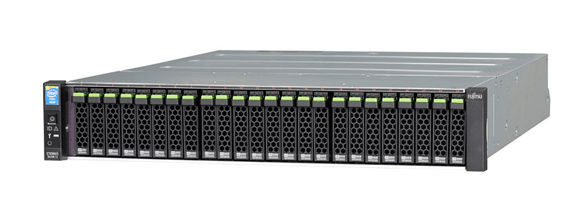
Klasiskā uzglabāšanas sistēma vienmēr tiek aprēķināta, pamatojoties uz sliktāko scenāriju (worst case scenario), izslēdzot operatīvā keša ietekmi un operāciju optimizāciju.
Kā pamatu veiktspējas rādītājiem pieņemam mehānisko veiktspēju no diska (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Tālāk disku skaits disku grupā tiek aprēķināts, izmantojot šādu formulu: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Kur:
— TotalIOPS – kopējā nepieciešamā veiktspēja IOPS no disku grupas
— RW – lasīšanas operāciju procentuālais daudzums
— RAIDpen – RAID soda punkti izvēlētajam RAID līmenim
Vairāk par RAID ierīcēm un RAID soda punktiem var lasīt šeit — un un
Pamatojoties uz iegūto disku skaitu, tiek aprēķināti iespējamie izsoļu varianti, kas atbilst uzglabāšanas jaudas prasībām, tostarp varianti ar vairāku līmeņu uzglabāšanu.
Sistēmu aprēķins, kas izmanto SSD kā uzglabāšanas līmeni, izskatāms atsevišķi.
Hibrīdo sistēmu aprēķinu īpatnības ar Flash Cache
Flash Cache – vispārīgs nosaukums visām patentētajām tehnoloģijām, kas izmanto zibatmiņu kā otro līmeņa kešu. Izmantojot flash kešu, uzglabāšanas sistēma parasti tiek aprēķināta, lai apkalpotu slodzi no magnētiskajiem diskiem, kamēr augstāko slodzi apkalpo kešatmiņa.
Šajā gadījumā ir jāizprot slodzes profils un pieprasījumu lokalizācijas pakāpe uz uzglabāšanas apjoma bloku. Flash kešs ir tehnoloģija slodzēm ar augstu pieprasījumu lokalizāciju un praktiski nav piemērojama vienmērīgi noslogotām apjomiem (piemēram, analītikas sistēmām).
Zema līmeņa / vidēja līmeņa hibrīdo sistēmu aprēķins
Zema un vidēja līmeņa hibrīdās sistēmas izmanto vairāku līmeņu uzglabāšanu ar datu pārvietošanu starp līmeņiem pēc grafika. Šajā procesā labāko modeļu vairāku līmeņu uzglabāšanas bloka izmērs ir 256 MB. Šīs īpašības neļauj uzskatīt vairāku līmeņu uzglabāšanas tehnoloģiju par veiktspējas uzlabošanas tehnoloģiju kā to daudzi maldīgi domā. Vairāku līmeņu uzglabāšana zema un vidēja līmeņa sistēmās ir izmaksu optimizēšanas tehnoloģija uzglabāšanai sistēmām ar izteiktu neviendabīgu slodzi.
Lielapjoma krāšanai vispirms tiek aprēķināta veiktspēja augšējā līmenī, kamēr apakšējā krāšanas līmeņa ietilpība tiek uzskatīta tikai par papildu krāšanas jaudu. Hibrīdās daudzlīmeņu sistēmā ir obligāta flash keša tehnoloģijas izmantošana daudzlīmeņu baseinā, lai kompensētu veiktspējas kritumu pēkšņi aktīvajām datām no apakšējā līmeņa.
SSD izmantošana daudzlīmeņu disku baseinā
SSD izmantošana daudzlīmeņu disku baseinā atšķiras atkarībā no konkrētā ražotāja flash keša algoritmu īstenošanas īpatnībām.
Vispārējā prakse krāšanas politikā SSD līmeņa disku baseinā ir SSD first.
Read Only Flash Cache. Read only flash keša līmenis uz SSD parādās, ja ievērojami lokalizētās rakstīšanas operācijas ir ārpus keša.
Read / Write Flash Cache. Attiecībā uz rakstīšanai domātu flash kešu vispirms tiek noteikts maksimālais keša apjoms, un SSD krāšanas līmenis parādās tikai tad, ja keša izmērs nav pietiekams, lai apkalpotu visu lokalizēto slodzi.
SSD un keša veiktspējas aprēķins tiek veikts katru reizi balstoties uz ražotāja ieteikumiem, bet vienmēr sliktākajā scenārijā.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish