

Turpinot tēmu par lielu datu plūsmu ierakstīšanu, kas tika uzsākta , šajā tiks aplūkoti veidi, kā samazināt hronoloģisko apjomu, kas tiek glabāts
PostgreSQL, un to ietekmi uz servera sniegumu. Runāsim parTOAST iestatījumiem un datu izlīdzināšanu.
„Vidēji” šie paņēmieni ļaus ietaupīt ne pārāk daudz resursu, bet — pilnīgi bez koda modifikācijas. Tomēr mūsu pieredze šajā jomā izrādījās diezgan produktīva, jo uzglabāšana praktiski jebkura uzraudzības sistēma pēc savas būtības ir lielākoties append-only attiecībā uz rakstītajiem datiem. Un, ja jums interesē, kā varētu iemācīt datubāzei rakstīt uz diska ar ātrumu 200MB/s
pusstundā, lūdzu, dodieties uz leju.
Mazi noslēpumi par lieliem datiem , tam regulāri tiek saņemti no žurnāliem teksta paketi..
Un, ņemot vērā, ka , kuru datubāzes mēs uzraudzām, — ir multiplā komponenta produkts ar sarežģītām datu struktūrām, tad pieprasa maksimālas produktivitātes tiek iegūti diezgan Tāpēc katra atsevišķā pieprasījuma vai rezultātu izpildes plāna apjoms, kas nonāk pie mums žurnālā, izrādās „vidēji” pietiekami liels.
Apskatīsim vienas no tabulām struktūru, uz kuru mēs rakstām „neapstrādātos” datus — tas ir, tieši oriģinālais teksts no žurnāla ieraksta:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- sektora atslēga
    date
, data -- pats svarīgākais
    text
, PRIMARY KEY(pack, recno)
);
Tipiska šāda tabula (jau sektorizēta, protams, tādēļ šī ir sektora veidne), kur svarīgākais ir teksts. Dažkārt pietiekami apjomīgs.
Atgādināsim, ka „fiziskais” katras ieraksta lielums PG nevar pārsniegt vienu datu lapu, bet „loģiskais” lielums — ir pavisam cita lieta. Lai ierakstītu laukā apjomīgu vērtību (varchar/text/bytea), tiek izmantota :
PostgreSQL izmanto noteikta izmēra lapas (parasti 8 KB), un neļauj ierakstiem ieņemt vairākas lapas. Tādēļ tieši saglabāt ļoti lielus lauku vērtības nav iespējams. Lai pārvarētu šo ierobežojumu, lielās lauku vērtības tiek saspiestas un/vai sadalītas vairākās fiziskās rindās. Tas notiek nemanāmi lietotājam un lielāko daļu servera koda ietekmē nenozīmīgi. Šī metode ir pazīstama kā TOAST …
Faktiski, katrai tabulai ar "potenciāli lieliem" laukiem automātiski katrai "lielai" rindai segmentēs pa 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Tas nozīmē, ja mums ir jāieraksta rinda ar "lielu" vērtību, data, tad reālais ieraksts notiks ne tikai galvenajā tabulā un tās PK, bet arī TOAST un tās PK.
Samazināt TOAST ietekmi
Bet lielākā daļa ierakstu mums tomēr nav tik lieli, 8KB būtu jāietilpst — kā šo ietaupīt?..
Te mums palīdz atribūts tabulas kolonnā:
- EXTENDED atļauj gan saspiest, gan atsevišķu glabāšanu. Tas ir standarta variants ļoti daudziem datu tipiem, kas ir saderīgi ar TOAST. Vispirms notiek mēģinājums veikt saspiešanu, tad — saglabāšana ārpus tabulas, ja rinda joprojām ir pārāk liela.
- MAIN atļauj saspiest, bet ne atsevišķu glabāšanu. (Faktiski, atsevišķa glabāšana šādos laukos tomēr tiks veikta, bet tikai kā ekstremāls pasākums, kad nav cita veida, kā samazināt rindiņu tā, lai tā ietilptu lapā.)
Faktiski, tas ir tieši tas, kas mums nepieciešams tekstam — maksimāli saspiest, un ja nu nevar tāpat, — izvietot TOAST. To var izdarīt tieši "gaisā", ar vienu komandu:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Kā novērtēt efektu
Kopš katru dienu datu plūsma mainās, mēs nevaram salīdzināt absolūtās skaitliskās vērtības, bet relatīvi jo mazāku daļu mēs ierakstījām TOAST — jo labāk. Bet šeit ir bīstamība — jo lielāks ir mūsu "fiziskais" apjoms katram atsevišķam ierakstam, jo "platāks" kļūst indekss, jo tādēļ ir jāpārklāj lielāks skaits datu lapu.
Sekcija pirms izmaiņām:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Sekcija pēc izmaiņām:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Faktiski, mēs sākām rakstīt TOAST divas reizes retāk, kas atbrīvoja ne tikai disku, bet arī CPU:
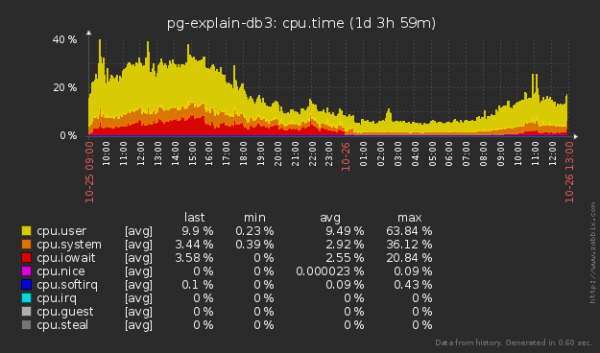
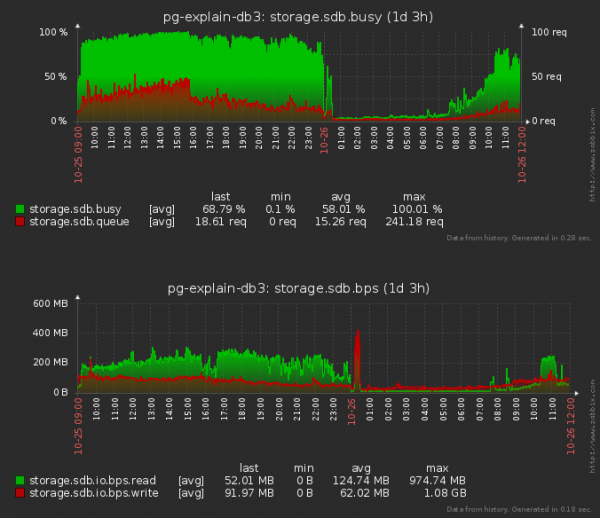
Piezīmēšu, ka mēs tagad arī "lasīt" disku sākām mazāk, ne tikai "rakstīt" — jo, ievietojot ierakstu kādā tabulā, ir jāpārbauda arī daļa no katra indeksa koka, lai noteiktu tās turpmāko pozīciju tajos.
Kam PostgreSQL 11 ir labs
Pēc atjaunināšanas uz PG11 mēs nolēmām turpināt "uzlabot" TOAST un pievēršam uzmanību tam, ka kopš šīs versijas ir pieejama konfigurācijai opcija :
TOAST apstrādes kods darbojas tikai tad, ja rinda, kas jāuzglabā tabulā, ir lielāka par TOAST_TUPLE_THRESHOLD baitiem (parasti tas ir 2 KB). TOAST kods saspiest un/vai pārvietot laukus ārpus tabulas, līdz rindas izmērs kļūst mazāks par TOAST_TUPLE_TARGET baitiem (mainīgs lielums, parasti arī 2 KB) vai samazināt to apjomu vairs nav iespējams.
Mēs nolēmām, ka mūsu dati parasti ir vai nu "ļoti īsi", vai uzreiz "ļoti gari", tāpēc nolēmām ierobežoties ar minimāli iespējamo vērtību:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Apskatīsim, kā jaunās iestatījums ietekmēja diska slodzi pēc pārkonfigurēšanas:
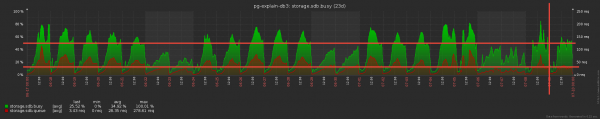
Labi! Vidējā rindas garums uz diska samazinājās aptuveni 1,5 reizes, un diska "aizņemšana" — par 20%! Bet, iespējams, tas kaut kā ietekmēja CPU?
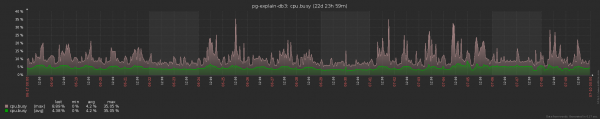
Vismaz sliktāk noteikti nav palicis. Tomēr grūti spriest, ja pat šādi apjomi joprojām nevar palielināt vidējo CPU slodzi virs 5%.
No vietu maiņas summas… summa mainās!
Kā zināms, maznauda krāj rubli, un pie mūsu uzglabāšanas apjomiem apmēram 10TB/mēnesī pat neliela optimizācija var sniegt labu peļņu. Tāpēc mēs pievērsām uzmanību fiziskajai datu struktūrai — kā tieši "sakārtoti" lauki katra ieraksta iekšienē katrai no tabulām.
Jo tas tieši :
Daudzas arhitektūras paredz datu izkārtošanu pēc mašīnu vārdu robežām. Piemēram, 32 bitu x86 sistēmā veseli skaitļi (integer tips, aizņem 4 baitus) tiks izkārtojami pa 4 baitus vārdus, kā arī dubultas precizitātes skaitļi (double precision, 8 baitus). Un 64 bitu sistēmā dubultā vērtība tiks izkārtojama pa 8 baitus vārdiem. Tas ir vēl viens nesaderības iemesls.
Lai noregulētu izmēru, tabulas rinda ir atkarīga no lauku izvietošanas secības. Parasti šis efekts nav ļoti pamanāms, taču dažos gadījumos tas var radīt ievērojamu izmēra palielinājumu. Piemēram, ja lauki, piemēram, char(1) un integer, ir piedāvāti kopā, starp tiem, kā noteikti, pazudīs 3 baiti.
Sāksim ar sintētiskajām modeļiem:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 baiti

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 baiti
Kāpēc pirmajā gadījumā ir par pāris liekiem baitiem? Viss ir vienkārši — 2-baitu smallint tiek noregulēts uz 4-baitu robežas pirms nākamā lauka, bet kad tas ir pēdējais — nav nekā, ko noregulēt.
Teorijā — viss ir labi un lauki var tikt pārvietoti kā vien vēlas. Pārbaudīsim reālos datus, ņemot par pamatu kādu no tabulām, kuras dienas daļa aizņem no 10-15GB.
Sākotnējā struktūra:
CREATE TABLE public.plan_20190220
(
-- Mantošana no tabulas plan:  pack uuid NOT NULL,
-- Mantošana no tabulas plan:  recno smallint NOT NULL,
-- Mantošana no tabulas plan:  host uuid,
-- Mantošana no tabulas plan:  ts timestamp with time zone,
-- Mantošana no tabulas plan:  exectime numeric(32,3),
-- Mantošana no tabulas plan:  duration numeric(32,3),
-- Mantošana no tabulas plan:  bufint bigint,
-- Mantošana no tabulas plan:  bufmem bigint,
-- Mantošana no tabulas plan:  bufdsk bigint,
-- Mantošana no tabulas plan:  apn uuid,
-- Mantošana no tabulas plan:  ptr uuid,
-- Mantošana no tabulas plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Sekcija pēc kolonnas secības maiņas — tieši tie paši lauki, tikai cita secība:
CREATE TABLE public.plan_20190221
(
-- Mantošana no tabulas plan:  dt date NOT NULL,
-- Mantošana no tabulas plan:  ts timestamp with time zone,
-- Mantošana no tabulas plan:  pack uuid NOT NULL,
-- Mantošana no tabulas plan:  recno smallint NOT NULL,
-- Mantošana no tabulas plan:  host uuid,
-- Mantošana no tabulas plan:  apn uuid,
-- Mantošana no tabulas plan:  ptr uuid,
-- Mantošana no tabulas plan:  bufint bigint,
-- Mantošana no tabulas plan:  bufmem bigint,
-- Mantošana no tabulas plan:  bufdsk bigint,
-- Mantošana no tabulas plan:  exectime numeric(32,3),
-- Mantošana no tabulas plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Kopējais sekcijas apjoms tiek noteikts ar ‘faktiem’ un ir atkarīgs tikai no ārējām procesa, tāpēc dalīsim heap izmēru (pg_relation_size) uz ierakstu skaitu tajā — tātad iegūstam vidējo reāli saglabāto ierakstu izmēru:
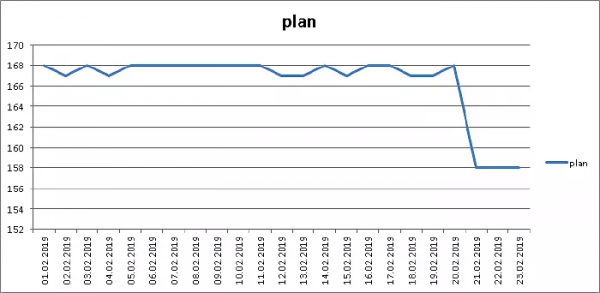
Mīnus 6% apjoma, lieliski!
Bet viss, protams, nav tik rožaini — jo mēs nevaram mainīt lauku kārtību indeksos, un tādēļ „kopumā“ (pg_total_relation_size)…
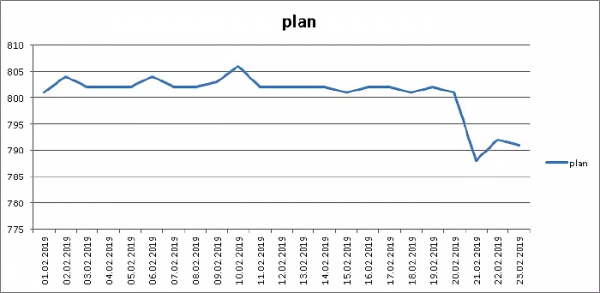
… tomēr arī šeit ietaupījām 1.5%, neizmainot ne rindiņu koda. Tiešām!
Piezīmēšu, ka iepriekš minētais lauku izvietojuma variants — nav fakts, ka tas ir visoptimālākais. Jo daži laukumu bloki negribētos „sadrupināt“ jau no estētiskajiem apsvērumiem — piemēram, pāris (pack, recno), kas ir PK šai tabulai.
Kopumā, „minimālās“ lauku izvietojuma noteikšana — ir diezgan vienkārša „izmēģinājuma“ uzdevums. Tāpēc jūs varat uz saviem datiem iegūt rezultātus pat labākus nekā mums — mēģiniet!
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish