

Vasarā tradicionāli samazinās pircēju aktivitāte un web projektu infrastruktūras izmaiņu intensitāte, saka mums Kapteinis Acīmredzamība. Tāpēc, ka pat IT speciālisti dažreiz dodas atvaļinājumā. Un CTO arī. Gan jau grūtāk tiem, kas paliek savās vietās, bet šoreiz ne par to: iespējams, tieši tāpēc vasara ir labākais periods, lai mierīgi pārdomātu esošo rezerves shēmu un izstrādātu plānu tās uzlabošanai. Un šajā jums noderēs Egora Andrejeva pieredze no , par kuru viņš stāstīja konferencē .
Veidojot rezerves vietas un darbojoties ar rezervēm, pastāv vairākas kārtīgas slazdi, kuriem nav jāiekļūst. Un visā šajā, tāpat kā daudz citur, mūs iznīcina perfekcionisms un… slinkums. Mēs cenšamies visu izdarīt pilnībā ideāli, bet ideāli darīt nav vajadzīgs! Ir jāizdara tikai noteiktas lietas, bet jādara tās pareizi, jāizdara līdz galam, lai tās normāli darbotos.
Failover nav nekādas jautras fanu lietas "lai būtu"; tas ir instruments, kas jāveido tikai vienam mērķim — samazināt dīkstāves laiku, lai pakalpojums, uzņēmums zaudētu mazāk naudas. Un visos rezervēšanas metodēs es piedāvāju domāt turpmākajā kontekstā: kur ir nauda?
Pirmais slazds: kad mēs izveidojam lielas stabilas sistēmas un nodarbojamies ar rezervēšanu — mēs samazinām avāriju skaitu. Tas ir biedējošs malds. Kad mēs nodarbojamies ar rezervēšanu, avāriju skaits, iespējams, palielinās. Un, ja mēs visu izdarīsim pareizi, kopumā mēs samazināsim dīkstāves laiku. Avāriju būs vairāk, bet tās notiks ar mazākām izmaksām. Jo kas ir rezervēšana? — tas ir sistēmas sarežģīšana. Jebkura sarežģīšana ir slikti: mums parādās vairāk skrūvju, vairāk zobratu, vārdu sakot, vairāk elementu — un līdz ar to augstāka iespēja kļūdīties. Un tās tiešām salauzīsies. Un tās sadalīsies biežāk. Vienkāršs piemērs: teiksim, ka mums ir kāda mājas lapa ar PHP, MySQL. Un to steidzami jārezervē.
Nu, ņemam otro platformu un veidojam identisku sistēmu... Grūtības palielinās divas reizes — mums ir divas entitātes. Un vēl mēs virsū uzklājam noteiktu datu pārvietošanas loģiku no vienas platformas uz otru — proti, datu replikācija, statikas kopēšana un tamlīdzīgi. Tātad, replikācijas loģika parasti ir ļoti sarežģīta, tādēļ sistēmas kopējā sarežģītība var būt nevis divas, bet trīs, piecas vai desmit reizes lielāka.
Otrā slazda: kad mēs veidojam patiesi lielas un sarežģītas sistēmas, mēs fantazējam, ko vēlamies iegūt beigās. Un lūk: mēs vēlamies iegūt supersakārtotu sistēmu, kas darbojas pilnīgi bez dīkstāves, pārslēdzas pus sekundē (vēl labāk — uzreiz), un sākam īstenot sapņus realitātē. Taču arī šeit ir nianses: jo mazāks ir vēlamais pārslēgšanās laiks, jo vairāk sarežģīta būs sistēmas loģika. Jo sarežģītāka kļūst šī loģika, jo biežāk sistēma sabojāsies. Un mēs varam nonākt ļoti nepatīkamā situācijā: mēs ar visiem spēkiem cenšamies samazināt dīkstāves laiku, bet patiesībā mēs visu sarežģām, un kad kaut kas notiek nepareizi, dīkstāves laiks galu galā būs garāks. Šeit bieži vien notiek, ka mēs domājam: labāk būtu nevis rezervēt. Labāk lai tā darbojās viena un ar saprotamu dīkstāves laiku.
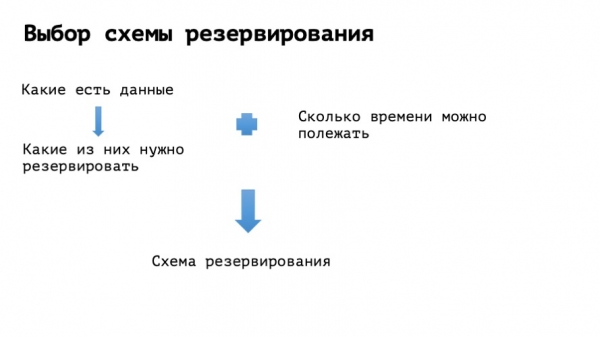
Kā ar to cīnīties? Ir jāpārstāj sev mīt, jāpārstāj sev glaimot, ka tagad veidojam kosmosa kuģi, bet adekvāti jāsaprot, cik ilgi projekts var stāvēt. Un šim maksimālajam laikam mēs izvēlēsimies, kādiem, vispār, paņēmieniem mēs paaugstināsim mūsu sistēmas uzticamību.
Ir īstais laiks „stāstu no dzīves”... protams, par dzīvi.
Piemērs numurs viens
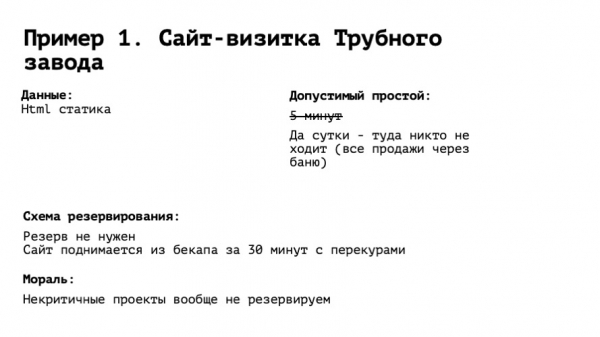
Iedomājieties vizītkarti cauruļu ražošanas uzņēmumam Nr. 1 pilsētā N. Tajā ir lieli burti — CAURUĻU RAŽOŠANAS UZŅĒMUMS NR. 1. Nedaudz zemāk — sauklis: „Mūsu caurules ir visapļāvākās caurules N”. Un apakšā ģenerāldirektora tālruņa numurs un viņa vārds. Mēs saprotam, ka ir jārezervē — tas ir ļoti svarīgi! Sākam saprast, no kā tas sastāv. Html statika — proti, pāris bildes, kur ģenerāldirektors, patiesībā, pie galda pirtī kopā ar savu partneri apspriež kādu nākamo darījumu. Sākam domāt par dīkstāvi. Prātā ienāk: tur jāguļ piecas minūtes, ne vairāk. Un šeit rodas jautājums: cik pārdošanas tika veikts no mūsu vietnes vispār? Cik, cik? Ko nozīmē „nulle”? Un tas nozīmē: jo visas četras darījuma laikā pagājušajā gadā ģenerāldirektors izdarīja pie tā paša galda, ar tiem pašiem cilvēkiem, ar kuriem viņi iet uz pirti sēdēt pie galda. Un mēs saprotam, ka pat ja vietne gulēs dienu — nekas briesmīgs nenotiks.
Balstoties uz ievadiem, ir diena, lai paceltu šo stāstu. Sākam domāt par rezervēšanas shēmu. Un izvēlamies ideālo rezervēšanas shēmu šajā piemērā: mēs rezervēšanu neizmantojam. Visa šī lieta tiek pacelta jebkura administratora pusstundas laikā ar pārtraukumiem. Uzstādīt tīmekļa serveri, ievietot failus — viss. Tas darbosies. Nav nepieciešams sekot, nekam nav jāpievērš īpaša uzmanība. Tātad secinājums no pirmā piemēra ir diezgan acīmredzams: pakalpojumi, kurus nav nepieciešams rezervēt — nav jārezervē.
Otrais piemērs
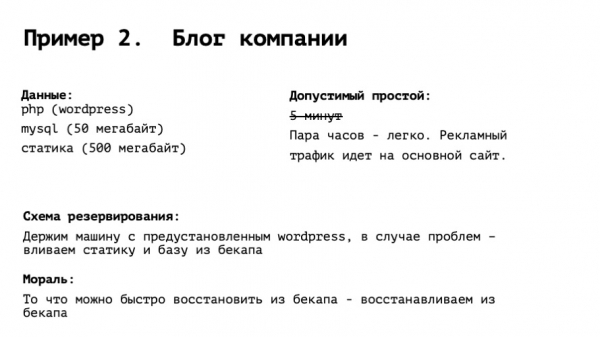
Uzņēmuma blogs: specializētas personas tur raksta ziņas, piemēram, mēs piedalījāmies tādā un tādā izstādē, vai mēs esam izlaidusi jaunu produktu un tā tālāk. Pieņemsim, tas ir standarta PHP ar WordPress, neliela datubāze un nedaudz statikas. Protams, prātā atkal rodas doma, ka nevajag sēdēt bez kustības - 'ne vairāk kā piecas minūtes!', un lūk, tas viss. Bet domāsim tālāk. Ko šis blogs dara? Tur ienāk apmeklētāji no Yandex un Google pēc dažādiem pieprasījumiem, organiskā veidā. Forši. Bet kā tas ir saistīts ar pārdošanu? Izpratne: ne īpaši. Reklāmas trafiks dodas uz galveno vietni, kas ir citā mašīnā. Sākam domāt par bloga rezerves shēmu. Principā, to vajadzētu uzcelt pāris stundu laikā, un tam būtu labi sagatavoties. Saprātīgi būtu ņemt citu datu centrā mašīnu, uz tās uzstādīt vidi, tātad tīmekļa serveri, PHP, WordPress, MySQL, un atstāt to noslēgtā stāvoklī. Kad mēs saprotam, ka viss ir sabojāts, ir jāpaveic divas lietas - jāveic MySQL dumps uz 50 metriem, tas desmitā daļā šķērsos minūti, un jāatjauno daži attēli no dublējuma. Tas arī nebūs liela darīšana. Tādējādi, pusstundas laikā visa šī lieta tiek pacelta. Nekādas replikācijas, vai Dievs pasarg, automātiskā failover. Secinājums: to, ko mēs varam ātri atjaunot no dublējuma - nevajag rezervēt.
Piemērs numur trīs, sarežģītāks
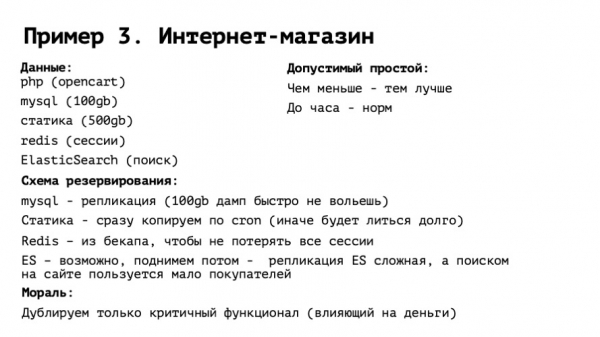
Interneta veikals. PHP ar nedaudz modificētu open heart, MySQL ar ievērojamu datubāzi. Salīdzinoši daudz statikas (jo interneta veikalā ir skaistas HD bildes un viss tāds), Redis sesijām un Elasticsearch meklēšanai. Sākam domāt par dīkstāves laiku. Un šeit, protams, ir acīmredzami, ka diena bez sāpēm interneta veikalam nevar nostāvēt. Jo ilgāk tas stāv, jo vairāk naudas mēs zaudējam. Ir jāpasteidzās. Un cik daudz? Domāju, ja mēs stāvam stundu, tad neviens nenormāls nesevi nejutīs. Jā, mēs kaut ko zaudēsim, bet ja sāksim cītīgi strādāt - tas būs tikai sliktāk. Nosakām pieļaujamo dīkstāves shēmu stundā.
Kā to visu var rezervēt? Mašīna ir nepieciešama jebkurā gadījumā: stunda ir diezgan maz. Mysql: šeit jau nepieciešama replikācija, dzīvā replikācija, jo stundā 100 GB dublējumā, visticamāk, nenonāks. Statika, bildītes: atkal, stundā 500 GB var nepaspēt ienākt. Tātad labāk uzreiz kopēt bildītes. Redis: te ir interesantāk. Redis sesijas turas — vienkārši ņemt un aprakt to mēs nevaram. Jo tas nebūs ļoti labi: visi lietotāji atradīsies bez reģistrācijas, grozi tiks iztukšoti un tā tālāk. Cilvēki būs spiesti atkārtoti ievadīt savu lietotājvārdu un paroli, un daudz cilvēku var atstāt un nepabeigt pirkumu. Atkal, konversija samazināsies. No otras puses, Redis ir tieši aktuāls, ar pēdējiem pieteikušajiem lietotājiem, varbūt arī tas nav nepieciešams. Un labs kompromiss ir ņemt Redis un atjaunot to no dublējuma, vakardienas, vai, ja jums tas tiek veikts katru stundu — stundu vecu. Laimīgā kārtā tā atjaunošana no dublējuma ir viena faila kopēšana. Un visinteresantākā vēsture ir Elasticsearch. Kurš kādreiz ir uzstādījis MySQL replikāciju? Kurš kādreiz ir uzstādījis Elasticsearch replikāciju? Un kam tā pēc tam strādāja normāli? Es vēlos teikt: redzam mūsu sistēmā kādu būtību. Tā šķiet noderīga — bet tā ir sarežģīta.
Grūti tādā ziņā, ka mūsu inženieriem nav pieredzes ar to. Vai nu ir bijusi negatīva pieredze. Vai arī mēs saprotam, ka tā ir vēl diezgan jauna tehnoloģija ar niansēm vai neizstrādātību. Domājam... Ak, dievs, elastīgais arī ir liels, tā atjaunošana no dublējuma arī ilgi aizņem, ko darīt? Saprotam, ka elastīgais mūsu gadījumā tiek izmantots meklēšanai. Un kā tirgo mūsu interneta veikals? Dodamies pie mārketinga speciālistiem, jautājam, no kurienes cilvēki nāk. Viņi atbild: "90% no Yandex tirgus nāk tieši uz produkta kartiņu". Un vai nu pērk, vai nepērk. Tādējādi, meklēšana ir nepieciešama 10% lietotāju. Un turēt elastīgā replikāciju, īpaši starp dažādiem datu centriem dažādās zonās, — tur tiešām ir daudz nianses. Kāds risinājums? Mēs paņemam elastīgo uz rezervētās platformas un neko ar to nedarām. Ja process ilgs, tad mēs to varbūt nākamajā reizē pacelsim, bet tas nav droši. Patiesībā, secinājums ir + - iepriekšējais: pakalpojumi, kas neietekmē naudu, mēs, atkal, nerezervējam. Lai shēma paliktu vienkāršāka.
Piemērs numurs četri, vēl grūtāk
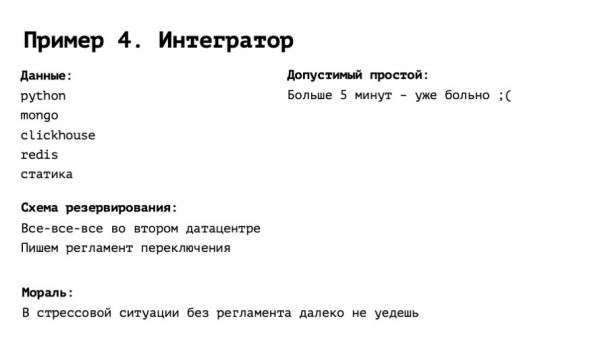
Integrators: ziedu tirdzniecība, taksometru izsaukšana, preču pārdošana, īsumā, jebkas. Nopietna lieta, kas darbojas 24/7 uz lielu lietotāju skaitu. Ar pilnvērtīgu interesantu steku, kur ir interesantas datubāzes, risinājumi, liela slodze un pats galvenais, ja tas pazūd vairāk nekā 5 minūtes, tad tas ir sāpīgi. Ne tikai un ne tik daudz, ka cilvēki nepirks, bet gan tāpēc, ka cilvēki redzēs, ka šī lieta nedarbojas, sadusmosies un var vispār vairs nepienākt.
Labi. Piecas minūtes. Ko mēs ar to darīsim? Šajā gadījumā mēs pieaugušo stilā, par visiem naudiem būvējam īstu rezervētu platformu, ar visu un visu replikāciju, un iespējams, pat automatizējam maksimāli pārslēgšanos uz šo platformu. Un papildus tam ir jāpatur prātā viena svarīga lieta: proti, jāuzraksta pārslēgšanās procedūra. Procedūra, pat ja jums viss un viss ir automatizēts, var būt ļoti vienkārša. No sērijas "uzsākt noteikto ansible scenāriju", "Route 53 jānospiež tāds izvēles rūtiņa" un tā tālāk — bet tam jābūt kādam precīzam darbību sarakstam.
Un, šķiet, viss ir skaidrs. Replikāciju pārslēgt — tas ir pavisam vienkāršs uzdevums, vai nu tā pārvērsīsies pati. Pārrakstīt domēna vārdu DNS — tas ir no tās pašas sērijas. Problēma ir tāda, ka, kad šāds projekts sabrūk, sākas panika, un pat visstiprākie, bārdainie admini var būt tam pakļauti. Bez skaidras instrukcijas "atveriet termināli, izpildiet šeit, mūsu servera adrese joprojām ir tāda pati" piešķirtus 5 minūtes, lai reanimētu, ir grūti izturēt. Un, kad mēs izmantojam šo regulējumu, ir viegli fiksēt dažas izmaiņas infrastruktūrā, piemēram, un attiecīgi mainīt regulējumu.
Nu, ja rezerves sistēma ir ļoti sarežģīta un kādā brīdī mēs esam pieļāvuši kļūdu, tad mēs varam nosist arī mūsu rezerves vietni, un, papildus tam, datus pārvērst ķirbī abās platformās — tas būs ļoti skumji.
Piemērs numur pieci, pilnīgais hardcore.
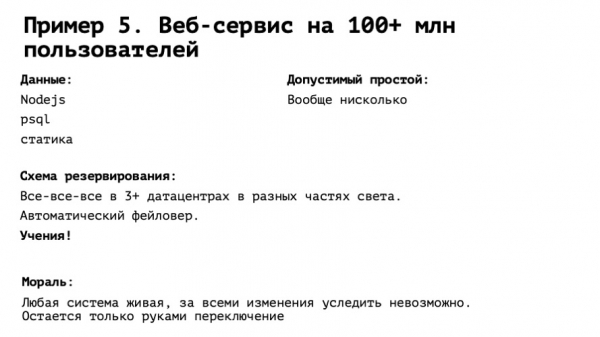
Starptautisks pakalpojums ar simtiem miljonu lietotāju visā pasaulē. Visas laika zonas, kas vien ir, augsta slodze uz maksimumu, gulēt nevienam nevajadzētu. Minūte — un viss būs skumji. Ko darīt? Rezervēt, atkal pilnā apjomā. Izpildījām visu, par ko runāju iepriekšējā piemērā, un vēl nedaudz vairāk. Ideāls pasaules, un mūsu infrastruktūra — tā ir pēc visiem DevOps principiem IaaC. Tātad viss ir git, un tikai nospiediet pogu.
Ko trūkst? Viena — mācības. Bez tām nevar. Šķiet, ka mums viss ir ideāli, viss ir mūsu kontrolē. Nospiežam pogu, viss notiek. Pat ja tā ir — mēs saprotam, ka tā nenotiek — mūsu sistēma mijiedarbojas ar citām sistēmām. Piemēram, tas ir DNS no Route 53, S3 glabātavas, integrācija ar kādiem API. Viss paredzēt šajā teorētiskajā eksperimentā mēs nevarēsim. Un līdz brīdim, kad mēs reāli neizslēdzam slēdzeni — neuzzināsim, vai tā darbosies vai nē.
Uz šo, droši vien, viss. Neizlaidiet un nepārspīlējiet. Un lai ar jums būtu uptime!
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish