

RAID algoritmi tika ieviesti sabiedrībai tālajā 1987. gadā. Joprojām tie ir vispieprasītākā datu aizsardzības un piekļuves paātrināšanas tehnoloģija informācijas uzglabāšanas jomā. Tomēr IT tehnoloģijai, kas pārsniegusi 30 gadu robežu, tas vairāk ir vecums nekā nobriedums. Iemesls tam ir progresu, kas neizbēgami nes jaunas iespējas. Laikmetā, kad faktiski nebija citu uzglabāšanas ierīču, izņemot HDD, RAID algoritmi ļāva visefektīvāk izmantot esošos krātuves resursus. Tomēr ar SSD parādīšanos situācija ir radikāli mainījusies. Tagad RAID darbībā ar SSD ir jau „ķīlis” to veiktspējā. Tāpēc, lai atklātu pilnu SSD ātruma potenciālu, vienkārši nepieciešama pavisam cita pieeja to izmantošanai.
Papildus acīmredzamajām atšķirībām starp HDD un SSD darba principos, abiem šo veida nesējiem ir vēl viena svarīga iezīme: jebkurš cietais disks var pārrakstīt jebkādus datus ar granularity vienā blokā (šobrīd tas visbiežāk ir 4KB). Salīdzinājumā ar SSD, pārrakstīšanas process ir daudz sarežģītāka procedūra:
- Mainītie dati tiek kopēti jaunā vietā. Šajā procesā granularity ir tajā pašā blokā, bet tas sastāv no vairākām lapām un to izmērs ir 256KB – 4MB. Tas nozīmē, ka, mainot tos pašus 4KB, ir nepieciešams pārvietot arī visus blakus esošos lapas, kas veido vienotu bloku.
- „Vecie” bloki tiek atzīmēti kā neizmantoti, lai vēlāk tos dzēstu ar „atkritumu savācēju” (Garbage Collector).
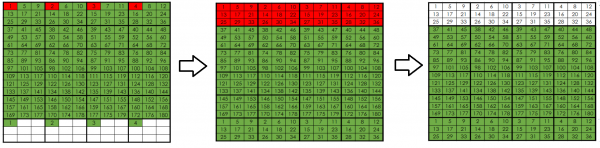
Secīga rakstīšana/pārrakstīšana uz SSD
Secīgas rakstīšanas/pārrakstīšanas gadījumā šī SSD darbības iezīme nespe spēlē nozīmīgu lomu veiktspējas ziņā, jo blokiem ir blakus un „atkritumu savācējs” lieliski tiek galā ar savu darbu fona režīmā. Bet reālajā dzīvē, un jo īpaši uzņēmumu segmentā, SSD visbiežāk tiek izmantota nejauša piekļuve datiem. Un šie dati tiek rakstīti nejaušās vietās uz uzglabātājiem.
Jo vairāk datu tiek ierakstīts SSD, jo grūtāk strādāt «atkritumu» kolektoram, jo pieaug fragmentācija. Rezultātā iestājas brīdis, kad datu dzēšanas process vairs nav «fonā»: SSD veiktspēja būtiski samazinās, jo ievērojamu daļu no tās aizņem atkritumu kolektors.
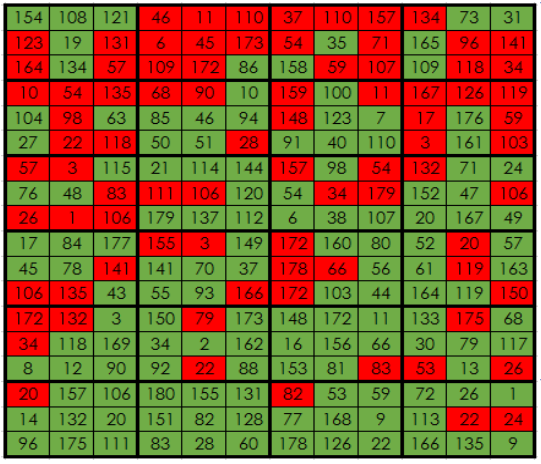
Reālā datu lokalizācija SSD ikdienas lietošanā
Lai ilustrētu atkritumu kolektora darba ietekmes efektu atkarībā no ieraksta režīma uz datu nesēju, var veikt vienkāršus testus: secīgais un nejaušais ieraksts blokos 4KB uz 100GB datu nesēja. (Avots - uzņēmums )
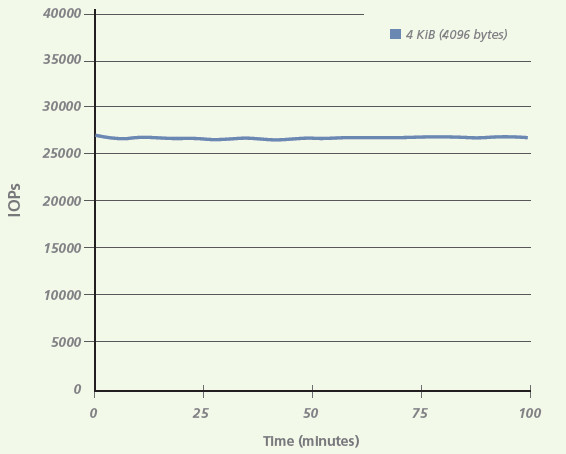
Veiktspēja secīgajā ierakstā
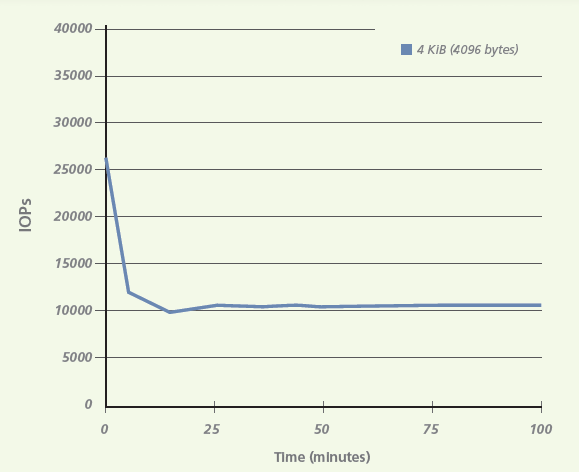
Veiktspēja nejaušajā ierakstā
Kā redzams testos, veiktspējas kritums var sasniegt vairāk nekā divas reizes. Un tas ir tikai viens datu nesējs. Ja tiek izmantots SSD RAID grupā, pārrakstīšanas operāciju skaits ievērojami palielinās, pateicoties darbam ar parity.
Pavisam, pateicoties šīm SSD darba īpatnībām, pastāv tāds parametrs kā ieraksta pastiprinājums (write amplification). Tas ir - attiecība starp datu apjomu, kas ierakstīts datu nesējā, un apjomu, ko patiesībā nosūtījis host. Un vispopulārākajam RAID5 šis koeficients ir ~3.5.
Tādējādi sistēmas ar klasisko RAID pamatā izmanto SSD tikai ~10% no to faktiskās ātruma un slikti mērogojas attiecībā uz veiktspēju, palielinot datu nesēju skaitu vairāk nekā desmit.
Tāpat jāatzīmē, ka liekie ierakstu operācijas ne tikai samazina SSD veiktspēju, bet arī samazina tā nebeidzamo resursu, tādējādi samazinot datu nesēja kalpošanas laiku.
, kas ir visu AccelStor produktu kodols, ir izstrādāta kā alternatīva klasiskajiem RAID algoritmiem, strādājot ar SSD. Tehnoloģijas inovativitāti apliecina dažādi patenti un balvas (tostarp Flash Memory Summit 2016), kā arī neatkarīgo testu rezultāti (piemēram, SPC1).
Būtība sastāv no visu ienākošo rakstu pieprasījumu pārvēršanas, galvenokārt random tipa, blokos, kas pēc iespējas vairāk atbilst secīgas rakstīšanas režīmam attiecībā uz glabāšanu. Rezultātā rakstīšana SSD tiek veikta viskomfortablākajā režīmā, bet galīgā veiktspēja pārsniedz jebkuras sistēmas ar klasisko RAID.
Visi SSD AccelStor sistēmās tiek sadalīti divās simetriskās grupās FlexiRemap®. Grupas izmērs ir atkarīgs no modeļa un sastāv no 5-11 glabātājiem. Par atpalicību grupā tiek izmantota paritāte līdzīgi RAID5. Abas grupas tiek izmantotas kopā, veidojot kopējo uzglabāšanas telpu. Tādējādi galīgā atpalicība būs līdzīga RAID50 masīvam, kas sastāv no divām grupām: sistēma spēj izturēt divu SSD atteici, bet ne vairāk kā vienu katrā FlexiRemap® grupā.
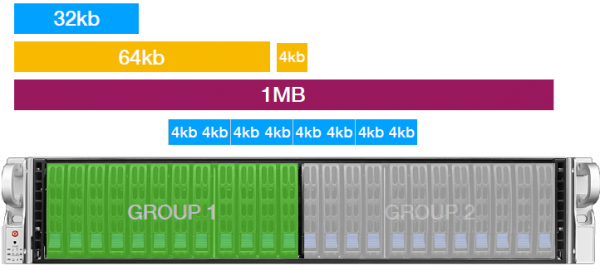
Visi ienākošie rakstu pieprasījumi tiek sadalīti 4KB blokos, kuri round robin režīmā tiek ierakstīti abās FlexiRemap® grupās. Tajā pašā laikā sistēma pastāvīgi uzskaita ierakstīto bloku pieprasījuma intensitāti, cenšoties, kad tos mainot, ierakstīt līdzīgus blokos pēc iespējas tuvāk viens otram. Tas rada virtuālu līdzību tirēšanai, ja izsakāmies uz SĒH terminoloģiju. Šādā gadījumā tiek ievērojami atvieglota „atkritumu” kolektora darbs: jo neizmantotie bloki pastāvīgi atradīsies blakus.
Jāatzīmē, ka atšķirībā no konkurentu ražojumiem neizmanto ieejas pieprasījumu kešatmiņas funkcionalitāti kontrolleru operatīvajā atmiņā. Visi ienākošie datu bloki tiek nekavējoties ierakstīti SSD. Host iegūst apstiprinājumu par veiksmīgu rakstīšanu tikai pēc fiziskās datu novietošanas uz glabātājiem. RAM tiek glabātas tikai bloku novietojuma tabulas SSD ātrākai piekļuvei un noteikšanai, kur ierakstīt nākamo datu bloku. Protams, drošības nolūkā šo tabulu kopijas atrodas arī pašos nesējos. Tā rezultātā AccelStor sistēmām nav nepieciešama nekāda kešatmiņas aizsardzība, piemēram, akumulatora/kondektora veidā (tomēr iespēja izveidot savienojumu ar UPS pastāv — „mīkstajam” izslēgumam problēmu gadījumā ar elektrību).
Pateicoties šādam pieejai datu ieraksta organizēšanā, „atkritumu” vācējs patiešām spēj darboties fonā, nesniedzot būtisku ietekmi uz glabātuves ātrumu, kas galu galā ļauj sistēmai utilizēt līdz 90% SSD veiktspējas. Tieši šis ir augsto IOPS rādītāju pamatā AccelStor sistēmās, kas atbalsta All Flash un izmanto RAID algoritmus.
Arī svarīga tehnoloģijas FlexiRemap® iezīme ir būtisks rakstīšanas operāciju samazinājums SSD. Tādējādi rakstīšanas koeficients (write amplification) AccelStor sistēmās ir tikai 1.3, kas, izsakoties vispārēji, nozīmē glabātuves kalpošanas laika palielinājumu salīdzinājumā ar RAID5 vairāk nekā 2.5 reizes!
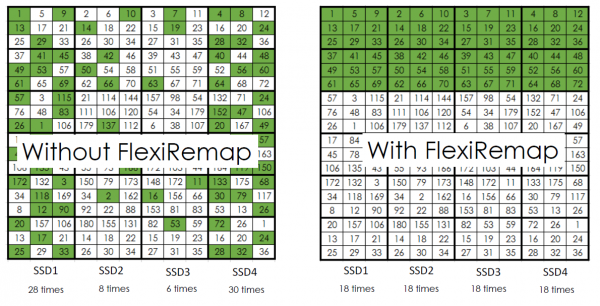
Pateicoties nepārtrauktai sistēmas kontrolei par datu izvietošanu SSD, visi glabātāji nolietojas vienādi. Šāda pieeja ļauj prognozēt to kalpošanas laiku un savlaicīgi brīdināt administratoru par rakstīšanas resursu izsīkšanu.
Ir skaidrs, ka SSD var atteikties darboties. Šādā gadījumā sistēma nekavējoties sāks atjaunošanu uz vienu no hot spare diskiem. Tajā pašā laikā FlexiRemap® grupa, kas atrodas degraded stāvoklī, pāriet uz „tikai lasīšanas” režīmu, kamēr visi rakstīšanas pieprasījumi tiek novirzīti uz otro grupu. Šāda aizsardzības mehānisma mērķis ir paātrināt atjaunošanas operāciju un samazināt risku, ka vēl viens glabātājs no tās pašas grupas izies no ierindas. Galu galā, nav noslēpums, ka atjaunošanas laikā visi glabātāji grupā piedzīvo paaugstinātu slodzi sakarā ar lasīšanas, rakstīšanas un atjaunošanas operāciju interferenci uz hot spare. Tādējādi palielinās arī cita diska atteikšanās varbūtība. Un jo vairāk rakstīšanas operāciju, jo ilgāk tiks veikta atjaunošana.
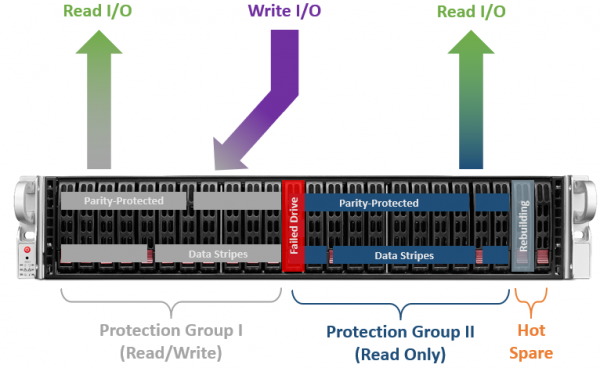
Pabeidzot atjaunošanas procesu un atgriežot FlexiRemap® grupu normālā stāvoklī, var rasties neliels ierakstīšanas resursa nelīdzsvarotība starp abām grupām. Tādēļ, lai to izlīdzinātu, turpmākas rakstīšanas operācijas biežāk notiks uz atjaunotās grupas (protams, ņemot vērā, lai gala veiktspēja sistēmā nebūtu stipri cietusi).
Palielināt All Flash sistēmu, kas balstītas uz RAID algoritmiem, veiktspēju virs dažām vērtībām (~280K IOPS@4K nejauša rakstīšana) nav iespējams pat izmantojot sarežģītas kešatmiņas sistēmas. Tehnoloģija FlexiRemap®, pateicoties pilnīgi citai pieejai glabāšanas telpas organizēšanai, ne tikai viegli pārvar šo slieksni, bet arī vienlaikus vairākkārt palielina SSD kalpošanas laiku. Tādējādi sistēmas ir nopietnas priekšrocības starp All Flash masīviem daudzos aspektos (IOPS/$, GB/$, TCO, ROI), padarot tos par ideāliem kanditātiem galvenajām pozīcijām klientu datu centros, lai risinātu resursu prasīgas uzdevumus.
Avots: habr.com
