

Sveiki, Habrā! Tradicionāli turpinām dalīties ar interesantu materiālu pirms jauno kursu uzsākšanas. Šodien īpaši jums esam tulkojuši rakstu par Google Cloud Spanner, saistot to ar kursa uzsākšanu. .
Sākotnēji publicēts .
Kā uzņēmums, kas piedāvā daudzus mākonī balstītus POS risinājumus mazumtirgotājiem, restorāniem un tiešsaistes pārdevējiem visā pasaulē, Lightspeed izmanto vairākus dažādus datubāzu platformu veidus, lai apstrādātu daudzus transakciju, analītiskos un meklēšanas gadījumus. Katra no šīm datubāzu platformām ir ar savām priekšrocībām un trūkumiem. Tādējādi, kad Google ieviesa tirgū Cloud Spanner — solīgas funkcijas, kas nav redzētas relāciju datubāzu pasaulē, piemēram, praktiski neierobežota horizontālā mērogojamība un 99,999% pakalpojumu līmenis (SLA) — mēs nevarējām palaist garām iespēju to iegūt savās rokās!
Lai sniegtu visaptverošu pārskatu par mūsu pieredzi ar Cloud Spanner, kā arī vērtēšanas kritērijiem, kurus mēs izmantojām, mēs apskatīsim šādas tēmas:
- Mūsu vērtēšanas kritēriji
- Cloud Spanner divos vārdos
- Mūsu vērtējums
- Mūsu secinājumi
1. Mūsu vērtēšanas kritēriji
Pirms iegremdējamies Cloud Spanner funkcijās, tās līdzībās un atšķirībās ar citiem risinājumiem tirgū, vispirms runāsim par galvenajiem lietošanas gadījumiem, kurus mēs uzsvērām, apsverot, kur izvietot Cloud Spanner mūsu infrastruktūrā:
- Kā (dominējošs) tradicionālā SQL datubāzu risinājuma aizstājējs
- Kā OLTP risinājums ar OLAP atbalstu
Piezīme: Lai vienkāršotu un atvieglotu salīdzināšanu, šis raksts salīdzina Cloud Spanner ar MySQL variantiem GCP Cloud SQL un Amazon AWS RDS risinājumu ģimenē.
Cloud Spanner izmantošana kā tradicionālā SQL datubāzu risinājuma aizstājējs
Vide tradicionālās datubāzēs, kad pieprasījumu atbildes laiks tuvojas vai pat pārsniedz iepriekš noteiktās lietojumprogrammas slodzes robežas (galvenokārt palielināto lietotāju un/vai pieprasījumu dēļ), pastāv vairāki veidi, kā samazināt atbildes laiku līdz pieņemamiem līmeņiem. Tomēr lielākā daļa no šiem risinājumiem prasa roku iejaukšanos.
Piemēram, pirmais solis, kas jādara, ir aplūkot dažādus datu bāzu parametrus, kas saistīti ar veiktspēju, un pielāgot tos tā, lai tie vislabāk atbilstu lietojumprogrammu izmantošanas modeļiem. Ja tas izrādīsies nepietiekami, var izvēlēties datu bāzes vertikālo vai horizontālo paplašināšanu.
Vertikālā paplašināšana nozīmē servera instance atjaunināšanu, parasti pievienojot vairāk procesoru/ kodolu, lielāku operatīvo atmiņu, ātrāku uzglabāšanu utt. Papildu aparatūras resursu pievienošana palielina datu bāzes veiktspēju, ko galvenokārt mēra darījumu skaitā sekundē un darījumu aizturi OLTP sistēmām. Relāciju datu bāzu sistēmas (kuras izmanto vairāku pavedienu pieeju), piemēram, MySQL, labi paplašinās vertikāli.
Šai pieejai ir vairāki trūkumi, bet acīmredzamākais ir maksimālais servera izmērs tirgū. Kad ir sasniegts vislielākā servera instance limits, vienīgā iespēja ir horizontālā paplašināšana.
Horizontālā paplašināšana ir pieeja, kurā klasteriem pievieno vairāk serveru, lai ideāli lineāri palielinātu veiktspēju ar palielinātu serveru skaitu. Vairākums tradicionālās datubāzu sistēmu slikti paplašinās horizontāli vai vispār neprasa paplašināšanu. Piemēram, MySQL var horizontāli paplašināt lasīšanas darbībām, pievienojot slave-nolasītājus, bet nevar horizontāli paplašināt rakstīšanas darbībām.
Savukārt, pateicoties savai būtībai, Cloud Spanner var viegli paplašināties horizontāli ar minimālu iejaukšanos.
Pilnībā funkcionāla DB kā pakalpojums jānovērtē no dažādiem aspektiem. Mūsu pamats bija populārākā mākoņa datu bāze — Google GCP Cloud SQL un Amazon AWS RDS. Mūsu novērtējums koncentrējās uz šādām kategorijām:
- Funkciju salīdzināšana: SQL apjoms, DDL, DML; savienojumu bibliotēkas / savienotāji, darījumu atbalsts utt.
- Izstrādes atbalsts: izstrādes un testēšanas vienkāršība.
- Administratīvās atbalsta funkcijas: instanču pārvaldība – piemēram, mērogošana uz augšu/uz leju un instanču uzlabojums; SLA, dublēšana un atjaunošana; drošība/kontrolēšanas piekļuve.
Cloud Spanner izmantošana kā OLTP risinājums ar OLAP atbalstu
Lai gan Google acīmredzami nevēlas apgalvot, ka Cloud Spanner ir paredzēts analītiskai apstrādei, tam ir dažas kopīgas īpašības ar citām sistēmām, piemēram, Apache Impala & Kudu un YugaByte, kas paredzētas OLAP darba slodzēm.
Pat ja pastāvētu tikai neliela iespēja, ka Cloud Spanner ir iekļaujis horizontāli mērogojamu HTAP (hibrīdās transakciju/analītiskās apstrādes) motoru ar (vairāk vai mazāk) noderīgu OLAP funkcionalitāti, mēs domājam, ka tas būtu pelnījis mūsu uzmanību.
Ņemot to vērā, mēs apskatījām šādas kategorijas:
- Datu ielāde, indeksēšana un partizēšanas atbalsts
- Vaicājumu veiktspēja un DML
2. Cloud Spanner divos vārdos
Google Spanner ir klastera relāciju datu bāzes pārvaldības sistēma (RDPS), ko Google izmanto vairāku savu pakalpojumu nodrošināšanai. Google padarīja to publiski pieejamu Google Cloud Platform lietotājiem 2017. gada sākumā.
Šeit ir daži Cloud Spanner atribūti:
- Spēcīga sinhronizēta, mērogojama klastera RDPS: izmanto aparatūras laika sinhronizāciju, lai nodrošinātu datu saskaņotību.
- Atbalsts starp tabulām veiktajiem darījumiem: darījumi var aptvert vairākas tabulas, neierobežojoties tikai ar vienu tabulu (atšķirībā no Apache HBase vai Apache Kudu).
- Tabulas, kas balstītas uz primāro atslēgu: visām tabulām jābūt deklarētai primājai atslēgai (PA), kas var sastāvēt no vairākiem tabulas kolonnām. Tabulas dati tiek glabāti PA secībā, kas padara tos ļoti efektīvus un ātrus meklēšanai pēc PA. Kā citām sistēmām, kas balstītas uz PA, ieviešanai jābūt modeļētai, ņemot vērā iepriekš izstrādātus lietošanas gadījumus, lai panāktu .
- Mainītās tabulas: tabulām var būt fiziskas atkarības viena no otras. Apakštabulas rindas var tikt sasaistītas ar vecāku tabulas rindām. Šāda pieeja paātrina attiecību meklēšanu, kas var tikt definēta datu modelēšanas posmā, piemēram, kopējo klientu un viņu rēķinu novietojumā.
- Indeksi: Cloud Spanner atbalsta sekundāros indeksus. Indekss sastāv no indeksētajiem laukiem un visiem PK laukiem. Ja vēlas, indekss var saturēt arī citus neindeksētus laukus. Indekss var būt savīts ar vecāku tabulu, lai paātrinātu pieprasījumus. Indeksam tiek piemēroti vairāki ierobežojumi, piemēram, maksimālais papildu lauku skaits, kas saglabāts indeksā. Arī pieprasījumi caur indeksošanas ceļiem var nebūt tik tieši kā citās RDBMS.
„Cloud Spanner automātiski izvēlas indeksu tikai retos gadījumos. Īpaši, ja pieprasījums pieprasa kādus laukus, kas nav saglabāti ».
- Pakalpojuma līgums (SLA): izvietojums vienā reģionā ar SLA 99,99%; vairāku reģionu izvietojumi ar SLA 99,999%. Lai arī pats pakalpojuma līgums ir tikai vienošanās, nevis kāda garantija, man šķiet, ka Google darbiniekiem patiešām ir precīzi dati, lai izdarītu šādu nopietnu apgalvojumu. (Piemēram, 99,999% nozīmē 26,3 sekundes pakalpojuma nepieejamības mēnesī.)
- Vairāk:
Piezīme: Apache Tephra projekts pievieno paplašinātu darījumu atbalstu Apache HBase (tagad arī īstenots Apache Phoenix kā beta versija).
3. Mūsu novērtējums
Tātad, mēs visi esam izlasījuši Googles apgalvojumus par Cloud Spanner priekšrocībām — gandrīz neierobežota horizontālā mērogojamība, saglabājot augstu saskaņotību un ļoti augstu SLA. Lai arī šos prasījumus ir ārkārtīgi grūti sasniegt, mūsu mērķis nebija tos apstrīdēt. Tā vietā koncentrēsimies uz citiem aspektiem, kas satrauc lielāko daļu datu bāzu lietotāju: lietošanas ērtumu.
Mēs novērtējām Cloud Spanner kā Sharded MySQL aizstājēju.
Google Cloud SQL un Amazon AWS RDS, divas populārākās OLTP datubāzes mākoņu tirgū, piedāvā ļoti plašu funkciju kopumu. Tomēr, lai paplašinātu šīs datubāzes ārpus vienas mezgla lieluma, jums ir jāveic aplikāciju sadalīšana. Šāds pieejas veids rada papildu sarežģījumus gan aplikācijām, gan administrēšanai. Mēs aplūkojām, kā Spanner iederas scenārijā, apvienojot vairākus segmentus vienā instancē, un kādas funkcijas (ja tādas pastāv), iespējams, nāksies upurēt.
Atbalsts SQL, DML un DDL, kā arī savienotājs un bibliotēkas?
Pirmkārt, uzsākot darbu ar jebkuru datubāzi, ir jāizveido datu modelis. Ja domājat, ka varat pieslēgt JDBC Spanner pie sava iecienītā SQL rīka, jūs atklāsiet, ka varat veikt pieprasījumus uz saviem datiem, bet nevarat to izmantot tabulu izveidei vai izmaiņām (DDL) vai jebkurai ievietošanas/atjaunināšanas/dzēšanas operācijai (DML). Oficiālais Google JDBC neatbalsta nevienu no tiem.
«Pašlaik draiveri neatbalsta DML vai DDL operatorus».
Spanner dokumentācija
Ar GCP konsoli situācija nav labāka — varat izsūtīt tikai SELECT pieprasījumus. Par laimi, ir pieejams DML un DDL atbalstošs JDBC draiveris no kopienas, kas iekļauj transakcijas. . Lai gan šis draiveris ir ārkārtīgi noderīgs, Google trūkums ar savu JDBC draiveri pārsteidz. Par laimi, Google piedāvā diezgan plašu klientu bibliotēku atbalstu (balstoties uz gRPC): C#, Go, Java, node.js, PHP, Python un Ruby.
Tehnoloģiski obligātā Cloud Spanner pielāgoto API izmantošana (DML un DDL trūkuma dēļ JDBC) ierobežo ar to saistītos koda apgabalus, piemēram, savienojumu baseinus vai datubāzes saistīšanas ietvarus (piemēram, Spring MVC). Parasti, izmantojot JDBC, varat brīvi izvēlēties mīļāko savienojumu baseinu (piemēram, HikariCP, DBCP, C3PO utt.), kas ir pārbaudīts un labi darbojas. Pielāgoto API Spanner gadījumā mums jāpaļaujas uz ietvariem/saistīšanas/pakalpojumu baseiniem, kurus esam radījuši paši.
Sānu veidošana, kas orientēta uz primāro atslēgu (PK), ļauj Cloud Spanneri būt ļoti ātram datu piekļuves gadījumos, izmantojot PK, bet arī rada dažas problēmas ar vaicājumiem.
- Jūs nevarat atjaunināt primārā atslēga vērtību; vispirms jāizdzēš ieraksts ar oriģinālo PA un jāievieto tas atkārtoti ar jauno vērtību. (Tas ir līdzīgi citām PA orientētām datubāzēm/uzglabāšanas mehānismiem.)
- Visiem UPDATE un DELETE operatoriem jānorāda PA WHERE, tādēļ nevar būt tukšiem DELETE all operatoriem — vienmēr jābūt apakšvaicājumam, piemēram: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Trūkst autoinkrementācijas opcijas vai kaut kā līdzīga, kas nosaka secību PA laukam. Lai tas darbotos, attiecīgā vērtība jāsagatavo lietojumprogrammas pusē.
Otrie indeksi?
Google Cloud Spanner nodrošina iebūvētu atbalstu otrajiem indeksi. Tas ir ļoti jauks papildinājums, kas ne vienmēr ir pieejams citās tehnoloģijās. Apache Kudu šobrīd vispār neatbalsta otros indeksus, bet Apache HBase tie netiek atbalstīti tieši, bet var tikt pievienoti caur Apache Phoenix.
Indekus Kudu un HBase var modelēt kā atsevišķu tabulu ar atšķirīgu primāro atslēgu sastāvu, bet atomaritāte operācijām, kas tiek veiktas ar vecāku tabulu un saistītajām indeksu tabulām, jādara lietojumprogrammas līmenī un nav triviala pareizā īstenojumā.
Kā minēts Cloud Spanner apskatā, tā indeksiem var būt atšķirības no MySQL indeksiem. Tādēļ raksturojot vaicājumus un profilu, ir jābūt īpaši piesardzīgiem, lai nodrošinātu, ka tiek izmantots atbilstošs indekss, kur tas nepieciešams.
Skati?
Ļoti populārs un noderīgs objekts datubāzē ir skati. Tie var būt noderīgi daudzos lietošanas gadījumos; divi mani favorīti ir loģiskās abstrakcijas līmenis un drošības līmenis. Diemžēl Cloud Spanner NEatbalsta skatus. Tomēr tas mūs ierobežo tikai daļēji, jo piekļuves tiesībām nav kolonnu līmeņa detalizācijas, kur skati varētu būt pieņemams risinājums.
Cloud Spanner dokumentācijā sadaļā, kur detalizēti aprakstītas kvotas un ierobežojumi (), ir ir, jo vidū ir viena, kas var būt problemātiska dažām lietotnēm: Cloud Spanner noklusējuma iestatījumos ir ierobežojums līdz 100 datubāzēm vienā instancē. Acīmredzami tas var kļūt par nopietnu šķērsli datubāzei, kas paredzēta mērogošanai uz vairāk nekā 100 datubāzēm. Par laimi, pēc sarunas ar mūsu Google tehnisko pārstāvi mēs uzzinājām, ka šo ierobežojumu var palielināt praktiski līdz jebkurai vērtībai, izmantojot Google atbalsta dienestu.
Atbalsts izstrādei?
Cloud Spanner piedāvā diezgan pieklājīgu programmēšanas valodu atbalstu darbam ar tās API. Oficiāli atbalstītās bibliotēkas ir C#, Go, Java, node.js, PHP, Python un Ruby. Dokumentācija ir pietiekami detalizēta, taču, kā tas ir ar citām novatoriskām tehnoloģijām, kopiena ir diezgan maza salīdzinājumā ar populārākajām datubāzu tehnoloģijām, kas var palielināt laiku, kas nepieciešams, lai atrisinātu mazāk izplatītas lietojuma vai problēmas.
Kā tad ir ar lokālās izstrādes atbalstu?
Mēs neatradām veidu, kā izveidot Cloud Spanner instanci lokālā vidē. Vislabākais, ko mēs ieguvām, bija Docker attēls. , kas principā ir līdzīgs, taču praksē ir ievērojami atšķirīgs. Piemēram, CockroachDB var izmantot PostgreSQL JDBC. Tā kā izstrādes videi jābūt pēc iespējas tuvāk darbībai, Cloud Spanner nav ideāls, jo jāpaļaujas uz pilnu Spanner instance. Lai samazinātu izmaksas, varat izvēlēties instanci vienā reģionā.
Administrēšanas atbalsts?
Izveidot Cloud Spanner instanci ir ļoti vienkārši. Jūsu jāizvēlas tikai starp multimodālā vai viena reģiona instanci, jānorāda reģions(-i) un mezglu skaits. Mazāk nekā minūtes laikā instancia tiks palaista un gatava darbam.
Dažas pamata metrikas ir tieši pieejamas Spanner lapā Google konsolē. Detalizētākus skatus var iegūt caur Stackdriver, kur varat arī iestatīt metrikas slieksņus un brīdinājuma politikas.
Piekļuve resursiem?
MySQL piedāvā plašas un ļoti detalizētas lietotāju atļauju/rolu iestatīšanas iespējas. Ir viegli iestatīt piekļuvi noteiktai tabulai vai pat tikai tās daļai no kolonnām. Cloud Spanner izmanto Google Identity & Access Management (IAM) rīku, kas ļauj noteikt politiku un atļaujas tikai ļoti augstā līmenī. Visdetalizētākais variants ir datubāzes līmeņa atļauja, kas lielākajā daļā ražošanas gadījumu nesaskan. Šis ierobežojums liek jums papildus nodrošināt drošības pasākumus savā kodā, infrastruktūrā vai abos, lai novērstu neatļautu Spanner resursu izmantošanu.
Dublējumi?
Vienkārši sakot, Cloud Spanner nav dublējumu. Lai arī augstie Google SLA prasības var garantēt, ka jūs nepazaudēsiet datus aparatūras vai datubāzes kļūdu dēļ, no cilvēka kļūdām, programmatūras defektiem utt. Mēs visi zinām noteikumu: augsta pieejamība neaizstāj saprātīgu dublēšanas stratēģiju. Pa šo brīdi vienīgais veids, kā dublēt datus, ir programmatūras plūsmas pārsūtīšana no datubāzes uz atsevišķu uzglabāšanas vidi.
Vaicājumu veiktspēja?
Datu ielādei un vaicājumu testēšanai mēs izmantojām Yahoo! Cloud Serving Benchmark. Tālāk esošajā tabulā ir parādīta B YCSB darba slodze ar 95% lasīšanas un 5% rakstīšanas attiecību.
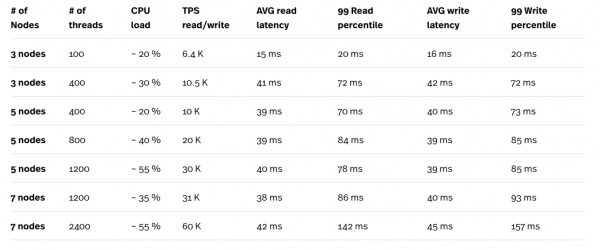
* Slodzes tests tika veikts uz skaitļošanas dzinēja (CE) n1-standard-32 (32 vCPU, 120 GB atmiņas), un testēšanas instances nekad nebija šaurs posms testos.
** Maksimālais pavedienu skaits vienā YCSB instancē ir 400. Kopumā bija jāuzsāk seši paralēli YCSB testu instance, lai iegūtu kopumā 2400 pavedienus.
Apskatot testu rezultātus, īpaši procesora slodzes un TPS kombināciju, mēs skaidri redzam, ka Cloud Spanner diezgan labi iespējo. Liela slodze, ko rada liels skaits pavedienu, tiek kompensēta ar lielu mezglu skaitu Cloud Spanner klasterī. Lai gan aizture izskatās diezgan augsta, īpaši strādājot ar 2400 pavedieniem, precīzāku skaitļu iegūšanai var būt nepieciešams atkārtoti pārbaudīt ar 6 mazākiem skaitļošanas dzinējiem. Katrs dzinējs veiks vienu YCSB testu, nevis vienu lielu CE instanci ar 6 paralēliem testiem. Tādējādi būs vieglāk atšķirt Cloud Spanner pieprasījumu aizturi un aizturi, ko pievieno tīkla savienojums starp Cloud Spanner un CE instanci, kurā tiek veikts tests.
Kā Cloud Spanner darbojas kā OLAP?
Particionēšana?
Datu sadalīšana fiziski un/vai loģiski neatkarīgos segmentos, ko sauc par partikcijām, ir ļoti populāra koncepcija, kas raksturīga lielākajai daļai OLAP mehānismu. Partikcijas var ievērojami uzlabot pieprasījumu veiktspēju un datu bāzes uzturējamību. Turpmāka izpēte par partikcijām prasa atsevišķu rakstu, tādēļ pieminēsim tikai partciju un sub-particiju shēmas nozīmi. Iespēja dalīt datus partcijās un pat tālāk sub-particijās ir atslēga analītisko pieprasījumu veiktspējai.
Cloud Spanner neatbalsta partcijas kā tādas. Tas sadala datus iekšēji, izmantojot tā sauktos split-us, kas balstīti uz primāro atslēgu diapazoniem. Sadalīšana tiek veikta automātiski, lai līdzsvarotu slodzi Cloud Spanner klasterī. Viena ļoti noderīga funkcija Cloud Spanner ir pamatā esošās slodzes sadalīšana vecāku tabulā (tabulā, kura nesatur citas). Spanner automātiski nosaka, vai split dati tiek lasīti biežāk nekā dati citos split-os, un var pieņemt lēmumu par tālāku sadalīšanu. Tādējādi pieprasījumā var būt iesaistīti vairāk mezglu, kas arvien efektīvāk palielina caurlaidību.
Datu augšupielādēšana?
Cloud Spanner datu apstrādes metode ir līdzīga parastai ielādei. Lai panāktu maksimālu veiktspēju, ir jāievēro daži ieteikumi, tostarp:
- Kārtot datus pēc primārā atslēgas.
- Sadaliet tos desmitos*mezglu skaits atsevišķās sekcijās.
- Izveidojiet uzdevumu kopu, kas vienlaicīgi ielādē datus.
Šādā datu ielādē tiek izmantoti visi Cloud Spanner mezgli.
Mēs izmantotām A YCSB slodzes testu, lai ģenerētu datu kopu ar 10M rindām.
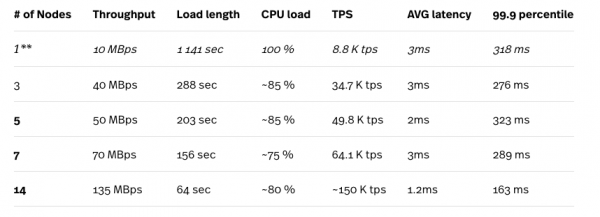
* Slodzes tests tika veikts uz n1-standard-32 aprēķinu dzinēja (32 vCPU, 120 GB RAM), un testēšanas instance nekad nebija šaurs posms testos.
** Viena mezgla iestatījums nav ieteicams jebkurai ražošanas slodzei.
Kā minēts iepriekš, Cloud Spanner automātiski apstrādā sadalījumus atkarībā no to slodzes, tādēļ rezultāti uzlabojas pēc vairākiem secīgiem testu atkārtojumiem. Šeit sniegtie rezultāti ir labākie, ko mēs esam iegūstši. Skatoties uz augstāk minētajiem skaitļiem, varam redzēt, kā Cloud Spanner (labi) mērogojas ar pieaugošo mezglu skaitu klasterī. Izvērsti skaitļi ir ārkārtīgi zemas vidējās aiztures, kas kontrastē ar sajauktajām slodzēm (95% lasīšanai un 5% rakstīšanai), kā aprakstīts iepriekš.
Mērogainas?
Cloud Spanner mezglu skaita palielināšana un samazināšana ir uzdevums, kas tiek veikts ar vienu klikšķi. Ja vēlaties ātri ielādēt datus, varat apsvērt iespēju palielināt instances jaudu līdz maksimumam (mūsu gadījumā tas bija 25 mezgli reģionā US-EAST), pēc tam samazināt mezglu skaitu, kas atbilst jūsu parastajai slodzei, kad visi dati ir ievietoti datu bāzē, ņemot vērā 2 TB/mezgls ierobežojumu.
Mums bija jāatgādina par šo ierobežojumu pat ar daudz mazāku datu bāzi. Pēc vairākiem slodzes testu palaišanas mūsu datu bāze bija apmēram 155 GB, un, samazinoties uz 1 mezgla instanci, mēs saņēmām sekojošo kļūdu:
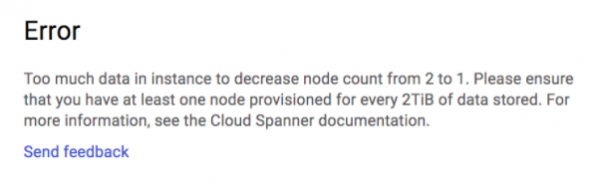
Mums izdevās samazināt mērogu no 25 līdz 2 instancēm, taču mēs iestrēgām uz diviem mezgliem.
Klastra Cloud Spanner mezglu skaita palielināšanu un samazināšanu var automatizēt, izmantojot REST API. Tas var būt īpaši noderīgi, lai samazinātu paaugstinātu slodzi uz sistēmu saspringtos darba laikos.
Kāda ir OLAP vaicājumu veiktspēja?
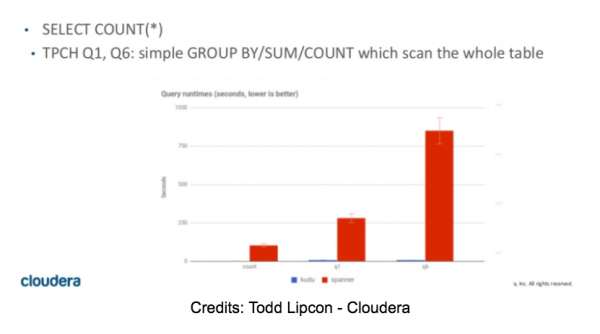
Sākotnēji mēs plānojām veltīt ievērojamu laiku mūsu Spanner novērtēšanai šajā jomā. Pēc vairākiem SELECT COUNT, mēs acumirklī sapratām, ka testēšana būs īsa un ka Spanner NEBŪS piemērots OLAP dzinējam. Neatkarīgi no mezglu skaita klastra, vienkārša rindu skaita izvēle tabulā ar 10M rindām aizņēma no 55 līdz 60 sekundēm. Turklāt jebkurš vaicājums, kas prasīja lielāku atmiņas apjomu starpposma rezultātu glabāšanai, beidzās ar OOM kļūdu.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M atšķirīgas vērtības) -> SpoolingHashAggregateIterator izbeidzās atmiņa jaunai rindai.
Dažas skaitļi TPC-H vaicājumiem var atrast Todda Lipkona rakstā , slīdraksti 42 un 43. Šie skaitļi sakrīt ar mūsu pašu rezultātiem (diemžēl).
4. Mūsu secinājumi
Ņemot vērā Cloud Spanner funkciju pašreizējo stāvokli, ir grūti iedomāties to kā vienkāršu aizstājēju esošajiem OLTP risinājumiem, jo īpaši, ja jūsu vajadzības pārsniegs tā iespējas. Būtu jāvelta ievērojams laiks, lai izveidotu risinājumu, ņemot vērā Cloud Spanner trūkumus.
Kad mēs sākām vērtēt Cloud Spanner, mēs gaidījām, ka tā pārvaldības funkcijas būs līdzvērtīgas vai vismaz tuvu citu Google SQL risinājumu līmenim. Bet mēs bijām pārsteigti par pilnīgu rezervju trūkumu un ļoti ierobežoto piekļuves kontroli resursiem. Nemaz nerunājot par skatu trūkumu, lokālās izstrādes vides trūkumu, neatbalstītām sekvencēm, JDBC bez DML un DDL atbalsta un tā tālāk.
Lai saprastu, kur doties tam, kam nepieciešams paplašināt transakciju datubāzi, jāsaka, ka tirgū pagaidām nav viengabalaina risinājuma, kas piemērots visiem lietojuma gadījumiem. Pastāv daudz risinājumu ar slēgto un atvērtā koda (daži no tiem tiek apspriesti šajā rakstā), katrs ar savām priekšrocībām un trūkumiem, taču nevienam no tiem nav SaaS ar SLA 99,999% un augstu saskanību. Ja augsts SLA līmenis ir jūsu galvenais mērķis un jūs nevēlaties izveidot savu risinājumu vairāku mākoņu vidē, Cloud Spanner varētu būt tieši tas risinājums, ko jūs meklējat. Tomēr jums jāzina par visiem tā ierobežojumiem.
Godīguma labad jāsaka, ka Cloud Spanner tika izdots vispārējai piekļuvei tikai 2017. gada pavasarī, tāpēc ir saprātīgi gaidīt, ka daži no tā pašreizējiem trūkumiem galu galā varēs izzust (cerams), un, kad tas notiks, tas var mainīt spēļu noteikumus. Galu galā Cloud Spanner nav tikai blakusprojekts Google. Google to izmanto kā pamatu citiem Google produktiem. Un, kad Google nesen nomainīja Megastore Google Cloud Storage uz Cloud Spanner, tas ļāva Google Cloud Storage kļūt stingri saskanīgam objektu sarakstiem visā pasaulē (kas joprojām neattiecas uz ).
Tātad cerība joprojām ir… mēs ceram.
Uz šī ir viss. Tāpat kā raksta autors, arī mēs turpinām cerēt, bet kādas ir jūsu domas par to? Rakstiet komentāros
Ikvienu aicinām apmeklēt mūsu kurā sīki izstāstīsim par kursu no OTUS.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish