

On February 26, we held a meetup on Apache Ignite GreenSource, featuring contributors to the open source project. . An important event in the life of this community was the restructuring of the component , which allows deploying user microservices directly in the Ignite cluster. This complex process was discussed at the meetup by , a software engineer and a contributor to Apache Ignite for over two years.
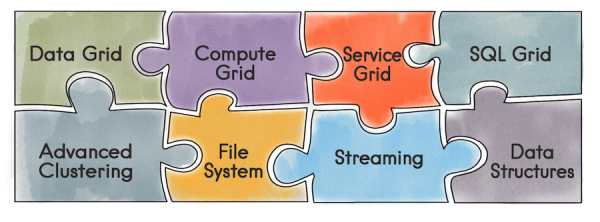
Let’s start with what Apache Ignite actually is. It is a database that represents a distributed Key/Value store with support for SQL, transactionality, and caching. Furthermore, Ignite allows deploying user services directly in the Ignite cluster. The developer has access to all tools provided by Ignite — distributed data structures, Messaging, Streaming, Compute, and Data Grid. For instance, using the Data Grid eliminates the issue of managing separate infrastructure for the data store and, consequently, the overhead costs that arise from it.
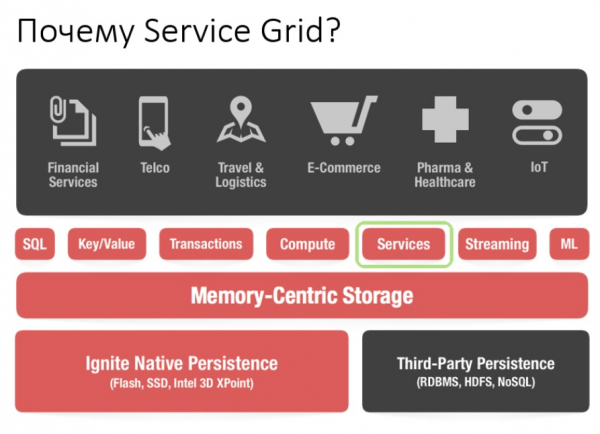
Using the Service Grid API, you can deploy a service simply by specifying the deployment scheme in the configuration and, accordingly, the service itself.
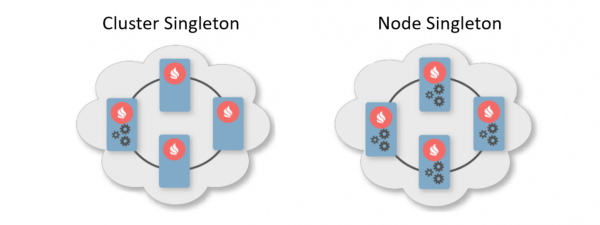
Typically, the deployment scheme indicates the number of instances to be deployed on the cluster nodes. There are two typical deployment schemes. The first is Cluster Singleton: at any given moment, there will be exactly one instance of the user service available in the cluster. The second is Node Singleton: one instance of the service is deployed on each node of the cluster.
Additionally, the user can specify the number of service instances across the entire cluster and define a predicate for filtering suitable nodes. In such a scenario, the Service Grid will calculate the optimal distribution for deploying services.
Turklāt ir tāda funkcija kā Affinity Service. Affinity ir funkcija, kas nosaka atslēgu saistību ar partitijām un partiju saistību ar mezgliem topoloģijā. Izmantojot atslēgu, var noteikt primāro mezglu, kurā tiek glabāti dati. Tādējādi var sasaistīt savu pakalpojumu ar atslēgu un keša affinity funkciju. Ja tiek mainīta affinity funkcija, notiks automātiska atkārtota izvietošana. Tādējādi pakalpojums vienmēr tiks novietots blakus datiem, ar kuriem tam jāstrādā, un attiecīgi samazināsies piekļuves izmaksas informācijai. Šādu shēmu var saukt par sava veida kolokācijas aprēķiniem.
Tagad, kad mēs esam izskatījuši, kāda ir pakalpojumu tīkla priekšrocība, pastāstīsim par tā attīstības vēsturi.
Kas bija agrāk
Iepriekšējā pakalpojumu tīkla realizācija balstījās uz transakciju replikējošo sistēmas kešu Ignite. Ar vārdu „kešs” Ignite domā glabātuvi. Tātad tas nav kaut kas pagaidu, kā varētu domāt. Neskatoties uz to, ka kešs ir replikējams un katrs mezgls satur visu datu kopumu, iekšēji kešam ir partitēta prezentācija. Tas ir saistīts ar glabātavu optimizāciju.
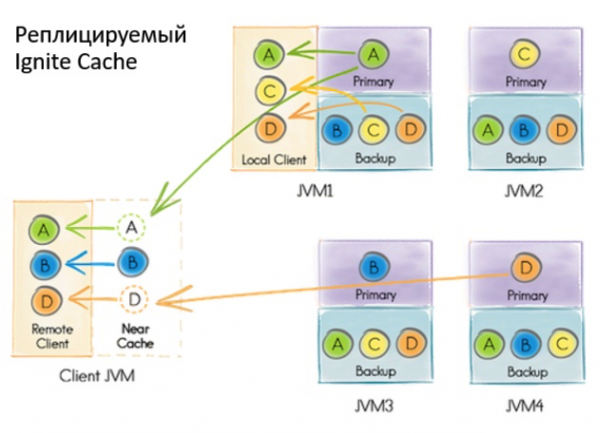
Kas notika, kad lietotājs vēlējās izvietot pakalpojumu?
- Visi mezgli klasterī parakstījās uz datu atjaunošanas glabātavā, izmantojot iebūvēto Continuous Query mehānismu.
- Iniciators mezgls read-committed transakcijas ietvaros izdarīja ierakstu datu bāzē, kas saturēja pakalpojuma konfigurāciju, tostarp sērijveida instanci.
- Saņemot paziņojumu par jauno ierakstu, koordinators aprēķināja sadalījumu, pamatojoties uz konfigurāciju. Saņemtais objekts tika ierakstīts atpakaļ datu bāzē.
- Ja mezgls nonāca sadalījumā, koordinatoram vajadzēja to izvietot.
Kas mūs neapmierināja
Kādā brīdī mēs nonācām pie secinājuma: ar pakalpojumiem nevar strādāt šādā veidā. Iemeslu bija vairāki.
Ja izvietošanas laikā notika kāda kļūda, to varēja uzzināt tikai no žurnāliem tajā mezglā, kur tas notika. Pastāvēja tikai asyncrons izvietojums, tāpēc pēc kontroles atgriešanas lietotājam no izvietošanas metodes bija nepieciešams papildu laiks pakalpojuma uzsākšanai - un šajā laikā lietotājs nevarēja neko pārvaldīt. Lai attīstītu pakalpojumu tīklu tālāk, izstrādātu jaunas funkcijas, piesaistītu jaunus lietotājus un padarītu visiem dzīvi vieglāku, bija jāveic izmaiņas.
Projektējot jauno Service Grid, mēs vispirms vēlējāmies nodrošināt sinhronizētas izvietošanas garantiju: tiklīdz lietotājs saņem kontroli no API, viņš var nekavējoties izmantot pakalpojumus. Mēs arī vēlējāmies sniegt iniciatoram iespēju apstrādāt izvietošanas kļūdas.
Turklāt vēlējāmies atvieglot īstenošanu, proti, izvairīties no transakcijām un pārdalīšanas. Neskatoties uz to, ka kešatmiņa ir replicējama un nav pārdalīšanas, liela izvietošanas laikā, kad ir daudz mezglu, radās problēmas. Mainot topoloģiju, mezgliem ir nepieciešams apmainīties ar informāciju, un lielas izvietošanas laikā šie dati var izmērīt ļoti daudz.
Kad topoloģija bija nestabila, koordinētājam bija nepieciešams pārskaitīt pakalpojumu sadalījumu. Un, kad jāstrādā ar transakcijām nestabilā topoloģijā, tas var novest pie grūti prognozējamām kļūdām.
Problēmas
Kādas globālas izmaiņas var notikt bez saistītām problēmām? Pirmā no tām bija topoloģijas maiņa. Jāņem vērā, ka jebkurā brīdī, pat pakalpojuma izvietošanas laikā, mezgls var pievienoties klasterim vai izņemties no tā. Turklāt, ja pakalpojuma izvietošanas laikā mezgls pievienojas klasterim, būs nepieciešams konsistenti nodot visu informāciju par pakalpojumiem jaunajam mezglam. Un runa ir ne tikai par jau izvietotajiem, bet arī par pašreizējiem un nākotnes izvietojumiem.
Tas ir tikai viens no jautājumiem, kurus var apkopot atsevišķā sarakstā:
- Kā izvietot statiski konfigurētus pakalpojumus mezgla palaišanas laikā?
- Mezglu izņemšanās no klastera – ko darīt, ja mezgls uzhosts pakalpojumus?
- Ko darīt, ja koordinētājs ir mainījies?
- Ko darīt, ja klients ir atkārtoti pievienojies klasterim?
- Vai jāapstrādā aktivizācijas/deaktivizācijas pieprasījumi un kā?
- Un, ja nosaukums ir noticis kešatmiņas iznīcināšanā, bet mums ir saistīti ar to afinitātes pakalpojumi?
Un tas ir tālu no visa.
Risinājums
Kā mērķis mēs izvēlējāmies Event Driven pieeju ar komunikācijas procesu īstenošanu, izmantojot ziņojumus. Ignite jau ir īstenoti divi komponenti, kas ļauj mezgliem sūtīt ziņojumus viens otram – communication-spi un discovery-spi.
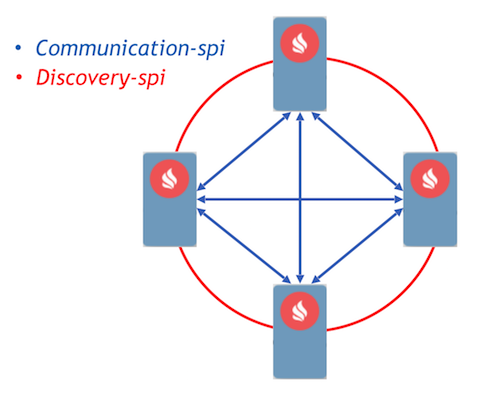
Communication-spi ļauj mezgliem tieši sazināties un nosūtīt ziņojumus. Tas ir labi piemērots liela datu apjoma pārsūtīšanai. Discovery-spi ļauj nosūtīt ziņojumu visiem mezgliem klasterī. Standartizētajā īstenojumā tas tiek darīts, izmantojot „gredzena” topoloģiju. Ir arī integrācija ar Zookeeper, šajā gadījumā tiek izmantota „zvaigznes” topoloģija. Vēl jāatzīmē svarīgs moments: discovery-spi nodrošina garantijas, ka ziņojums noteikti tiks piegādāts pareizajā secībā visiem mezgliem.
Apskatīsim izvietošanas protokolu. Visi lietotāju pieprasījumi izpildei un atteikšanai tiek nosūtīti pa discovery-spi. Tas nodrošina sekojošas garantijas:
- Pieprasījums tiks saņemts visiem mezgliem klasterī. Tas ļaus turpināt apstrādi, ja koordinators mainās. Tas arī nozīmē, ka katram mezgam būs visi nepieciešamie metadati par vienu ziņojumu, piemēram, pakalpojuma konfigurācija un tā serializētais instants.
- Strikta ziņojumu piegādes secība ļauj atrisināt konfigurāciju un konkurējošu pieprasījumu konfliktus.
- Tā kā mezgla piekļaušana topoloģijai tiek apstrādāta arī pa discovery-spi, jaunajam mezgam nonāks visi dati, kas nepieciešami darbam ar pakalpojumiem.
Saņemot pieprasījumu, mezgli klasterī to validē un izveido uzdevumus apstrādei. Šie uzdevumi tiek ievietoti rindā un pēc tam apstrādāti citā pavedienā ar atsevišķu darbinieku. Tas ir realizēts šādā veidā, jo izvietošana var aizņemt būtisku laiku un kavēt dārgo discovery plūsmu nav pieņemami.
Visus pieprasījumus no rindas apstrādā izvietošanas menedžeris. Tam ir īpašs darbinieks, kas izvelk uzdevumu no šīs rindas un inicializē to, lai uzsāktu izvietošanu. Pēc tam notiek sekojošas darbības:
- Katrs mezgls patstāvīgi aprēķina sadalījumu, pateicoties jaunai determinētai assignment funkcijai.
- Mezgli izveido ziņojumu ar izvietošanas rezultātiem un nosūta to koordinatoram.
- Koordinators agregē visus ziņojumus un izveido visa izvietošanas procesa rezultātu, kas tiek nosūtīts pa discovery-spi visiem mezgliem klasterī.
- Saņemot rezultātu, izvietošanas processbeidzas, pēc tam uzdevums tiek izdzēsts no rindas.
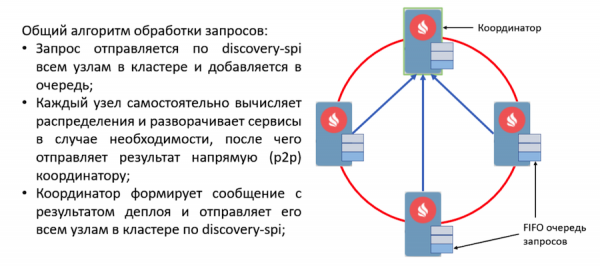
Jaunais notikumu virzītais dizains: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Ja, ja izpildes brīdī radās kļūda, mezgls uzreiz iekļauj šo kļūdu ziņojumā, kuru nosūta koordinatoram. Pēc ziņojumu apkopošanas koordinatoram būs informācija par visām kļūdām izvietošanas laikā, un šis ziņojums tiks nosūtīts pa discovery-spi. Informācija par kļūdām būs pieejama jebkurā mezglā klasterī.
Pēc šā darba algoritma visus svarīgākos notikumus apstrādā Service Grid. Piemēram, topoloģijas maiņa ir arī ziņojums pa discovery-spi. Un, salīdzinot ar iepriekšējo, protokols ir izrādījies pietiekami viegls un uzticams. Pietiekami, lai apstrādātu jebkuru situāciju izvietošanas laikā.
Kas notiks tālāk
Tagad par plāniem. Jebkura liela izmaiņa projektā Ignite tiek veikta kā iniciatīva Ignite uzlabošanai, saukta par IEP. Arī Service Grid pārdizaina projektam ir IEP — ar jokiem nosaukumu «Eļļas maiņa Service Grid». Taču patiesībā mēs nomainījām ne tikai eļļu motorā, bet visu motoru.
IEP uzdevumus mēs sadalījām 2 fāzēs. Pirmā — lielā fāze, kas ietver izvietošanas protokola pārstrādi. Tā jau ir iekļauta galvenajā versijā, varat izmēģināt jauno Service Grid, kas parādīsies versijā 2.8. Otrā fāze ietver daudzus citus uzdevumus:
- Aukstā atkārtota izvietošana
- Servisa versiju pārvaldība
- Uzticamības palielināšana
- Tīrs klients
- Uzraudzības un dažādu metrikas rādītāju skaitīšanas rīki
Visbeidzot, mēs varam ieteikt jums Service Grid, lai veidotu uzticamas augstas pieejamības sistēmas. Mēs arī aicinām jūs pievienoties mūsu un dalīties ar savu pieredzi. Jūsu pieredze patiešām ir svarīga kopienai, tā palīdzēs saprast, kur doties tālāk, kā nākotnē attīstīt komponentu.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish