

Sveiki visiem. Šajā rakstā es izstāstīšu, kāpēc mēs Avito pirms deviņiem mēnešiem izvēlējāmies Kafka un ko tā sevī ietver. Dalīšos ar vienu no lietošanas gadījumiem — ziņojumu brokeris. Un visbeidzot parunāsim par to, kādus ieguvumus mēs guvām, izmantojot Kafka kā servisu.
Problēma
Vispirms nedaudz konteksta. Pirms kāda laika mēs sākām atkāpties no monolītiskās arhitektūras, un pašlaik Avito jau ir vairāki simti dažādu pakalpojumu. Katram no tiem ir savas datu glabāšanas sistēmas, tehnoloģiju kaudzes un tie atbild par savu biznesa loģikas daļu.
Viena no problēmām ar lielu pakalpojumu skaitu ir komunikācija. Pakalpojums A bieži vēlas uzzināt informāciju, kas ir pakalpojumā B. Šajā gadījumā pakalpojums A vēršas pie pakalpojuma B caur sinhrono API. Pakalpojums B vēlas zināt, kas notiek pakalpojumos G un D, un tie, savukārt, interesējas par pakalpojumiem A un B. Kad tādu "ziņkārīgu" pakalpojumu kļūst daudz, saites starp tiem pārvēršas par mulsīgu mezglu.
Turklāt jebkurā brīdī pakalpojums A var kļūt nepieejams. Un ko šajā gadījumā darīt pakalpojumam B un visiem citiem ar to saistītajiem pakalpojumiem? Bet, ja biznesa operācijas izpildei ir jāveic secīga sinhrono izsaukumu ķēde, vispārējās operācijas atteikšanās iespēja kļūst vēl augstāka (un tā ir jo augstāka, jo garāka šī ķēde).
Tehnoloģijas izvēle
Labi, problēmas ir skaidras. Tos var novērst, izveidojot centralizētu ziņojumu apmaiņas sistēmu starp pakalpojumiem. Tagad katram pakalpojumam ir jāzina tikai par šo ziņojumu apmaiņas sistēmu. Turklāt pašai sistēmai jābūt noturīgai pret kļūdām un horizontāli paplašināmai, kā arī avārijas gadījumā jākopj sevī pieprasījumu buferis turpmākai apstrādei.
Tagad izvēlēsimies tehnoloģiju, uz kuras tiks īstenota ziņojumu piegāde. Vispirms sapratīsim, ko mēs no tās sagaidām:
- ziņojumi starp pakalpojumiem nedrīkst pazust;
- ziņojumi var būt dublēti;
- ziņojumus var uzglabāt un lasīt vairākus dienas (noturīgs buferis);
- pakalpojumi var parakstīties uz interesējošiem datiem;
- vairāki pakalpojumi var lasīt tos pašus datus;
- ziņojumi var saturēt detalizētu, apjomīgu payload (notikumiem piesātināta stāvokļa pārvade);
- dažreiz nepieciešama ziņojumu secības garantija.
Tāpat mums bija kritiski svarīgi izvēlēties pēc iespējas mērogojamāku un uzticamāku sistēmu ar augstu caurlaidspēju (vismaz 100 tūkstoši ziņojumu, pa dažiem kilobaitiem sekundē).
Šajā posmā mēs šķīrāmies no RabbitMQ (grūti noturēt stabilu pie augstiem RPS), PGQ no SkyTools (pietiekami ātrs un slikti mērogojams) un NSQ (nepersistējošs). Visas šīs tehnoloģijas ir izmantotas mūsu uzņēmumā, bet šai uzdevumam tās nebija piemērotas.
Tālāk mēs sākām aplūkot mums jaunus tehnoloģiskus risinājumus — Apache Kafka, Apache Pulsar un NATS Streaming.
Pulsar mēs noraidījām pirmajā kārtā. Mēs nolēmām, ka Kafka un Pulsar ir diezgan līdzīgas sistēmas. Un, lai gan Pulsar ir pārbaudīts lielos uzņēmumos, ir jaunāks un teorētiski piedāvā zemāku latentumu, mēs no šiem diviem izvēlējāmies Kafka, jo tā ir de facto standarts šādām uzdevumu izpildei. Iespējams, nākotnē mēs atgriezīsimies pie Apache Pulsar.
Tādējādi palika divi kandidāti: NATS Streaming un Apache Kafka. Mēs diezgan detalizēti izpētījām abus risinājumus, un abi tie atbilda uzdevumam. Bet beigās mēs baidījāmies no attiecīgās jaunības NATS Streaming (un no tā, ka viens no galvenajiem izstrādātājiem, Tyler Treat, nolēma izstāties no projekta un uzsākt savu — Liftbridge). Turklāt NATS Streaming klasterizācijas režīms nepiedāvāja iespēju spēcīgai horizontālai mērogai (iespējams, tas jau nav problēma pēc daļu režīma pievienošanas 2017. gadā).
Tomēr NATS Streaming ir lieliska tehnoloģija, uzrakstīta valodā Go un apstiprināta Cloud Native Computing Foundation. Atšķirībā no Apache Kafka, tai nav nepieciešams Zookeeper darbībai (iespējams, ), jo iekšēji tā izmanto RAFT. Turklāt NATS Streaming ir vieglāk administrēt. Mēs neizslēdzam iespēju, ka turpmāk mēs vēlreiz atgriezīsimies pie šīs tehnoloģijas.
Tomēr šobrīd mūsu uzvarētājs ir Apache Kafka. Mēs testos tā parādījās pietiekami ātra (vairāk nekā miljons ziņojumu sekundē gan lasot, gan rakstot ar ziņojumu apjomu 1 kilobaits), pietiekami uzticama, labi mērogojama un pierādīta lielos uzņēmumos. Turklāt Kafka atbalsta vismaz dažas lielas komerciālas kompānijas (mēs, piemēram, izmantojam Confluent versiju), kā arī Kafka ir attīstīta ekosistēma.
Kafka apskats
Pirms uzsākt, nekavējoties rekomendēju lielisku grāmatu — «Kafka: The Definitive Guide» (ir ir krievu tulkojumā, bet termini nedaudz mulsina). Tajā var atrast informāciju, kas nepieciešama pamata izpratnei par Kafka un pat nedaudz vairāk. Pašai dokumentācijai no Apache un Confluent emuāram ir lieliski uzrakstīts un viegli lasāms.
Tātad, aplūkosim, kā Kafka izskatās no putna lidojuma. Pamata Kafka topoloģija sastāv no producer, consumer, broker un zookeeper.
Broker
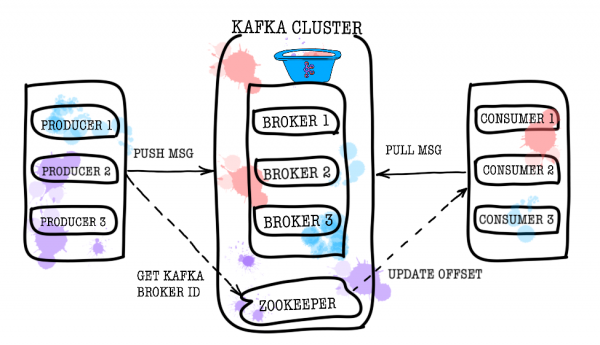
Jūsu datu glabāšanu nodrošina brokeris (broker). Visi dati tiek glabāti binārā veidā, un brokeris maz zina par to, kas tie ir un kāda ir to struktūra.
Katrs loģiskais notikumu veids parasti atrodas savā atsevišķā topikā (topic). Piemēram, paziņojuma izveidošanas notikums var nonākt topikā item.created, bet tā izmaiņu notikums — item.changed. Topikus var uzskatīt par notikumu klasifikatoriem. Topika līmenī ir iespējams iestatīt tādas konfigurācijas parametrus kā:
- uzglabājamo datu apjomu un/vai to vecumu (retention.bytes, retention.ms);
- datu redundances faktoru (replication factor);
- maksimālo viena ziņojuma izmēru (max.message.bytes);
- minimālo skaitu saskaņoto repliku, kurā var ierakstīt datus topikā (min.insync.replicas);
- iespēju veikt failover uz nesakrīto atpalikušo repliku ar potenciālu datu zudumu (unclean.leader.election.enable);
- un vēl daudz ko citu ().
Savukārt katrs topiks tiek sadalīts vienā vai vairākās partitijās (partition). Tieši partitijās beigās nonāk notikumi. Ja klasterī ir vairāk nekā viens brokers, partitijas tiks vienmērīgi sadalītas pa visiem brokeriem, cik iespējams, kas ļaus skalot slodzi uz rakstīšanu un lasīšanu tikai vienā topikā uz vairākiem brokeriem.
Uz diska dati katrai partitijai tiek glabāti segmentu failu veidā, kuru noklusējums ir viens gigabaits (to kontrolē caur log.segment.bytes). Svarīga iezīme ir tā, ka datu dzēšana no partitijām (aktualizējot retention) notiek tieši pa segmentiem (nav iespējams dzēst vienu notikumu no partitijas, var dzēst tikai veselu segmentu, turklāt tikai neaktīvo).
Zookeeper
Zookeeper darbojas kā metadatu krātuve un koordinators. Tieši tas spēj pateikt, vai brokeri ir dzīvi (uz to var paskatīties caur zookeeper acīm, izmantojot zookeeper-shell komandu ls /brokers/ids), kurš brokers ir kontrolieris (get /controller), vai sadaļas ir sinhronā stāvoklī ar savām replikām (get /brokers/topics/topic_name/partitions/partition_number/state). Tāpat tieši uz zookeeper vispirms dosies ražotājs un patērētājs, lai uzzinātu, kurā brokerī kādi temati un sadaļas tiek glabātas. Gadījumos, kad tēmai ir noteikts replication factor, kas pārsniedz 1, zookeeper norādīs, kuras sadaļas ir līderi (tās tiks ierakstītas un no tām tiks lasīts). Ja brokers avarē, tieši zookeeper tiks ierakstīta informācija par jauniem līderu sadaļām (sākot no versijas 1.1.0 asinkronā režīmā, ).
Vecākās Kafka versijās zookeeper atbildēja arī par offsetu glabāšanu, bet tagad tie tiek glabāti īpašā tēmā __consumer_offsets brokerī (lai gan jūs joprojām varat izmantot zookeeper šiem mērķiem).
Visvienkāršākais veids, kā pārvērst jūsu datus par ķirbi, ir tieši informācijas zudums no zookeeper. Šādā scenārijā būs ļoti grūti saprast, ko un no kurienes ir jālasa.
Ražotājs
Ražotājs — visbiežāk ir serviss, kas veic tiešu datu ierakstu Apache Kafka. Ražotājs izvēlas tēmu, kurā tiks glabāti tā tematiskie ziņojumi, un sāk tajā ierakstīt informāciju. Piemēram, ražotājs var būt sludinājumu serviss. Šādā gadījumā tas nosūtīs šādus pasākumus tematiskajās tēmās, kā "sludinājums izveidots", "sludinājums atjaunots", "sludinājums dzēsts" utt. Katrs pasākums šajā gadījumā ir atslēgas-vērtības pāris.
Pēc noklusējuma visi pasākumi tiek sadalīti pa tēmas sadaļām, izmantojot round-robin, ja atslēga nav norādīta (zaudējot secību), un ar MurmurHash (atslēga), ja atslēga ir klāt (secība vienā sadaļā).
Šeit uzreiz jāatzīmē, ka Kafka garantē pasākumu secību tikai vienā sadaļā. Bet patiesībā bieži tas nav problēma. Piemēram, var droši pievienot visas izmaiņas viena un tā paša sludinājuma vienā sadaļā (tādējādi saglabājot šo izmaiņu secību attiecībā uz sludinājumu). Tāpat var pārnest secības numuru vienā no pasākuma laukiem.
Patērētājs
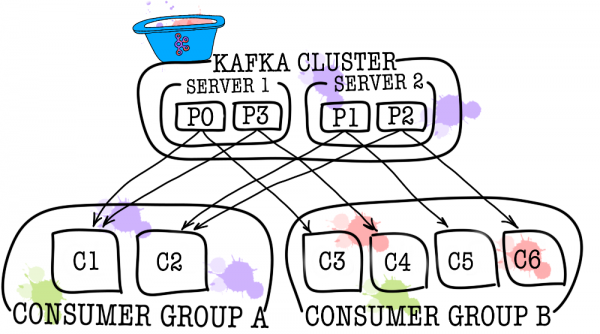
Patērētājs atbild par datu saņemšanu no Apache Kafka. Atgriežoties pie iepriekš minētā piemēra, kā patērētājs varētu būt moderēšanas pakalpojums. Šis pakalpojums būs parakstījies uz sludinājumu pakalpojuma tēmu un, kad parādīsies jauns sludinājums, to saņems un analizēs saskaņā ar noteiktām politikām.
Apache Kafka atceras, kādus pēdējos notikumus patērētājs saņēmis (tam tiek izmantota palīdzības tēma __consumer__offsets), tādējādi garantējot, ka, veiksmīgi nolasot, patērētājs nesaņems to pašu ziņojumu divreiz. Tomēr, ja iespējot opciju enable.auto.commit = true un pilnībā uzticēt patērētāja pozīcijas izsekošanu Kafka, var . Ražošanas kodā visbiežāk patērētāja pozīciju kontrolē manuāli (izstrādātājs pārvalda brīdi, kad obligāti jāveic nolasītā notikuma apstiprināšana).
Tajos gadījumos, kad viena patērētāja nepietiek (piemēram, ja jauno notikumu plūsma ir ļoti liela), var pievienot vēl dažus patērētājus, apvienojot tos patērētāju grupā. Patērētāju grupa loģiski pārstāv tieši tādu pašu patērētāju, bet ar datu sadalījumu starp grupas dalībniekiem. Tas ļauj katram dalībniekam ņemt savu ziņojumu daļu, tādējādi palielinot lasīšanas ātrumu.
Testēšanas rezultāti
Šeit nevēlos rakstīt daudz paskaidrojoša teksta, vienkārši dalīšos ar iegūtajiem rezultātiem. Testēšana tika veikta uz 3 fiziskajām mašīnām (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s tīkls), brokeri un zookeeper tika izvietoti lxc.
Veiktspējas testēšana
Testēšanas laikā tika iegūti sekojoši rezultāti.
- Ziņojumu rakstīšanas ātrums ar 1KB lieliem ziņojumiem vienlaikus izmantojot 9 ražotājus — 1300000 notikumu sekundē.
- Ziņojumu lasīšanas ātrums ar 1KB lieliem ziņojumiem vienlaikus izmantojot 9 patērētājus — 1500000 notikumu sekundē.
Nepieciešamības testēšana
Testēšanas laikā tika iegūti sekojoši rezultāti (3 brokeri, 3 zookeeper).
- Vienas no brokeru neparastas izslēgšanās neiznīcina vai nepadara pieejamu klasteri. Darbs turpinās normālā režīmā, taču atlikušajiem brokeriem ir liela slodze.
- Brokera nepareizs iznākums divu brokera gadījumā trīs brokeru klasterī ar min.isr = 2 noved pie klastera nepieejamības rakstīšanai, bet pieejamības lasīšanai. Ja min.isr = 1, klasteris turpina būt pieejams gan lasīšanai, gan rakstīšanai. Tomēr šis režīms ir pretrunā augstiem datu drošības prasībām.
- Viena no Zookeeper serveriem nepareizs iznākums nepārtrauc vai nepadara klasteri nepieejamu. Darbs turpinās normāli.
- Divu Zookeeper serveru nepareizs iznākums noved pie klastera nepieejamības līdz brīdim, kad viens no Zookeeper serveriem atjauno savu darbību. Šis apgalvojums ir pareizs attiecībā uz Zookeeper klasteri, kas sastāv no 3 serveriem. Pēc izpētes tika nolemts palielināt Zookeeper klasteri līdz 5 serveriem, lai palielinātu pieejamību.
Kafka kā pakalpojums
Mēs esam pārliecinājušies, ka Kafka ir lieliska tehnoloģija, kas palīdz mums atrisināt uzdevumu (ziņojumu brokera izveidošana). Tomēr mēs nolēmām aizliegt pakalpojumiem tieši piekļūt Kafka un slēdzām to virsū ar data-bus pakalpojumu. Kāpēc mēs to izdarījām? Patiesībā ir vairākas iemeslu.
Data-bus ir uzņēmis visas ar Kafka integrāciju saistītās funkcijas (patēriņa un ražotāju iestatīšana un konfigurēšana, uzraudzība, brīdināšana, žurnālfailu glabāšana, mērogošana utt.). Tādējādi integrācija ar ziņojumu brokeri notiek maksimāli vienkārši.
Data-bus ļāva abstrahēties no konkrētās valodas vai bibliotēkas savienojumam ar Kafka.
Data-bus ļāva citiem pakalpojumiem abstrahēties no datu glabāšanas slāņa. Iespējams, kādā brīdī mēs aizvietosim Kafka ar Pulsar, un neviens pat nemanīs (visi pakalpojumi zina tikai par data-bus API).
Data-bus uzņēma sev notikumu shēmu validāciju.
Ar data-bus ir ieviesta autentifikācija.
Data-bus ietvaros mēs varam bez dīkstāves, nemanāmi atjaunināt Kafka versijas, centralizēti pārvaldīt ražotājus, patēriņus, brokerus utt.
Data-bus ļāva pievienot nepieciešamās funkcijas, kuras trūkst Kafka (kā piemēram, tēmu audita veikšana, anomāliju kontrole klasterī, DLQ izveidošana utt.).
Data-bus ļauj realizēt failover centralizēti visiem pakalpojumiem.
Pašlaik, lai sāktu sūtīt notikumus uz ziņojumu brokeri, pietiek ar to, lai savā pakalpojuma kodā pievienotu nelielu bibliotēku. Tas ir viss. Jums rodas iespēja rakstīt, lasīt un skalot ar vienu koda rindu. Visa realizācija ir slēpta no jums, redzamā daļa ir tikai dažas rokasgrāmatas ar partijas izmēru. Zem vāka pakalpojums data-bus palaiž Kubernetes nepieciešamo instanču skaitu ražotājiem un patērētājiem un nodrošina viņiem nepieciešamo konfigurāciju, taču viss tas jūsu pakalpojumam ir caurspīdīgs.
Protams, nav sudraba lodes, un šādam pieejai ir savi ierobežojumi.
- Data-bus ir jāatbalsta pašiem, atšķirībā no trešo pušu bibliotēkām.
- Data-bus palielina mijiedarbību starp pakalpojumiem un ziņojumu brokeri, kas samazina veiktspēju salīdzinājumā ar tīru Kafka.
- Ne viss var tikt tā vienkārši noslēpts no pakalpojumiem, dublēt KSQL vai Kafka Streams funkcionalitāti data-bus mums negribas, tādēļ dažreiz nākas atļaut pakalpojumiem savienoties tieši.
Mūsu gadījumā plusi pārsita mīnusus, un lēmums slēpt ziņojumu brokeri saskaņotā pakalpojumā izrādījās pamatots. Gada laikā ekspluatācijas laikā mums nebija nekādu nopietnu avāriju un problēmu.
P.S. Paldies manai draudzenei, Ekaterinai Obalajevai, par lieliskajām ilustrācijām šim rakstam. Ja jums tās patika, atradīsies vēl vairāk ilustrāciju.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish