

Mēs esam izstrādājuši datu centra tīkla dizainu, kas ļauj izvērst izskaitļošanas klasterus ar vairāk nekā 100 tūkstošiem serveru un ar maksimālo šķērsgriezuma platumu (bisection bandwidth) virs viena petabaita sekundē.
No Dmitrija Afanaseva ziņojuma jūs uzzināsiet par jaunā dizaina pamatprincipiem, topoloģiju mērogošanu, ar to saistītajām problēmām, risinājumu variantiem, maršrutēšanas un modernas tīkla iekārtu forward plane funkciju mērogošanas īpatnībām «blīvi» (densely connected) topoloģijās ar lielu ECMP maršrutu skaitu. Turklāt Dima īsi pastāstīja par ārējās savienojamības organizāciju, fizisko līmeni, kabeļu sistēmu un veidiem, kā turpināt palielināt kapacitāti.
— Labdien visiem! Mans vārds ir Dmitrijs Afanasevs, es esmu Yandex tīkla arhitekts un galvenokārt nodarbojos ar datu centru tīklu dizainu.
Mans stāsts būs par atjaunoto Yandex datu centru tīklu. Tas ir lielā mērā esošā dizaina evolūcija, bet tajā pašā laikā ir arī daži jauni elementi. Tas ir pārskata prezentācija, jo bija jāiekļauj diezgan daudz informācijas īsā laikā. Mēs sāksim ar loģiskās topoloģijas izvēli. Pēc tam būs pārskats par control plane un ar datu plūsmu saistītajām mērogošanas problēmām, izvēle par to, kas notiks fiziskajā līmenī, un aplūkosim dažas iekārtu īpatnības. Nedaudz pieskarsimies arī tam, kas notiek datu centrā ar MPLS, par kuru mēs runājām pirms kāda laika.
Tātad, kas ir Yandex no slodžu un pakalpojumu viedokļa? Yandex ir tipiska hiperskalas uzņēmums. Ja skatāmies uz lietotājiem, tad vispirms notiek lietotāju pieprasījumu apstrāde. Tāpat ir dažādi straumēšanas pakalpojumi un datu nodalīšana, jo mums ir arī uzglabāšanas pakalpojumi. Ja tuvāk pie aizmugures, tad tur parādās infrastruktūras slodzes un pakalpojumi, piemēram, sadalīti objektu krātuves, datu replikācija un, protams, pastāvīgas rindas. Viens no galvenajiem slodzes veidiem ir MapReduce un tamlīdzīgas sistēmas, plūsmas apstrāde, mašīnmācīšanās utt.
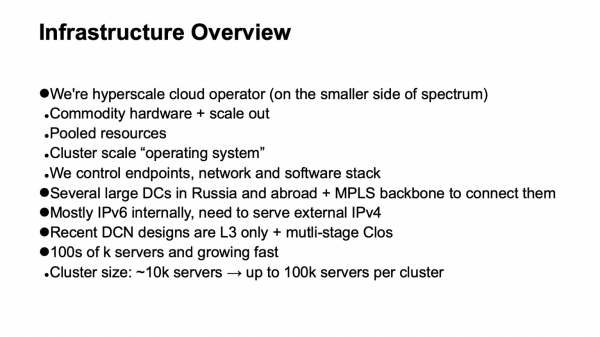
Kā ir organizēta infrastruktūra, uz kuras viss tas notiek? Atkal, mēs esam diezgan tipisks hiperskaleris, lai gan, iespējams, nedaudz tuvāk tam spektra galam, kur atrodas mazāki hiperskaleris. Bet mums ir visas īpašības. Mēs izmantojam industriālo aparatūru un horizontālo mērogošanu visur, kur tas ir iespējams. Mums ir plašs resursu kopums: mēs nestrādājam ar atsevišķām mašīnām, atsevišķām stendiem, bet apvienojam tās lielā kopā neaizvietojamu resursu ar dažu papildu pakalpojumiem, kas nodarbojas ar plānošanu un resursu piešķiršanu, un strādājam ar šo kopumu.
Tādējādi mums rodas nākamais līmenis — operētājsistēmas līmeņa aprēķinu klasteris. Ļoti svarīgi ir tas, ka mēs pilnībā kontrolējam tehnoloģiju steku, kuru izmantojam. Mēs kontrolējam galapunktus (serverus), tīklu un programmatūru.
Mums ir vairāki lielie datu centri Krievijā un ārvalstīs. Tos apvieno backbone, kas izmanto MPLS tehnoloģiju. Mūsu iekšējā infrastruktūra praktiski pilnībā balstās uz IPv6, bet, tā kā mums jāapkalpo ārējais trafiks, kas joprojām lielākoties ienāk pa IPv4, mums ir jāspēj piegādāt pieprasījumus, kas ierodas pa IPv4, līdz frontend-serveriem, un nedaudz vēl jāieiet ārējā IPv4 internetā — piemēram, indeksēšanai.
Pēdējās dažas datu centru tīklu dizaina iterācijas izmanto vairāku slāņu Clos topoloģijas, un tajās tiek izmantota tikai L3. Mēs kādu laiku atpakaļ atteicāmies no L2 un elpojam vieglāk. Galu galā mūsu infrastruktūrā ir simtiem tūkstošu aprēķinu (serveru) instance. Maksimālais klastera izmērs pirms kāda laika bija apmēram 10 tūkstoši serveru. Tas ir lielā mērā saistīts ar to, kā var strādāt minētās operētājsistēmas līmeņa klasteri, plānotāji, resursu piešķiršana utt. Tā kā infrastruktūras programmatūrā ir notikusi progresēšana, tagad mērķis ir izmērs apmēram 100 tūkstoši serveru vienā aprēķinu klasterī, un mums ir uzdevums — spēt veidot tīkla fabrikas, kas ļauj efektīvi realizēt resursu kopumu šādā klasterī.
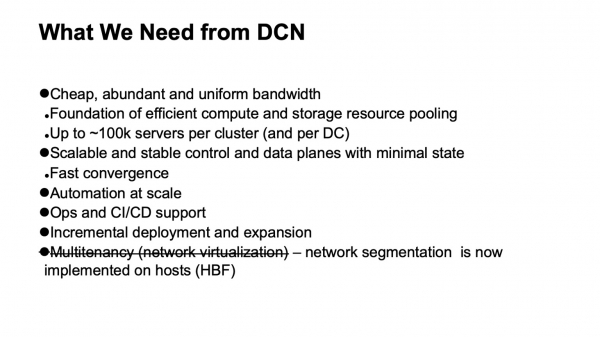
Ko mēs vēlamies no datu centra tīkla? Pirmkārt — daudz lēnas un pietiekami vienmērīgi sadalītas joslas platuma. Jo tīkls ir tā bāze, kas ļauj mums veikt resursu apvienošanu. Jaunais mērķa izmērs — aptuveni 100 tūkstoši serveru vienā klasterī.
Protams, mēs vēlamies arī elastīgu un stabilu kontrolējošo sistēmu, jo tādā lielā infrastruktūrā rodas daudz galvassāpju pat no nejaušiem notikumiem, un mēs nevēlamies, lai kontrolējošā sistēma radītu vēl lielākas galvassāpes. Tajā pašā laikā mēs vēlamies minimizēt stāvokli tajā. Jo mazāk stāvokļa, jo labāk un stabilāk viss darbojas, vieglāk diagnosticēt.
Protams, mums nepieciešama automatizācija, jo manuāli pārvaldīt šādu infrastruktūru nav iespējams un jau kādu laiku tas nav bijis iespējams. Mums pēc iespējas nepieciešama atbalsts operatīvajai darbībai un CI/CD atbalsts, cik vien tas ir iespējams.
Pie šādiem datu centru un klasteru izmēriem uzdevums atbalstīt inkrementālu izvēršanu un paplašināšanu bez pakalpojuma pārtraukumiem ir kļuvusi ļoti akūta. Ja klasteros, kas ir tūkstoša mašīnu izmēros, iespējams, tuvāk desmit tūkstošiem, tos vēl varēja īstenot kā vienu operāciju — tas ir, mēs plānojam paplašināt infrastruktūru, un daži tūkstoši mašīnu tiek pievienotas kā viena operācija, tad klasteris, kas ir tuvu simt tūkstošiem mašīnu, nekļūst par tādu uzreiz, tas tiek veidots noteiktā laika posmā. Un vēlams, lai visas šī laika vienības, kas jau tika nodotas, esošā infrastruktūra būtu pieejama.
Un viena prasība, kas mums bija un pazuda: tā ir multitenancy atbalsts, tas ir, tīkla virtualizācija vai segmentācija. Tagad mums to vairs nav jāveic tīkla fabrikas līmenī, jo segmentācija ir pārcelta uz hostiem, un tas ir ļoti atvieglojis mūsu paplašināšanu. Pateicoties IPv6 un plašam adrešu spektram, mums nebija nepieciešams iekšējā infrastruktūrā izmantot atkārtotas adreses, visa adresācija bija un tāpat unikāla. Un, pateicoties tam, ka mēs tīkla filtrāciju un segmentāciju esam pārcēluši uz hostiem, mums nav jāveido kaut kādas virtuālas tīkla vienības datu centru tīklos.
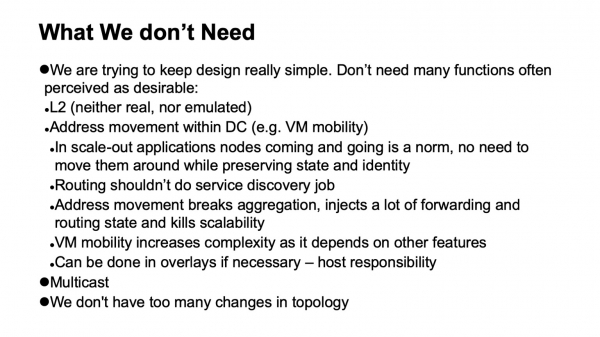
Viena svarīga lieta ir tā, ka mums tā nav nepieciešama. Ja dažas funkcijas var izņemt no tīkla, tas būtiski atvieglo dzīvi un parasti paplašina pieejamā aprīkojuma un programmatūras izvēli, kā arī ļoti atvieglo diagnostiku.
Tātad, ko mēs varam izslēgt, no kā mēs varējām atteikties, ne vienmēr ar prieku tajā brīdī, kad tas notika, bet ar lielu atvieglojumu, kad process bija pabeigts?
Pirmkārt, atteikšanās no L2. Mums nav nepieciešams ne īsts, ne emulēts L2. Tas netiek izmantots būtībā tādēļ, ka mēs kontrolējam lietojumprogrammu steku. Mūsu lietojumprogrammas ir horizontāli mērogojamas, tās darbojas ar L3 adresāciju, tās īpaši neuztrauc, ka kāda atsevišķa instance ir izslēgta, vienkārši tiek palaista jauna, kurai nav nepieciešams darboties uz vecās adreses, jo ir atsevišķs līmenis pakalpojumu atklāšanai un uzraudzībai mašīnām, kas atrodas klasterī. Mēs nepārliekam šo uzdevumu uz tīklu. Tīkla uzdevums ir piegādāt paketus no punkta A uz punktu B.
Mums arī nav situāciju, kad adreses pārvietojas tīklā, un tas jāuzrauga. Daudzos dizainos tas parasti ir nepieciešams, lai atbalstītu VM mobilitāti. Mēs neizmantojam virtuālo mašīnu mobilitāti lielā Yandex iekšējā infrastruktūrā, un, turklāt, uzskatām, ka, pat ja tas tiek darīts, tam nevajadzētu notikt ar tīkla atbalstu. Ja tas ir absolūti nepieciešams, tas jārealizē līmeņa viesos un adreses, kas var migrēt, jāievieto apakšslāņos, lai netiktu traucēta un veikti pārāk daudz dinamisku izmaiņu šo derīgās (transporta) tīklā.
Vēl viena tehnoloģija, ko mēs neizmantojam, ir multicast. Vēlētājiem varu detalizēti izskaidrot, kāpēc. Tas ļoti atvieglo dzīvi, jo, ja kāds ar to ir saskāries un skatījies, kā izskatās tieši multicast kontrolēšanas līnija — visās instalācijās, izņemot vissimplākās, tas ir liels galvassāpes. Un vēl, ir grūti atrast labi strādājošu atvērtu īstenojumu, piemēram.
Un visbeidzot, mēs projektējam mūsu tīklus tā, lai tajos notiktu ne pārāk daudz izmaiņu. Mēs varam paļauties uz to, ka ārēju notikumu plūsma maršrutēšanas sistēmā ir neliela.
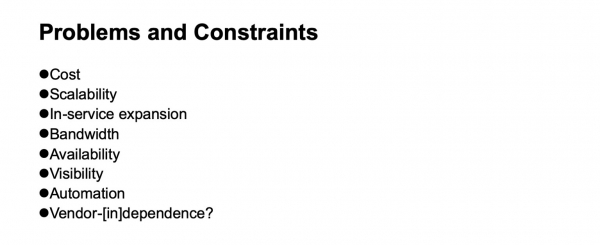
Kādas problēmas var rasties un kādas ierobežojumus jāņem vērā, kad mēs izstrādājam datu centra tīklu? Protams, izmaksas. Izvēršamība, līdz kādam līmenim mēs vēlamies augt. Nepieciešamība paplašināties bez pakalpojuma pārtraukšanas. Joslas platums, pieejamība. Tīkla notikumu redzamība uzraudzības sistēmām un operatīvajām komandām. Automātikas atbalsts — vēlreiz, cik vien tas ir iespējams, jo dažādas uzdevumus var risināt dažādos līmeņos, tostarp ieviešot papildu slāņus. Un, protams, neatkarība no piegādātājiem. Lai gan dažādos vēstures periodos, atkarībā no tā, kāda aspekta skatāmies, šī neatkarība ir bijusi vieglāk vai grūtāk sasniedzama. Ja aplūkojam tīkla ierīču mikroshēmas, tad līdz pēdējam laikam runāt par neatkarību no piegādātājiem, ja mēs vēlējāmies mikroshēmas ar lielu caurlaidspēju, bija ļoti nosacīti.
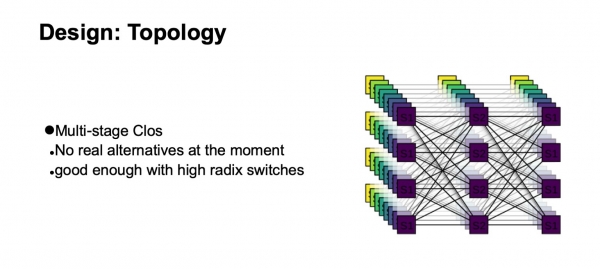
Kura loģiskā topoloģija mēs būsim būvējuši mūsu tīklu? Tā būs daudzlīmeņu Clos. Patiesībā reālu alternatīvu šobrīd nav. Un Clos topoloģija ir pietiekami laba, pat salīdzinot ar dažādām progresīvām topoloģijām, kas patlaban ir vairāk akadēmiskā interešu sfērā, ja mums ir slēdži ar augstu radikālu.
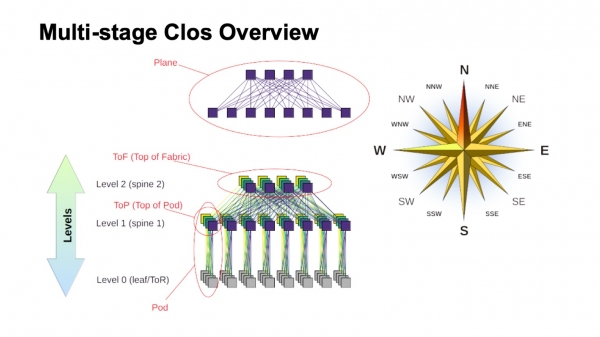
Kā aptuveni ir uzbūvēta daudzlīmeņu Clos tīkla struktūra un kā tajā tiek saukti dažādi elementi? Pirmkārt, vēja roze, lai orientētos, kur ir ziemeļi, kur dienvidi, kur austrumi, kur rietumi. Šāda veida tīklus parasti būvē tie, kam ir ļoti liels satiksmes apjoms starp rietumiem un austrumiem. Attiecībā uz pārējiem elementiem, augšpusē attēlots virtuālais slēdzis, kas izveidots no mazākiem slēdžiem. Tā ir pamata ideja par rekurzīvo Clos tīklu būvi. Mēs ņemam elementus ar kādu radikālu un savienojam tos tā, lai tas, kas radies, varētu tikt uzskatīts par slēdzi ar lielāku radikālu. Ja nepieciešams vēl vairāk, šo procedūru var atkārtot.
Piemēram, dubultstaba Clos gadījumos, kad skaidri var izcelt komponentes, kas manā shēmā ir vertikālas, tās parasti sauc par plāksnēm. Ja mēs veidotu Clos ar trim spain switch līmeņiem (visi, kas nav robežlīnijas un nav ToR slēdži un kas tiek izmantoti tikai pārsūtīšanai), tad plāksnes izskatītos sarežģītāk, divu līmeņu izskatās tieši tā. ToR vai leaf slēdžu bloku un saistītos ar tiem pirmā līmeņa spain slēdžus mēs saucam par Pod. Spain slēdži spain-1 līmenī augšpusē Pod — tas ir top of Pod, Pod virsotne. Slēdži, kas atrodas visa auduma augšdaļā — tas ir augšējais slānis auduma, Top of fabric.
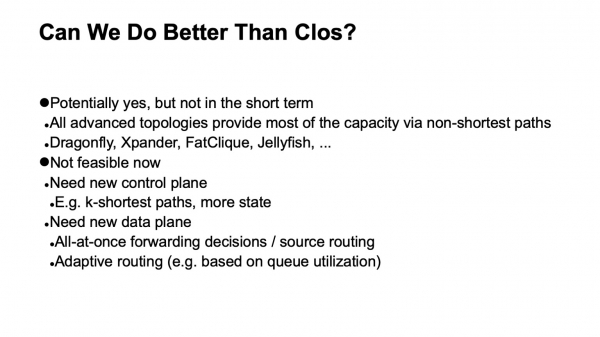
Protams, rodas jautājums: Clos tīklus būvē jau kādu laiku, pati ideja vispār nāk no klasiskās telefona sistēmas, TDM tīkliem. Varbūt ir radies kaut kas labāks, varbūt to var labāk izdarīt? Un jā, un nē. Teorētiski jā, praksē tuvākajā laikā noteikti nē. Jo ir noteikts skaits interesantu topoloģiju, daļa no tām pat tiek izmantotas ražošanā, piemēram, Dragonfly tiek izmantots HPC lietojumos; ir arī interesantas topoloģijas, piemēram, Xpander, FatClique, Jellyfish. Ja paskatāmies uz ziņojumiem konferencēs, piemēram, SIGCOMM vai NSDI pēdējā laikā, varam atklāt diezgan lielu darbu skaitu par alternatīvām topoloģijām, kas ir ar labākām īpašībām (kādām vai citām), salīdzinot ar Clos.
Bet visām šīm topoloģijām ir viena interesanta īpašība. Tā kavē to ieviešanu datu centros, kurus mēs mēģinām būvēt uz standarta aparatūras un kas maksā pietiekami saprātīgas naudas. Visās šajās alternatīvajās topoloģijās lielākā daļa joslas, diemžēl, nav pieejama pa īsākajiem ceļiem. Tāpēc mēs uzreiz zaudējam iespēju izmantot tradicionālo kontrolēšanas plānu.
Teorētiski uzdevuma risinājums ir zināms. Tas, piemēram, ir link state modifikācijas, izmantojot k-shortest path, bet, atkārtoti, nav tādu protokolu, kas būtu realizēti ražošanā un masveidā pieejami aparatūrā.
Turklāt, ņemot vērā, ka lielākā daļa jaudas nav pieejama pa īsākajiem ceļiem, mums jāmodificē ne tikai kontrolplāns, lai tas izvēlētos visus šos ceļus (un, starp citu, tas ir ievērojami lielāks stāvoklis kontrolplānā). Mums arī jāmodificē pārsūtīšanas plāns, un parasti ir nepieciešamas vismaz divas papildu funkcijas. Tas ir, spēja veikt visus lēmumus par pakotņu pārsūtīšanu reizē, piemēram, uz saimniekdatora. Faktiski tas ir avota maršrutēšana, ko dažkārt interkonnekciju tīklu literatūrā dēvē par vis-uz-reiz pārsūtīšanas lēmumiem. Un vēl adaptīvā maršrutēšana — tas ir jau funkcija, kas nepieciešama tīkla elementiem, kas, piemēram, nozīmē, ka mēs izvēlamies nākamo pārlēkšanu, pamatojoties uz informāciju par minimālo sastrēgumu rindā. Kā piemērs, iespējami citi varianti.
Tātad, virziens ir interesants, bet, diemžēl, pašlaik to nevaram pielietot.
Labi, apstāsimies pie loģiskās topoloģijas Clos. Kā mēs to skalosim? Apskatīsim, kā tā ir iekārtota un ko varam darīt.
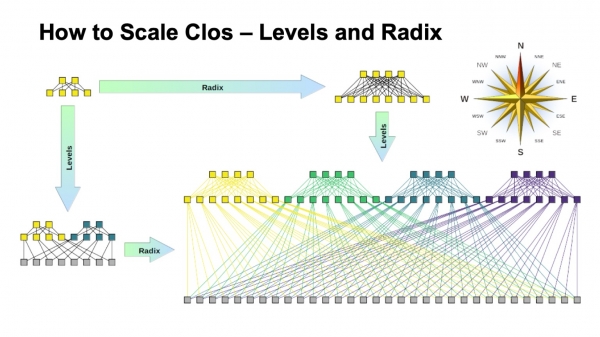
Clos tīklā ir divi galvenie parametri, kurus mēs varam kaut kā variēt un iegūt dažādus rezultātus: elementu radix un līmeņu skaitu tīklā. Man ir shēmiski attēlots, kā tas abi ietekmē izmēru. Ideālā gadījumā kombinējam gan to, gan to.
Redzams, ka galīgā Clos tīkla platums ir spaina slēdžu dienvidu radix produktu pa visiem līmeņiem, tas, cik daudz saitu mums ir uz leju, kā tas zarojas. Tā mēs palielinām tīkla izmēru.
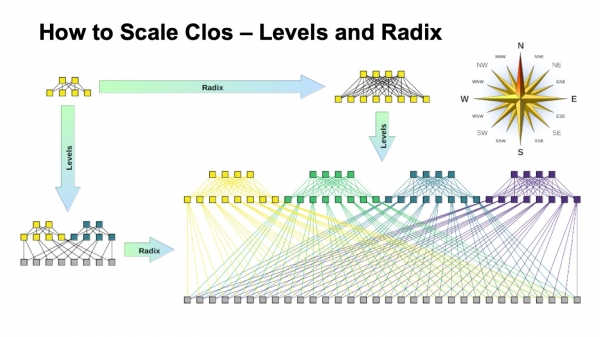
Runājot par jaudu, īpaši ToR slēdžos, šeit ir divi mērogošanas varianti. Mēs varam saglabāt vispārējo topoloģiju, izmantojot ātrākus saišu, vai varam pievienot vairākas lidmašīnas.
Ja paskatāmies uz izvērsto Clos tīkla variantu (labajā apakšējā stūrī) un atgriežamies pie šī attēla ar Clos tīklu apakšā...
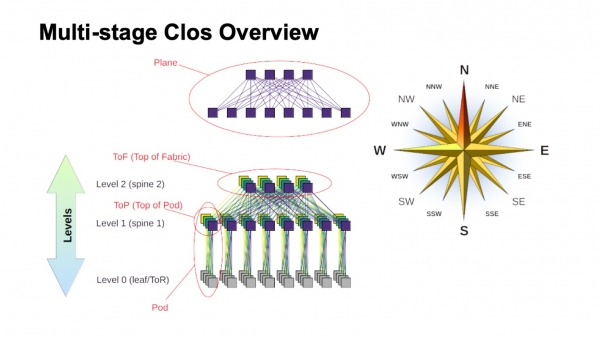
… tad tā ir tieši tā pati topoloģija, bet šajā slaidā tā ir saspiesta kompaktāk, un rūpnīcas lidmašīnas ir uzklātas vienu virs otras. Tas ir viens un tas pats.
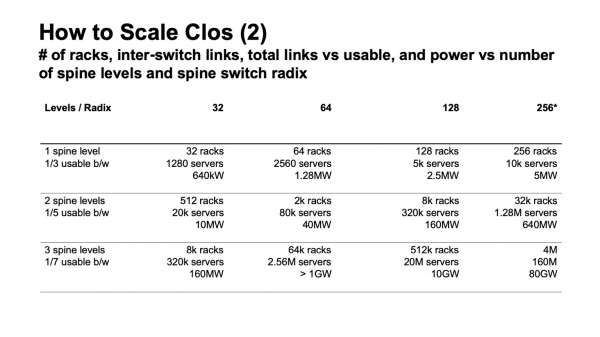
Kā izskatās Clos tīkla mērogošana skaitļos? Šeit ir sniegti dati par maksimālo platumu, ko var iegūt tīkls, maksimālais stacionāro, ToR slēdžu vai leaf slēdžu skaits, ja tie nav stendos, ko mēs varam iegūt atkarībā no tā, kāds ir mūsu slēdžu radix, kas tiek izmantots spaina līmeņiem, un cik daudz līmeņu mēs izmantojam.
Šeit ir norādīts, cik daudz mums var būt stenda, cik daudz serveru un aptuveni cik tas viss var patērēt, ņemot vērā 20 kW uz stendu. Pirms tam es minēju, ka mēs plānojam klasteri ap 100 tūkstošu serveru izmēru.
Redzams, ka visā šajā konstrukcijā ir divi ar pusi varianti, kas ir interesanti. Ir variants ar diviem slāņiem spainu un 64-portu slēdžiem, kas nedaudz pietrūkst. Tad ir lieliski piemēroti varianti 128-portu (ar radikālu 128) spainu slēdžiem ar diviem līmeņiem, vai slēdži ar radikālu 32 un trim līmeņiem. Un visos gadījumos, kad ir lielāks radikāls un vairāk līmeņu, var izveidot ļoti lielu tīklu, bet, ja paskatās uz sagaidāmo patēriņu, parasti tur ir gigavati. Kabeli var novietot, bet tik daudz elektrības vienā vietā mēs visticamāk nesaņemsim. Ja skatās statistiku, publiskos datus par datu centriem — ļoti maz var atrast datu centru ar aprēķināto jaudu virs 150 MW. Tas, kas ir vairāk — parasti ir datu centru kompleksus, daži lieli datu centri, kas ir pietiekami tuvu viens otram.
Ir vēl viens svarīgs parametrs. Ja paskatāties uz kreiso kolonnu, tur ir norādīta izmantojamā joslas platums. Nav grūti pamanīt, ka Clos tīklā ievērojama daļa portu tiek izmantota, lai savienotu slēdžus savā starpā. Izmantojamais joslas platums — tas ir tas, ko var nodot uz āru, serveru virzienā. Protams, es runāju par nosacītajiem portiem un tieši par joslu. Parasti, līnijas iekšējā tīklā ir ātrākas nekā līnijas virzienā uz serveriem, bet uz katru joslu, ko mēs varam izsniegt uz āru uz mūsu serveru iekārtām, attiecas vēl kāda josla iekšējā tīklā. Un jo vairāk līmeņu mēs veidojam, jo lielāki ir speciālie izdevumi, lai nodrošinātu šo joslu uz āru.
Turklāt, pat šī papildu josla nav gluži vienāda. Kamēr pārraides ir īsas, mēs varam izmantot kaut ko līdzīgu DAC (tiešais pieslēgums varš, t.i., twinax kabeļi), vai multimodālo optiku, kas joprojām ir salīdzinoši saprātīgas cenas. Kad mēs pārejam uz garākām pārraidēm — parasti tas ir vienmoda optika, un šo papildu joslu izmaksas būtiski pieaug.
Un atkal, atgriežoties pie iepriekšējā slaida, ja mēs veidojam Clos tīklu bez pārrakstīšanas, tad nav grūti paskatīties uz shēmu, redzēt, kā tiek veidots tīkls – pievienojot katru līmeni spain switch'e, mēs atkārtojam visu to joslu, kas bija zemāk. Plus līmenis – plus visa tā pati josla, vēl tikpat daudz portu uz slēdzējiem, vēl tikpat daudz transiveru. Tāpēc spain switch' līmeņu skaitu ir ļoti ieteicams minimizēt.
Pamatojoties uz šo attēlu, ir skaidrs, ka mēs ļoti vēlamies veidot uz kaut kā līdzīga slēdžiem ar radikālu 128.
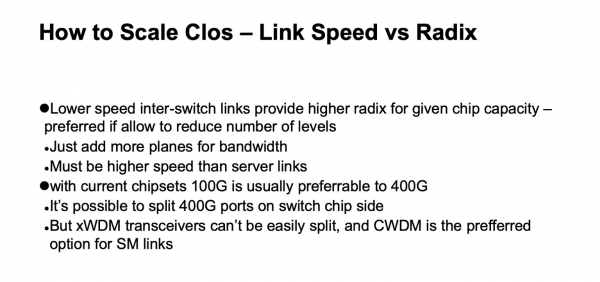
Šeit principā viss ir tāds pats kā es tagad stāstīju, šis slaids ir drīzāk domāts pārdomām vēlāk.
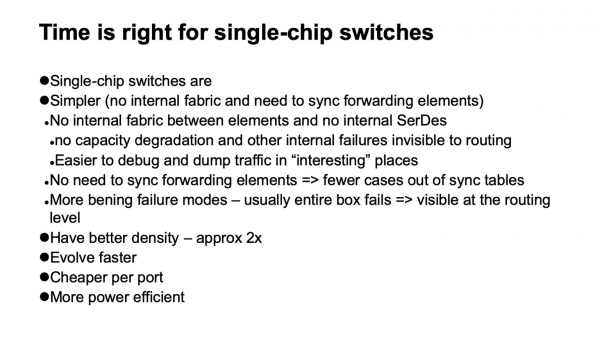
Kādi ir varianti, ko mēs varam izvēlēties kā tādus slēdžus? Ļoti patīkama ziņa mums ir tā, ka tagad tādus tīklus beidzot var būvēt uz vienchip slēdžiem. Un tas ir patiešām lieliski, tiem ir daudz patīkamu īpašību. Piemēram, tiem gandrīz nav iekšējās struktūras. Tas nozīmē, ka tie ir vieglāk salauzāmi. Tie salūst, bez šaubām, bet, par laimi, tie salūst pilnīgi. Moduļu ierīcēs ir daudz nepatīkamu defektu, kad no kaimiņu un kontroles plāna viedokļa tas it kā strādā, bet, piemēram, tam ir pazudusi daļa fabrikas un tas nedarbojas ar pilnu jaudu. Un satiksme uz to tiek līdzsvarota, pamatojoties uz to, ka tas ir pilnībā funkcionāls, un mēs varam saņemt pārslodzes.
Vai, piemēram, rodas problēmas ar backplane, jo iekšējā moduļu ierīcē arī ir augstas ātruma SerDes – tā patiesi ir sarežģīti iekārtota iekšpusē. Vai arī tam sinhronizējas vai nesinhronizējas tabulas starp forwarding elementiem. Kopumā jebkura jaudīga moduļu ierīce, kas sastāv no liela skaita komponentu, iekšpusē parasti satur visu to pašu Clos tīklu, tikai to ir ļoti grūti diagnosticēt. Bieži pat pašam piegādātājam ir grūti diagnosticēt.
Un tam ir liels skaits kļūdu scenāriju, kuros ierīce degradējas, bet pilnībā neiznāk no topoloģijas. Tā kā mūsu tīkls ir liels, aktīvi izmantojam līdzīgu elementu balansēšanu, tīkls ir ļoti regulārs, tas ir, viens ceļš, kur viss ir kārtībā, būtībā neatšķiras no otra ceļa, mums ir izdevīgāk vienkārši zaudēt daļu ierīču no topoloģijas, nekā nonākt situācijā, kad dažas no tām it kā strādā, bet it kā nē.
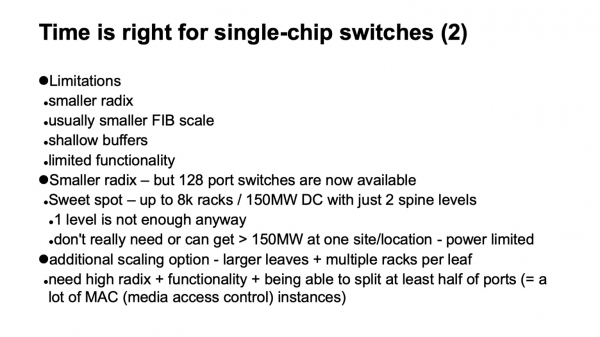
Nākamā patīkamā viena čipa ierīču iezīme — tās labāk attīstās, ātrāk. Tāpat tās parasti ir ar labāku jaudu. Ja ņemam lielas savāktas konstrukcijas, kas mums ir, salīdzinot, tad jauda uz rack-ienību pa portiem ar tādu pašu ātrumu izrādās gandrīz divas reizes labāka nekā modulārām ierīcēm. Ierīces, kas būvētas ap vienu čipu, iznāk ievērojami lētāk nekā modulārās un patērē mazāk enerģijas.
Bet, protams, tas viss nenotiek bez trūkumiem. Pirmkārt, praktiski vienmēr mazāks radikss nekā modulārām ierīcēm. Ja mēs varam iegūt ierīci, kas būvēta ap vienu čipu, ar 128 portiem, tad modulāro ierīču mēs varam iegūt uz dažiem simtiem portu jau tagad bez īpašām problēmām.
Tas ir ievērojami mazāks virzīšanās tabulu izmērs un, parasti, viss, kas saistīts ar datu plūsmas mērogojamību. Sekli buferi. Un, parasti, diezgan ierobežota funkcionalitāte. Bet izrādās, ka, ja pārzinām šos ierobežojumus un laikus rūpējamies par to, lai tos apietu vai vienkārši ņemtu vērā, tas nav tik biedējoši. Fakts, ka radikss ir mazāks, jaunākajos, beidzot parādījušos ierīcēs ar radiksu 128, vairs nav problēma, mēs varam uzbūvēt divos slāņos. Ar vienu līmeni sanāk pavisam sīki klasteri. Pat iepriekšējie mūsu dizaini un prasības tomēr tos pārsniedza.
Patiesībā, ja risinājums ir uz robežas, ir vēl viens veids, kā paplašināties. Tā kā pēdējais (vai pirmais) līmenis, pie kura pieslēdzas serveri, ir ToR slēdži vai leaf slēdži, mēs neesam spiesti pieslēgt pie tiem tikai vienu stendu. Tāpēc, ja risinājums ir divas reizes par zemu, var padomāt par to, lai vienkārši izmantotu slēdzi ar lielāku radix apakšējā līmenī un pieslēgt, piemēram, divus-trīs stendus vienā slēdžā. Tas arī ir variants, tam ir savas izmaksas, bet tas noteikti darbojas un var kļūt par labu risinājumu, kad ir nepieciešams palielināt kapacitāti divas reizes.
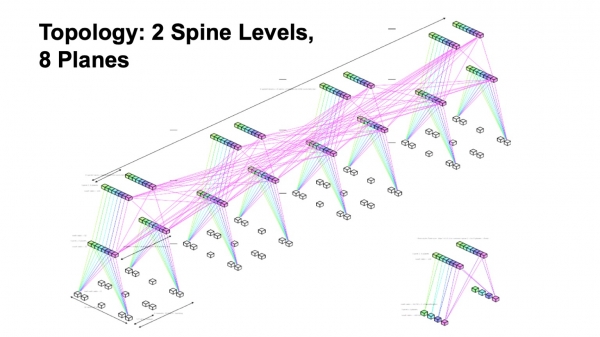
Kopsavelkot, mēs veidojam topoloģiju ar diviem līmeņiem spainu, ar astoņiem fabrikas slāņiem.
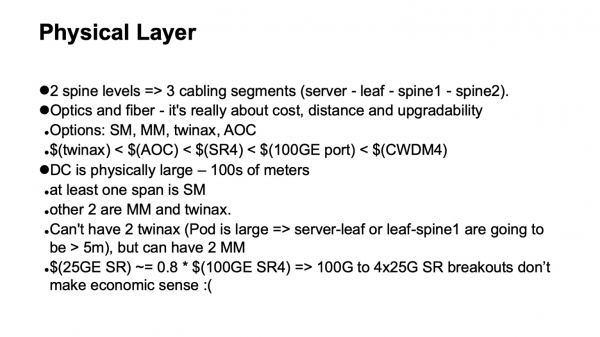
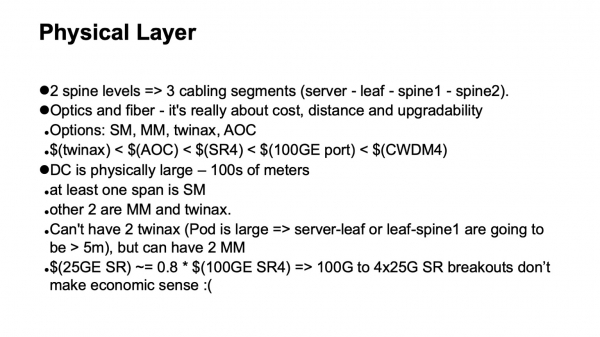
Kāda būs fizika? Ļoti vienkārši aprēķini. Ja mums ir divi spainu līmeņi, tad mums ir kopumā trīs slēdžu līmeņi, un mēs sagaidām, ka tīklā būs trīs kabeļu segmenti: no serveriem uz leaf slēdžiem, uz spaini 1, uz spaini 2. Iespējas, kuras mēs varam izmantot, ir twinax, multimode, single mode. Un šeit jāņem vērā, kāda josla ir pieejama, cik tas maksās, kādi ir fiziskie izmēri, kādi spraugām varam iziet, un kā mēs plānosim atjaunot aprīkojumu.
Attiecībā uz izmaksām visu var izkārtot rindiņā. Twinax ir ievērojami lētāki nekā aktīvā optika, lētāki nekā multimode pārveidotāji, ja skatāmies pēc slēdžā gala, nedaudz lētāki nekā 100-gigabitu slēdža ports. Un, uzmanību, tas ir lētāks nekā single mode optika, jo slēgumos, kur nepieciešama single mode, datu centros ir jēgpilni izmantot CWDM, ar paralēlo single mode (PSM) strādāt nav ļoti ērti, rodas ļoti lielas šķiedru pakas, un, ja apstājamies pie šīm tehnoloģijām, iegūstam apmēram šādu cenu hierarhiju.
Vēl viens novērojums: diemžēl nav izdevies izmantot saliktos 100 k 4x25 multimode portus. Sakarā ar SFP28 pārveidotāju konstrukcijas īpatnībām tie nav daudz lētāki nekā QSFP28 uz 100 Gbit. Un šī sadalīšana multimode nedarbojas ļoti labi.
Vēl viens ierobežojums ir tas, ka, ņemot vērā datu centru lielumu un serveru skaitu, mūsu datu centri fiziski ir lieli. Tas nozīmē, ka vismaz vienu posmu būs jādara ar vienmodu šķiedru. Atkal, ņemot vērā Pods fizisko lielumu, nevarēs iet divus posmus ar twinax kabeļiem.
Tātad, ja optimizējam cenas ziņā un apsveram šīs konstrukcijas ģeometriju, mēs iegūstam vienu posmu ar twinax, vienu posmu ar multimodu un vienu posmu ar vienmodu izmantojot CWDM. Tas ņem vērā iespējamos uzlabojumu ceļus.
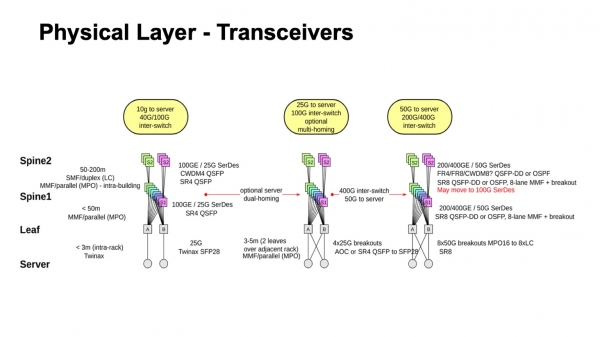
Tā izskatās, ko mēs nesen piedzīvojām, kur mēs virzāmies un kas ir iespējams. Ir skaidrs, vismaz, kā virzīties uz 50-gigabita SerDes gan multimodam, gan vienmodam. Turklāt, ja paskatāmies uz to, kas patlaban ir vienmodu transīveros un nākotnes 400G, bieži vien, kad 50G SerDes ierodas no elektriskās puses, optikā var nonākt jau 100 Gbps uz sliedi. Tāpēc ir pilnīgi iespējams, ka, vietā pārejai uz 50, notiks pāreja uz 100-gigabita SerDes un 100 Gbps uz sliedi, jo daudzi piegādātāji sola, ka to pieejamība gaidāma diezgan drīz. Laiks, kad 50G SerDes bija visātrākie, šķiet, nebūs ļoti ilgs, jo 100G SerDes pirmās vienības tiek izlaistas nākamgad. Un pēc kāda laika pēc tam, iespējams, tie maksās saprātīgas naudas.
Vēl viens aspekts attiecībā uz fizikas izvēli. Principā jau tagad mēs varam izmantot 400- vai 200-gigabita portus ar 50G SerDes. Bet izrādās, ka tam nav īpaša jēga, jo, kā es jau stāstīju iepriekš, mēs vēlamies pietiekami lielu radikusu slēdzējos, protams, saprātīgās robežās. Mēs vēlamies 128. Un, ja mūsu čipa kapacitāte ir ierobežota un mēs palielinām linka ātrumu, tad radikuss, protams, samazinās, nav brīnumu.
Un kopējo jaudu mēs varam palielināt, pievienojot līmeņus, un šajā gadījumā nav īpašu izmaksu, var pievienot līmeņu skaitu. Un, ja mēs zaudējam radikusu, mums būs jāpievieno papildu līmenis, tāpēc pie pašreizējiem aprēķiniem, pie pašreizējās maksimāli pieejamās jaudas uz vienu čipu, izrādās, ka efektīvāk ir izmantot 100-gigabita portus, jo tie ļauj iegūt lielāku radikusu.
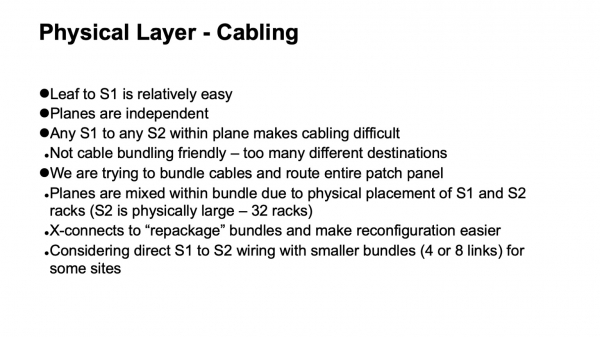
Nākamais jautājums ir, kā ir organizēta fizika, bet jau no kabeļu infrastruktūras viedokļa. Izrādās, ka tā ir organizēta samērā interesanti. Kabeļi starp leaf slēdžiem un pirmā līmeņa spine slēdžiem — tur nav tik daudz savienojumu, viss tiek veidots salīdzinoši vienkārši. Bet, ja mēs ņemam vienu plakni, tad, kas notiek iekšpusē — tur ir jāapvieno visi pirmā līmeņa spine ar visiem otrā līmeņa spine.
Turklāt, parasti ir noteikti vēlējumi par to, kāam tas jāizskatās datu centrā. Piemēram, mums ļoti gribējās apvienot kabeļus bundļos un vilkt tos tā, lai viens augstas blīvuma patch panel dotos pilnībā uz vienu patch panel, lai nebūtu haoss garumos. Mums izdevās atrisināt šo uzdevumu. Ja sākotnēji aplūko loģisko topoloģiju, tad ir redzams, ka plaknes ir neatkarīgas, katra plakne var tikt veidota pati par sevi. Bet, kad mēs pievienojam tādu bundling un vēlamies pilnībā vilkt patch panel uz patch panel, tad nākas vienā bundlī sajaukt dažādas plaknes un ieviest starpposma konstrukciju optiskos cross-connects veidā, lai pārpakotu tās no tā, kā tās bija savāktas vienā segmentā, uz to, kā tās tiks savāktas citā segmentā. Pateicoties tam, mēs iegūstam patīkamu īpašību: visa sarežģītā komutācija neiznāk ārpus stendiem. Kad nepieciešams kaut ko ļoti sasiet, "atvērt plaknes", kā to reizēm sauc Clos tīklos, tas viss ir koncentrēts vienā stendā. Mums nav ļoti izsistām, līdz individuālām savienojumiem, komutācijām starp stendiem.
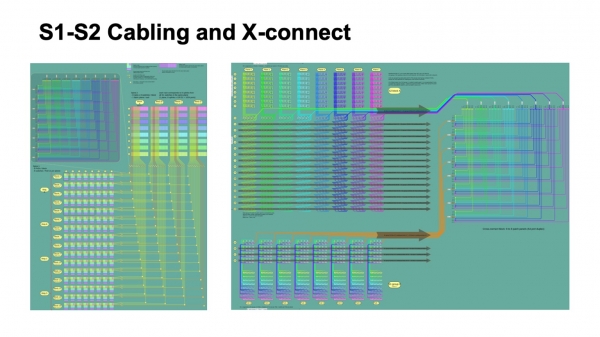
Tā tas izskatās no loģiskās kabeļu infrastruktūras organizācijas viedokļa. Attēlā pa kreisi krāsainie bloki attēlo pirmā līmeņa spine slēdžu blokos, pa astoņiem katrā, un no tiem nāk četri kabeļu bundļi, kas iet un krusto citu bundļu gaitu, kas nāk no spine-2 slēdžiem.
Mazie kvadrāti norāda krustpunktus. Augšējā kreisajā pusē ir katra no šiem krustpunktiem izvēršanās, kas patiesībā ir krustojuma modulis ar 512 uz 512 portiem, kas pārpakāti kabeļus tā, lai tie nonāktu pilnīgi vienā stendā, kur tikai ir viena spine-2 plakne. Un labajā pusē ir šīs bildes nedaudz detalizētāka izvēršanās attiecībā uz vairākiem Pods spine-1 līmenī, un kā tas iepakots krustojumā, kā tas nonāk spine-2 līmenī.
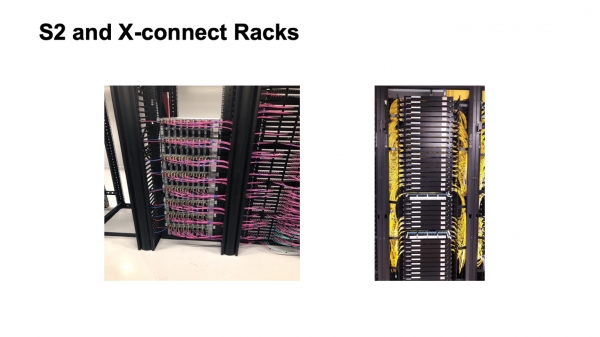
Tā tas izskatās. Nepilnīgi vēl salikts spine-2 stends (kreisajā pusē) un krustojuma stends. Diemžēl tur nav pārāk daudz redzams. Visa šī konstrukcija tiek izvērsta šobrīd vienā no mūsu lielajiem datu centriem, kas paplašinās. Tas ir darbs procesā, tas izskatīsies labāk, būs labāk piepildīts.
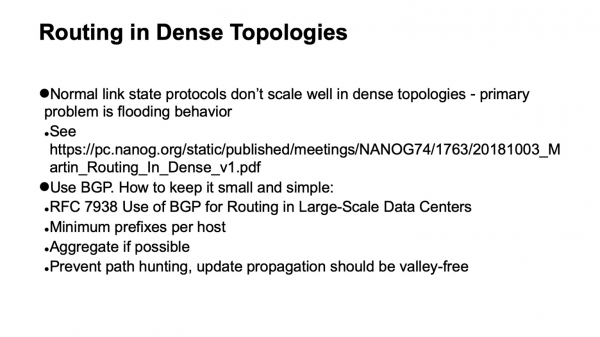
Svarīgs jautājums: izvēlēta loģiskā topoloģija, uzbūvēta fizika. Kas notiks ar kontrolēšanas plānu? No pieredzes ekspluatācijā ir labi zināms, ka link state protokoli ir labi, tos ir patīkami lietot, taču diemžēl blīvā savienojuma topoloģijā tie slikti mērogojas. Un ir viens galvenais faktors, kas tam traucē — kā darbojas plūsmu vadība link state protokolos. Ja vienkārši ņemsim plūsmu algoritmu, apskatīsim, kā ir iekārtota mūsu tīkla, redzams, ka katrā soli būs ļoti liels pieaugums, un tas vienkārši appludina kontrolēšanas plānu ar atjauninājumiem. Tieši šādām topoloģijām ar tradicionālo plūsmu algoritmu link state protokolos ir ļoti slikta sadarbība.
Izvēle — izmantot BGP. Kā to pareizi sagatavot, ir aprakstīts RFC 7938 par BGP izmantošanu lielos datu centros. Pamata idejas ir vienkāršas: minimālais prefiksu skaits uz saimniekdatoru un vispār minimālais prefiksu skaits tīklā, izmantot agregāciju, ja tas ir iespējams, un apslāpēt ceļa meklēšanu. Mēs vēlamies ļoti precīzu, ļoti kontrolētu atjauninājumu izplatīšanu, ko sauc par valley free. Mēs vēlamies, lai atjauninājumi, ceļojot pa tīklu, tiktu izplatīti tieši vienu reizi. Ja tie sākas no apakšas, tie virzās uz augšu, izplatās ne vairāk kā vienu reizi. Nebūs zigzag, zigzagi ir ļoti slikti.
Lai to izdarītu, mēs izmantojam diezgan vienkāršu shēmu, lai izmantotu pamatmehānismus BGP. Tas nozīmē, ka mēs izmantojam eBGP, kas darbojas uz link local, un autonomās sistēmas tiek piešķirtas šādā veidā: autonomā sistēma uz ToR, autonomā sistēma visam spain 1 slēdžu blokam vienā Podā, un kopējā autonomā sistēma visam Top of Fabric. Nav grūti paskatīties un pārliecināties, ka šajā gadījumā pat normāla BGP uzvedība sniedz mums to atjauninājumu izplatīšanu, kādu mēs vēlamies.
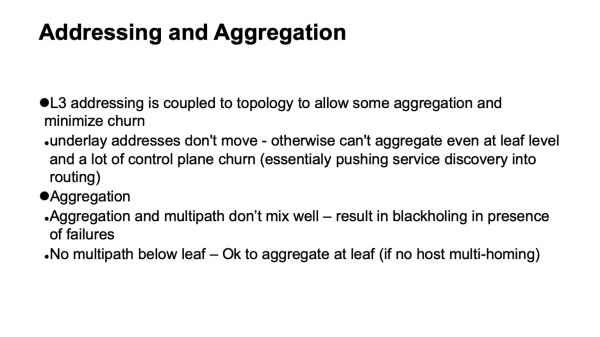
Protams, ir nepieciešams projektēt adresāciju un adreses agregāciju tā, lai tas būtu saderīgs ar to, kā ir būvēta maršrutēšana, lai nodrošinātu control plane stabilitāti. L3 adresācija transportā ir saistīta ar topoloģiju, jo bez tā nav iespējams sasniegt agregāciju, bez tā individuālās adreses iekļūs maršrutēšanas sistēmā. Un vēl viena lieta — agregācija, diemžēl, nesajaucas ar multi-path, jo, kad mums ir multi-path un ir agregācija, viss ir labi, kamēr visa tīkls ir funkcionāls, tajā nav traucējumu. Diemžēl, tiklīdz tīklā parādās traucējumi un simetrija topoloģijā tiek zaudēta, mēs varam nonākt punktā, no kura tika izsludināta agregācija, no kuras nav iespējams doties tālāk, kur mums nepieciešams. Tādēļ vislabāk agregēt tur, kur tālāk nav multi-path, mūsu gadījumā tas ir ToR slēdži.
Patiesībā, agregēt ir iespējams, bet uzmanīgi. Ja mēs varam izdarīt kontrolētu deagregāciju, kad tīklā parādās traucējumi. Bet tā ir diezgan sarežģīta uzdevums, mēs pat bijām novērtējuši, vai to var izdarīt, vai var pievienot papildu automātiku un galīgus automātus, kas pareizi aktivizētu BGP, lai iegūtu nepieciešamo uzvedību. Diemžēl corner cases apstrāde ir ļoti neobjektīva un sarežģīta, un, pievienojot BGP ārējās ierīces, šis uzdevums labi netiek risināts.
Ļoti interesants darbs šajā plānā ir veikts RIFT protokola ietvaros, par ko tiks runāts nākamajā ziņojumā.
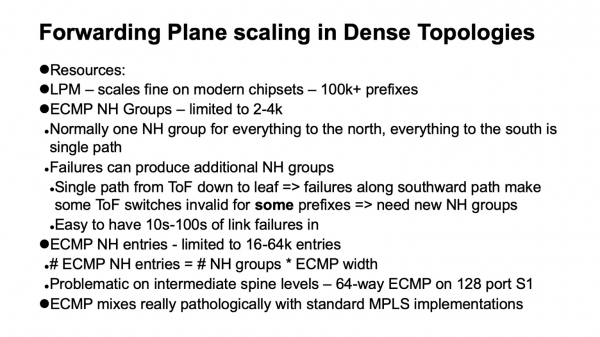
Vēl viena svarīga lieta ir tā, kā datu plūsmas tiek skalētas blīvās topoloģijās, kur ir liels alternatīvo ceļu skaits. Šajā procesā tiek izmantotas vairākas papildu datu struktūras: ECMP grupas, kas, savukārt, apraksta Next Hop grupas.
Normālās darbības tīklā, kas darbojas bez traucējumiem, kad mēs virzāmies pa Clos topoloģiju uz augšu, pietiek izmantot tikai vienu grupu, jo viss, kas nav lokāli, tiek aprakstīts ar noklusējumu, var virzīties uz augšu. Kad mēs virzāmies no augšas uz leju uz dienvidiem, tad visi ceļi nav ECMP, tie ir vienpavadījuma ceļi. Viss ir kārtībā. Problēma ir tā, un klasiskās Clos topoloģijas īpatnība ir tā, ka, ja mēs skatāmies uz auduma augšējo daļu, uz jebkuru elementu, līdz jebkuram elementam apakšā tam ir viens ceļš. Ja pa šo ceļu notiek traucējumi, tad tieši šis elements auduma augšā kļūst nederīgs tieši attiecībā uz tiem prefiksiem, kas atrodas aiz bojātā ceļa. Bet pārējiem tas ir derīgs, un mums ir jāizvērtē ECMP grupas un jāievieš jauns stāvoklis.
Kā izskata datu plūsmas mērogojamību modernajos ierīcēs? Ja mēs veicam LPM (garākais prefiksa sakritība), viss ir salīdzinoši labi, vairāk nekā 100 tūkstoši prefiksu. Ja runājam par Next Hop grupām, tad situācija ir sliktāka - 2–4 tūkstoši. Ja runājam par tabulu, kas satur Next Hops (vai pieslēgšanās aprakstu), tad tas ir apmēram no 16 tūkstošiem līdz 64 tūkstošiem. Un tas var kļūt par problēmu. Un šeit mēs nonākam pie interesanta atkāpes: kas notika ar MPLS datu centros? Principā, mēs to vēlējāmies īstenot.
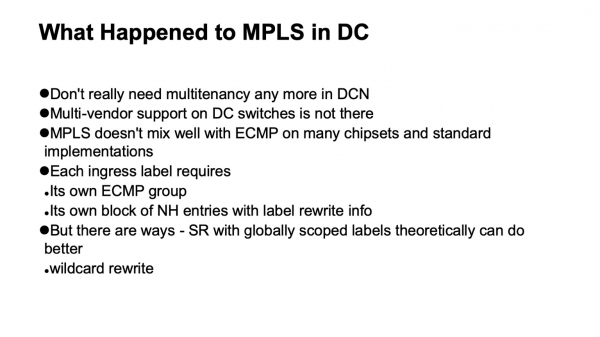
Notika divas lietas. Mēs izveidojām mikrosegmentāciju hostos, un mums vairs nevajadzēja to darīt tīklā. Atbalsts no dažādiem piegādātājiem, kā arī atvērtās realizācijas uz baltajiem lodziņiem ar MPLS, nebija pārāk labs. Un savukārt MPLS, vismaz tās tradicionālās realizācijas, diemžēl ļoti slikti sakrīt ar ECMP. Un tieši tāpēc.
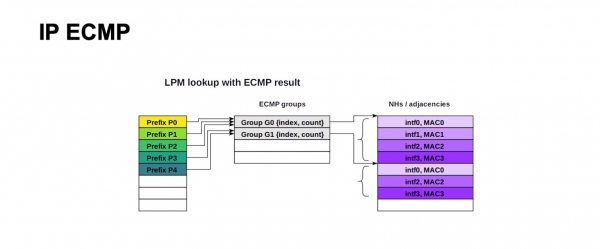
Tā izskatās ECMP maršrutēšanas struktūra IP. Liels skaits prefiksu var izmantot to pašu grupu un to pašu Next Hops bloku (vai pieslēgšanās, dažādā dokumentācijā dažādām ierīcēm to var saukt dažādi). Jēga ir tāda, ka tas tiek aprakstīts kā izejas ports un uz ko pārrakstīt MAC adresi, lai nokļūtu pareizajā Next Hop. IP viss izskatās vienkārši - var izmantot ļoti lielam prefiksu skaitam to pašu grupu, to pašu Next Hops bloku.
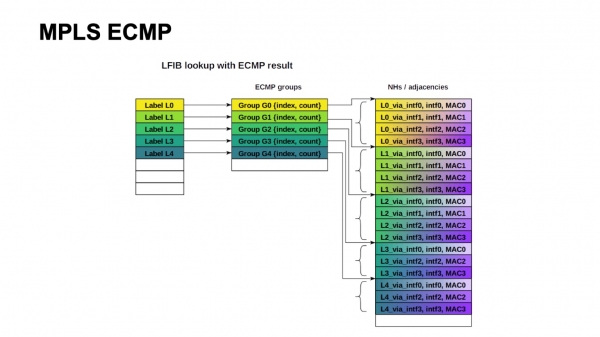
Klasiskā MPLS arhitektūra paredz, ka, atkarībā no izejošā interfeisa, etiķete var tikt pārrakstīta uz dažādām vērtībām. Tāpēc mums ir jāuztur katrai ienākošajai etiķetei grupa un Next Hops bloks. Un tas, diemžēl, nav mērogojams.
Nav nevajag grūti pārlūkot, ka mūsu konstrukcijai bija nepieciešami apmēram 4000 ToR slēdžu, maksimālais platums — 64 ECMP ceļi, ja pāriet no spiny-1 uz spiny-2. Mēs grūtībā iekļaujamies vienā ECMP grupu tabulā, ja vienam prefiksam ar ToR ir izeja, un vispār neiekļaujamies Next Hops tabulā.
Viss nav bezcerīgi, jo Segment Routing tipa arhitektūra paredz globālās atzīmes. Formāli būtu iespējams atkārtoti apvienot visus šos Next Hops blokus. Tam nepieciešama operācija, kas līdzīga wild card: ņemt atzīmi un pārrakstīt uz to pašu bez konkrētas vērtības. Bet, diemžēl, pieejamās realizācijas to neakceptē ļoti labi.
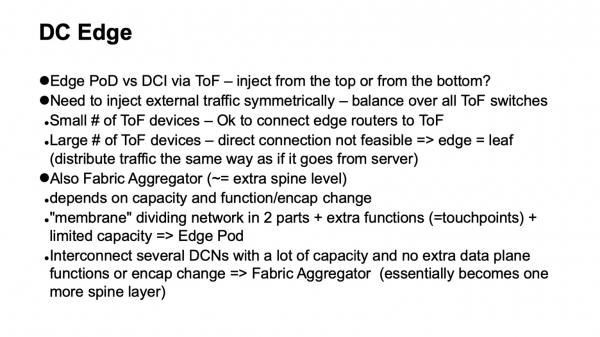
Un visbeidzot, mums jānodrošina ārējā trafika ievade datu centrā. Kā to izdarīt? Agrāk trafiku šajā Clos tīklā ievadīja no augšas. T.i., bija robežmaršrutētāji, kas pievienojās visiem ierīcēm Top of fabric. Šī risinājuma darbība ir diezgan laba mazā un vidējā izmēra tīklos. Diemžēl, lai ievadītu trafiku simetriski visā tīklā, ir nepieciešams piekļūt visiem Top of fabric elementiem vienlaikus, un, kad tie skaita pārsniedz simtu, izrādās, ka mums ir nepieciešams liels radikāls pat robežmaršrutētājiem. Kopumā tas maksā naudu, jo robežmaršrutētāji ir funkcionālāki, to porti būs dārgāki, un rezultātā veidojas ne visai patīkama konstrukcija.
Cits variants — ievadīt šādu trafiku no apakšas. Nav grūti pārliecināties, ka Clos topoloģija ir uzbūvēta tā, ka trafiks, kas nāk no apakšas, t.i., no ToR, vienmērīgi izplatās pa slāņiem visā Top of fabric divu iterāciju laikā, noslogojot visu tīklu. Tāpēc mēs iepazīstinām ar speciālu Pod veidu, Edge Pod, kas nodrošina ārējo savienojamību.
Ir ir vēl viena opcija. Piemēram, tā rīkojas Facebook. Viņiem tas saucas Fabric Aggregator vai HGRID. Tiek ieviesta papildu spine-tīkla līmenis, lai savienotu vairākus datu centrus. Šāda konstrukcija ir iespējama, ja mums nav papildu funkciju vai kapsulācijas maiņas krustojumos. Ja tās ir, tas ir papildu touch points, kas padara to sarežģīti. Parasti rodas vairāk funkciju un sava veida membrāna, kas nodala dažādas datu centra daļas. Veidot šādu membrānu lielu nevajadzētu, bet, ja tā kaut kādā veidā ir ļoti nepieciešama, tad ir jēga apsvērt iespēju to pārvietot, padarīt pēc iespējas plašāku un pārvietot uz hostiem. Tā rīkojas, piemēram, daudzi mākoņa operātori. Viņiem ir overlays, kas sākas no hostiem.
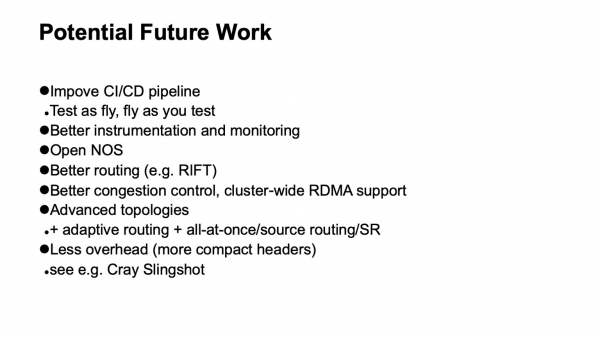
Kādas mēs redzam attīstības iespējas? Pirmkārt — CI/CD cauruļvadu atbalsta uzlabošana. Mēs vēlamies lidot tā, kā testējam, un testēt tā, kā lidot. Tas neizdodas pārāk labi, jo infrastruktūra ir liela, un to dubultot testiem nav iespējams. Jāizprot, kā iekļaut testēšanas elementus darba infrastruktūrā, neradot tās sabrukumu.
Labākā instrumentācija, labākais monitors praktiski nekad nav lieks. Viss jautājums ir līdzsvarā starp pūlēm un peļņu. Ja var saprātīgā kārtā pievienot — ļoti labi.
Atvērtās operētājsistēmas tīkla ierīcēm. Labākie protokoli un labākās maršrutēšanas sistēmas, piemēram, RIFT. Tāpat nepieciešami pētījumi par labāko congestion control shēmu pielietojumu un, iespējams, atbalsta RDMA ieviešana vismaz dažos punktos klasterī.
Ja skatāmies ar skatu uz tālāko nākotni, tad nepieciešamas progresīvas topoloģijas un, iespējams, tīkla risinājumi ar mazāku overhead. No jaunākajiem izstrādājumiem — nesen tika publicēti raksti par tehnoloģijām HPC Cray Slingshot rūpnīcās, kuru pamatā ir komerciālais Ethernet, bet ar iespēju izmantot daudz īsākus galvenes. Tā rezultātā overhead samazinās.
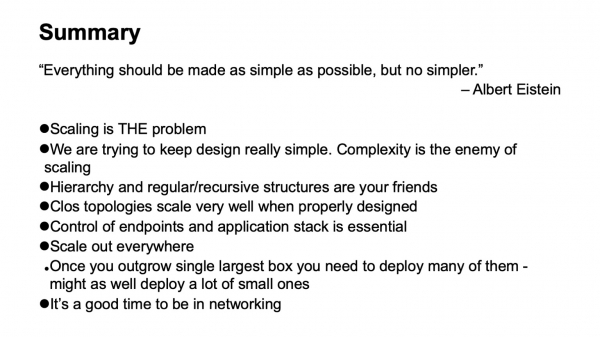
Visam jābūt tik vienkāršam, cik iespējams, bet ne vienkāršākam. Sarežģītība ir mērogojamības ienaidnieks. Vienkāršība un regulāras struktūras ir mūsu draugi. Ja ir iespēja veidot scale out — dariet to. Un tiešām, tagad ir lieliski nodarboties ar tīkla tehnoloģijām. Notiek daudz interesanta. Paldies.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish