

Klienti arvien biežāk vaicā: «Vēlamies kā Amazon RDS, bet lētāk»; «Vēlamies kā RDS, bet visur, jebkurā infrastruktūrā». Lai realizētu līdzīgu pārvaldītu risinājumu uz Kubernetes, mēs aplūkojām pašreizējo populārākā PostgreSQL operatoru stāvokli (Stolon, operatori no Crunchy Data un Zalando) un izdarījām savu izvēli.
Šis raksts ir mūsu iegūtā pieredze, gan no teorētiskā viedokļa (risinājumu apskats), gan no praktiskā aspekta (kas tika izvēlēts un kādi bija rezultāti). Bet vispirms noskaidrosim, kādi vispār ir prasības potenciālajai RDS aizvietotājai …
Kas ir RDS?
Kad cilvēki runā par RDS, pēc mūsu pieredzes, viņi domā par pārvaldītu (managed) DB serveru, kas:
- ir viegli konfigurējams;
- ir iespēja strādāt ar snapshot un atjaunoties no tiem (vēlams ar atbalstu );
- ļauj izveidot master-slave topoloģijas;
- ir bagāts paplašinājumu saraksts;
- nodrošina auditēšanu un lietotāju/piekļuves pārvaldību.
Runājot vispārīgi, uzdevuma īstenošanas pieejas var būt diezgan dažādas, tomēr ceļš ar nosacīto Ansible mums nav tuvs. (Līdzīgā secinājumā nonāca arī kolēģi no 2GIS savas izveidot «rīku ātrai kļūdu tolerantu klastra izvietošanai uz Postgres».)
Tieši operatori ir vispārpieņemta pieeja līdzīgu uzdevumu risināšanai Kubernetes ekosistēmā. Sīkāk par tiem saistībā ar datu bāzēm, kas tiek palaistas Kubernetes iekšienē, jau stāstīja Flanta tehniskais direktors, , vienā no saviem ziņojumiem .
Piezīmeshell-operator PostgreSQL ir vairāki populāri K8s operatori:
Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
- Apskatīsim tos tuvāk.
Operatora izvēle
Papildus tām svarīgajām iespējām, kas jau minētas iepriekš, mēs — kā infrastruktūras inženieri Kubernetes vidē — arī gaidījām no operatoriem sekojošo:
implementāciju no Git un ar
- Custom Resources ;
- node affinity vai node selector uzstādīšana;
- tolerances uzstādīšana;
- tuning iespēju pieejamība;
- .
- saprotamas tehnoloģijas un pat komandas.
Neiedziļinoties detaļās par katru no punktiem (jautājiet komentāros, ja pēc visu rakstu izlasīšanas paliek jautājumi), atzīmēsim kopumā, ka šie parametri ir nepieciešami, lai precīzāk aprakstītu klastera mezglu specializāciju, lai tos varētu pasūtīt konkrētām lietojumprogrammām. Tā mēs varam sasniegt optimālu līdzsvaru starp veiktspēju un izmaksām.
Tagad — pie pašu PostgreSQL operatoriem.
1. Stolon
no itāļu uzņēmuma Sorint.lab tika apskatīts kā noteikts etalons starp operatoriem datu bāzēm. Tas ir salīdzinoši vecs projekts: tā pirmā publiskā versija notika jau 2015. gada novembrī(!), un GitHub repozitorija var lepoties ar gandrīz 3000 zvaigznēm un vairāk nekā 40 kontribūtoriem.
Un patiešām, Stolon ir izcils pārdomātas arhitektūras piemērs:
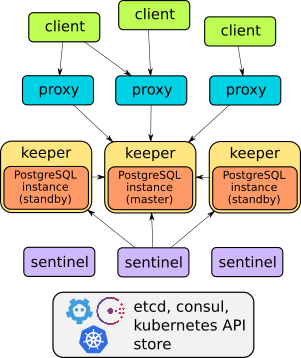
Ar šī operatora ierīkošanu detalizēti var iepazīties ziņojumā vai . Kopumā pietiek teikt, ka tas prot visu iepriekš aprakstīto: failover, proxy caurspīdīgai klientu piekļuvei, dublējumus… Un, kas interesanti, proxy nodrošina piekļuvi caur vienu pakalpojumu gala punktu — atšķirībā no diviem citiem risinājumiem, kas tiks aplūkoti tālāk (tiem ir divi pakalpojumi piekļuvei datu bāzei).
Tomēr Stolon , kā rezultātā to nevar tā izvietot, lai vienkārši un ātri — "kā karstus pīrādziņus" — izveidotu datu bāzu instancēs Kubernetes. Vadība tiek veikta, izmantojot utilītu stolonctl, izvietošana — caur Helm chart, bet lietotāju definīcijas tiek noteiktas ConfigMap.
No vienas puses, iznāk, ka operators īsti nav operators (galu galā tas neizmanto CRD). Bet no otras puses — tā ir elastīga sistēma, kas ļauj konfigurēt resursus K8s tā, kā jums ērtāk.
Kopumā, personīgi mums tas nešķita optimāls ceļš izveidot atsevišķu chart katrai datu bāzei. Tāpēc sākām meklēt alternatīvas.
2. Crunchy Data PostgreSQL Operator
, jauna amerikāņu starta uzņēmuma, izskatījās kā loģiska alternatīva. Tā publiskā vēsture sākas ar pirmo izdošanu 2017. gada martā, kopš tā laika GitHub repozitorijs ir ieguvis nedaudz mazāk nekā 1300 zvaigznes un vairāk nekā 50 kontribūtoriem. Pēdējā izdošana septembrī tika pārbaudīta darbam ar Kubernetes 1.15—1.18, OpenShift 3.11+ un 4.4+, GKE un VMware Enterprise PKS 1.3+.
Crunchy Data PostgreSQL Operator arhitektūra arī atbilst deklarētajām prasībām:
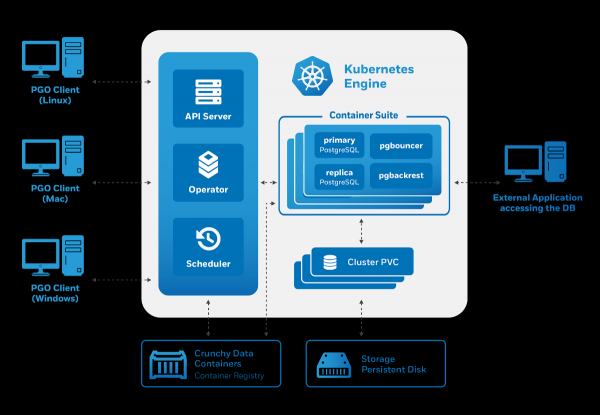
Pārvaldība notiek caur utilītu pgo, tomēr tā savukārt ģenerē pielāgotos resursus Kubernetes. Tāpēc mūs kā potenciālos lietotājus operators iepriecināja:
- ir pārvaldība caur CRD;
- ērta lietotāju pārvaldība (tāpat caur CRD);
- integrācija ar citiem komponentiem — specializēta konteineru attēlu kolekcija PostgreSQL un rīku izmantošanai ar to (ieskaitot pgBackRest, pgAudit, paplašinājumus no contrib utt.).
Tomēr mēģinājumi sākt izmantot Crunchy Data operatoru atklāja vairākas problēmas:
- Nebija iespējams izmantot tolerances — bija pieejams tikai nodeSelector.
- Izveidotie pod’i bija daļa no Deployment’a, neskatoties uz to, ka mēs izvietojām stateful lietojumu. Atšķirībā no StatefulSet, Deployment’i nespēj izveidot diskus.
Pēdējais trūkums noved pie smieklīgām situācijām: testēšanas vidē izdevās palaist 3 replikas ar vienu disku vietējā krātuvē, tā rezultātā operators ziņoja, ka 3 replikas darbojas (lai gan tā nebija patiesība).
Vēl viena šī operatora iezīme ir tā gatavā integrācija ar dažādām palīgierīcēm. Piemēram, viegli uzstādīt pgAdmin un pgBounce, bet tiek apsvērti iepriekš konfigurētie Grafana un Prometheus. Nesenajā atsevišķi tiek uzsvērta uzlabotā integrācija ar projektu , pateicoties kuram operators piedāvā vizuālu metrikas skatījumu par PgSQL "no kastes".
Tomēr dīvainais ģenerēto Kubernetes resursu izvēle noveda mūs pie nepieciešamības meklēt citu risinājumu.
3. Zalando Postgres Operators
Zalando produkti mums ir zināmi ilgu laiku: ir pieredze ar Zalenium un, protams, mēs esam izmēģinājuši — viņu populāro HA risinājumu PostgreSQL. Par uzņēmuma pieeju stāstīja viens no tā autoriem — Aleksejs Kļukins — ēterā , un tas mums iepatikās.
Šis ir jaunākais risinājums no apskatītajiem šajā rakstā: pirmais releases notika 2018. gada augustā. Tomēr, pat neskatoties uz nelielo formālo releases skaitu, projekts ir veicis lielu ceļu, jau apsteidzot Crunchy Data risinājumu ar 1300+ zvaigznēm GitHub un maksimālo devēju skaitu (70+).
"Zem vāka" šī operatora izmanto laika pārbaudītus risinājumus:
- Patroni un operācijām,
- — rezerves kopijām,
- — kā savienojumu baseins.
Tā izskatās Zalando operatora arhitektūra:
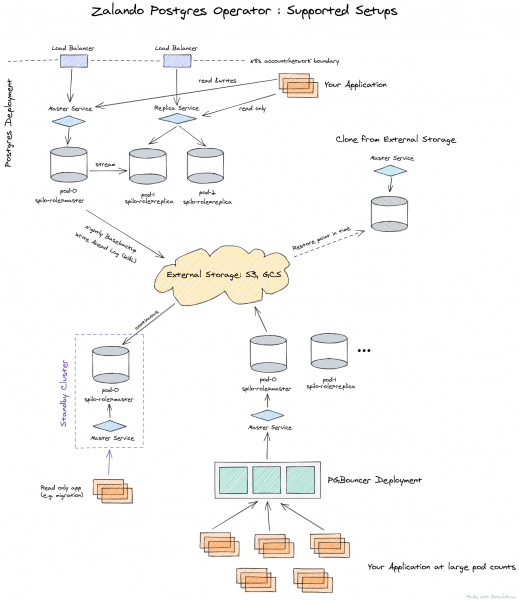
Operators are fully managed through Custom Resources, automatically creating a StatefulSet from containers, which can then be customized by adding various sidecars to the pod. This is a significant advantage compared to the operator from Crunchy Data.
Since we chose the solution from Zalando among three options considered, the further description of its capabilities will be presented below, immediately along with practical application.
Practice with Postgres Operator from Zalando
The deployment of the operator is very simple: just download the current release from GitHub and apply the YAML files from the directory . Alternatively, you can also use .
After installation, you should take care of setting up . This is done through ConfigMap postgres-operator in the namespace where you installed the operator. Once the storages are configured, you can deploy your first PostgreSQL cluster.
For example, our standard deployment looks like this:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
This manifest deploys a cluster of 3 instances with a sidecar in the form of , from which we collect application metrics. As you can see, everything is very simple, and if desired, you can create literally an unlimited number of clusters.
Attention should also be paid to the web panel for administration — . It comes bundled with the operator and allows creating and deleting clusters, as well as working with backups created by the operator.
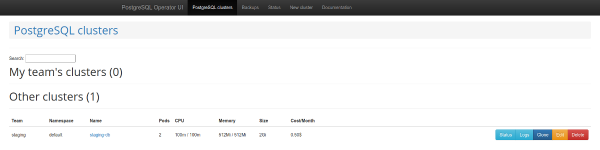
List of PostgreSQL clusters
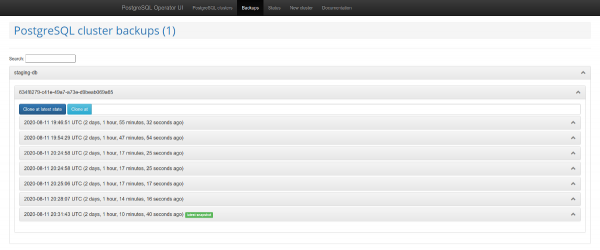
Backup management
Another interesting feature is the support for . This mechanism automatically creates roles in PostgreSQL, based on the received list of user names. After that, the API allows you to return the list of users for whom roles are automatically created.
Problems and their solutions
However, using the operator soon revealed several significant drawbacks:
- there is no support for nodeSelector;
- neiespējamība atslēgt dublējumus;
- izmantojot datu bāzu izveides funkciju, netiek piešķirtas noklusējuma privilēģijas;
- periodiski trūkst dokumentācijas vai arī tā ir novecojusi.
Par laimi, daudzas no tām var risināt. Sāksim ar beigu — problēmas ar dokumentošanu.
Diemžēl jūs varat sastapties ar to, ka ne vienmēr ir skaidrs, kā norādīt dublējumu un kā pievienot dublējumu pakotni Operator UI. Par to dokumentācijā ir pieminēts pavisam nedaudz, bet reālais apraksts atrodams :
- jāizveido noslēpums;
- jāpārskaita to operatoram parametrā
pod_environment_secret_nameCRD ar operatora iestatījumiem vai ConfigMap (atkarībā no tā, kā jūs nolēmāt uzstādīt operatoru).
Tomēr, kā izrādījās, šobrīd tas nav iespējams. Tāpēc mēs esam apkopojuši ar dažām papildu trešo pušu izstrādēm. Plašāk par to — skatiet zemāk.
Ja nododat operatoram parametrus dublējumam, proti — wal_s3_bucket un piekļuves atslēgas AWS S3, tad viņš dublēs visu: ne tikai datu bāzes ražošanā, bet arī testēšanā. Mūs tas neapmierināja.
Parametru aprakstā Spilo, kas ir pamata Docker apkārtne PgSQL operatora lietošanā, izrādījās: var nodot parametrs WAL_S3_BUCKET tukšu, tādējādi atslēdzot dublējumus. Vēl vairāk, par lielu prieku atradās arī , kuru mēs nekavējoties pieņēmām savā forka. Tagad ir pietiekami vienkārši pievienot enableWALArchiving: false resursam PostgreSQL klasterī.
Jā, bija iespēja izdarīt citādāk, palaidot 2 operatorus: viens testēšanai (bez dublējumiem), otrs — ražošanai. Bet tādējādi mēs varējām iztikt ar vienu.
Labi, mēs esam iemācījušies nodot piekļuvi datu bāzēm S3 un dublējumi sāka nokļūt glabātavā. Kā panākt, lai dublējumu lapas darbotos Operator UI?
Operator UI būs nepieciešams pievienot 3 mainīgos:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Pēc tam dublējumu pārvaldīšana kļūs pieejama, kas mūsu gadījumā atvieglos darbu ar testēšanu, ļaujot nosūtīt tur momentnaudījumu no ražošanas bez papildu skriptiem.
Kā vēl viens plus tika minēta sadarbība ar Teams API un plašas iespējas datu bāzu un lomu izveidē, izmantojot operatoru. Tomēr izveidotajām lomu nebija noklusējuma tiesību. Attiecīgi lietotājs ar lasīšanas tiesībām nevarēja lasīt jaunās tabulas.
Kāpēc tā? Neskatoties uz to, ka kodā nepieciešamās GRANT, tie netiek pielietoti katrā situācijā. Ir 2 metodes: syncPreparedDatabases un syncDatabases. Iz syncPreparedDatabases — neskatoties uz to, ka sadaļā preparedDatabases ir nosacījums defaultRoles un defaultUsers lomu izveidei, — noklusējuma tiesības netiek pielietotas. Mēs strādājam pie plāna, lai šīs tiesības tiktu automātiski pielietotas.
Un pēdējais moments aktuālajos uzlabojumos — , pievienojot Node Affinity izveidotajam StatefulSet. Mūsu klienti bieži vien dod priekšroku izmaksu samazināšanai, izmantojot spot instance, un uz tām noteikti nevajadzētu izvietot datu bāžu pakalpojumus. Šo jautājumu varētu risināt arī ar tolerancēm, bet Node Affinity klātbūtne sniedz lielāku pārliecību.
Kas iznāca?
Pēc minēto problēmu risināšanas mēs forknējām Postgres Operator no Zalando uz , kur tas tiek veidots ar tik noderīgām pataugām. Un, lai nodrošinātu ērtību, mēs apkopojām arī .
Priekšlikumu saraksts, kas pieņemts forka:
- ;
- ;
- ;
- .
Būtu lieliski, ja kopiena atbalstītu šos PR, lai tie iekļautos upstream nākamajā operatora versijā (1.6).
Bonuss! Panākumu stāsts par ražošanas migrāciju
Ja jūs izmantojat Patroni, operātors var migrēt dzīvu ražošanu ar minimālu dīkstāvi.
Spilo ļauj veidot standby klasterus, izmantojot S3 glabātuves ar , kad PgSQL binārais žurnāls vispirms tiek saglabāts S3, un pēc tam tiek ievadīts replikā. Bet ko darīt, ja jums nees ir izmantots Wal-E vecajā infrastruktūrā? Šīs problēmas risinājums jau uz habra.
Palīdzēt nāk loģiskā PostgreSQL replikācija. Tomēr neiedziļināsimies detaļās, kā izveidot publikācijas un parakstus, jo… mūsu plāns izgāzās.
Problēma ir tā, ka datu bāzē bija vairākas noslogotas tabulas ar miljoniem rindu, kuras nepārtraukti tika papildinātas un dzēstas. ar copy_data, kad jauna replika kopē visu saturu no meistara, vienkārši nepaspēja sekot meistaram. Saturs tika kopēts nedēļu, bet tomēr nesekmīgi panāca meistaru. Rezultātā ar problēmu palīdzēja kolēģi no Avito: var pārvietot datus, izmantojot pg_dump. Aprakstīšu mūsu (nedaudz uzlaboto) šī algoritma variantu.
Ideja ir tāda, ka var izveidot izslēgtu abonementu, pievienotu konkrētam replikācijas slotam, un pēc tam labot darījuma numuru. Bija pieejamas replikas darbam ar produkciju. Tas ir svarīgi, jo replikācija palīdzēs izveidot konsekventu dump un turpināt saņemt izmaiņas no meistara.
Nākamajās komandās, kas apraksta migrācijas procesu, tiks izmantotas šādas apzīmējumi hostiem:
- master — avota serveris;
- replica1 — plūsmas replikācija vecajā produkcijā;
- replica2 — jaunā loģiskā replikācija.
Migrācijas plāns
1. Izveidosim meistara abonementu uz visām tabulām shēmā public datubāzes dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Izveidosim replikācijas slotu meistara pusē:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Apturēsim replikāciju vecajā replikā:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Iegūsim darījuma numuru no meistara:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Izveidosim dump no vecās replikas. To darīsim vairākos pavedienos, kas palīdzēs paātrināt procesu:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump\/ dbname
6. Augšupielādēsim dump jaunajā serverī:
pg_restore -h replica2 -F d -j 8 -d dbname dump\/
7. Pēc dump augšupielādes varam uzsākt replikāciju plūsmas replikā:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Izveidosim abonementu jaunajā loģiskajā replikā:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Iegūsim oid abonementus:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Pieņemam, ka tika iegūts oid=1000. Lietosim darījuma numuru abonementam:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA\/AAAAAAAA');"
10. Uzsāksim replikāciju:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Pārbaudīsim abonementa statusu, replikācijai jādarbojas:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Pēc tam, kad replikācija uzsākta un datubāzes sinhronizētas, mēs varam veikt pārslēgšanu.
13. Pēc replikācijas pabeigšanas jālabo secības. Tas ir labi aprakstīts .
Pateicoties šādam plānam, pārslēgšana notika ar minimālām aizkavēšanām.
Secinājums
Kubernetes operatori ļauj vienkāršot dažādas darbības, samazinot tās līdz K8s resursu izveidei. Tomēr, sasniedzot izcilu automatizāciju, jāatceras, ka tā var radīt arī virkni nevēlamu nianses, tādēļ pie operatoru izvēles pieejiet pārdomāti.
Apskatot trīs populārākos Kubernetes operatorus PostgreSQL, mēs izvēlējāmies projektu no Zalando. Ar to saskārāmies ar dažām grūtībām, taču rezultāts patiešām iepriecināja, tāpēc plānojam paplašināt šo pieredzi arī uz citām PgSQL instalācijām. Ja jums ir pieredze ar līdzīgiem risinājumiem — būsim priecīgi redzēt detaļas komentāros!
P.S.
Lasiet arī mūsu emuāra rakstos:
- «»;
- «»;
- «».
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish