

Iļjas Kosmodemjanskā 2015. gada ziņojuma "Linux tuning to improve PostgreSQL performance" atšifrējums
Atruna: Vēršu uzmanību, ka šis ziņojums datēts ar 2015. gada novembri — ir pagājuši vairāk nekā 4 gadi un ir pagājis daudz laika. Ziņojumā aplūkotā versija 9.4 vairs netiek atbalstīta. Pēdējo 4 gadu laikā ir iznākuši 5 jauni PostgreSQL laidieni un 15 Linux kodola versijas. Ja mēs pārakstīsim šīs vietas, iznāks cits ziņojums. Bet šeit tiek aplūkota fundamentālā Linux pielāgošana PostgreSQL, kas ir aktuāla pat tagad.
Mani sauc Iļja Kosmodemjanskis. Es strādāju uzņēmumā PostgreSQL-Consulting. Un tagad es nedaudz pastāstīšu par to, ko darīt ar Linux attiecībā uz datu bāzēm vispār un īpaši attiecībā uz PostgreSQL, jo principi ir diezgan līdzīgi.
Par ko tiks runāts? Ja jūs strādājat ar PostgreSQL, jums līdz noteiktai pakāpei jābūt UNIX administratoram. Ko tas nozīmē? Ja mēs salīdzinām Oracle un PostgreSQL, tad Oracle jums jābūt 80 % DBA datu bāzes administratoram un 20 % Linux administratoram.
Ar PostgreSQL ir nedaudz sarežģītāk. Ar PostgreSQL ir nepieciešams labāk izprast, kā darbojas Linux. Un, ievērojot to, jāseko līdzi jaunumiem, jo pēdējā laikā ir daudz atjauninājumu. Jauni kodoli iznāktu un parādās jaunas funkcionalitātes, uzlabojas veiktspēja utt.
Kāpēc mēs runājam par Linux? Ne jau tāpēc, ka mēs esam Linux konferencē Sanktpēterburgā, bet tāpēc, ka mūsdienu apstākļos viena no visatbilstošākajām operētājsistēmām datu bāzēm vispār un PostgreSQL īpaši ir Linux. Jo, diemžēl, FreeBSD attīstās kādā ļoti dīvainā virzienā. Un būs problēmas gan ar veiktspēju, gan ar daudziem citiem jautājumiem. PostgreSQL veiktspēja uz Windows ir pilnīgi atsevišķa sarežģīta tēma, kas balstās uz to, ka Windows nav tādas kopējās atmiņas kā UNIX, un viss PostgreSQL uz to balstās, jo tā ir daudzprocesu sistēma.
Un eksotika, piemēram, Solaris, domāju, interesē mazākus daudzus, tāpēc ejam tālāk.
Mūsdienu Linux izplatījumā ir vairāk nekā 1 000 syctl parametru, atkarībā no tā, kā ir salikts kodols. Turklāt, ja mēs paskatāmies uz dažādām skrūvēm, varam vēl dažādos veidos kaut ko pielāgot. Ir failu sistēmu parametri, kā tās montēt. Ja jautājumi par to, kā palaist: ko BIOS jāpieslēdz, kā jādara aparatūra utt.
Tas ir ļoti liels apjoms, par kuru var runāt vairākas dienas, nevis īsā ziņojumā, taču es šobrīd apstāšos pie svarīgām lietām, kā izvairīties no tām kļūdām, kas garantēti neļaus jums labi izmantot datu bāzi uz Linux, ja jūs tās neizlabosiet. Un svarīgs punkts ir tāds, ka daudzi parametri pēc noklusējuma ir iestatīti nepareizi attiecībā uz datu bāzi. Tātad pēc noklusējuma darbosies slikti vai vispār nedarbosies.
Kādi ir tradicionālie tuning mērķi Linux? Es domāju, ka, ņemot vērā, ka jūs visi nodarbojaties ar Linux pārvaldību, īpaši paskaidrot, kas ir mērķi, nav nepieciešams.
Var veikt tuning:
- CPU.
- Atmiņa.
- Krātuve.
- Citi. Par to mēs runāsim beigās. Pat tādi parametri kā enerģijas taupīšanas politika var neparedzami un nepatīkami ietekmēt veiktspēju.
Kāda ir PostgreSQL un datu bāzu specifika vispār? Problēma ir tā, ka nevar tune`t kādu atsevišķu skrūvi un paskatīties, vai mūsu veiktspēja ir ievērojami uzlabojusies.
Jā, tādas skrūves pastāv, bet datu bāze ir sarežģīta struktūra. Tā sadarbojas ar visiem servera resursiem un dod priekšroku pilnīgai sadarbībai. Ja jūs paskatīsieties uz mūsdienu Oracle ieteikumiem par to, kā izmantot hostēšanas operētājsistēmu, tas būs kā joks par to mongolieti kosmonautu – pabarot suni un neko nepieskart. Dodiet datu bāzei visus resursus, un datu bāze pati visu sakārtos.
Principā attiecībā uz PostgreSQL situācija ir ļoti līdzīga. Atšķirība ir tāda, ka datu bāze ne vienmēr spēj pati paņemt visus resursus, tātad daudzas lietas ir jākontrolē pašam līmenī Linux.
Galvenā ideja ir neizvēlēties kādu vienīgu mērķi un sākt to tune`t, piemēram, atmiņu, CPU vai kaut ko tamlīdzīgu, bet analizēt darba slodzi un censties maksimāli uzlabot caurlaidspēju, lai mūsu datu bāzē maksimāli efektīvi plūstu tā slodze, ko labi programmētāji mums radījuši, tostarp arī mūsu lietotāji.
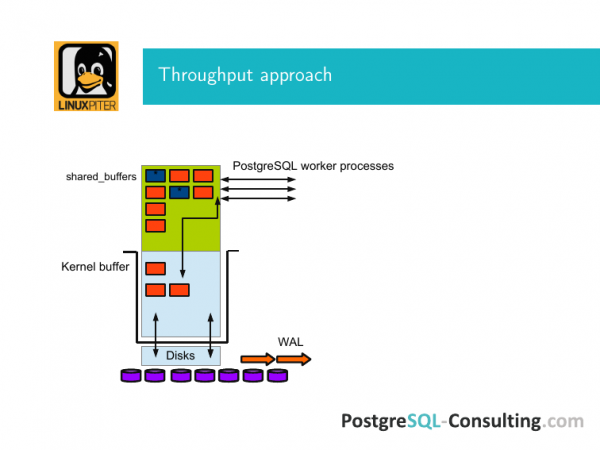
Šeit ir attēls, kas paskaidro, kas tas ir. Ir Linux operētājsistēmas buferis, ir kopēja atmiņa un ir PostgreSQL kopējie buferi. Atšķirībā no Oracle, PostgreSQL darbojas tieši caur kodola buferi, t. i., lai lapas no diska nonāktu tā kopējā atmiņā, tām jāiziet cauri kodola buferim un atpakaļ ir tieši tāda pati situācija.
Šīs sistēmas iekšpusē atrodas diski. Es to attēloju kā diskus. Patiesībā tur var būt RAID kontrolieris utt.
Un šī ievade-izvade tā vai citādi notiek caur šo procesu.
PostgreSQL ir klasiskā datubāze. Tur iekšā ir lapas. Un visa ievade-izvade notiek, izmantojot lapas. Mēs ar lapām pacelam blokos atmiņā. Un, ja nekas nenotika, mēs tās vienkārši izlasījām, tad pakāpeniski tās no šī keša, no kopējām buferiem izgaist un atgriežas atpakaļ diskā.
Ja mēs kaut kur kaut ko nomainījām, tad visa lapa tiek atzīmēta kā netīra. Es tās šeit atzīmēju ar zilu krāsu. Un tas nozīmē, ka šai lapai jābūt sinhronizētai ar bloku krātuvi. T.i., kad mēs to padarījām netīru, tika veikta ieraksts WAL. Un kādā brīnišķīgā brīdī notika parādība, ko sauc par checkpoint. Un šajā žurnālā tika ierakstīta informācija par to, ka tā ir notikusi. Un tas nozīmē, ka visas netīrās lapas, kas šajā brīdī bija šajos kopējos buferos, tika sinhronizētas ar diska krātuvi, izmantojot fsync caur kodola buferi.
Kāpēc tas tiek darīts? Ja mums pazūd strāva, mēs nenonākam situācijā, kad visas dati ir pazuduši. Pastāvīgā atmiņa, par kuru mums visi stāstīja, pagaidām ir teorijā par datubāzēm – tas ir gaišs nākotnes redzējums, uz kuru mēs noteikti tiecamies un kas mums patīk, bet pašlaik tie joprojām dzīvo vēl 20 gadus atpakaļ. Un, protams, visam tam jāseko līdzi.
Un uzdevums maksimizēt caurlaidspēju ir uzlabot visus šos posmus, lai viss ātri pārvietotos šurpu turpu. Kopējā atmiņa ir galvenokārt lappušu kešs. PostgreSQL mēs nosūtījām pieprasījumu select kaut ko, viņš izsauca datus no diska. Tie nonāca kopējās buferos. Tādējādi, lai tas labāk darbotos, ir jābūt daudz atmiņas.
Lai viss darbotos labi un ātri, jums pareizi jāiestata operētājsistēma visos posmos. Un jāizvēlas sabalansēta aparatūra, jo, ja kādā vietā būs disbalanss, jūs varat izveidot ļoti daudz atmiņas, taču apkalpošanas ātrums būs nepietiekams.
Apskatīsim katru no šiem punktiem.
Lai šīs lapas ceļotu šurp un turp ātrāk, ir nepieciešams panākt sekojošo:
- Pirmkārt, ir jāstrādā efektīvāk ar atmiņu.
- Otrkārt, ir jāuzlabo pāreja, kad lapas no atmiņas nokļūst uz diska.
- Un, treškārt, ir jābūt labiem diskiem.
Ja jums ir 512 GB operatīvās atmiņas serveri un viss beigās nonāk SATA cietajā diskā bez jebkāda keša, tad viss datu bāzes serveris pārvēršas ne vienkārši par ķirbi, bet par ķirbi ar SATA interfeisu. Jūs tieši ar to saskarsieties. Un nekas jums nepalīdzēs.
Runājot par pirmo punktu par atmiņu, ir trīs lietas, kas var stipri apgrūtināt dzīvi.
Pirmā no tām ir NUMA. NUMA ir lieta, kas izveidota, lai uzlabotu veiktspēju. Atkarībā no darba slodzes var optimizēt dažādas lietas. Un tās jaunajā izskatā tādām aplikācijām kā datu bāze, kas intensīvi izmanto page cache, nav ļoti laba.
Divos vārdos. Kā saprast, ka ar NUMA kaut kas nav kārtībā? Jums ir kāds nepatīkams troksnis, pēkšņi kāds CPU izrādās noslogots. Tajā pašā laikā jūs analizējat vaicājumus PostgreSQL un redzat, ka tur nekas līdzīgs nav. Šiem vaicājumiem nevajadzētu tik intensīvi patērēt CPU. To var ilgi medīt. Vienkāršāk ir sākumā izmantot pareizās rekomendācijas, kā iestatīt NUMA PostgreSQL.
Kas patiesībā notiek? NUMA ir Non-Uniform Memory Access. Kāds ir jēga? Jums ir CPU, un blakus ir tā lokālā atmiņa. Un šī atmiņa interconnects var piekļūt atmiņai no citiem CPU.
Ja jūs izpildīsiet numactl --hardware, tad jums parādīsies liela lapa. Starp citu tur būs lauks distances. Būs cipari – 10-20, kaut kas šādā garā. Šie cipari nav nekas cits kā hopu skaits, lai piekļūtu šai attālajai atmiņai un izmantotu to lokāli. Principā tā ir laba ideja. Tas labi paātrina veiktspēju noteiktu slodžu gadījumā.
Tagad iedomājieties, ka jums ir viens CPU, kas vispirms mēģina izmantot savu lokālo atmiņu, tad mēģina piesaistīt citas atmiņas caur interconnect priekš kāda. Un šis CPU saņem visu jūsu PostgreSQL page cache – visas, cik nu tur gigabaitu. Jūs vienmēr saņemat sliktāko gadījumu, jo CPU tieši šajā atmiņas modulī parasti ir maz. Un visa apkalpotā atmiņa tiek apstrādāta caur šiem interconnects. Rezultāts ir lēns un skumjš. Un jums ir procesors, kas apkalpo šo mezglu, pastāvīgi noslogots. Un šīs atmiņas piekļuves laiks ir slikts, lēns. Tā ir situācija, kuru jūs nevēlaties, ja izmantojat to datu bāzei.
Tāpēc pareizāks variants datu bāzei ir tāds, lai operētājsistēma Linux vispār nezinātu, kas tur notiek. Lai tā piekļūtu atmiņai tā, kā tam vajag.
Kāpēc tā? Izskatās, ka tam vajadzētu būt pretēji. Tas notiek vienas vienkāršas iemesla dēļ: mums page cache ir nepieciešama liela atmiņa – desmitiem, simtiem gigabaitu.
Un, ja mēs to visu esam piešķīruši un apstrādājuši mūsu datus tur, ieguvums no keša izmantošanas būs ievērojami lielāks nekā ieguvums no tāda izsmalcināta piekļuves veida atmiņai. Un šādā veidā mums būs nepārspējams ieguvums, salīdzinot to, ka mēs efektīvāk piekļūsim atmiņai, izmantojot NUMA.
Tāpēc šobrīd ir divi pieejamie piegājieni, kamēr gaišā nākotne nav pienākusi, un datu bāze nemācās pati saprast, uz kādiem CPU tā strādā un no kurienes tai kaut kas jāiegūst.
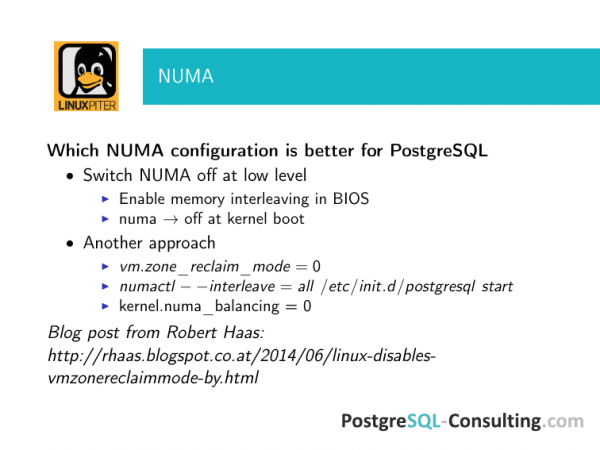
Tāpēc pareizais piegājiens ir vispār atslēgt NUMA, piemēram, pie restartēšanas. Lielākajā daļā gadījumu ieguvumi ir tik lieli, ka jautājums, kā labāk, vispār nerodas.
Ir vēl viena iespēja. Mēs to biežāk izmantojam nekā pirmo, jo, kad uz mūsu atbalstu vēršas klients, servera restartēšana viņam ir liels darbs. Viņam tur uzņēmums strādā. Un viņi piedzīvo problēmas ar NUMA. Tāpēc mēs cenšamies atslēgt mazāk invazīvā veidā, nekā restartējot, bet šeit uzmanīgi jāpārbauda, vai tas ir atslēgts. Jo, kā pierāda pieredze, atslēgšana uz PostgreSQL mātes procesu NUMA ir laba, tomēr nav vispār garantēts, ka tas darbosies. Jāskatās un jāpārbauda, vai tas tiešām ir atslēgts.
Ir ir labs ieraksts no Robert Haas. Viņš ir viens no PostgreSQL komitejas locekļiem. Viens no galvenajiem izstrādātājiem visiem zemāko slāņu tehniskajiem aspektiem. Un, ja izpētīsit saites no šī ieraksta, tur ir aprakstītas vairākas krāšņas stāstu par to, kā NUMA apgrūtināja cilvēku dzīvi. Apskatiet, izpētiet sistēadmina kontrolsarakstu par to, ko nepieciešams iestatīt serverī, lai mūsu datubāze darbotu labi. Šos iestatījumus ir jāpieraksta un jāpārbauda, jo citādi viss varētu nebūt tik labi.
Vēršu uzmanību, ka tas attiecas uz visiem iestatījumiem, par kuriem es runāšu. Bet parasti datubāzes tiek veidotas master-slave režīmā, lai nodrošinātu noturību pret kļūdām. Neaizmirstiet veikt šos iestatījumus uz slave, jo kādā brīdī jums var notikt avārija, un jums būs jāpārslēdzas uz slave, kurš kļūs par Master.
Avārijas situācijā, kad viss ir ļoti slikti, jūsu telefons pastāvīgi zvanīs, un vadītājs ieradīsies ar lielu nūju, jums nebūs laika domāt par to, lai pārbaudītu. Un rezultāti var būt ārkārtīgi bēdīgi.
Nākamā lieta – tas ir huge pages. Huge pages ir grūti pārbaudīt atsevišķi, un tam nav īsti jēgas, kaut arī ir veiktspējas testi, kas to prot darīt. Tie viegli atrodami internetā.
Kāds ir jēga? Jums ir ne pārāk dārgs serveris, kurā ir daudz operatīvās atmiņas, piemēram, vairāk par 30 GB. Jums netiek izmantoti huge pages. Tas nozīmē, ka jums nepārprotami ir atmiņas overhead, un šis overhead ir tālu nepatīkams.
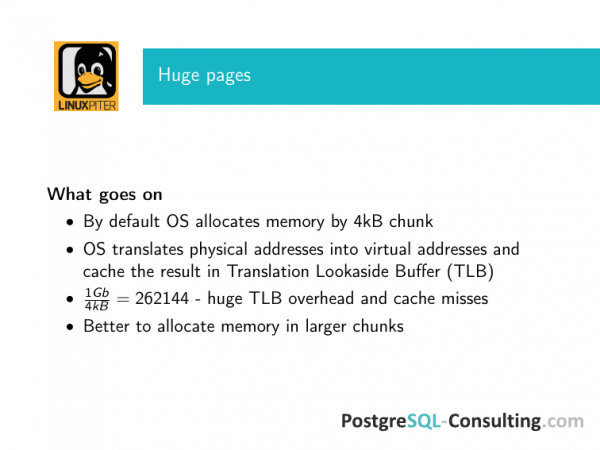
Kāpēc tā? Un kas notiek? Operētājsistēma sadala atmiņu mazos gabaliņos. Tas ir ērti, tā ir vēsturiski izveidota kārtība. Un, ja iedziļināmies detaļās, tad operētājsistēmai ir jāpārveido virtuālās adreses fiziskajās. Un šis ir diezgan sarežģīts process, tāpēc operētājsistēma šīs operācijas rezultātu kešē tuvākajā Translation Lookaside Buffer (TLB).
Un, tā kā TLB ir kešatmiņa, tad šādā situācijā rodas visas raksturīgās kešatmiņas problēmas. Pirmkārt, ja jums ir ļoti daudz operatīvās atmiņas, un tā visa ir sadalīta mazos gabaliņos, tad šis buferis kļūst ļoti liels. Un, ja keša buferis ir liels, tad meklēšana tajā notiek lēnāk. Overhead ir liels, un tas pats aizņem vietu, t.i., operatīvo atmiņu patērē kaut kas nepareizs. Tas ir viens.
Divi – jo lielāks kešatmiņas apmērs šādā situācijā, jo lielāka ir iespēja, ka būs kešatmiņas trūkumi. Un šīs kešatmiņas efektivitāte strauji samazinās ar tās lieluma pieaugumu. Tāpēc operētājsistēmās tika izstrādāta vienkārša pieeja. Linux to jau ilgu laiku izmanto. FreeBSD to nesen ieviesa. Tomēr mēs runājam par Linux. Tas ir huge pages.
Un šeit jāatzīmē, ka huge pages, kā ideja, sākotnēji tika virzīta kopienu, tostarp Oracle un IBM, vārdā, t.i., datu bāzu ražotāji nopietni domāja, ka tas būs noderīgi, arī datu bāzēm.
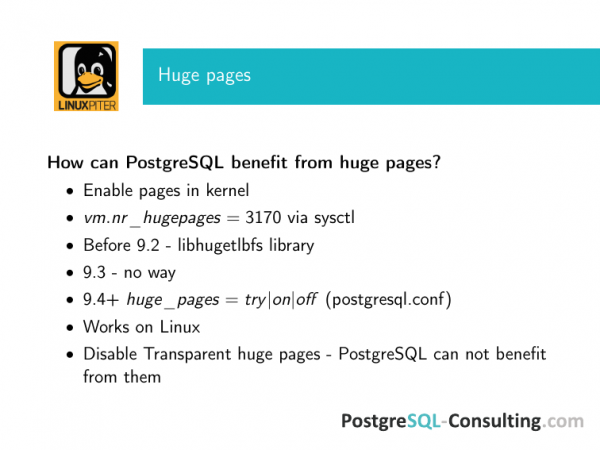
Un kā to savienot ar PostgreSQL? Pirmkārt, Linux kodolā ir jābūt ieslēgtiem huge pages.
Otrkārt, tie skaidri jānorāda ar sysctl parametru – cik daudz to ir. Skaitļi šeit ir no kāda vecā servera. Jūs varat aprēķināt, cik aptuveni jums ir shared buffers, lai huge pages tajos ietilptu.
Un, ja jūs visu serveri esat atdevuši PostgreSQL, tad laba sākumpunkts ir vai nu 25 % no operatīvās atmiņas atvēlēt shared buffers, vai 75 %, ja esat pārliecināti, ka jūsu datu bāze 75 % noteikti ietilps. Pirmais sākumpunkts. Un aprēķiniet, ja jums ir 256 GB operatīvās atmiņas, tad attiecīgi 64 GB jums būs shared buffers. Aptuveni aprēķiniet ar nelielu rezervi – kādai jābūt šai vērtībai.
Līdz versijai 9.2 (ja nemaldos, sākot no versijas 8.2) varēja ar trešo pušu bibliotēku savienot PostgreSQL ar huge pages. Un to vienmēr vajag darīt. Pirmkārt, jums ir jāpārliecinās, ka kodols prot pareizi piešķirt huge pages. Un, otrkārt, lai lietojumprogramma, kas ar tām strādā, varētu tām piekļūt. Vienkārši tā tas nedarbosies. Tā kā PostgreSQL piešķīra atmiņu System V stilā, to varēja izdarīt, izmantojot libhugetlbfs — tas ir pilnais bibliotēkas nosaukums.
Versijā 9.3 tika uzlabota PostgreSQL veiktspēja, strādājot ar atmiņu, un tika atteikts izmantot 5. sistēmas metodi atmiņas piešķiršanai. Visi bija ļoti priecīgi, jo pretējā gadījumā, mēģinot palaist divus PostgreSQL instancus uz viena datora, tā saka, ka man trūkst kopējās atmiņas. Un saka, ka jālabo sysctl. Tur ir tāds sysctl, ka jārebootē un tā tālāk. Kopumā, visi bija priecīgi. Bet mmap atmiņas piešķiršana pārtrauca huge pages izmantošanu. Mums lielākā daļa klientu izmanto lielus kopējos buferus. Un mēs uzstājām, ka nevajadzētu pāriet uz 9.3, jo tur pārslodze sākās skaitāmos procentos.
Bet šajā laikā kopiena pievērsa uzmanību šai problēmai, un versijā 9.4 tika ļoti labi pārstrādāta šī funkcija. Un 9.4 parādījās parametrs postgresql.conf, kurā var ieslēgt try, on vai off.
Try – tas ir visdrošākais parametrs. Palaidot PostgreSQL, kad tas piešķir kopējo atmiņu, tas mēģina iegūt šo atmiņu no huge pages. Un, ja tas neizdodas, tas atgriežas uz parasto piešķiršanu. Un, ja jums ir FreeBSD vai Solaris, tad jūs varat iestatīt try, tas vienmēr ir droši.
Ja ir on, tad tas vienkārši nesāksies, ja nevarēs piešķirt no huge pages. Šeit jau – kādam tas ir labāk. Bet, ja jums ir try, tad pārbaudiet, vai jums tiešām ir piešķirta vajadzīgā atmiņa, jo tur ir daudz kļūdu iespēju. Šobrīd šī funkcionalitāte darbojas tikai Linux.
Vēl viens neliels novērojums, pirms ejam tālāk. Transparent huge pages – tas vēl nav par PostgreSQL. To normāli izmantot tas nevar. Un ar Transparent huge pages šāda darba slodzes gadījumā, kad nepieciešama liela daļa kopējās atmiņas, priekšrocības parādās tikai pie ļoti lieliem apjomiem. Ja jums ir terabaiti atmiņas, tad tas var spēlēt lomu. Ja runājam par ikdienišķām lietojumprogrammām, kad jums ir 32, 64, 128, 256 GB atmiņas uz mašīnas, tad parastie huge pages ir labi, bet Transparent vienkārši izslēdzam.
Un pēdējā lieta, kas saistīta ar atmiņu, tieši nav saistīta ar caurlaidspēju, tā var ļoti traucēt dzīvi. Visa caurlaidspēja ievērojami cieš no tā, ka serveris pastāvīgi swap'ojas.
Un tas būs ļoti nepatīkami vairākās situācijās. Galvenā nepatikšana ir tā, ka mūsdienu kodoli nedaudz atšķiras no vecākiem Linux kodoliem. Tas ir jautājums, uz kura nepatīkami uzkāpt, jo, kad mēs runājam par darbu ar swap, tas beidzas ar OOM-killer ne savlaicīgu iejaukšanos. Un OOM-killer, kurš neieradās savlaicīgi un noņēma PostgreSQL, ir nepatīkami. Par to uzzinās visi, t.i., līdz pēdējam lietotājam.
Kas notiek? Jums tur ir liels operatīvās atmiņas apjoms, viss labi strādā. Bet kaut kādā veidā serveris iestrēgst swap un palēninās dēļ tā. Izskatās, ka atmiņas ir daudz, bet tā tomēr notiek.
Agrāk mēs ieteicām iestatīt vm.swappiness uz nulli, t.i., atslēgt swap. Agrāk likās, ka 32 GB operatīvās atmiņas un attiecīgi dalītie buferi ir milzīgs apjoms. Galvenais swap uzdevums ir, lai būtu vieta, kur iemest kodolu, ja mēs avarējam. Un tas vairs īsti netika paveikts. Un ko tad darīs ar šo kodolu? Tā jau ir problēma, kad neskaidri saprot, kāpēc swap ir nepieciešams, īpaši tādā apjomā.
Tomēr mūsdienīgākos, t.i., trešās versijas kodolos uzvedība ir mainījusies. Un, ja iestatīsiet swap uz nulli, t.i., izslēgsiet to, drīz vai vēlāk, pat ja atlicis kāds operatīvās atmiņas apjoms, pie jums ieradīsies OOM-killer, lai nogalinātu visintensīvākos patērētājus. Jo tas uzskatīs, ka pie tāda darba slodzes mums vēl ir mazliet un mēs izbeigsimies, t.i., nevis nogalināt sistēmas procesu, bet nogalināt ko mazāk svarīgu. Tas mazāk svarīgais izrādīsies intensīvais dalītās atmiņas patērētājs, proti, postmaster. Un pēc tam būs labi, ja datubāzi nebūs jāpārstrukturē.
Tādēļ pašlaik pēc manām atmiņām lielākā daļa distribūciju – tas ir kaut kur 6, t.i., kad sākt izmantot swap atkarībā no tā, cik daudz atmiņas palicis. Mēs pašlaik iesakām iestatīt vm.swappiness = 1, jo tas praktiski to izslēdz, bet nenoved pie tādiem efektiem kā ar negaidīti ieradīsies OOM-killer un visu šo lietu nogalinās.
Kas tālāk? Kad runājam par datu bāzu veiktspēju un pakāpeniski pārnākam uz diskiem, visi sāk satraukti satvert galvas. Jo patiesība, ka disks ir lēns un atmiņa ātra, visiem no bērnības ir pazīstama. Un visi zina, ka datu bāzēm būs problēmas ar diska veiktspēju.
Pamatproblēma ar PostgreSQL veiktspēju, kas saistīta ar checkpoints spikes, rodas nevis tāpēc, ka disks ir lēns. Tas drīzāk ir saistīts ar to, ka atmiņas un diska caurlaidspēja nav līdzsvarota. Turklāt tās var būt nelīdzsvarotas dažādos vietās. PostgreSQL nav pareizi konfigurēts, operētājsistēma nav konfigurēta, aparatūra nav konfigurēta un aparatūra ir nepareiza. Šī problēma nenotiek tikai tad, ja viss notiek kā vajag, t.i., ja vai nu slodzes nav, vai nu iestatījumi un aparatūra ir labi izvēlēti.
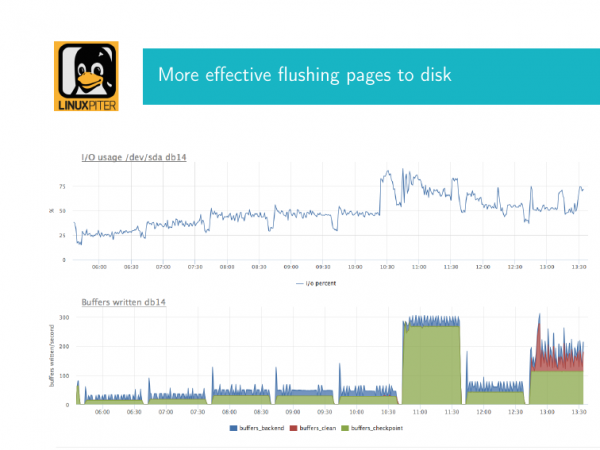
Kas tas ir un kā tas izskatās? Parasti cilvēki, kuri strādā ar PostgreSQL, ir šajā procesā piedalījušies ne reizi vien. Es paskaidrošu. Kā jau teicu, PostgreSQL periodiski veic checkpoints, lai netīrās lapas kopējā atmiņā pārvietotu uz disku. Ja mums ir liels kopējās atmiņas apjoms, tad checkpoints sāk intensīvi ietekmēt disku, jo pārvieto šīs lapas uz fsync. Tas nonāk kodola buferī un tiek ierakstīts diskos, izmantojot fsync. Un, ja šī apjoma ir liels, mēs varam novērot nepatīkamu efektu, proti, ļoti lielu disku noslodzi.
Šeit man ir divas bildes. Es tagad paskaidrošu, kas tas ir. Tas ir divi ar laiku koriģēti grafiki. Pirmais grafiks – tas ir diska noslodze. Šeit tas sasniedz gandrīz 90% šajā laika brīdī. Ja jums ir datu bāze ar fiziskiem diskiem un RAID kontrolieri, kura noslodze tuvojas 90%, tad tas ir slikti jaunumi. Tas nozīmē, ka vēl nedaudz un tas sasniegs 100 un ievades-ievades tiks apstādināta.
Ja jums ir diska masīvs, tad tur ir nedaudz cita stāsta. Tas atkarīgs no tā, kā tas ir konfigurēts, kāds ir masīvs utt.
Vienlaikus šeit ir konfigurēts grafiks no iekšējās PostgreSQL skata, kas norāda, kā notiek checkpoint. Zaļajā krāsā ir parādīts buferu skaits, t. i., cik daudz netīro lapu šajā brīdī tika pārsūtīts šim checkpoint, lai sinhronizētos. Un tas ir galvenais, kas šeit ir jāzina. Mēs redzam, ka mums ir daudz lapu, un kādā brīdī mēs nonākam pie ierobežojuma, t. i., rakstījām rakstījām, šeit acīmredzot disk sistēma ir ļoti aizņemta. Un mūsu checkpoint ļoti spēcīgi ietekmē disku. Ideālā situācija izskatītos drīzāk šādi, t. i., mums šeit būtu mazāk ierakstu. Un ar iestatījumiem mēs varam to salabot, lai tas turpinātos. T. i., noslodze ir neliela, bet kaut kur mēs šeit rakstām.
Ko darīt, lai uzvarētu šo problēmu? Ja jums ir apstājies I/O datu bāzē, tas nozīmē, ka visi lietotāji, kuri ir piekrituši izpildīt savus pieprasījumus, gaidīs.
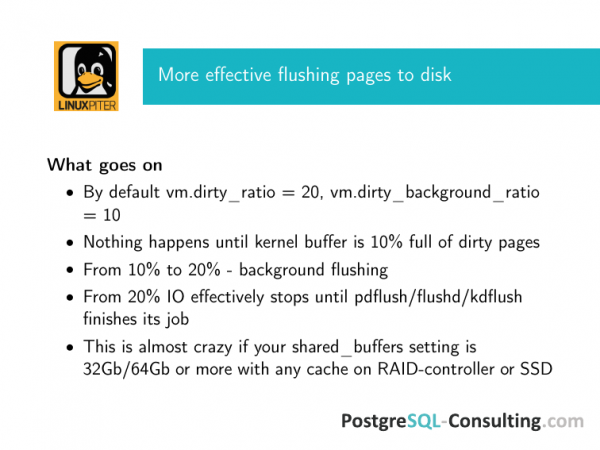
Ja skatās no Linux skatpunkta, ja esat paņēmis labu aparatūru, pareizi to iestatījis, normāli konfigurējis PostgreSQL, lai tas reti veiktu šos checkpointus, izstiepjot tos laika gaitā, tad jūs nonākat pie Debian noklusējuma parametriem. Lielākajai daļai Linux distribūciju šāda aina: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Ko tas nozīmē? Ar kodu 2.6 parādījās viens fons, kas veic flushing. Pgflush, atkarībā no tā, ko kāds izmanto, kas nodarbojas ar netīro lapu izsniegšanu no kodola bufera un izsniegšanu, kad ir nepieciešams nekavējoties izsniegt netīras lapas, kad fona izsniegšana vairs nepalīdz.
Kad sākas fons? Kad 10 % no visas operatīvās atmiņas, kas ir serverī, ir aizņemti ar netīrām lapām kodola buferī, tiek izsaukta īpaša funkcija fona izsniegšanai. Kāpēc tā ir fona? Tā kā parametru tā pieņem, cik lapas izsniegt. Un, pieņemsim, izsniedz N lapas. Un uz kādu laiku šī funkcija aizmieg. Un tad tā atkal nāk un izsniedz vēl kādu lapu skaitu.
Tas ir ļoti vienkāršs stāsts. Šeit uzdevums ir kā ar baseinu, kad vienā caurulē ieplūst, otrā izplūst. Mums ir ieraksts un, ja tas nosūtījis maz netīro lapu uz izsniegšanu, tad pakāpeniski no kodola bufera pgflush viss tiks uzmanīgi izkliedēts.
Ja, ja turpina uzkrāties šīm netīrajām lapām, tās uzkrājas līdz 20 %. Pēc tam operētājsistēmai ir prioritāte visu šo uzrakstīt diskā, jo var izslēgties strāva, un mums viss būs slikti. Mēs zaudēsim šos datus, piemēram.
Kas ir triks? Triks ir tajā, ka šie parametri mūsdienu pasaulē, 20 un 10 % no visas operatīvās atmiņas, kas ir uz mašīnas, ir ārkārtīgi augsts slogs jebkurai diskosistēmai, kas jums ir.
Iedomājieties, ka jums ir 128 GB operatīvās atmiņas. 12,8 GB nonāk jūsu diskosistēmā. Un, kāds būtu jūsu kešatmiņas tips vai masīvs, tas nevarēs izturēt tik daudz.
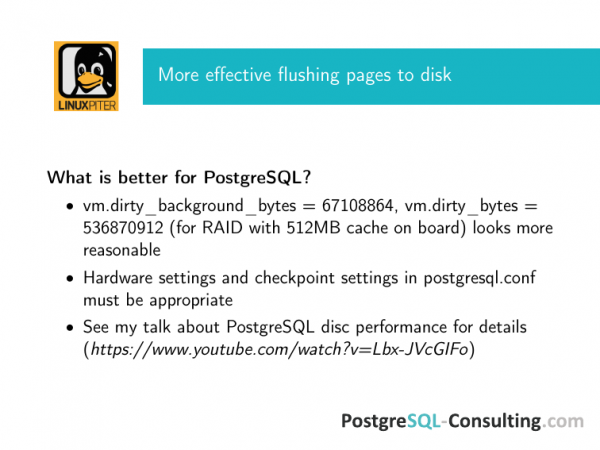
Tādēļ mēs iesakām šos skaitļus uzreiz noregulēt, ņemot vērā jūsu RAID kontroliera iespējas. Man šeit ir sniegta ieteikums kontrolierim ar 512 MB kešatmiņu.
Visu uzskaitīt ir ļoti vienkārši. Varat iestatīt vm.dirty_background byte formātā. Un šie iestatījumi atceļ iepriekšējos divus. Vai nu noklusējuma proporcija, vai aktivizē tās, kas ir byte formātā, un strādās tās, kas ir byte formātā. Bet, tā kā es esmu DBA konsultants un strādāju ar dažādiem klientiem, es cenšos būt piesardzīgs un tādēļ, ja byte, tad byte. Neviens nav devis nekādas garantijas, ka labs administrators nepapildinās serverim atmiņu, un restartēs to, bet skaitlis paliks tāds pats. Vienkārši aprēķiniet šos skaitļus, lai jūs varētu būt droši, ka viss iekļausies.
Kas notiks, ja neiekļausieties? Man ir norādīts, ka efektīvi tiek apturēta jebkura flushing, bet patiesībā tā ir izteiksmes forma. Operētājsistēmai ir liela problēma - tai ir daudz netīro lapu, tāpēc efektīvi tiek apturēta jebkura IO, ko rada jūsu klienti, tas ir, ja kāds SQL pieprasījums tiek nosūtīts uz datu bāzi, tas gaida. Jebkura ievade-izvade tiek veikta zemākā prioritātē, jo datu bāze ir aizņemta ar checkpoint. Un kad tā beigsies, nav skaidrs. Un, ja esat sasniedzis ne fona, ne aizmugures flushing, tas nozīmē, ka viss jūsu IO ir aizņemts ar to. Un līdz tam tas netiks izdarīts.
Šeit ir vēl divi svarīgi aspekti, kas iznāk ārpus šī ziņojuma. Šiem iestatījumiem vajadzētu saskanēt ar iestatījumiem postgresql.conf, t.i., checkpoint iestatījumiem. Un jūsu diskosistēmai jābūt pienācīgi konfigurētai. Ja jums ir RAID kešatmiņa, tajā jābūt baterijai. Cilvēki pērk RAID ar labu kešatmiņu bez baterijas. Ja jums ir SSD RAID, tad tiem jābūt servera versijai, un tajos jābūt kondensatoriem. Šeit ir detalizēta pārbaudes saraksts. Šajā saistē ir mans referāts par to, kā konfigurēt diska veiktspēju PostgreSQL. Tur ir visi šie pārbaudes saraksti.
Kas vēl var ļoti sarežģīt dzīvi? Tie ir divi parametri. Tie ir salīdzinoši jauni. Tie pēc noklusējuma var būt ieslēgti dažādās lietotnēs. Un tie var sarežģīt dzīvi ne mazāk, ja tie tiek nepareizi ieslēgti.
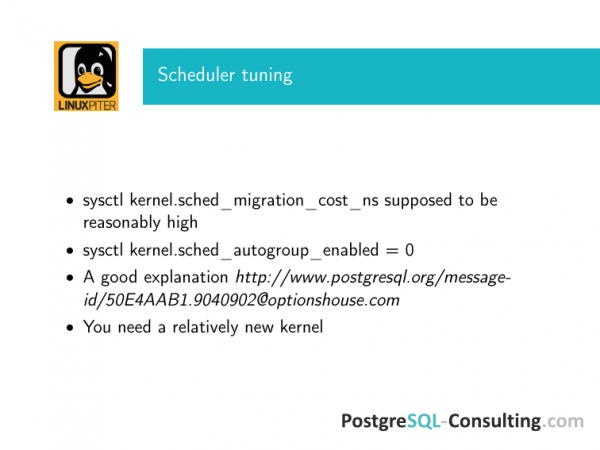
Ir divas relatīvi jaunas lietas. Tās jau parādījās trešajās kodolās. Tas ir sched_migration_cost nanosekundēs un sched_autogroup_enabled, kurš pēc noklusējuma ir viens.
Un kā tās bojā dzīvi? Kas ir sched_migration_cost? Linux plānotājs var migrēt procesu no viena CPU uz citu. Un PostgreSQL, kas izpilda vaicājumus, migrācija uz citu CPU ir pilnīgi neskaidra. No operētājsistēmas viedokļa, kad jūs pārslēdzat logus starp OpenOffice un termināli, tas var būt labi, bet datubāzēm – tas ir ļoti slikti. Tāpēc saprātīga politika ir iestatīt migration_cost uz kādu lielu vērtību, vismaz dažus tūkstošus nanosekunžu.
Ko tas nozīmēs plānotājam? Tas tiks uzskatīts, ka šajā laikā process joprojām ir karsts. T.i., ja jums ir kaut kāda ilga transakcija, kas kaut ko ilgstoši veic, tad plānotājs to sapratīs. Viņš uzskatīs, ka, kamēr šis laiks nav pagājis, migrēt šo procesu nav nepieciešams. Ja šajā laikā process kaut ko dara, tad tas netiks migrēts nekur, un tas mierīgi pabeigs darbu tajā CPU, kuru viņam ir piešķīris. Un rezultāts ir lielisks.
Otrais moments – tas ir autogroup. Ir laba ideja specifiskām darba slodzēm, kas nav saistītas ar mūsdienu datubāzēm – grupēt procesus pēc tā virtuālā termināla, no kura tie ir palaisti. Tas ir ērti noteiktām uzdevumu grupām. Praksē PostgreSQL ir multiplatformu sistēma ar prefork, kas tiek palaista no viena termināļa. Jums ir rakstīšanas bloķēšana, pazīmes un visi jūsu klienta pieprasījumi tiek grupēti vienā plānotājā, vienā CPU. Un tie visi laipni gaidīs, kad tas atbrīvosies, lai nevienam netraucētu un izmantotu to ilgāk. Šī ir situācija, kas ir pilnīgi nevajadzīga, ja slodze ir liela, tādēļ to ir jāizslēdz.
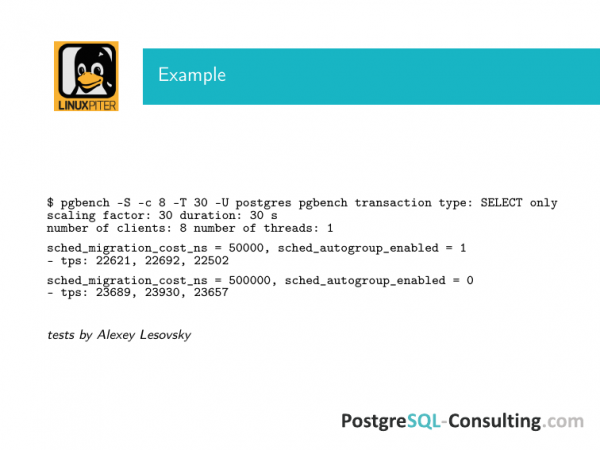
Mans kolēģis Aleksejs Lesovskis veica testus ar vienkāršo pgbench, kur palielināja migrācijas izmaksas par kārtu un izslēdza autogroup. Atšķirība sliktā aparatūrā izrādījās gandrīz 10 %. Ir diskusijas PostgreSQL e-pasta sarakstā, kur cilvēki dalās ar rezultātiem, kā līdzīgas izmaiņas ietekmēja pieprasījumu ātrumu par 50 %. Šādu stāstu ir diezgan daudz.
Un visbeidzot par enerģijas taupīšanas politiku. Ir labi, ka tagad Linux var izmantot klēpjdatorā. Un tam it kā jāpatērē labi akumulatora resurss. Bet pēkšņi izrādās, ka serverī tas var gadīties arī.
Turklāt, ja jūs no kāda hostinga nomājat serverus, tad "laipnie" hostinga neuztraucas par to, lai jums būtu labāka veiktspēja. Viņu uzdevums ir nodrošināt, lai viņu aparatūra tiktu izmantota maksimāli efektīvi. Tādēļ viņi noklusējuma iestatījumos var ieslēgt klēpjdatoru enerģijas taupīšanas režīmu operētājsistēmā.
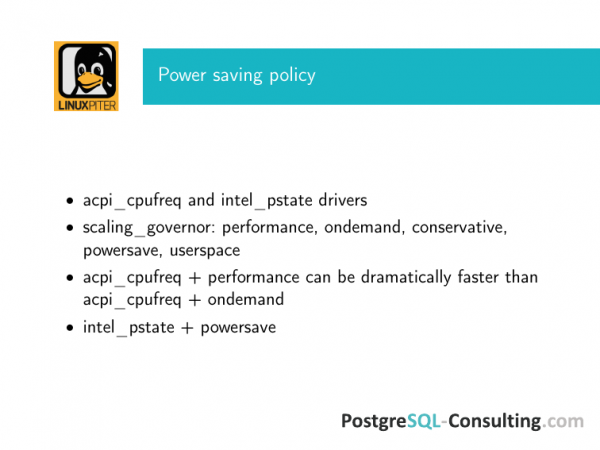
Ja jūs serverī ar datubāzi intensīvā slodze izmantojat šos labumus, tad jūsu izvēle ir acpi_cpufreq + performance. Pat ar ondemand jau būs problēmas.
Intel_pstate ir nedaudz citāds draiveris. Un tagad priekšroka tiek dota šim, jo tas ir jaunāks un labāk darbojas.
Un attiecīgi governors tikai performance. Ondemand, powersave un viss pārējais – tas nav par jums.
Rezultāti pēc explain analyze PostgreSQL var atšķirties par vairākiem pasūtījumiem, ja jūs ieslēdzat powersave, jo praktiski jums zem datubāzes CPU tiks plānotas nepārskatāmā veidā.
Šīs lietas var būt ieslēgtas noklusējumā. Rūpīgi paskatieties – vai viņi nav ieslēguši to noklusējumā. Tas var būt patiešām liela problēma.
Un beigās es vēlētos pateikt paldies mūsu DBA komandas PosgreSQL-Consulting puišiem, proti, Maksam Bogukam un Aleksejam Lesovskim, kuri katru dienu iegulda cenšoties šo darbu padarīt labāku. Mēs cenšamies darīt visu iespējamo, lai mūsu klientiem viss darbotos. Te ir kā ar aviācijas drošības instrukcijām. Viss ir rakstīts asinīm. Katrs no šiem skrūvēm ir atrasts kādas problēmas procesā. Es labprāt dalos ar jums šajos ieskatos.
Jautājumi:
Paldies! Ja, piemēram, uzņēmums vēlas ietaupīt un novietot uz viena servera datu bāzi un aplikācijas loģiku, vai ja uzņēmums seko modernai mikroservisu arhitektūrai, kurā PostgreSQL darbojas konteinerā. Kāda ir specifika? Sysctl globāli ietekmē visus kodolus. Es neesmu dzirdējis, ka sysctl kaut kādā veidā tiek virtualizēts, lai tie strādātu atsevišķi konteinerā. Ir tikai cgroup, un tur ir tikai daļējs kontrole. Kā tas būtu iespējams? Vai, ja vēlaties veikt optimizāciju, palaidiet PostgreSQL uz atsevišķa fiziskā servera un optimizējiet to?
Mēs esam atbildējuši uz jūsu jautājumu aptuveni trijos veidos. Ja runa ir par fizisko serveri, kuru var optimizēt utt., tad atslābinieties, viss darbosies labi bez šīm konfigurācijām. Ja jums rodas slodze, kas prasa šīs konfigurācijas, tad jūs agrāk nonāksiet pie fiziskā servera nekā pie šīm konfigurācijām.
Kāda ir problēma? Ja tā ir virtuālā mašīna, tad, visticamāk, jums būs daudz problēmu, piemēram, ar to, ka lielākā daļā virtuālo mašīnu diskam ir diezgan nekonsekventa latentitāte. Pat ja disku caurlaidība ir laba, viena nepareiza transakcija ievades-izejas operācijā, kas būtiski neietekmē vidējo caurlaidību, kas notika checkpoint vai WAL ierakstīšanas brīdī, padarīs datu bāzi ļoti ciešamu. Un jūs to pamanīsit ātrāk, nekā tiksiet pie šīm problēmām.
Ja jums uz tā paša servera būs NGINX, tad būs arī tā pati problēma. Tas sacentīsies par kopējo atmiņu. Un līdz iestrēgumiem, kas te aprakstīti, jūs nenonāksiet.
Tomēr no otras puses, daži no šiem parametriem jums tomēr būs aktuāli. Piemēram, izmantojot sysctl, jāuzstāda dirty_ratio, lai tas nebūtu tik neprātīgs – tas jebkurā gadījumā palīdzēs. Tā vai citādi, jūs mijiedarbosities ar disku. Un tas notiks pēc nepareizas shēmas. Tie ir noklusējuma parametri, kurus es rādīju. Un jebkurā gadījumā tos labāk mainīt.
Bet ar NUMA var būt problēmas. VmWare, piemēram, labi strādā ar NUMA ar tieši pretējām iestatījumiem. Un šeit ir jāizvēlas – dzelzs serveris vai ne dzelzs.
Man ir jautājums, kas saistīts ar Amazon AWS. Viņiem ir iepriekš konfigurēti attēli. Viens no tiem saucas Amazon RDS. Vai tur ir kādi pielāgoti iestatījumi viņu operētājsistēmai?
Tur ir iestatījumi, bet tie ir citi iestatījumi. Šeit mēs konfigurējam operētājsistēmu no aspekta, kā datu bāze to izmantos. Un tur ir parametri, kas nosaka, kur mums tagad jāiet, tāds shapings. Proti, mums ir nepieciešams tik daudz resursu, un mēs tos tagad izmantosim. Pēc tam Amazon RDS šos resursus pievieno, un tur veiktspēja krītas. Ir atsevišķas lietas, kā cilvēki sāk šajā sakarā eksperimentēt. Dažreiz pat diezgan veiksmīgi. Bet tas nav saistīts ar OS iestatījumiem. Tas ir kā mākoņa hakings. Tā ir cita stāsts.
Kāpēc Transparent huge pages nedod efektu salīdzinājumā ar Huge TLB?
Nedod. To var izskaidrot daudzos veidos. Bet patiesībā viņi vienkārši to nedod. Kāda ir PostgreSQL stāsts? Viņš startā piešķir lielu daļu kopējās atmiņas. Transparent vai netransparent tas ir pilnīgi bez nozīmes. Fakts, ka viņi tiek piešķirti startā, viss skaidro. Un, ja atmiņas ir ļoti daudz un ir jāpārstrukturē shared_memory segments, tad Transparent huge pages būs aktuāli. PostgreSQL tas ir vienkārši startā piešķirts milzīgs gabals un viss, un tālāk tur nekas īpašs nenotiek. Protams, var izmantot, bet pastāv risks iegūt curruption shared_memory, kad tas atkārtoti atvēlēs kaut ko. PostgreSQL par to pat nezina.
Avots: habr.com
