

Mēs sāku pārdomāt uzraudzības sistēmas izveidi produktu komandu veidošanas posmā. Bija skaidrs, ka mūsu funkcija - ekspluatācija - šajās komandās nekādā veidā neiekļaujas. Kāpēc tā?
Problēma ir tāda, ka visas mūsu komandas ir organizētas ap atsevišķām informācijas sistēmām, mikropakalpojumiem un frontendām, tāpēc kopējais veselības stāvoklis visai sistēmai komandām nav redzams. Piemēram, tās var nezināt, kāda mazāka daļa dziļā backendā ietekmē frontend daļu. Viņu intereses ierobežojas ar sistēmām, ar kurām integrēta viņu sistēma. Ja arī komanda un tās pakalpojums A gandrīz nav savienots ar pakalpojumu B, šāds pakalpojums komandai ir gandrīz neredzams.
Savukārt mūsu komanda strādā ar sistēmām, kas ir ļoti cieši integrētas savā starpā: starp tām ir daudz saikņu, tā ir diezgan liela infrastruktūra. Un no visām šīm sistēmām (kuru mums, starp citu, ir milzīgs skaits) ir atkarīga interneta veikala darbība.
Un tā sanāk, ka mūsu nodaļa nepieder ne vienai komandai, bet atrodas nedaudz malā. Visā šajā situācijā mūsu uzdevums ir izprast kompleksajā veidā, kā darbojas informācijas sistēmas, to funkcionalitāte, integrācijas, programmatūra, tīkli, aparatūra un kā viss tas ir savstarpēji saistīts.
Platforma, uz kuras darbojas mūsu interneta veikali, izskatās šādi:
- front
- middle-office
- back-office
Neatkarīgi no tā, cik ļoti mēs gribētu, nav iespējams, ka visas sistēmas darbotos bez problēmām un nevainojami. Problēma atkal ir sistēmu un integrāciju skaitā - pie tāda skaita kā mums, daži incidenti ir neizbēgami, neskatoties uz testēšanas kvalitāti. Protams, gan iekšējā kādā atsevišķā sistēmā, gan to integrācijas aspektā. Un ir nepieciešams uzraudzīt visas platformas stāvokli kompleksā veidā, nevis koncentrēties tikai uz kādu atsevišķu tās daļu.
Ideālā gadījumā visa platformas veselības stāvokļa uzraudzību vajadzētu automatizēt. Un mēs nonācām pie uzraudzības kā neizbēgamas šī procesa sastāvdaļas. Sākotnēji tā tika izveidota tikai frontenam, bet arī tīklošanā, programmatūras un aparatūras administratoriem bija savas uzraudzības sistēmas pa slāņiem. Visi šie cilvēki uzraudzīja tikai savu līmeni, un neviens nebija ieguvis kompleksu izpratni.
Piemēram, ja virtuālā mašīna ir avarējusi, visbiežāk par to zina tikai administrators, kurš atbild par aparatūru un virtuālo mašīnu. Frontes komanda šādās situācijās ir pamanījusi tikai to, ka lietojumprogramma ir avarējusi, bet datus par virtuālās mašīnas avāriju viņa nav saņēmusi. Savukārt administrators var zināt, kurš ir pasūtītājs, un aptuveni iztēloties, kas tieši šobrīd notiek šajā virtuālajā mašīnā, ar nosacījumu, ka tas ir kāds liels projekts. Par mazajiem viņš, visticamāk, nezina. Tā vai citādi, administratoram jāiet pie īpašnieka un jāprasa, kas tad tieši bija šajā mašīnā, kas jāatjauno un kas jāmaina. Bet, ja bija kaut kas ļoti nopietns, sākās skrējiens pa apli — jo neviens neskatījās uz sistēmu kopumā.
Galu galā šādas sašķeltas histērijas ietekmē visu frontendi, lietotājus un mūsu galveno biznesa funkciju — interneta pārdošanu. Tā kā mēs neesam komandu daļa, bet nodarbojamies ar visu e-komercijas lietojumprogrammu ekspluatāciju, kas ietilpst interneta veikalā, mēs uzņēmāmies izveidot kompleksu e-komercijas platformas uzraudzības sistēmu.
Sistēmas struktūra un tehnoloģiskais kaudze
Mēs sākām ar to, ka izvirzījām vairākus uzraudzības slāņus mūsu sistēmām, kuru griezumā mums būs nepieciešams vākt metriku. Un visu to vajadzēja apvienot, ko mēs arī izdarījām pirmajā posmā. Pašlaik šajā posmā mēs pilnveidojam pēc iespējas augstāko metrikas vākšanu visos mūsu slāņos, lai izveidotu korelāciju un saprastu, kā sistēmas ietekmē viena otru.
Kompleksas uzraudzības trūkums lietojumprogrammu palaišanas sākumposmā (jo mēs sākām to veidot, kad lielākā daļa sistēmu bija ekspluatācijā) noveda pie tā, ka mums radās būtiskas tehniskās parāds uzraudzības uzstādīšanā visai platformai. Mēs nevarējām atļauties koncentrēties uz uzraudzības uzstādīšanu kādai vienai informācijas sistēmai un detalizēti izstrādāt uzraudzību tai, jo pārējās sistēmas kādu laiku paliktu bez uzraudzības. Šīs problēmas risināšanai mēs definējām sarakstu ar vissvarīgākajām metrikām informācijas sistēmas stāvokļa novērtēšanai pa slāņiem un sākām to ieviešanu.
Tāpēc nolēmām uzsākt darbu pakāpeniski.
Mūsu sistēma sastāv no:
- aparātūras;
- operētājsistēmas;
- programmatūras;
- UI daļas lietojumprogrammā uzraudzībai;
- uzņēmējdarbības metrikas;
- integrācijas lietojumprogrammas;
- informācijas drošība;
- tīkli;
- satelītbalansētāja.
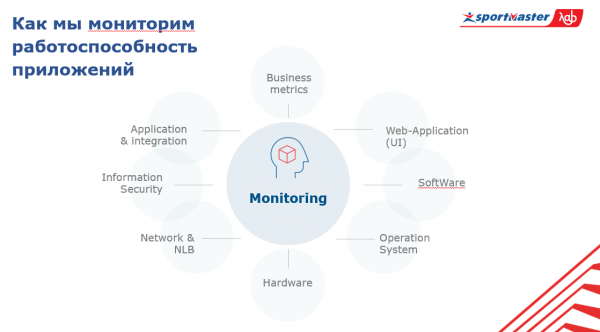
Šīs sistēmas centrā ir pati uzraudzība. Lai vispārīgi saprastu visa sistēmas stāvokli, jāzina, kas notiek ar lietojumprogrammām visos šajos slāņos un visā lietojumprogrammu daudzveidībā.
Tātad par steku.
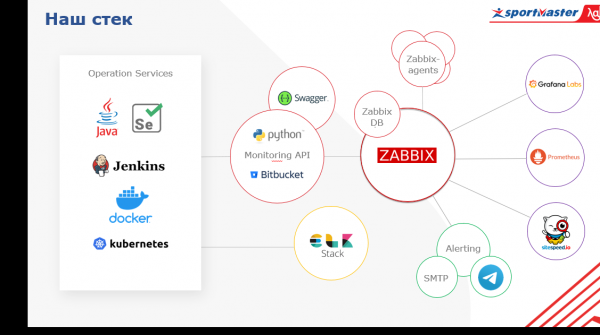
Mēs izmantojam programmatūru ar atvērtā koda. Mēs centrā izmantojam Zabbix, ko galvenokārt izmantosim kā trauksmes sistēmu. Visiem ir zināms, ka tas ir ideāli piemērots infrastruktūras uzraudzībai. Ko tas šeit nozīmē? Tieši tās zemā līmeņa metrikas, kas ir katrai uzņēmumam, kas uztur savu datu centru (un Sportmasteram ir pašu datu centri) — servera temperatūra, atmiņas stāvoklis, RAID, tīkla ierīču metri.
Mēs esam integrējuši Zabbix ar Telegram un Microsoft Teams, kas ir aktīvi izmantoti komandās. Zabbix aptver fakto tīklu, aparatūru un daļēji programmatūru, bet tas nav panaceja. Mēs šo datu bagātinām no dažādiem citiem pakalpojumiem. Piemēram, aparātūras līmenī mēs tieši caur API savienojamies mūsu virtualizācijas sistēmā un iegūstam datus.
Kas vēl. Papildus Zabbix mēs izmantojam Prometheus, kas ļauj uzraudzīt metrikas dinamiskajā vidē. Tas nozīmē, ka mēs varam saņemt lietojumprogrammas metrikas caur HTTP endpoint un neuztraukties par to, kādas metrikas tajās iekļaut, un kādas ne. Pamatojoties uz šiem datiem, var izstrādāt analītiskus pieprasījumus.
Datu avoti pārējiem slāņiem, piemēram, uzņēmējdarbības metrikām, mums dalās trīs komponentos.
Pirmkārt, tas ir ārēji biznesa sistēmas, Google Analytics, mēs vācam metrikas no žurnāliem. No tiem mēs iegūstam datus par aktīvajiem lietotājiem, konversijām un visu pārējo, kas saistīts ar biznesu. Otrkārt, tā ir UI uzraudzības sistēma. Par to jāstāsta sīkāk.
Kādreiz mēs sākām ar manuālo testēšanu, un tā pārauga automatizētajos testos funkcionalitātē un integrācijās. No tā mēs izveidojām uzraudzību, atstājot tikai galveno funkcionalitāti, un savijām to ar marķieriem, kas ir maksimāli stabilas un nemainās bieži laikā.
Jaunā komandām struktūra nozīmē, ka visa darbība ar lietojumprogrammām ir koncentrēta uz produktu komandām, tāpēc tīro testēšanu mēs esam pārtraukuši. Tā vietā mēs esam izveidojuši UI uzraudzību, kas uzrakstīta Java, Selenium un Jenkins (tiek izmantots kā palaišanas un ziņojumu ģenerēšanas sistēma).
Mums bija daudz testu, bet galu galā mēs nolēmām pievērsties augstākā līmeņa metriskajiem rādītājiem. Ja mums būs daudz specifisku testu, būs grūti saglabāt datu aktuālumu. Katrs nākamais atjauninājums ievērojami izjauks visu sistēmu, un mēs tikai nodarbosimies ar tās labošanu. Tāpēc mēs pievēršamies pilnīgi fundamentālām lietām, kas reti mainās, un uzraugām tikai tās.
Visbeidzot, trešais datu avots ir centralizēta žurnālu sistēma. Žurnāliem mēs izmantojam Elastic Stack, un pēc tam šos datus varam iekļaut mūsu biznesa metrikas uzraudzības sistēmā. Papildus tam darbojas mūsu pašu Monitoring API serviss, kas uzrakstīts Python, kas jautā par API jebkurām sistēmām un iegūst datus no tām Zabbix.
Vēl viens neaizvietojams uzraudzības atribūts ir vizualizācija. Mums tā tiek veidota, pamatojoties uz Grafana. Starp citām vizualizācijas sistēmām tā izceļas ar to, ka paneļos ir iespējams vizualizēt metrikas no dažādiem datu avotiem. Mēs varam apkopot augstākā līmeņa metrikas interneta veikalam, piemēram, pasūtījumu skaitu, kas veikti pēdējā stundā, no DB, operētājsistēmas snieguma metrikas, uz kuras darbojas šis interneta veikals, no Zabbix, un metrikas par šīs lietojumprogrammas instancēm - no Prometheus. Un viss tas būs vienā panelī. Pārskatāmi un viegli pieejami.
Gribu izcelt drošību - mēs šobrīd uzlabojam sistēmu, kuru vēlāk integrēsim ar globālo uzraudzības sistēmu. Manuprāt, galvenās problēmas, ar kurām e-komercija saskaras informācijas drošības jomā, ir saistītas ar robotiem, parseriem un brutālo spēku. Par šo ir jāuzrauga, jo tas var kritiski ietekmēt gan mūsu lietojumprogrammu darbību, gan reputāciju biznesa kontekstā. Un ar izvēlēto tehnoloģiju steku mēs šos uzdevumus veiksmīgi risinām.
Vēl viens svarīgs punkts ir tas, ka lietojumprogrammu līmeni vāc Prometheus. Tas ir arī integrēts ar Zabbix. Mums ir arī sitespeed, pakalpojums, kas ļauj mums sekot līdzi tādiem parametriem kā mūsu lapas ielādes ātrums, bottlenecks, lapas zīmējums, skriptu ielāde un citi, tas arī ir integrēts caur API. Tādējādi mūsu metrikas tiek vākta Zabbix, un attiecīgi mēs arī alertējam no turienes. Visi brīdinājumi pagaidām tiek nosūtīti caur galvenajiem sūtīšanas veidiem (pašlaik tas ir e-pasts un telegram, vēl nesen pievienojām MS Teams). Mūsu plānos ir pilnveidot brīdināšanas sistēmu līdz tādam līmenim, lai viedie roboti strādātu kā pakalpojums un sniegtu informāciju par monitoringu visām interesētajām produktu komandām.
Mums ir svarīgi ne tikai atsevišķu informāciju sistēmu metrikas, bet arī kopējie metrikas visai infrastruktūrai, ko izmanto lietojumprogrammas: klasteri fizisko serveru, uz kuriem ir izvietotas virtuālās mašīnas, trafika balanceri, Network Load Balancer-i, pati tīkla infrastruktūra, sakaru kanālu izmantošana. Klāt nāk metrikas par mūsu pašu datu centriem (mums ir vairāki un infrastruktūra ir diezgan nozīmīga).
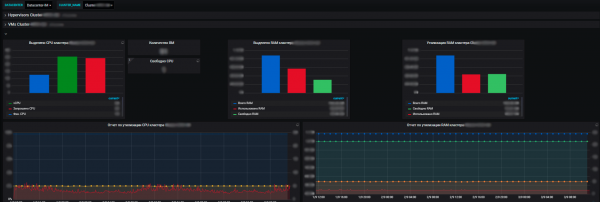
Mūsu monitoringa sistēmas priekšrocības ir tādas, ka ar tās palīdzību mēs redzam visu sistēmu darbības stāvokli, varam novērtēt to ietekmi vienai uz otru un uz kopējiem resursiem. Un, beigu beigās, tā ļauj plānot resursus, kas arī ir mūsu atbildības jomā. Mēs pārvaldām serveru resursus — pūlu e-komercijā, ievadām-izvadām no ekspluatācijas jaunu aparatūru, pērkam jaunu, veicam resursu izmantošanas auditu un citus darbus. Katru gadu komandas plāno jaunus projektus, attīsta savas sistēmas, un mums ir svarīgi nodrošināt viņiem resursus.
Un ar metrikām mēs redzam resursu patēriņa tendenci mūsu informācijas sistēmās. Un jau uz to pamata varam plānot. Virtualizācijas līmenī mēs vākjam datus un redzam informāciju par pieejamo resursu skaitu datu centru kontekstā. Savukārt datu centrā ir redzama gan izmantošana, gan faktiskā resursu sadalījuma un patēriņa informācija. Turklāt, gan ar standalone serveriem, gan ar virtuālajām mašīnām un fizisko serveru klasteriem, uz kuriem šīs virtuālās mašīnas aktīvi darbojas.
Nākotne
Šobrīd mēs esam sagatavojuši sistēmas kodolu kopumā, taču joprojām ir pietiekami daudz aspektu, pie kuriem vēl jāstrādā. Vismaz tas ir informācijas drošības slānis, taču ir svarīgi arī nokļūt pie tīkla, attīstīt alertinga sistēmu un atrisināt korelācijas jautājumu. Mums ir daudz slāņu un sistēmu, katrā slānī vēl ir daudz metriku. Sanāk, ka tas ir kā matryoshka, kurā ir vēl matryoshkas.
Mūsu uzdevums ir galu galā izveidot pareizu alertus. Piemēram, ja rodas problēma ar aparatūru, vēlreiz, ar virtuālo mašīnu, un tur bija svarīga lietojumprogramma, un pakalpojums nebija rezervēts. Mēs uzzinām, ka virtuālā mašīna ir apstājusies. Tad tiks ziņots par biznesa metriem: lietotāji kaut kur pazuduši, konversijas nav, UI interfeisā nav pieejams, arī programmatūra un pakalpojumi ir apstājušies.
Ar šādu izkārtojumu mēs saņemsim alertu nevēlamo informāciju, un tas jau neatbilst pareizas uzraudzības sistēmas formātam. Izvirzās korelācijas jautājums. Tāpēc ideālā situācijā mūsu uzraudzības sistēmai vajadzētu teikt: "Puiši, jūsu fiziskā mašīna ir apstājusies, un kopā ar to arī šī lietojumprogramma un šie metri", izmantojot vienu alertu, nevis apgāžot mūs simtiem alertu. Tai jāziņo par galveno — par iemeslu, kas veicina problēmas operatīvu novēršanu, lokalizējot to.
Mūsu brīdināšanas sistēma un alertu apstrāde ir izveidota ap 24/7 karsto līniju. Visi alerti, kas tiek uzskatīti par obligātiem un iekļauti pārbaudes sarakstā, tiek nosūtīti tur. Katram alertam obligāti jābūt aprakstam: kas notika, ko tas īsti nozīmē, kādu ietekmi tas rada. Un vēl saite uz informācijas paneli un instrukcijas, ko darīt šajā gadījumā.
Tas viss attiecas uz prasībām alertinga izveidei. Turpmākā situācija var attīstīties divos virzienos — vai nu ir problēma, kuru jāpatur prātā, vai arī notikusi monitoringa sistēmas kļūme. Bet jebkurā gadījumā ir jādodas un jānoskaidro.
Vidēji tagad dienā mēs saņemam ap simts alertu, ņemot vērā to, ka alertu korelācija vēl nav pienācīgi iestatīta. Un ja ir jāveic tehniskie darbi un mēs kaut ko piespiedu kārtā atslēdzam, to skaits pieaug vairākas reizes.
Papildus mūsu pārvaldītajām sistēmām un metrikām, kuras mēs uzskatām par svarīgām, monitoringa sistēma ļauj vākt datus produktu komandām. Tās var ietekmēt to metrikas, kas tiek uzraudzītas mūsu informācijas sistēmās.
Mūsu kolēģis var nākt un lūgt pievienot kādu metrikai, kas izrādīsies noderīga gan mums, gan komandai. Piemēram, komandai var nebūt pietiekami daudz pamatu metrikas, un viņiem var būt nepieciešams uzraudzīt kaut ko specifisku. Grafana mēs izveidojam telpu katrai komandai un piešķiram administrētāja tiesības. Turklāt, ja komandai nepieciešami informācijas paneļi, bet viņi paši to nevar izdarīt vai nezina, kā to izdarīt, mēs viņiem palīdzam.
Tā kā mēs neesam vērtības radīšanas, komandu relīžu un plānošanas plūsmā, mēs pakāpeniski nonākam pie tā, ka visu sistēmu relīzes ir nevainojamas un tās var ieviest katru dienu, nesaskaņojot ar mums. Mums ir svarīgi uzraudzīt šīs relīzes, jo tās potenciāli var ietekmēt lietojumprogrammas darbību un kaut ko salauzt, kas ir kritiski. Relīžu pārvaldībai mēs izmantojam Bamboo, no kura API mēs iegūstam datus un varam redzēt, kuras relīzes ir iznākušas un to statusu. Un vissvarīgākais — kad.
Tādējādi mēs varam redzēt korelāciju starp jaunām relīzēm un radušām problēmām. Galvenā ideja ir saprast, kā sistēma darbojas visos slāņos, ātri lokalizēt problēmu un arī ātri to novērst. Galu galā bieži vien visvairāk laika prasa ne problēmas risināšana, bet iemesla meklēšana.
Un mēs vēlamies fokusēties uz proaktivitāti šajā virzienā nākotnē. Ideālā gadījumā mēs vēlētos iepriekš uzzināt par tuvākajām problēmām, nevis pēc fakta, lai nodarboties ar to novēršanu, nevis risināšanu. Dažkārt notiek nepatiesas trauksmes monitoringa sistēmā, gan cilvēciskas kļūdas, gan izmaiņu dēļ lietojumprogrammā. Mēs strādājam pie tā, uzlabojam un cenšamies brīdināt tos lietotājus, kas kopā ar mums izmanto monitoringa sistēmu pirms jebkādām manipulācijām, vai arī šos pasākumus veikt tehniskajā logā.
Tātad, sistēma ir sākta un veiksmīgi darbojas kopš pavasara sākuma... un rāda diezgan reālus ieņēmumus. Protams, tā nav tās galīgā versija, vēl daudz noderīgu funkciju tiks iekļautas. Bet šobrīd, ar tik lielu integrāciju un lietojumprogrammu skaitu, automatizēts monitorings patiesībā ir neizbēgams.
Ja arī jūs tāpat sekojat lieliem projektiem ar nopietnu integrāciju skaitu — uzrakstiet komentāros, kādu sudraba lodi atradāt šim mērķim.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish