

Pagaidiet! Pagaidiet! Patiesi, tā nav kārtējā raksts par SQL Server atjaunošanas veidiem. Es pat nestāstīšu par atjaunošanas modeļu atšķirībām un kā cīnīties ar palielināto "žurnālu".
Iespējams (tikai iespējams), pēc šī ieraksta izlasīšanas jūs varēsiet panākt, ka dublējums, kuru veicat ar standarta rīkiem, rīt naktī tiks veikts aptuveni 1.5 reizes ātrāk. Un tikai tāpēc, ka jūs izmantosiet nedaudz vairāk BACKUP DATABASE parametru.
Ja šī ieraksta saturs jums bija acīmredzams — atvainojiet. Es izlasīju visu, ko atradu Google ar frāzi "habr sql server backup", un nevienā rakstā neatradu atzinumu par to, ka dublēšanas laikā varētu kādā veidā ietekmēt to ar parametru palīdzību.
Uzreiz pievērsīšu jūsu uzmanību Aleksandra Glādčenko komentāram ():
Nekad nemainiet parametrus BUFFERCOUNT, BLOCKSIZE, MAXTRANSFERSIZE ražošanas vidē. Tie ir paredzēti tikai līdzīgu rakstu rakstīšanai. Praksē jūs saskarsieties ar atmiņas problēmām.
Būtu, protams, lieliski būt visgudrākajam un publicēt ekskluzīvu saturu, taču, diemžēl, tā nav. Ir angļu un krievu valodā raksti/publikācijas (vienmēr jūtos apmaldījies, kā tos pareizi nosaukt), kas veltīti šai tēmai. Šeit ir daļa no tām, kas man gadījās: , , .
Tātad, vispirms es pievienošu dažas saīsinātas BACKUP sintakses no (starpcitu, iepriekš es pieminēju BACKUP DATABASE, bet viss tas attiecas arī uz transakciju žurnāla dublēšanu un diferenciālo dublēšanu, bet, iespējams, ar mazāk acīmredzamu efektu):
BACKUP DATABASE { database_name | @database_name_var }
  TO  [ ,...n ]

  [ WITH {
           |  [ ,...n ] } ]
[;]

 [ ,...n ]::=

--Media Set Options

 | BLOCKSIZE = { blocksize | @blocksize_variable }

--Data Transfer Options
   BUFFERCOUNT = { buffercount | @buffercount_variable }
 | MAXTRANSFERSIZE = { maxtransfersize | @maxtransfersize_variable }
— nozīmē, ka tur bija kaut kas, bet es to izņēmu, jo šobrīd tas nav attiecīgs tematikai.
Kā jūs parasti veicat dublēšanu? Kā “māca” veikt dublēšanu miljoniem rakstu? Vispār, ja man vajadzēs vienreiz veikt dublēšanu kādai ne pārāk lielai datu bāzei, es automātiski uzrakstīšu kaut ko līdzīgu šim:
BACKUP DATABASE smth
TO DISK = 'D:Backupsmth.bak'
WITH STATS = 10, CHECKSUM, COMPRESSION, COPY_ONLY;
-- labi, CHECKSUM es uzrakstīju tikai lai liktos gudrāk
Un, kopumā, šeit ir uzskaitīti, iespējams, 75-90% no visiem parametriem, kas parasti tiek pieminēti rakstos par dublēšanu. Nu, tur ir arī INIT, SKIP un vēl. Vai esat apmeklējuši MSDN? Vai redzējāt, ka tur ir iespēju uz pusotru ekrānu? Es arī redzēju…
Droši vien jau sapratāt, ka tālāk runa ies par trim parametriem, kas palikuši pirmajā koda blokā — BLOCKSIZE, BUFFERCOUNT un MAXTRANSFERSIZE. Lūk, to apraksti no MSDN:
BLOCKSIZE = { blocksize | @ blocksize_variable } — norāda fiziskā bloka lielumu baitos. Atbalstītie izmēri ir 512, 1024, 2048, 4096, 8192, 16 384, 32 768 un 65 536 baidi (64 KB). Noklusējuma vērtība ir 65 536 lentu ierīcēm un 512 citām ierīcēm. Parasti šis parametrs nav nepieciešams, jo BACKUP instrukcija automātiski izvēlas blokam atbilstošo lielumu. Izteikta bloka lieluma iestatīšana pārdefinē automātisko lieluma izvēli.
BUFFERCOUNT = { buffercount | @ buffercount_variable } — nosaka kopējo ievades-izejas buferu skaitu, kas tiks izmantoti dublēšanas operācijā. Var norādīt jebkuru veselu pozitīvu vērtību, taču liels buferu skaits var izraisīt atmiņas trūkuma kļūdu pārāk liela virtuālā adresācijas telpā procesā Sqlservr.exe.
Kopējais buferu izmantotās telpas apjoms tiek noteikts pēc šādas formulas:
BUFFERCOUNT * MAXTRANSFERSIZE.
MAXTRANSFERSIZE = { maxtransfersize | @ maxtransfersize_variable } norāda maksimālo datu pakotnes lielumu baitos, lai apmainītos ar datiem starp SQL Server un dublējuma nesēju. Atbalstītās vērtības ir, kas dalās ar 65 536 baitiem (64 KB), līdz pat 4 194 304 baiti (4 MB).
Es zvēru — es to lasīju agrāk, bet man pat prātā neienāca, kāds var būt to ietekme uz veiktspēju. Turklāt, šķiet, man ir jāveic savdabīgs „nāciens ārā” un jāatzīst, ka pat šobrīd es ne līdz galam saprotu, ko tie īsti dara. Droši vien vajadzētu vairāk izlasīt par buferu ievadi-izeju un darbību ar cieto disku. Kadreiz es to izdarīšu, bet tagad varu vienkārši uzrakstīt skriptu, kas pārbaudīs, kā šie lielumi ietekmē ātrumu, ar kādu izņem dublējumu.
Izveidoju nelielu datubāzi, apmēram 10 GB lielu, novietoju to uz SSD un dublējumu katalogu uz HDD.
Esmu izveidojis pagaidu tabulu rezultātu glabāšanai (mani tā nav pagaidu, lai varētu sīkāk pētīt rezultātus, bet jūs jau paši izlemiet):
DROP TABLE IF EXISTS ##bt_results;

CREATE TABLE ##bt_results (
    id              int IDENTITY (1, 1) PRIMARY KEY,
    start_date      datetime NOT NULL,
    finish_date     datetime NOT NULL,
    backup_size     bigint NOT NULL,
    compressed_size bigint,
    block_size      int,
    buffer_count    int,
    transfer_size   int
);
Skripta darbības princips ir vienkāršs — iedziļināšanās ciklos, katrs no kuriem maina viena parametra vērtību, pievienoju šos parametrus komandas BACKUP, saglabāju pēdējo ierakstu no msdb.dbo.backupset, dzēšu dublējuma failu un nākamā iterācija. Tā kā informācija par dublējuma izpildi nāk no backupset, precizitāte nedaudz zaudējas (tur nav sekundes daļu), bet mēs to pārdzīvosim.
Vispirms jāatļauj xp_cmdshell izmantošana, lai dzēstu dublējumus (pēc tam neaizmirstiet to atslēgt, ja tas jums nav vajadzīgs):
EXEC sp_configure 'show advanced options', 1;
EXEC sp_configure 'xp_cmdshell', 1;
RECONFIGURE;
EXEC sp_configure 'show advanced options', 0;
GO
Nu un, pašos svarīgākajos jautājumos:
DECLARE @tmplt AS nvarchar(max) = N'
BACKUP DATABASE [bt]
TO DISK = ''D:SQLServerbackupbt.bak''
WITH
    COMPRESSION,
    BLOCKSIZE = {bs},
    BUFFERCOUNT = {bc},
    MAXTRANSFERSIZE = {ts}';

DECLARE @sql AS nvarchar(max);


bsp;  -- BLOCKSIZE values
DECLARE @bs     int = 4096,
        @max_bs int = 65536;


bsp;  -- BUFFERCOUNT values
DECLARE @bc     int = 7,
        @min_bc int = 7,
        @max_bc int = 800;


bsp;  -- MAXTRANSFERSIZE values
DECLARE @ts     int = 524288,   -- 512KB, default = 1024KB
        @min_ts int = 524288,
        @max_ts int = 4194304;  -- 4MB

SELECT TOP 1
    @bs = COALESCE (block_size, 4096),
    @bc = COALESCE (buffer_count, 7),
    @ts = COALESCE (transfer_size, 524288)
FROM ##bt_results
ORDER BY id DESC;

WHILE (@bs <= @max_bs)
BEGIN
    WHILE (@bc <= @max_bc)
    BEGIN
        WHILE (@ts <= @max_ts)
        BEGIN
            SET @sql = REPLACE (REPLACE (REPLACE(@tmplt, N'{bs}', CAST(@bs AS nvarchar(50))), N'{bc}', CAST (@bc AS nvarchar(50))), N'{ts}', CAST (@ts AS nvarchar(50)));

            EXEC (@sql);

            INSERT INTO ##bt_results (start_date, finish_date, backup_size, compressed_size, block_size, buffer_count, transfer_size)
            SELECT TOP 1 backup_start_date, backup_finish_date, backup_size, compressed_backup_size,  @bs, @bc, @ts
            FROM msdb.dbo.backupset
            ORDER BY backup_set_id DESC;

            EXEC xp_cmdshell 'del "D:SQLServerbackupbt.bak"', no_output;

            SET @ts += @ts;
        END

        SET @bc += @bc;
        SET @ts = @min_ts;

        WAITFOR DELAY '00:00:05';
    END

    SET @bs += @bs;
    SET @bc = @min_bc;
    SET @ts = @min_ts;
END
Ja jums nepieciešami paskaidrojumi par to, kas šeit notiek — rakstiet komentāros vai privāti. Pašlaik pastāstīšu tikai par parametriem, kurus es pievienoju BACKUP DATABASE.
BLOCKSIZE ir mūsu „slēgts” vērtību saraksts, un man nebija rezerves kopijas ar BLOCKSIZE < 4KB. MAXTRANSFERSIZE var būt jebkura skaitļa reizinājums ar 64KB — no 64KB līdz 4MB. Noklusējuma manā sistēmā ir 1024KB, es izvēlējos 512 — 1024 — 2048 — 4096.
Grūtāk bija ar BUFFERCOUNT — tam var būt jebkurš pozitīvs skaitlis, bet saite norāda . Turpat ir aprakstīts, kā iegūt informāciju par to, ar kuru BUFFERCOUNT patiesībā tiek veikta rezerves kopija — man tas ir 7. Samazināt to nebija jēgas, bet augšējā robeža tika noteikta eksperimentāli — pie BUFFERCOUNT = 896 un MAXTRANSFERSIZE = 4194304 rezerves kopija neizdevās ar kļūdu (par ko ir minēts augstāk):
Msg 3013, Level 16, State 1, Line 7 BACKUP DATABASE ir beidzies anomāli.
Msg 701, Level 17, State 123, Line 7 Sistēmas atmiņa resursu grupā 'default' nav pietiekama, lai izpildītu šo vaicājumu.
Salīdzinājumam, vispirms parādīšu rezultātus, veicot rezerves kopiju vispār bez parametru norādīšanas:
BACKUP DATABASE [bt]
TO DISK = 'D:SQLServerbackupbt.bak'
WITH COMPRESSION;
Nu, rezerves kopija ir rezerves kopija:
Apstrādāti 1070072 lapas datubāzei ‘bt’, fails ‘bt’ failā 1.
Apstrādāti 2 lapas datubāzei ‘bt’, fails ‘bt_log’ failā 1.
BACKUP DATABASE veiksmīgi apstrādāti 1070074 lapas 53.171 sekundēs (157.227 MB/sek).
Paša skripts, kas testē parametrus, strādāja pāris stundas, visi mērījumi ir . Un šeit ir rezultātu izvēle, kurās ir trīs labākie izpildes laiki (es mēģināju izveidot skaistu diagrammu, bet, ierakstā būs jānoplūkt ar tabulu, bet komentāros pievienots ).
SELECT TOP 7 WITH TIES
    compressed_size,
    block_size,
    buffer_count,
    transfer_size,
    DATEDIFF(SECOND, start_date, finish_date) AS backup_time_sec
FROM ##bt_results
ORDER BY backup_time_sec ASC;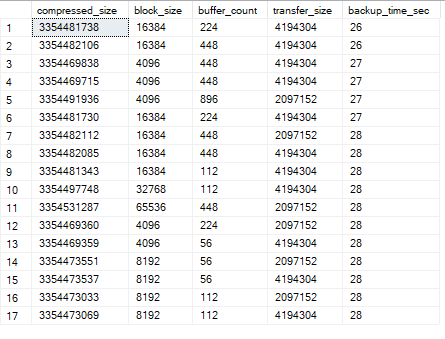
Uzmanību, uzreiz ļoti svarīgs komentārs no no :
paļāvīgi var teikt, ka saistība starp parametriem un rezerves kopijas ātrumu šajos vērtību intervālos ir nejauša, nekādas likumības nav. Bet novirze no iebūvētajiem parametriem, acīmredzami, labi ietekmēja rezultātu
Tas ir, tikai pateicoties standarta BACKUP parametru pārvaldībai tika iegūts laika ieguvums rezerves kopijas izņemšanā 2 reizes: 26 sekundes, salīdzinot ar 53 sākumā. Bet tas nav slikti, vai ne? Bet jāpārbauda, kā ir ar atjaunošanu. Varbūt tagad atjaunot būs 4 reizes ilgāk?
Vispirms izmērīsim, cik ilgi ilgst rezerves kopijas atjaunošana ar noklusējuma iestatījumiem:
RESTORE DATABASE [bt]
FROM DISK = 'D:SQLServerbackupbt.bak'
WITH REPLACE, RECOVERY;
Nu, to jūs paši zināt, ceļi tur, replace-ne replace, recovery-ne recovery. Un man tas izpildās tā:
Apstrādāti 1070072 lapas datubāzei ‘bt’, fails ‘bt’ failā 1.
Apstrādāti 2 lapas datubāzei ‘bt’, fails ‘bt_log’ failā 1.
RESTORE DATABASE veiksmīgi apstrādāja 1070074 lapas 40.752 sekundēs (205.141 MB/sek).
Tagad mēģināšu atjaunot rezerves kopijas, kas izveidotas ar mainītiem BLOCKSIZE, BUFFERCOUNT un MAXTRANSFERSIZE.
BLOCKSIZE = 16384, BUFFERCOUNT = 224, MAXTRANSFERSIZE = 4194304RESTORE DATABASE veiksmīgi apstrādāja 1070074 lapas 32.283 sekundēs (258.958 MB/sek).
BLOCKSIZE = 4096, BUFFERCOUNT = 448, MAXTRANSFERSIZE = 4194304RESTORE DATABASE veiksmīgi apstrādāja 1070074 lapas 32.682 sekundēs (255.796 MB/sek).
BLOCKSIZE = 16384, BUFFERCOUNT = 448, MAXTRANSFERSIZE = 2097152RESTORE DATABASE veiksmīgi apstrādāja 1070074 lapas 32.091 sekundēs (260.507 MB/sek).
BLOCKSIZE = 4096, BUFFERCOUNT = 56, MAXTRANSFERSIZE = 4194304RESTORE DATABASE veiksmīgi apstrādāja 1070074 lapas 32.401 sekundēs (258.015 MB/sek).
RESTORE DATABASE instrukcija atjaunošanas procesā nemainās, tajā nav norādītas šīs parameters, SQL Server tās nosaka pats pēc rezerves kopijas. Un redzams, ka pat atjaunošanas laikā var būt ieguvums — praktiski par 20% ātrāk (godīgi sakot, netiku daudz laika veltījis atjaunošanai, pārbaudīju dažas no "ātrākajām" rezerves kopijām un pārliecinājos, ka nav pasliktināšanās).
Vispārīgi precizēšu – šeit aprakstīti nav kādi optimāli visiem parametri. Optimālus parametrus savu sistēmai jūs varat iegūt tikai ar testēšanu. Es ieguvu šādus rezultātus, jūs saņemsiet citus. Bet jūs redzat, ka savas rezerves kopijas var "atzīmēt" un tās patiešām var veidoties un atjaunoties ātrāk.
Vēlreiz stingri iesaku izlasīt dokumentāciju pilnībā, jo tieši jūsu sistēmai var būt nianses.
Kopš esmu sācis rakstīt par rezerves kopijām, vēlos uzreiz rakstīt vēl par vienu "optimizāciju", kas sastopama biežāk nekā "tuning" parametri (to, cik es saprotu, izmanto vismaz daļa rezerves kopēšanas utilītu, iespējams, kopā ar iepriekš aprakstītajiem parametriem), bet Habrē tā arī nav aprakstīta.
Ja paskatāmies uz otro rindiņu dokumentācijā, tieši zem BACKUP DATABASE, mēs redzam:
TO [, ...n]Kā jūs domājat, kas notiks, ja norādīsiet vairākus backup_device? Sintakse taču atļauj. Bet notiks ļoti interesanta lieta — rezerves kopija vienkārši "izplūdīs" pa vairākiem ierīcēm. Tas ir, katra "ierīce" atsevišķi būs bezjēdzīga, zaudējāt vienu, zaudējāt visu rezerves kopiju. Bet kā šāda izplūšana ietekmēs rezerves kopēšanas ātrumu?
Mēģināsim veikt rezerves kopiju uz divām "ierīcēm", kas atrodas blakus vienā mapē:
BACKUP DATABASE [bt]
TO
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak'
WITH COMPRESSION;
Ak dievs, kas šeit notiek?
Apstrādāti 1070072 lapas datubāzei ‘bt’, fails ‘bt’ failā 1.
Apstrādātas 2 lapas datubāzei ‘bt’, fails ‘btžurnālā’ failā 1.
DATUBĀZES DUMPA izveide veiksmīgi apstrādāja 1070074 lapas 40.092 sekunžu laikā (208.519 MB/sek).
Dumperis izveidojas par 25% ātrāk bez redzama iemesla? Bet, ja pievieno vēl pāris ierīces?
DATUBĀZES DUMP [bt]
TĀ,
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak',
    DISK = 'D:SQLServerbackupbt3.bak',
    DISK = 'D:SQLServerbackupbt4.bak'
AR KOMPRESIJU;
DATUBĀZES DUMPA izveide veiksmīgi apstrādāja 1070074 lapas 34.234 sekunžu laikā (244.200 MB/sek).
Kopumā, ieguvums apmēram 35% laika dumpera izveidē, tikai dēļ tā, ka dumps tiek rakstīts uzreiz 4 failiem vienā diskā. Esmu pārbaudījis lielāku skaitu — manā klēpjdatorā ieguvuma nav, optimāli — 4 ierīces. Jums — nezinu, jāizmēģina. Un, starp citu, ja jums šīs ierīces — tiešām dažādi diski, apsveicu, ieguvumam vajadzētu būt vēl ievērojamākam.
Tagad runāsim par to, kā šo laimi atjaunot. Lai to izdarītu, būs jāmaina atjaunošanas komanda un jāpārskaita visas ierīces:
ATJAUNOT DATUBĀZI [bt]
NO
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak',
    DISK = 'D:SQLServerbackupbt3.bak',
    DISK = 'D:SQLServerbackupbt4.bak'
AR AIZSTĀJUMU, ATJAUNOŠANU;
DATUBĀZES ATJAUNOŠANA veiksmīgi apstrādāja 1070074 lapas 38.027 sekunžu laikā (219.842 MB/sek).
Nedaudz ātrāk, bet apmēram līdzīgi, nesvarīgi. Kopumā dumps izveidots ātrāk, un atjaunošanu veic tādā pašā ātrumā — vai tas ir veiksme? Manuprāt — diezgan liela veiksme. Tas ir svarīgi,tāpēc atkārtošos — ja jūs zaudet pat vienu no šiem failiem — zaudējat visu dumpu..
Ja paskatās žurnālā informāciju par dumpu, ko izlaiž ar Trace Flag 3213 un 3605, tad var pamanīt, ka, veidojot dumpu uz vairākām ierīcēm, vismaz palielinās BUFFERCOUNT skaits. Varbūt varētu izmēģināt noteikt optimālākus parametrus arī BUFFERCOUNT, BLOCKSIZE, MAXTRANSFERSIZE, bet man uzreiz tas neizdevās, un veikt šādu testēšanu vēlreiz, bet dažādu failu skaitam, man nebija vēlēšanās. Arī diski ir žēl. Ja vēlaties organizēt šādu testēšanu, skriptu pārveidot nav grūti.
Beidzot runāsim par cenu. Ja dumps tiek veidots paralēli ar lietotāju darbu — jāpievērš ārkārtīgi nopietni testēšanai, jo, ja dumps tiek veidots ātrāk — diski tiek vairāk noslogoti, procesora slodze pieaug (taču tas viss vēl jākompresē uz vietas), attiecīgi, samazinās sistēmas vispārējā atsaucība.
Joki-joki, bet es pilnīgi saprotu, ka nekādus atklājumus neesmu izdarījis. Tas, kas minēts augstāk, ir tikai paraugdemonstrējums, kā var pielāgot optimālos parametrus dublēšanas veikšanai.
Atcerieties, ka viss, ko darāt — darāt uz savu risku. Pārbaudiet savus dublējumus un neaizmirstiet par DBCC CHECKDB.
Avots: habr.com
