

Piezīme:: Kubernetes pielāgošanu GitLab uzskata par vienu no diviem galvenajiem faktoriem, kas veicina uzņēmuma izaugsmi. Tomēr līdz nesenam laikam GitLab.com tiešsaistes pakalpojuma infrastruktūra tika veidota uz virtuālajām mašīnām, un tikai pirms apmēram gada tika uzsākta tās migrācija uz K8s, kas joprojām nav pabeigta. Priecājamies piedāvāt tulkojumu nesenai GitLab SRE inženiera rakstam par to, kā tas notiek un kādi secinājumi ir inženieriem, kas piedalās projektā.
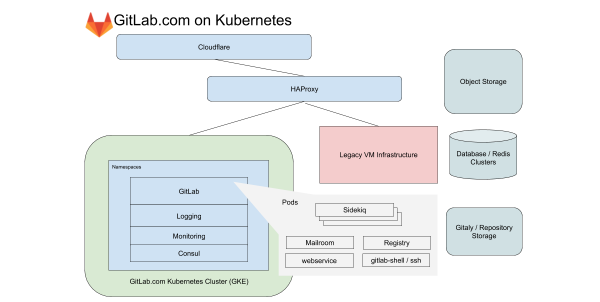
Jau apmēram gadu mūsu infrastruktūras nodaļa nodarbojas ar visu pakalpojumu migrāciju uz GitLab.com Kubernetes. Šajā laikā mēs esam saskārušies ar problēmām, kas saistītas ne tikai ar pakalpojumu pārvietošanu uz Kubernetes, bet arī ar hibrīda izvietojuma pārvaldību pārejas laikā. Par vērtīgajiem mācību procesiem, ko esam saņēmuši, tiks runāts šajā rakstā.
Kopš paša sākuma GitLab.com tā serveri darbojās mākonī uz virtuālajām mašīnām. Šīs virtuālās mašīnas pārvalda Chef, un to uzstādīšana notiek, izmantojot mūsu . gadījumam, ja nepieciešams atjaunināt lietojumprogrammu, sastāv no vienkārša serveru parka atjaunināšanas saskaņotā secīgā veidā, izmantojot CI cauruļvadu. Šī metode — lai gan tā ir lēna un nedaudz — nodrošina, ka GitLab.com izmanto tādus pašus uzstādīšanas un konfigurēšanas veidus, kā lietotāji autonomās (self-managed) GitLab instalācijās, kas izmanto mūsu Linux paketes.
Mēs izmantojam šo metodi, jo ir ārkārtīgi svarīgi izjust visas bēdas un priekus, ko piedzīvo parastie kopienas pārstāvji, kad uzstāda un konfigurē savas GitLab kopijas. Šis pieejas ceļš labi darbojās kādu laiku, taču kad projektu skaits GitLab pārsniedza 10 miljonus, mēs sapratām, ka tas vairs nesniedz mūsu prasībām pēc mērogojamības un izvietošanas.
Pirmie soļi uz Kubernetes un cloud-native GitLab
2017. gadā tika izveidots projekts lai sagatavotu GitLab ieviešanai mākoņos un sniegtu lietotājiem iespēju instalēt GitLab Kubernetes klasteros. Tajā laikā mēs sapratām, ka GitLab pārvietošana uz Kubernetes palielinās SaaS platformas mērogojamību, atvieglos izvietojumus un uzlabos skaitļošanas resursu izmantošanas efektivitāti. Tajā pašā laikā daudzas mūsu lietojumprogrammas funkcijas bija atkarīgas no pievienotiem NFS nodalījumiem, kas kavēja pāreju no virtuālajām mašīnām.
Tieksme uz cloud native un Kubernetes ļāva mūsu inženieriem plānot pakāpenisku pāreju, kuras laikā mēs atteicāmies no dažām lietojumprogrammas atkarībām no tīkla glabātuvēm, vienlaikus turpinot attīstīt jaunas funkcijas. Kopš mēs sākām plānot migrāciju 2019. gada vasarā, daudzi no šiem ierobežojumiem ir novērsti, un GitLab.com pārcelšana uz Kubernetes tagad norit pilnā sparā!
GitLab.com darbības īpašības Kubernetes vidē
GitLab.com mēs izmantojam vienotu reģionālo GKE klasteri, kas apstrādā visu lietojumprogrammas trafiku. Lai minimizētu sarežģītību (jau tā sarežģītā) migrācijā, koncentrējamies uz pakalpojumiem, kas nav atkarīgi no lokālās glabāšanas vai NFS. GitLab.com galvenokārt izmanto monolītu kodu bāzi uz Rails, un mēs vēršam trafiku atkarībā no darba slodzes raksturlielumiem uz dažādiem galapunktiem, kas ir izolēti savos īpašajos mezglu baseinos.
Runājot par frontend, šie veidi tiek dalīti pieprasījumos uz web, API, Git SSH/HTTPS un Registry. Attiecībā uz backend mēs sadalām uzdevumus rindās pēc dažādiem raksturlielumiem atkarībā no , kas ļauj mums noteikt pakalpojuma līmeņa mērķus (Service-Level Objectives, SLOs) dažādām slodzēm.
Visi šie pakalpojumi GitLab.com ir konfigurēti, izmantojot nemodificētu GitLab Helm chart. Konfigurācija tiek veikta apakšgrafikos, kas var tikt izvēles veidā iekļauti pakāpeniski, kad mēs pārvietojam pakalpojumus uz klasteri. Pat ņemot vērā, ka tika nolemts neiekļaut migrācijā dažus no mūsu stateful pakalpojumiem, piemēram, Redis, Postgres, GitLab Pages un Gitaly, Kubernetes izmantošana ļauj radikāli samazināt virtuālo mašīnu skaitu, kuras šobrīd pārvalda Chef.
Kubernetes caurspīdīgums un konfigurācijas pārvaldība
Visas iestatījumus pārvalda pats GitLab. Tam tiek izmantoti trīs konfigurācijas projekti, kas balstīti uz Terraform un Helm. Mēs cenšamies visur izmantot pašu GitLab, lai palaistu GitLab, taču ekspluatācijas uzdevumiem mums darbojas atsevišķa GitLab instalācija. Tā nepieciešama, lai mēs nebūtu atkarīgi no GitLab.com pieejamības, veicot izsaiņošanu un atjauninājumus uz GitLab.com.
Lai gan mūsu Kubernetes klastera caurules darbojas atsevišķā GitLab instalācijā, kodu repozitorijiem ir spoguļi, kas publiski pieejami šādās adresēs:
- — konfigurācijas saite GitLab.com Helm diagrammai;
- — satur konfigurācijas pakalpojumiem, kas nav tieši saistīti ar GitLab lietotni. Tajos ietilpst konfigurācijas žurnālu pārvaldībai un klastera uzraudzībai, kā arī integrētiem rīkiem, piemēram, PlantUML;
- — Terraform konfigurācija Kubernetes un vecajai (legacy) VM infrastruktūrai. Šeit tiek konfigurēti visi resursi, kas nepieciešami klastera palaišanai, tostarp pats klasteris, mezglu kopas, dienesta konti, IP adrešu rezervēšana.

Veicot izmaiņas, tiek rādīts publisks ar saiti uz detalizētu diff, ko SRE analizē pirms izmaiņu veikšanas klasterī.
SRE saite ved uz detalizētu diff GitLab instalācijā, kas tiek izmantota ekspluatācijā un piekļuve tai ir ierobežota. Tas ļauj darbiniekiem un kopienai, kuriem nav piekļuves ekspluatācijas projektam (tas ir atvērts tikai SRE), skatīt ieteiktās izmaiņas konfigurācijā. Apvienojot publisku GitLab piemēru kodam ar slēgtu piemēru CI caurulēm, mēs nodrošinām vienotu darba procesu, vienlaikus garantējot neatkarību no GitLab.com konfigurāciju atjauninājumos.
Ko mēs uzzinājām migrācijas laikā
Migrācijas procesā tika gūta pieredze, kuru mēs pielietojam jaunās migrācijās un izvietojumos Kubernetes.
1. Izmaksu pieaugums dēļ trafika starp pieejamības zonām.
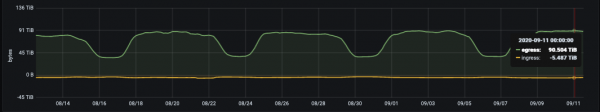
Ikdienas egress statistika (baiti dienā) GitLab.com Git glabātuves parkam.
Google sadala savu tīklu reģionos. Tie, savukārt, tiek iedalīti pieejamības zonās (AZ). Git mitināšana ir saistīta ar lieliem datu apjomiem, tāpēc mums ir svarīgi kontrolēt tīkla egress. Iekšējā datu plūsmā egress ir bez maksas tikai tad, ja tā paliek viena pieejamības zonas robežās. Raksta rakstīšanas brīdī mēs ikdienā nododam apmēram 100 TB datu (un tas ir tikai Git repozitorijiem). Pakalpojumi, kas mūsu vecajā VM balstītajā topoloģijā atradās uz vienām un tām pašām virtuālajām mašīnām, tagad darbojas dažādos Kubernetes pod'os. Tas nozīmē, ka daļa datu plūsmu, kas iepriekš bija vietēja VM, potenciāli var izkļūt ārpus pieejamības zonām.
Reģionālie GKE klasteri ļauj aptvert vairākas pieejamības zonas rezerves nodrošināšanai. Mēs apsveram iespēju pakalpojumiem, kas ģenerē lielus datu plūsmu apjomus. Tas samazinās egress izmaksas, saglabājot klastera līmeņa rezerves nodrošināšanu.
2. Resursu limitu, pieprasījumu un mērogošanas jautājumi
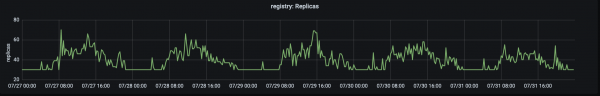
Replikāciju skaits, kas apstrādā ražotnes datu plūsmu uz registry.gitlab.com. Datu plūsma sasniedz maksimumu ~15:00 UTC.
Mūsu migrācijas stāsts sākās 2019. gada augustā, kad mēs pirmo reizi pārvietojām pakalpojumu — GitLab konteineru reģistru (GitLab Container Registry) — uz Kubernetes. Šis kritiski svarīgais, augsta datu plūsmu pakalpojums labi derēja pirmajai migrācijai, jo tas ir stateless lietojumprogrammas ar nelielu ārējo atkarību skaitu. Pirmā problēma, ar kuru mēs saskaramies, bija liels izraidīto pod'ā skaits, kas radās sakarā ar atmiņas trūkumu mezglos. Tāpēc mums nācās mainīt pieprasījumus un limitus.
Tika atklāts, ka gadījumā, ja lietojumprogramma, kuras atmiņas patēriņš pieaug laika gaitā, zemās pieprasījumu vērtības (kas rezervē atmiņu katram pod'ā) kopā ar "dāsnu" stingro limitu lietošanai radīja piesātinājumu (saturation) mezglos un augstu izraidīšanas līmeni. Lai tiktu galā ar šo problēmu, tika . Tas samazināja spiedienu mezglos un nodrošināja podu dzīves ciklu, kas neizdarīja pārāk lielu spiedienu uz mezglu. Tagad mēs sākam migrācijas ar dāsniem (un gandrīz vienādiem) pieprasījumu un ierobežojumu vērtībām, koriģējot tās pēc nepieciešamības.
3. Metri un žurnāli
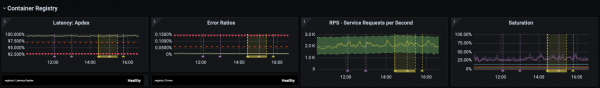
Infrastruktūras nodaļa koncentrējas uz kavējumiem, kļūmju procentiem un piesātinājumu ar noteiktajiem (SLO), saistītiem ar .
Pagājušajā gadā viens no galvenajiem notikumiem infrastruktūras nodaļā bija uzlabojumi monitorēšanā un darbā ar SLO. SLO ļāva mums izvirzīt mērķus atsevišķiem pakalpojumiem, ko mēs rūpīgi uzraudzījām migrācijas laikā. Bet pat ar šādu uzlabotu novērojamību ne vienmēr var nekavējoties saskatīt problēmas, izmantojot metrikas un brīdinājumus. Piemēram, koncentrējoties uz kavējumiem un kļūmju procentiem, mēs nepilnībā aptveram visus pakalpojuma izmantošanas scenārijus migrācijas laikā.
Šī problēma tika atklāta gandrīz nekavējoties pēc daļas darba slodžu pārvietošanas uz klasteri. Īpaši asi tā izpaudās, kad bija jā pārbauda funkcijas, kuru pieprasījumu skaits nav liels, bet kurām ir ļoti specifiskas konfigurācijas atkarības. Viens no galvenajiem mācību secinājumiem pēc migrācijas bija nepieciešamība monitorēšanā ņemt vērā ne tikai metriku, bet arī žurnālus un “garo asti” (runājot par uz grafika — tulk. piez.) kļūdām. Tagad katrai migrācijai mēs iekļaujam detalizētu pieprasījumu sarakstu žurnāliem (log queries) un plānojam skaidras atgriešanas procedūras, kuras, ja rodas problēmas, var nodot no vienas maiņas uz citu.
Vienlaicīga to pašu pieprasījumu apkalpošana vecajā VM infrastruktūrā un jaunajā, kas balstīta uz Kubernetes, bija unikāla uzdevums. Atšķirībā no lift-and-shift migrācijas (ātra lietotņu pārvietošanas “kā ir” jaunā infrastruktūrā; vairāk var izlasīt, piemēram, — piezīme tulkotājam), paralēlā darbība uz «vecajām» VM un Kubernetes prasa, lai uzraudzības rīki būtu saderīgi ar abām vidēm un spētu apvienot metrikas vienā skatā. Ir svarīgi, ka mēs izmantojam tos pašus dashboard’us un vaicājumus uz žurnāliem, lai nodrošinātu konsekventu novērojamību pārejas periodā.
4. Pāradresēt satiksmi uz jauno klasteri
GitLab.com daļa serveru tiek piešķirta . Kanāriju parks kalpo mūsu iekšējiem projektiem, kā arī var . Bet vispirms tas ir paredzēts izmaiņu, kas tiek veiktas infrastruktūrā un lietojumprogrammā, pārbaudei. Pirmais pārvietotais pakalpojums sāka ar ierobežota iekšējā satiksmes apjoma pieņemšanu, un mēs turpinām izmantot šo metodi, lai pārliecinātos par SLO ievērošanu, pirms nosūtīt visu satiksmi uz klasteri.
Migrācijas gadījumā tas nozīmē, ka vispirms Kubernetes tiek nosūtīti pieprasījumi uz iekšējiem projektiem, un pēc tam mēs pakāpeniski pāradresējam uz klasteri pārējo satiksmi, mainot svaru backend caur HAProxy. Pārejas procesā no VM uz Kubernetes kļuva skaidrs, ka ir ļoti izdevīgi, ja ir pieejams vienkāršs veids, kā novirzīt satiksmi starp veco un jauno infrastruktūru, un attiecīgi turēt veco infrastruktūru gatavībā atgaitai pirmās pārejas dienās.
5. Podu rezerves jauda un tās izmantošana
Tūlīt tika identificēta nākamā problēma: podi pakalpojumam Registry sākās ātri, taču podu palaišana Sidekiq aizņēma līdz . Garlaicīgs podu palaišana Sidekiq kļuva par problēmu, kad mēs sākām migrāciju uz Kubernetes darba slodzēm, kas nepieciešama ātri apstrādāt jobus un ātri mērogoties.
Šajā gadījumā mācība bija tāda, ka, lai arī Horizontal Pod Autoscaler (HPA) Kubernetes labi tiek galā ar satiksmes pieaugumu, ir svarīgi ņemt vērā darba slodžu raksturlielumus un piešķirt podu rezerves jaudu (īpaši nevienmērīgas pieprasījuma izplatības apstākļos). Mūsu gadījumā tika novērots pēkšņs jobu pieaugums, kas izraisīja strauju mērogošanu, kas noveda pie CPU resursu noslāņošanās pirms mēs paspējām mērīt mezglu baseinu.
Vienmēr ir kārdinājums izspiest maksimāli daudz no klastera, tomēr mēs, sākotnēji saskaroties ar veiktspējas problēmām, tagad uzsākam ar dāsnu pod budžetu un pēc tam to samazinām, uzmanīgi sekojot SLO. Podu palaišana Sidekiq pakalpojumam ievērojami paātrinājās un tagad vidēji aizņem apmēram 40 sekundes. ieguva gan GitLab.com, gan mūsu self-managed instalācijas, kas izmanto oficiālo GitLab Helm diagrammu.
Secinājums
Pēc katra pakalpojuma pārvietošanas mēs priecājāmies par Kubernetes izmantošanas priekšrocībām produkcijā: ātrāku un drošāku lietojumprogrammu izvietošanu, mērogojamību un efektīvāku resursu sadalījumu. Turklāt migrācijas ieguvumi sniedzas tālāk par GitLab.com. No katra uzlabojuma oficiālo Helm diagrammu iegūst arī tās lietotāji.
Ceru, ka jums patika stāsts par mūsu piedzīvojumiem migrācijā uz Kubernetes. Mēs turpinām pārvietot arvien jaunus pakalpojumus uz klasteri. Papildu informāciju var iegūt no šādām publikācijām:
- «»;
- «»;
- .
P.S. no tulka
Lasiet arī mūsu emuāra rakstos:
- «»;
- «»;
- «»;
- «».
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish