

LINQ ievadīts .NET kā jauns jaudīgs datu manipulācijas valodas instruments. LINQ to SQL kā daļa no tā ļauj diezgan ērti komunicēt ar DBMS, piemēram, izmantojot Entity Framework. Tomēr, bieži to pielietojot, izstrādātāji aizmirst paskatīties, kurš konkrēti SQL vaicājums tiks ģenerēts queryable provider, jūsu gadījumā — Entity Framework.
Apskatīsim divus galvenos aspektus piemērā.
Tādēļ SQL Server izveidosim datubāzi Test un tajā izveidosim divas tabulas, izmantojot sekojošo vaicājumu:
Tabulu izveide
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Tagad piepildīsim tabulu Ref, izpildot sekojošo skriptu:
Tabulas Ref piepildīšana
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Analogiski piepildīsim tabulu Customer, izmantojot sekojošo skriptu:
Tabulas Customer piepildīšana
USE [TEST]
GO

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

WHILE(@ind<=12000000)
BEGIN
	IF(@ind%3=0) SET @ind_ref=1;
	ELSE IF (@ind%5=0) SET @ind_ref=2;
	ELSE IF (@ind%7=0) SET @ind_ref=3;
	ELSE IF (@ind=0) SET @ind_ref=4;
	ELSE IF (@ind=0) SET @ind_ref=5;
	ELSE IF (@ind=0) SET @ind_ref=6;
	ELSE IF (@ind=0) SET @ind_ref=7;
	ELSE IF (@ind=0) SET @ind_ref=8;
	ELSE IF (@ind=0) SET @ind_ref=9;
	ELSE IF (@ind=0) SET @ind_ref=10;
	ELSE IF (@ind=0) SET @ind_ref=11;
	ELSE SET @ind_ref=@ind90000;

	INSERT INTO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 SELECT
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
END
GO
Tādējādi mēs ieguvām divas tabulas, no kurām vienā ir vairāk nekā 1 miljons rindu datu, bet otrā — vairāk nekā 10 miljoni rindu datu.
Tagad Visual Studio ir nepieciešams izveidot testēšanas projektu Visual C# Console App (.NET Framework):
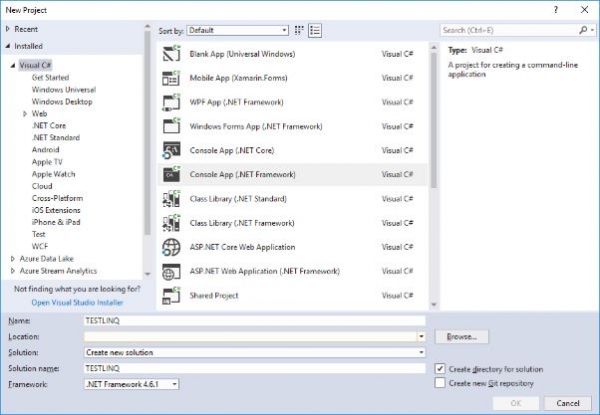
Tālāk ir nepieciešams pievienot bibliotēku Entity Framework, lai mijiedarbotos ar datu bāzi.
Lai to pievienotu, ar peles labo pogu noklikšķinām uz projekta un konteksta izvēlnē izvēlamies Manage NuGet Packages:
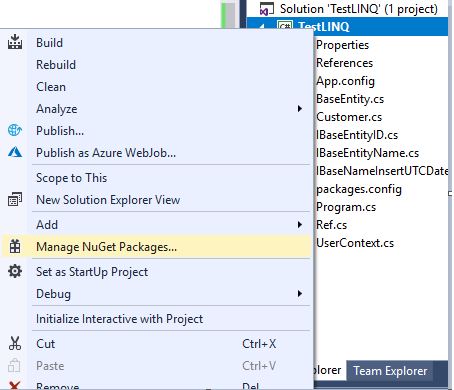
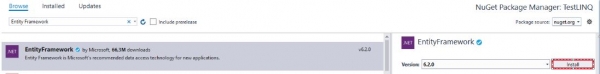
Pēc tam atvērtajā NuGet pakotņu pārvaldības logā meklēšanas lodziņā ievadām vārdu „Entity Framework”, izvēlamies pakotni Entity Framework un instalējam to:
Pēc tam failā App.config, pēc configSections elementa aizvēršanas, jāievieš šāds bloks:
connectionString jāievada pieslēguma virkne.
Tagad izveidosim trīs saskarnes atsevišķos failos:
- Iesniegums saskarnei IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Iesniegums saskarnei IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Iesniegums saskarnei IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
Un atsevišķā failā izveidosim bāzes klasi BaseEntity mūsu divām entītēm, kurā ietilps kopējie lauki:
Iesniegums bāzes klases BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Pēc tam atsevišķos failos izveidosim mūsu divas entītes:
- Iesniegums klases Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Iesniegums klases Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Tagad izveidosim atsevišķā failā kontekstu UserContext:
Iesniegums klases UserContex
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
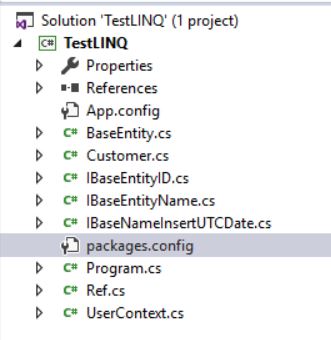
Esam saņēmuši gatavu risinājumu testiem par optimizāciju ar LINQ to SQL, izmantojot EF, MS SQL Server:
Tagad failā Program.cs ievadīsim sekojošo kodu:
Fails Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Tālāk izpildīsim mūsu projektu.
Darba beigās konsolei tiks izvadīts:
Ģenerētais SQL vaicājums
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
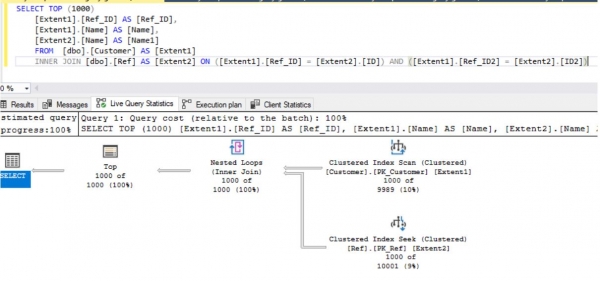
T.i., kopumā LINQ vaicājums ir ģenerējis diezgan labu SQL vaicājumu MS SQL Server datu bāzei.
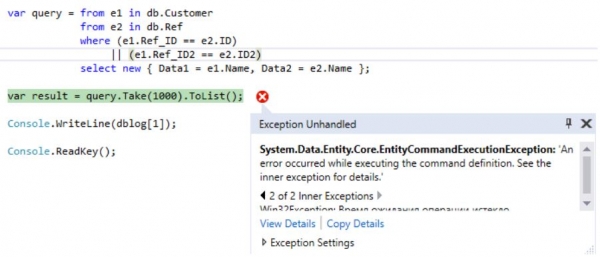
Tagad mainīsim nosacījumu no UN uz VAI LINQ vaicājumā:
LINQ vaicājums
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
Un atkal palaidīsim mūsu lietotni.
Izpilde beigsies ar kļūdu, kas saistīta ar izpildes laika pārsniegšanu 30 sekunžu laikā:
Ja paskatāmies, kāds vaicājums šajā gadījumā tika ģenerēts ar LINQ:
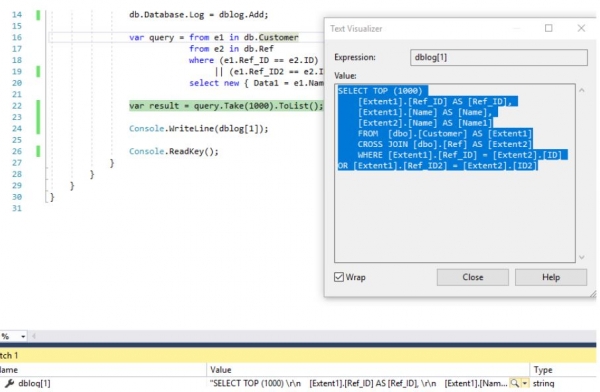
, tad varam pārliecināties, ka atlasīšana notiek, izmantojot kartējošo reizinājumu starp divām kopām (tabulām):
Ģenerētais SQL vaicājums
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Ierakstīsim LINQ vaicājumu šādi:
Optimizētais LINQ vaicājums
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Tad iegūsim sekojošo SQL vaicājumu:
SQL vaicājums
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Diemžēl LINQ pieprasījumos savienojuma nosacījums var būt tikai viens, tāpēc šeit ir iespējams veikt ekvivalentu pieprasījumu caur diviem pieprasījumiem, izmantojot Union, lai noņemtu dublikātus starp rindām.
Jā, pieprasījumi vispārējā gadījumā būs neekvivalenti, jo var tikt atgriezti pilnīgi dublēti rindu. Tomēr, reālajā dzīvē pilnīgi dublējošas rindas nav nepieciešamas un no tām cenšas atbrīvoties.
Tagad salīdzināsim šo divu pieprasījumu izpildes plānus:
- CROSS JOIN vidēji izpildes laiks ir 195 sek:

- INNER JOIN-UNION vidēji izpildes laiks ir mazāk nekā 24 sek:

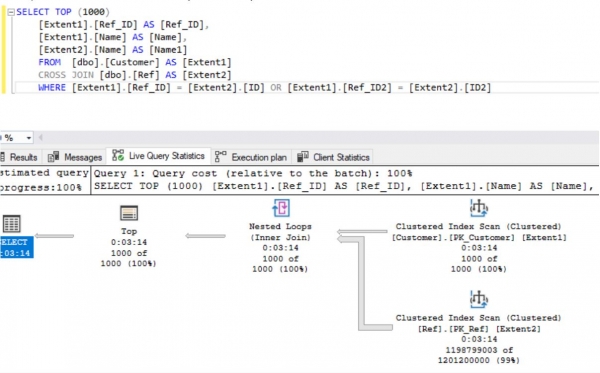
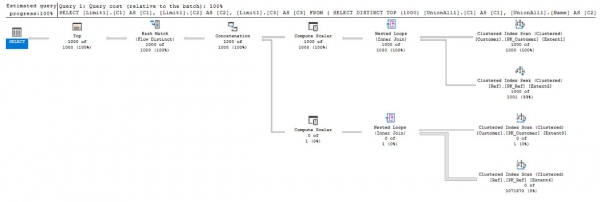
Kā redzams no rezultātiem, optimizēts LINQ pieprasījums divām tabulām ar miljoniem ierakstu darbojas vairākkārt ātrāk nekā neoptimizēts.
LINQ pieprasījuma veida variants ar un:
LINQ vaicājums
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
gandrīz vienmēr tiks ģenerēts pareizs SQL pieprasījums, kas vidēji tiks izpildīts apmēram 1 sek:
Tāpat LINQ to Objects manipulācijas vietā, izmantojot tādu pieprasījumu veidu:
LINQ pieprasījums (1. variants)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
var izmantot pieprasījuma veidu:
LINQ pieprasījums (2. variants)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
kur:
Divu masīvu definīcija
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, bet tips Para tiek definēts šādi:
tips Para definīcija
class Para
{
        public int Key1, Key2;
        public string Data;
}
Līdz ar to esam aplūkojuši dažus aspektus LINQ vaicājumu optimizācijā MS SQL Server.
Diemžēl pat pieredzējuši un vadošie .NET izstrādātāji aizmirst, ka ir nepieciešams saprast, ko īsti dara tās instrukcijas, kuras viņi izmanto. Pretējā gadījumā viņi kļūst par konfigurētājiem un var ielaist laika spridzekli nākotnē, gan mēroga palielināšanas procesā, gan veicot nelielas izmaiņas apkārtējās vides nosacījumos.
Tika veikta arī neliela pārskata analīze, .
Avota faili testam — paša projekts, datu bāzes TEST tabulu izveide, kā arī šo tabulu datu aizpildīšana ir pieejama .
Tāpat šajā repozitorijā mapē Plans atrodas plāni vaicājumu izpildei ar nosacījumiem OR.
Avots: habr.com
