

Uzreiz izskaidrošu raksta nosaukumu. Sākotnēji bija plānots sniegt labu, uzticamu padomu par refleksijas izmantošanas paātrināšanu vienkārša, bet reālista piemēra formā, tomēr benchmarkingā atklājās, ka refleksija strādā ne tik lēni, kā es domāju, savukārt LINQ darbojas lēnāk, nekā man bija murgos. Beigu beigās izrādījās, ka esmu pieļāvis kļūdu mērījumos... Šīs dzīves stāsta detaļas ir zem katra punkta un komentāros. Tā kā piemērs ir pietiekami ikdienišķs un īstenots principā tā, kā parasti tiek darīts uzņēmumā, izrādījās pietiekami interesanta, kā man šķiet, dzīves demonstrācija: ietekmi uz raksta galvenā objekta darba ātrumu nebija iespējams pamanīt ārējās loģikas dēļ: Moq, Autofac, EF Core un citas „apvākšanās”.
Es sāku darbu, iedvesmojoties no šī raksta:
Kā redzams, autors piedāvā izmantot kompilētas delegācijas, nevis tieši piekļūt refleksijas tipu metodēm, kā lielisku veidu, kā būtiski paātrināt lietojumprogrammas darbu. Tur vēl ir, protams, IL emisija, bet to vēlētos izvairīties, jo tas ir visdarbdarbīgākais uzdevuma izpildes veids, kas ir saistīts ar kļūdām.
Ņemot vērā, ka es vienmēr esmu uzskatījis par līdzīgu viedokli par refleksijas ātrumu, es neko īpaši neapšaubu autora secinājumus.
Es bieži sastopos ar naivu refleksijas izmantošanu uzņēmumos. Tiek ņemts tips. Tiek ņemta informācija par īpašību. Tiek izsaukts metode SetValue, un visi ir priecīgi. Vērtība nonāca mērķa laukā, visi ir apmierināti. Cilvēki ir diezgan gudri — seniori un komandu vadītāji — raksta savus paplašinājumus uz object, pamatojoties uz šādu naivu realizāciju „universālos” mapperu no viena veida uz otru. Parasti būtība ir šāda: ņemam visus laukus, ņemam visas īpašības, iterējam pa tām: pie nosaukumu saskaņas izpildām SetValue. Periodiski sastopam izņēmumus neveiksmēs tur, kur neatradām kādu īpašību vienā no tipiem, taču arī šeit ir izeja, kas uzlabo veiktspēju. Try/catch.
Es esmu redzējis, kā cilvēki pārraksta parserus un mapperus, neesot pilnībā apbruņotiem ar informāciju par to, kā strādā pirms viņiem izgudrotie velosipēdi. Es esmu redzējis, kā cilvēki slēpj savas naivās realizācijas aiz stratēģijām, interfeisiem, injekcijām, it kā tas attaisnotu turpmāko haosu. No šādām realizācijām es esmu atteicies. Patiesībā es neesmu mērījis reālu veiktspējas noplūdi, un, ja bija iespēja, es vienkārši mainīju realizāciju uz 'optimālāku', ja bija laiks. Tāpēc pirmie mērījumi, par kuriem runāšu tālāk, mani patiešām samulsināja.
Es domāju, ka daudzi no jums, lasot Rihtera vai citus ideologus, ir sastapušies ar pilnīgi pamatotu apgalvojumu, ka refleksija kodā ir parādība, kas ļoti negatīvi ietekmē aplikācijas veiktspēju.
Refleksijas izsaukums liek CLR pārmeklēt assemblemus meklējumos pēc vajadzīgā, pievilkt to metadatus, parsēt tos utt. Turklāt refleksija secību pārmeklēšanas laikā rada lielu atmiņas patēriņu. Patērētā atmiņa liek CLR aktivizēt GC un sākās lēnām rīcībām. Tas noteikti ir pamanāmi lēni, ticiet man. Milzīgas mūsdienu ražošanas serveru vai mākoņu mašīnu atmiņas apjoma iemantošana neglābj no augstām aizkavēm apstrādē. Faktiski, jo vairāk atmiņas, jo lielāka iespējamība, ka jūs PAMANĪSIT, kā darbojas GC. Refleksija – tas ir, idejiski, nevajadzīga sarkana drēbe priekš viņa.
Tomēr mēs visi izmantojam gan IoC konteinerus, gan datu mapperus, kuru darbības princips ir balstīts arī uz refleksiju, tomēr jautājumu par to veiktspēju parasti nerodas. Nē, ne tāpēc, ka atkarību injekcija un abstrahēšanās no modeļiem ārējā ierobežota konteksta ir tik nepieciešamas lietas, ka mums ir jāupurē veiktspēja jebkurā gadījumā. Viss ir vienkāršāk – tas patiesībā nav būtiski ietekmējis veiktspēju.
Fakts ir tāds, ka visslavenākie ietvari, kas balstīti uz refleksijas tehnoloģiju, izmanto visdažādākos paņēmienus, lai optimizētu savu darbu ar to. Parasti tas ir kešatmiņa. Parasti – tas ir Expressions un no izteikumu koka kompilēti delegāti. Tas pats automapperī tur konkurētspējīgu Vārdu krājumu, kas saskaņo tipus ar funkcijām, kas var viens otru konvertēt jau bez refleksijas izsaukuma.
Kā tas tiek sasniegts? Patiesībā tas nemaz neatšķiras no loģikas, ko pati platforma izmanto JIT koda ģenerēšanai. Pirmajā metode izsaukumā tā tiek kompilēta (un jā, šis process nav ātrs), bet pēc tam kontrole tiek nodota jau kompilētajai metodei, un te lielu veiktspējas kritumu nebūs.
Mūsu gadījumā mēs varam izmantot arī JIT kompilāciju un pēc tam izmantot kompilēto uzvedību ar tādu pašu veiktspēju kā tās AOT analoģijas. Šajā gadījumā mums palīdzēs izteiksmes.
Principu, par kuru runājam, var īsi formulēt šādi:
Jākešē gala rezultāts, ko sasniedzam ar refleksiju, kā delegāts, kas satur kompilētu funkciju. Visi nepieciešamie objekti ar informāciju par tipiem arī ir jākēšē saglabātajos laukos jūsu tipa objektos – darba procesā.
Šajā ir loģika. Veselais saprāts mums saka, ka, ja kaut ko var kompilēt un kešot, tad to vajadzētu darīt.
Pavisam īsi sakot, jāatzīmē, ka kešēšana, strādājot ar refleksiju, ir ar savām priekšrocībām, pat ja netiek izmantota piedāvātā izteiksmes kompilācijas metode. Patiešām, šeit es atkārtošu autora raksta tēzes, uz kuru atsaucos iepriekš.
Tagad par kodu. Apskatīsim piemēru, kas balstīts uz manu nesen izjusto sāpju, ar ko nācās saskarties nopietnā ražošanā nopietnā kredītu organizācijā. Visas entītes ir izdomātas, lai neviens nedabūtu nekādas aizdomas.
Ir kāda entītāte. Lai būtu Contact. Ir vēstules ar standartizētu tekstu, no kurām parsers un hidratators rada šos kontaktus. Ieradās vēstule, mēs to izlasījām, izanalizējām uz atslēgu-vērtību pāriem, izveidojām kontaktu, saglabājām datu bāzē.
Tas ir elementāri. Pieņemsim, ka kontaktam ir īpašības Vārds, Vecums un kontakttelefonu. Šie dati tiek nodoti vēstulē. Tāpat bizness grib, lai atbalsta darbinieki varētu operatīvi pievienot jaunus atslēgas mappēšanas īpašības uz pāriem vēstules tekstā. Gadījumā, ja kāds ir kļūdījies veidnē vai ja pirms izlaišanas vajadzēs ātri palaist jaunu mappēšanu no jauna partnera, pieskaņojoties jaunajam formātam. Tādā gadījumā jauno mappēšanas atbilstību mēs varam pievienot kā lētu datu labojumu. Tātad tas ir praktisks piemērs.
Realizējam, izstrādājam testus. Strādā.
Kodu es nenorādīšu: avota failu ir daudz, un tie ir pieejami GitHub saistībā raksta beigās. Jūs varat tos lejupielādēt, pārbaudīt līdz neatpazīšanai un izmērīt, kā tas ietekmētu jūsu gadījumu. Norādīšu tikai divus šablona metožu koda fragmentus, kuriem atšķiras ātrā hidratētāja un lēnā hidratētāja darbība.
Loģika ir šāda: šablona metode saņem pārus, kas veidoti pamata parsera loģikā. LINQ līmenis ir parsers un pamata hidratētāja loģika, kas veic pieprasījumu uz datu bāzes kontekstu un saskaņo atslēgas ar pāriem no parsera (šīm funkcijām ir kods без LINQ salīdzinājumam). Pāri tiek nodoti galvenajai hidratācijas metodei un vērtības tiek iestatītas atbilstošajās matērijas īpašībās.
„Ātrais“ (Fast prefikss benchmarkos):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Kā mēs redzam, tiek izmantota statiska kolekcija ar īpašību setteriem – kompilētām lambda funkcijām, kas sauc matērijas setteru. Tās tiek izveidotas ar sekojošo kodu:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
Kopumā tas ir skaidrs. Apskatām īpašības, izveidojam pa tām deleģātus, kas sauc setterus, saglabājam. Pēc tam izsaucam, kad nepieciešams.
„Lēnais“ (Slow prefikss benchmarkos):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Šeit mēs uzreiz apskatām īpašības un tieši izsaucam SetValue.
Lai ilustrētu un kalpotu par etalonu, es īstenoju elementāro metodi, kas tieši ieraksta to korrelācijas pāru vērtības entītijās. Prefikss – Manual.
Tagad ņemam BenchmarkDotNet un izpētām veiktspēju. Un pēkšņi… (spoilers — tas nav pareizais rezultāts, sīkāk — zemāk)
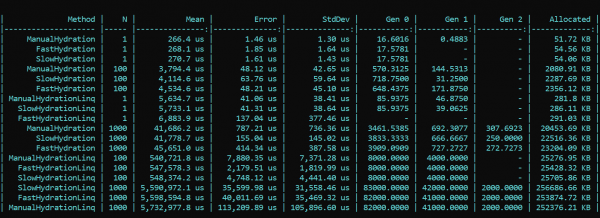
Ko mēs šeit redzam? Metodes, kas uzvarošā veidā valkā prefiksu Fast, gandrīz visos gājienos izrādās lēnākas nekā metodes ar prefiksu Slow. Tas attiecas gan uz alokāciju, gan uz darba ātrumu. Savukārt skaista un eleganta mapējošā realizācija, izmantojot visur, kur iespējams, paredzētas LINQ metodes, tieši otrādi, ļoti patērē veiktspēju. Atšķirība ir milzīga. Tendence nemainās ar dažādu gājienu skaitu. Atšķirība tikai mērogos. Ar LINQ 4 — 200 reizes lēnāka, atkritumu ir aptuveni tādā pašā mērogā.
ATJAUNOTS
Es neticēju savām acīm, bet kas ir vēl svarīgāk, ne manām acīm, ne manam kodam neticēja mūsu kolēģis — . Pārbaudot manu risinājumu, viņš spoži atklāja un norādīja uz kļūdu, ko es, sakarā ar vairākiem realizācijas izmaiņām, no sākotnējā uz galīgo, biju palaidis garām. Pēc atrastās kļūdas labojuma Moq iestatījumos visi rezultāti nostājās sava vietā. Pēc atkārtotā testēšanas galvenā tendence nemainās — LINQ tomēr ietekmē veiktspēju spēcīgāk nekā refleksija. Tomēr ir patīkami, ka darbs ar Expression kompilāciju tiek veikts nevelti, un rezultāts ir redzams gan alokācijā, gan izpildes laikā. Pirmajā uzsākšanā, kad tiek inicializēti statiskie lauki, likumsakarīgi ir lēnāks „ātrajam” metodam, bet pēc tam situācija mainās.
Šeit ir atkārtotā testēšanas rezultāts:
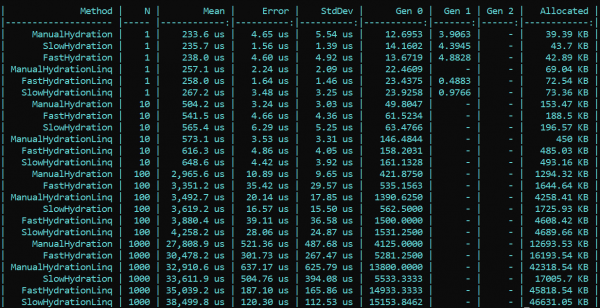
Secinājums: izmantojot refleksiju, nav nepieciešams pievērsties trikiem — LINQ patērē veiktspēju daudz spēcīgāk. Tomēr, intensīvi izmantotos métodos, kur nepieciešama optimizācija, var saglabāt refleksiju kā inicializatorus un deleģātu kompilatorus, kas pēc tam nodrošinās „ātru” loģiku. Tā jūs varat saglabāt gan refleksijas elastību, gan lietojumprogrammas ātrdarbību.
Kodam ar benchmarku var piekļūt šeit. Visi, kas vēlas, var pārbaudīt manus vārdus:
PS: kods testos izmanto IoC, bet benchmarkos – skaidru konstrukciju. Problēma ir tā, ka galīgajā realizācijā es izslēdzu visus faktorus, kas var ietekmēt veiktspēju un traucēt rezultātus.
PPS: Paldies lietotājam par to, ka pamanījāt manu kļūdu Moq iestatīšanā, kas ietekmēja pirmos mērījumus. Ja kādam no lasītājiem ir pietiekami daudz karmas, lūdzu, ielieciet like. Cilvēks apstājās, cilvēks iedziļinājās, cilvēks pārbaudīja un norādīja uz kļūdu. Es uzskatu, ka tas ir cienīgs un simpātisks darbs.
PPPS: paldies tam rūpīgajam lasītājam, kurš pievērsās stilistikai un noformējumam. Es esmu par konsekvenci un ērtību. Diplomātiskā pasniegšana atstāj ko vēlams, bet es pieņēmu kritiku. Lūdzu pievērst uzmanību.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish