

Ienākot produktā, kas attīstās vairāk nekā desmit gadus, nav pārsteidzoši sastapt novecojušas tehnoloģijas. Bet, ja pēc sešiem mēnešiem jums būs jāiztur slodze, kas ir desmit reizes lielāka, un kļūdu cena pieaugs simtiem reižu? Šajā gadījumā jums ir nepieciešams gudrs Highload inženieris. Bet, tā kā nebija neviena, kurš varētu palīdzēt, šī problēma bija uzticēta man. Pirmajā raksta daļā es pastāstīšu, kā mēs pārgājām no Redis uz Redis-cluster, bet otrajā daļā sniegšu padomus, kā sākt izmantot klasteri un uz ko pievērst uzmanību tā ekspluatācijā.
Tehnoloģijas izvēle
Cik slikts atskirtais Redis (standalone redis) konfigurācijā 1 meistars un N vergi? Kāpēc es to uzskatu par novecojušu tehnoloģiju?
Nē, Redis nav tik slikts… Tomēr ir daži trūkumi, kurus nevar ignorēt.
Pirmkārt, Redis neatbalsta katastrofu atjaunošanas mehānismus pēc meista kritiena. Lai atrisinātu šo problēmu, mēs izmantojām konfigurāciju ar automātisku VIP pārvietošanu uz jauno meistaru, mainot viena no vergiem lomu un pārslēdzot pārējos. Šis mehānisms darbojās, taču to nevarēja nosaukt par uzticamu risinājumu. Pirmkārt, notika viltus trauksmes, un, otrkārt, tas bija vienreizējs, un pēc aktivizēšanas bija nepieciešamas roku darbības, lai visu atkal savestu kārtībā.
Otrkārt, tikai viena meistara klātbūtne radīja šardēšanas problēmu. Bija nepieciešams izveidot vairākus neatkarīgus klasterus "1 meistars un N vergi", pēc tam manuāli izdalīt datus pa šīm mašīnām un cerēt, ka rīt kāds no datu bāzēm nepiedzimst tik liels, ka to nāksies novietot uz atsevišķa instancē.
Kādi ir varianti?
- Visdārgākais un bagātākais risinājums ir Redis-Enterprise. Šis ir kompleksais risinājums ar pilnu tehnisko atbalstu. Neskatoties uz to, ka tas tehniski izskatās ideāli, ideoloģisku iemeslu dēļ mums tas nebija piemērots.
- Redis-cluster. Izsistē ir atbalsts katastrofu pārslēgšanai uz meistaru un šardēšanai. Saskarne gandrīz neatšķiras no parastās versijas. Izskatās daudzsološs, par zemūdens akmeņiem runāsim tālāk.
- Tarantool, Memcache, Aerospike un citi. Visi šie rīki veic aptuveni to pašu. Bet katram ir savi trūkumi. Mēs nolēmām nesalikt visus olas vienā grozā. Memcache un Tarantool mēs izmantojam citām vajadzībām, un, iepriekš nosakot, varu teikt, ka mūsu praksē ar tiem bija vairāk problēmu.
Izmantošanas specifika
Paskatīsimies, kādas uzdevumus mēs vēsturiskā gaismā esam risinājuši ar Redis un kādu funkcionalitāti izmantojuši:
- Kešatmiņa pirms pieprasījumiem uz attālinātiem pakalpojumiem, piemēram, 2GIS | Golang
GET SET MGET MSET "IZVĒLĒT DB"
- Kešatmiņa pirms MYSQL | PHP
GET SET MGET MSET SCAN "ATSLĒGA PA MODELI" "IZVĒLĒT DB"
- Galvenais krātuve sesiju un šoferu koordinātu apstrādei | Golang
GET SET MGET MSET "IZVĒLĒT DB" "PIEBILT GEO ATSLĒGU" "IUST GEO ATSLĒGU" SCAN
Kā redzat, nav nekādas augstākās matemātikas. Kāpēc tad ir sarežģījumi? Apskatīsim katru metodi atsevišķi.
Metode
Apraksts
Redis-klastera īpatnības
Risinājums
GET SET
Ierakstīt/izlasīt atslēgu
MGET MSET
Ierakstīt/izlasīt vairākas atslēgas
Atslēgas būs dažādās mezglos. Gatavas bibliotēkas spēj veikt Multi-darbības tikai viena mezgla ietvaros
Aizvietot MGET ar pipeline no N GET operācijām
IZVĒLĒT DB
Izvēlēties datubāzi, ar kuru strādāsim
Nepodut vairāku datubāzu atbalstu
Visu likt vienā datubāzē. Pievienot prefiksus atslēgām
SCAN
Iziet cauri visām atslēgām datubāzē
Tā kā mums ir viena datubāze, iziet cauri visām atslēgām klasterī ir pārāk dārgi
Uzturēt invariantu vienas atslēgas ietvaros un veikt HSCAN šai atslēgai. Vai nu atteikties pavisam
GEO
Darbības ar geoatslēgu
Geoatslēga nav shardota
ATSLEGA PA MODELI
Meklēt atslēgu pēc modeļa
Tā kā mums ir viena datubāze, meklēsim visās atslēgās klasterī. Pārāk dārgi
Ateikties vai uzturēt invariantu, kā tas ir gadījumā ar SCAN
Redis pret Redis-klasteri
Ko mēs zaudējam un ko iegūstam, pārejot uz klasteri?
- Trūkumi: zaudējam funkcionalitāti daudzu datubāzu gadījumā.
- Ja vēlamies saglabāt vienā klasterī loģiski nesaistītus datus, būs jādara pielāgojumi, pievienojot prefiksus.
- Zaudējam visas darbības "pa datubāzi", piemēram, SCAN, DBSIZE, CLEAR DB u.c.
- Multi-darbības ir kļuvušas ievērojami sarežģītākas, jo var būt nepieciešams vērsties pie vairāk nekā viena mezgla.
- Priekšrocības:
- Turbūtība katastrofās gadījumā ar avārijas pārslēgšanu uz galveno mezglu.
- Shardēšana Redis pusē.
- Datu pārvietošana starp mezgliem atomāri un bez dīkstāves.
- Jaudu un slodžu pievienošana un pārdale bez dīkstāves.
Es varētu secināt, ka, ja jums nav nepieciešama augsta pieejamība, tad pārcelšanās uz klasteri nav tā vērta, jo tas var būt sarežģīts uzdevums. Taču, ja sākotnēji ir jāizvēlas starp atsevišķu versiju un klasteri, tad jādod priekšroka klasterim, jo tas nav sliktāks un papildus noņems daļu no jums pārējo galvassāpju.
Sagatavošanās pārcelšanās procesam
Sāksim ar prasībām pārcelšanās procesam:
- Tam jābūt bezšuvju. Pilnīga servisa pārtraukšana uz 5 minūtēm mums nav pieņemama.
- Tam jābūt pēc iespējas drošākam un pakāpeniskam. Mēs vēlamies saglabāt kontroli pār situāciju. Mēs nevēlamies visu izlaist uzreiz un lūgt, lai nodzēšam pogu.
- Minimālie datu zudumi pārcelšanās laikā. Mēs saprotam, ka pārcelt atomāri būs ļoti sarežģīti, tāpēc pieņemam zināmu datu nesakritību starp parasto un klastera Redis.
Klastera apkope
Pirms pārcelšanās ir jādomā par to, vai mēs spējām atbalstīt klasteri:
- Grafiki. Mēs izmantojam Prometheus un Grafana, lai sekotu CPU slodzes, aizņemtās atmiņas, klientu skaita, GET, SET, AUTH operāciju skaita utt. grafikiem.
- Ekspertīze. Iedomājieties, ka rīt jūsu atbildībā būs liels klasteris. Ja tas sabojāsies, neviens, izņemot jūs, to nevarēs salabot. Ja tas sāk palēnināties, visi skries pie jums. Ja būs nepieciešams pievienot resursus vai pārkārtot slodzi, atkal pie jums. Lai nebūtu balti mati 25 gadu vecumā, vēlams iepriekš apsvērt šos gadījumus un pārbaudīt, kā tehnoloģija uzvedīsies dažādu darbību laikā. Par to runāsim sīkāk sadaļā “Ekspertīze”.
- Uzraudzības un brīdinājumi. Kad klasteris sabojājas, par to gribas uzzināt pirmajam. Mēs esam ierobežojušies ar brīdinājumu par to, ka visas mezgla atgriež vienādu informāciju par klastera stāvokli (jā, tas notiek arī citādāk). Pārējās problēmas ātrāk pamanīt, pēc Redis klientu pakalpojumu brīdinājumiem.
Pārcelšanās
Kā mēs plānosim pārcelties:
- Pirmkārt, ir jāpreparē bibliotēka, lai strādātu ar klasteri. Par pamatu Gо versijai mēs izmantojām go-redis un nedaudz pielāgojām to savām vajadzībām. Realizējām Multi-metodes caur pipeline un nedaudz uzlabojām pieprasījumu atkārtošanas noteikumus. Ar PHP versiju radās vairāk problēmu, bet galu galā mēs apstopējāmies pie php-redis. Nesen viņi ieviesa klastera atbalstu, un mūsuprāt, tas izskatās labi.
- Tālāk ir jāuzstāda pats klasteris. To izdarīt var burtiski divās komandās, pamatojoties uz konfigurācijas failu. Detalizētāk par iestatījumiem runāsim turpmāk.
- Pakāpeniskai pārejai mēs izmantojam dry-mode. Tā kā mums ir divas bibliotēku versijas ar identisku saskarni (viena parastajai versijai, otra klasterim), nav grūti izveidot apvalku, kas darbosies ar atsevišķu versiju un paralēli dublēs visus pieprasījumus klasterī, salīdzinās atbildes un rakstīs atšķirības žurnālos (mūsu gadījumā NewRelic). Tādējādi, pat ja klastera versija pārtrauktu darboties dispečera laikā, mūsu ražošanas vide netiks ietekmēta.
- Izveidojot klasteri dry-modē, mēs varam mierīgi sekot līdzi atbilžu atšķirību grafikam. Ja kļūdu daļa lēnām, bet noteikti tuvojas kādai mazai konstantai, tas nozīmē, ka viss ir labi. Kāpēc tomēr ir atšķirības? Jo ieraksts atsevišķā versijā notiek nedaudz agrāk nekā klasterī, un mikrolaika dēļ dati var atšķirties. Atliek tikai apskatīt atšķirību žurnālus, un, ja visas tās ir izskaidrojamas ar neatomaritāti ierakstā, tad var doties tālāk.
- Tagad var pārvērst dry-mode pretējā virzienā. Rakstīsim un lasīsim no klastera, bet dublēsim atsevišķā versijā. Kāpēc? Nākamo nedēļu vēlos novērot klastera darbību. Ja pēkšņi izrādīsies, ka slodzes maksimumā ir problēmas vai mēs kaut ko neesam iekļāvuši, mums vienmēr būs iespēja veikt ārkārtas atgriešanos pie vecā koda un aktuālajiem datiem, pateicoties dry-mode.
- Atliek atslēgt dry-mode un demontēt atsevišķo versiju.
Ekspertīze
Vispirms īsi par klastera uzbūvi.
Pirmkārt, Redis ir key-value krātuve. Kā atslēga tiek izmantotas patvaļīgas virknes. Kā vērtības var tikt izmantoti skaitļi, virknes un veselas struktūras. To ir ļoti daudz, bet mūsu kopīgās uzbūves izpratnei tas nav svarīgi.
Nākamais abstrakcijas līmenis pēc atslēgām ir sloti (SLOTS). Katram atslēgam pieder viens no 16 383 slotiem. Katrā slotā var būt neierobežots atslēgu skaits. Tādējādi visas atslēgas tiek sadalītas 16 383 nepārklājošos kopumos.
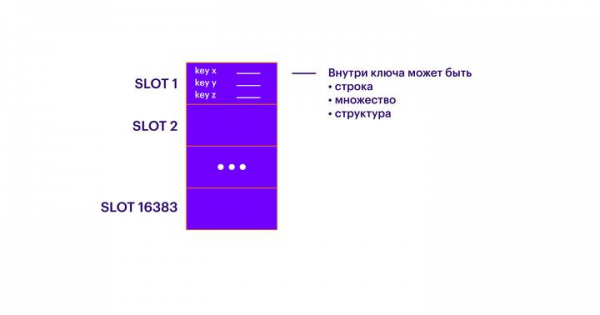
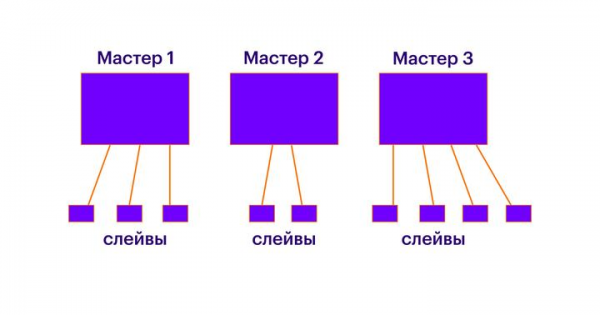
Tālāk, klasterī jābūt N meistarnodēm. Katru nodu var uzskatīt par atsevišķu Redis instanci, kas zina visu par citām nodēm iekš klastera. Katra meistarnode satur noteiktu skaitu slotu. Katrs slots pieder tikai vienai meistarnodei. Visus slotus jādistribūē starp nodēm. Ja daži sloti nav sadalīti, tad tajos esošās atslēgas būs nepieejamas. Katru meistarnodi ir jēga palaist uz atsevišķas loģiskas vai fiziskas mašīnas. Tāpat vērts atcerēties, ka katra node darbojas tikai uz viena kodola, un, ja vēlaties uz vienas loģiskās mašīnas palaist vairākus Redis instancus, pārliecinieties, ka tie darbojas uz atšķirīgiem kodoliem (mēs to neesam mēģinājuši, bet teorētiski viss būtu jādarbojas). Pamatā meistarnodes nodrošina parasto šardēšanu, un lielāks meistarnodu skaits ļauj skalot rakstīšanas un lasīšanas pieprasījumus.
Pēc tam, kad visas atslēgas ir sadalītas pa slotiem, un sloti ir izkaisīti pa meistarnodēm, katrai meistarnodei var pievienot neierobežotu skaitu sliežu nodēm. Katrā šādā "meistara-slieža" saistē darbosies parasta replikācija. Sliegi ir nepieciešami, lai skalotu lasīšanas pieprasījumus un avārijas pārslēgšanai gadījumā, ja meistars iziet no ierindas.
Tagad runāsim par operācijām, kuras būtu labi pratīt izpildīt.
Pieeju sistēmai mēs veiksim caur Redis-CLI. Tā kā Redis nav vienota ieejas punkta, sekojošās operācijas var veikt uz jebkuras no nodēm. Katrs punkts īpaši uzsver iespēju veikt operāciju slodzes apstākļos.
- Pirmais un pats svarīgākais, kas mums nepieciešams: operācija cluster nodes. Tā atgriež klastera stāvokli, parāda nodu sarakstu, to lomas, slotu sadalījumu utt. Papildu informāciju var iegūt, izmantojot cluster info un cluster slots.
- Būtu labi spēt pievienot un dzēst mezglus. Tam ir operācijas cluster meet un cluster forget. Ņemiet vērā, ka cluster forget ir jāpiemēro KATRAM mezglam, gan meistariem, gan replikām. Bet cluster meet ir pietiekami izsaukt tikai vienā mezglā. Šāda atšķirība var būt mulsinoša, tādēļ labāk par to uzzināt pirms klastera palaišanas ekspluatācijā. Jauna mezgla pievienošana droši veicama reālajā vidē un nekādā veidā neietekmē klastera darbību (kas ir loģiski). Ja plānojat dzēst mezglu no klastera, tad jāpārliecinās, ka tajā nav palikuši sloti (pretējā gadījumā riskējat zaudēt piekļuvi visiem atslēgām šajā mezglā). Arī nedzēsiet meistaru, kam ir vergi, citādi notiks nevajadzīga balsošana par jauno meistaru. Ja mezglos vairs nav slotu, tas ir neliels problēmu, bet kāpēc mums lieki izvēles, ja vispirms var dzēst vergiem.
- Ja nepieciešams piespiedu kārtā nomainīt meistaru un vergu, tad derēs komanda cluster failover. Izsaucot to reālajā vidē, jāapzinās, ka operācijas izpildes laikā meistars būs nepieejams. Parasti pārslēgšana notiek mazāk nekā sekundes laikā, taču tas nav atomārs. Varat rēķināties, ka daļa pieprasījumu meistaram šajā laikā beigsies ar kļūdu.
- Pirms mezgla noņemšanas no kopas, tam nedrīkst būt nekādu slotu. Tos vislabāk pārdalīt, izmantojot komandu cluster reshard. Slotus pārsūtīs no viena meistara uz citu. Visa operācija var aizņemt dažas minūtes, atkarībā no pārsūtāmo datu apjoma, tomēr pārsūtīšanas process ir drošs un nekādā veidā neietekmē kopas darbu. Tādējādi visus datus var pārsūtīt no viena mezgla uz citu tieši slodzes laikā, nerūpējoties par to pieejamību. Tomēr ir arī nianses. Pirmkārt, datu pārsūtīšana ir saistīta ar noteiktu slodzi gan pieņēmēja, gan sūtītāja mezglam. Ja pieņēmējas mezgls jau ir ļoti noslogots ar procesoru, tad nevajadzētu to vēl vairāk noslogot ar jaunu datu pieņemšanu. Otrkārt, tiklīdz sūtītāja meistaram vairs nebūs neviena slota, visi viņa vergi nekavējoties pāriet pie meistara, uz kuru šie sloti tika pārcelti. Un problēma ir tā, ka visi šie vergi tajā pašā laikā vēlēsies sinhronizēt datus. Un jums vēl paveiksies, ja tā būs daļēja, nevis pilnīga sinhronizācija. Ņemiet to vērā un kombinējiet slotu pārvietošanas un vergu atslēgšanas/pārvietošanas operācijas. Vai arī ceriet, ka jums ir pietiekama izturība.
- Ko darīt, ja pārsūtīšanas laikā jūs atklājat, ka kaut kur esat pazaudējuši slotus? Ceru, ka šī problēma jūs neskar, bet, ja kas, ir operācija cluster fix. Tā kaut kā izkaisīs slotus pa mezgliem gadījuma kārtībā. Ieteiktu pārbaudīt tās darbību, iepriekš izdzēšot no kopas mezglu ar sadalītiem slotiem. Tā kā dati neizsadalītajos slotos tāpat nav pieejami, par problēmām ar šo slotu pieejamību jau ir par vēlu uztraukties. Savukārt, sadalītiem slotiem operācija neietekmēs.
- Vēl viena noderīga operācija ir monitor. Tā ļauj reālā laikā redzēt visu pieprasījumu sarakstu, kas tiek sūtīti uz mezglu. Vēl vairāk, to var izmantot ar grep, lai noskaidrotu, vai ir nepieciešamais trafiks.
Ir vērts pieminēt arī avārijas pārslēgšanas procedūru. Ja īsi, tā ir un, manuprāt, darbojas lieliski. Tomēr nevajadzētu domāt, ka, izvilkot vadu no kontaktligzdas mašīnai ar galveno mezglu, Redis nekavējoties pārslēgsies un klienti nepamanīs zaudējumu. Manā pieredzē pārslēgšana notiek vairākas sekundes. Šajā laikā daļa datu būs nepieejama: tiek konstatēta galvenā mezgla nepieejamība, mezgli balsos par jauno, slaves pārslēdzās, dati sinhronizējas. Labākais veids, kā pārliecināties, ka shēma strādā, ir veikt lokālas mācības. Uzstādiet klasteri savā klēpjdatorā, nodrošiniet minimālu slodzi, simulējiet kritienu (piemēram, bloķējot portus), novērtējiet pārslēgšanas ātrumu. Manā skatījumā, tikai spēlējoties šādā veidā divas dienas, var būt droši par tehnoloģijas darbību. Vai nu cerēt, ka programmatūra, ko lieto puse interneta, noteikti darbojas.
Konfigurācija
Bieži vien konfigurācija ir pirmais, kas nepieciešams, lai uzsāktu darbu ar rīku. Un, kad viss ir sācis darboties, nevēlamies pieskarties konfigurācijai. Nepieciešams noteikts pūles, lai piespiestu sevi atgriezties pie iestatījumiem un rūpīgi tos pārskatīt. Manā atmiņā ir bijuši vismaz divi nopietni izgāšanās gadījumi, jo neesam pievērsuši uzmanību konfigurācijai. Lūdzu, pievērsiet īpašu uzmanību šādiem punktiem:
- timeout 0
Laiks, pēc kura tiek slēgti neaktīvie savienojumi (sekundēs). 0 — neslēdzas
Ne katra mūsu bibliotēka prata pareizi slēgt savienojumus. Atspējojot šo iestatījumu, mēs riskējam saskarties ar klientu skaita ierobežojumiem. No otras puses, ja tāda problēma pastāv, automātiskā zaudēto savienojumu pārtraukšana to maske, un mēs to varam nepamanīt. Turklāt šo iestatījumu nevajadzētu ieslēgt, izmantojot persist-savienojumus. - Save x y & appendonly yes
RDB momentuzņēmuma saglabāšana.
RDB/AOF problēmas mēs sīki apspriedīsim turpmāk. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Ja ir ieslēgts, tad RDB momentuzņēmuma sabojāšanās gadījumā galvenais mezgls pārtrauks pieņemt izmaiņu pieprasījumus. Ja savienojums ar galveno mezglu ir zudis, tad slaves var turpināt atbildēt uz pieprasījumiem (jā). Vai arī pārtrauks atbildēt (nē)
Mūs neapmierina situācija, kad Redis pārvēršas par ķirbi. - repl-ping-slave-period 5
Pēc šī laika intervāla mēs sāksim uztraukties, ka meistars ir nepareizi noregulēts un ir pienācis laiks veikt failover procedūru.
Būs jāmeklē līdzsvars starp viltus trauksmes un failover uzsākšanu manuāli. Mūsu praksē uz to parasti tiek tērētas 5 sekundes. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Tieši tik daudz datu mēs varam glabāt buferī neaktīvai replikai. Ja buferis izbeidzas, būs jāsaskaņo pilnīgi no jauna.
Prakse norāda, ka labāk uzstādīt lielāku vērtību. Iemeslu, kāpēc replika var sākt kavēties, nav maz. Ja tā sāk atpalikt, pastāv liela iespējamība, ka jūsu meistars jau grūti tiek galā, un pilna sinhronizācija būs pēdējais piliens. - maxclients 10000
Maksimālais vienlaicīgo klientu skaits.
No mūsu pieredzes labāk uzstādīt lielāku vērtību. Redis lieliski tiek galā ar 10 tūkstošiem savienojumu. Tikai pārliecinieties, ka sistēmā ir pietiekami daudz soketu. - maxmemory-policy volatile-ttl
Noteikums, saskaņā ar kuru tiek dzēsti atslēgas, sasniedzot pieejamās atmiņas limitu.
Šeit svarīgs ir nevis pats noteikums, bet gan izpratne par to, kā tas notiks. Redis var uzslavēt par spēju normāli darboties, sasniedzot atmiņas limitu.
RDB un AOF problēmas
Lai gan pats Redis glabā visus datus operatīvajā atmiņā, pastāv arī mehānisms datu saglabāšanai diskā. Faktiski ir trīs mehānismi:
- RDB-snapshot — pilnīgs visu datu attēls. To iestata, izmantojot konfigurāciju SAVE X Y, un tas tiek lasīts kā "Saglabāt pilnīgu visu datu attēlu katras X sekundes, ja vismaz Y atslēgas ir mainījušās."
- Append-only failā ir darbību saraksts to izpildes secībā. Tas pievieno jaunus ienākošos darbību datus failam katras X sekundes vai pēc Y darbībām.
- RDB un AOF — iepriekšējo divu kombinācija.
Visiem paņēmieniem ir savi plusi un mīnusi, es neminēšu tos visus, tikai pievērsīšu uzmanību manā skatījumā ne acīmredzamām lietām.
Vispirms RDB attēla saglabāšanai ir nepieciešams izsaukt FORK. Ja datu ir daudz, tas var pakārt visu Redis no dažām milisekundēm līdz sekundēm. Turklāt sistēmai ir nepieciešams piešķirt atmiņu šādam attēlam, kas nozīmē, ka ir jānodrošina dubultā operatīvās atmiņas rezerves: ja Redis ir piešķirti 8 GB, tad virtuālajai mašīnai ar to jābūt pieejamiem 16.
Otrkārt, pastāv problēmas ar daļēju sinhronizāciju. AOF režīmā, atkārtoti pieslēdzoties slavei, var izpildīties pilnīga sinhronizācija. Neizdevās saprast, kāpēc tā notiek. Bet par to ir jāatceras.
Šie divi punkti jau liek domāt, cik ļoti mums nepieciešami šie dati diskā, ja tie tāpat jau tiek dublēti slavos. Datus var pazaudēt tikai tad, ja visi slavi izgāžas, un tas ir problēmas līmenī 'ugunsgrēks datu centrā'. Kompromisa risinājumā varētu piedāvāt saglabāt datus tikai slavās, bet šajā gadījumā ir jāpārliecinās, ka šie slavi nekad nekļūst par meistaru avārijas atjaunošanai (tam ir iestatījums slavu prioritātei to konfigurācijā). Mēs katrā konkrētajā gadījumā domājam, vai ir nepieciešams saglabāt datus diskā, un visbiežāk atbildam 'nē'.
Secinājums
Noslēgumā ceru, ka esmu devis vispārēju priekšstatu par redis-cluster darbību tiem, kas par to pilnīgi neko nav dzirdējuši, kā arī norādījis uz kādām acīmredzamām niansēm tiem, kas jau sen to izmanto.
Paldies par veltīto laiku, un kā parasti, komentāri par tēmu ir laipni gaidīti.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish