

Kubernetes klastera atjaunošanas process
Kādā brīdī, izmantojot Kubernetes klasteri, rodas nepieciešamība atjaunot aktīvās noder. Tas var ietvert pakotņu atjauninājumus, kodola atjauninājumus vai jaunu virtuālo mašīnu attēlu izplatīšanu. Kubernetes terminoloģijā tas tiek saukts par .
Šis ieraksts ir daļa no 4 ierakstu cikla:
- Šis ieraksts.
- Pareiza pod’iem darbības pārtraukšana Kubernetes klasterī
- Pārtraukta pod’a beigšana tā dzēšanas procesā
- Kā izvairīties no dīkstāves Kubernetes klasterī, izmantojot PodDisruptionBudgets
(piez. tul. citu cikla rakstu tulkojumi gaidāmi drīzumā)
Šajā rakstā mēs aprakstīsim visus rīkus, ko Kubernetes nodrošina, lai sasniegtu nulles dīkstāvi jūsu klastera aktīvajām noder.
Problēmas definēšana
Sākumā mēs izmantosim naivo pieeju, definējot problēmas un vērtējot potenciālos šī pieejas riskus, kā arī uzkrājot zināšanas, lai risinātu katru no problēmām, ar kurām sastapsimies visā ciklā. Rezultātā mēs iegūsim konfigurāciju, kurā tiek izmantoti lifecycle hooks, readiness probes un Pod disruption budgets, lai sasniegtu mūsu nulles dīkstāvi.
Lai uzsāktu mūsu ceļojumu, ņemsim konkrētu piemēru. Pieņemsim, ka mums ir Kubernetes klasteris ar diviem noder, kurā darbojas lietojumprogramma ar diviem pod’am, kas atrodas aiz Serviss:
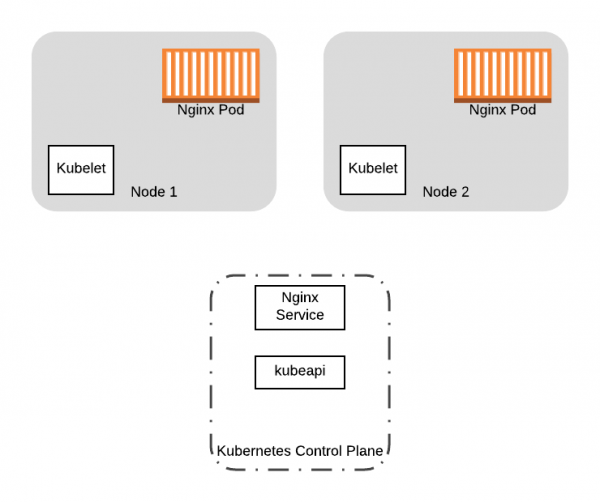
Sāksim ar diviem pod’iem ar Nginx un Servisu, kas darbojas mūsu divos Kubernetes klastera noder.
Mēs vēlamies atjaunot divu darboto noder kodola versiju mūsu klasterī. Kā mēs to izdarīsim? Vienkārša risinājuma būtu jauni noder ar atjaunoto konfigurāciju, pēc tam izslēdzot vecos noder, vienlaikus palaižot jaunus. Lai gan tas darbosies, šādam pieejai būs vairākas problēmas:
- Kad jūs izslēgsiet vecos noder, uz tiem uzstādītie pod’i tiks izslēgti arī. Ko darīt, ja pod’i ir jānotīra, lai tos pareizi atslēgtu? Jūsu izmantotā virtualizācijas sistēma var negaidīt tīrīšanas procesa pabeigšanu.
- Ko darīt, ja jūs izslēgsiet visus noder vienlaikus? Jūs iegūsiet ievērojamu dīkstāvi, kamēr pod’i pāriet uz jaunajiem noder.
Mums nepieciešams pareizs veids, kā migrēt podus no vecajām mezgliem, un tajā pašā laikā jābūt drošiem, ka neviens no mūsu darba procesiem netiek palaists, kamēr mēs veicam izmaiņas mezglā. Vai, kad mēs veicam pilnīgu klastera nomaiņu, kā iepriekšminētajā piemērā (tas ir, nomainām VM attēlus), mēs vēlamies pārvietot strādājošās lietojumprogrammas no vecajiem mezgliem uz jauniem. Abos gadījumos mēs vēlamies novērst jaunu podu plānošanu vecajos mezglos, un pēc tam izraidīt no tiem visus palaistos podus. Lai sasniegtu šos mērķus, mēs varam izmantot komandu kubectl drain.
Vizu podu pārdale no mezgla
Drenāžas operācija ļauj pārdalīt visus podus no mezgla. Izpildes procesā mezgls tiek marķēts kā nesekmīgs (flags NoSchedule). Tas novērš jaunu podu parādīšanos uz tā. Pēc tam drenāža sāk izraidīt podus no mezgla, apturot konteinerus, kas šobrīd tiek palaisti mezglā, nosūtot signālu TERM konteineriem podā.
Lai gan kubectl drain drenāža veiksmīgi izturas pret podu izraidīšanu, ir vēl divi faktori, kas var izraisīt darbības drenāžas neizdošanos:
- Jūsu lietojumprogrammai jāspēj pareizi iziet, saņemot
TERMsignālu. Kad podi tiek izraidīti, Kubernetes nosūta signāluTERMkonteineriem un gaida, kamēr tie apstājas noteiktu laiku, pēc kura, ja tie nav apstājušies, tos aptur ar spēku. Jebkurā gadījumā, ja jūsu konteiners nesapratīs signālu pareizi, jūs joprojām varat nepareizi izslēgt podus, ja tie šobrīd darbojas (piemēram, tiek izpildīta datu bāzes transakcija). - Jūs zaudējat visus podus, kuros ir jūsu lietojumprogramma. Tā var būt nepieejama, kad jaunie konteineri tiek palaisti jaunajos mezglos, vai, ja jūsu podi ir izvietoti bez kontrolieriem, tie var neatsākties vispār.
Izvairīšanās no dīkstāves
Lai minimizētu dīkstāves laiku no brīvprātīgas traucējumiem, piemēram, no drenāžas operācijas mezglā, Kubernetes sniedz šādas kļūdu apstrādes iespējas:
Pārējās cikla daļās mēs izmantosim šīs Kubernetes funkcijas, lai mazinātu podu pārvietošanas sekas. Lai būtu vieglāk sekot pamatidejai, mēs izmantosim savu iepriekšminēto piemēru ar šādu resursa konfigurāciju:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Šī konfigurācija ir minimālais piemērs Deployment, kas pārvalda nginx podus kopienā. Turklāt konfigurācija apraksta resursu Serviss, kuru var izmantot, lai piekļūtu nginx podiem kopienā.
Visā cikla laikā mēs pakāpeniski paplašināsim šo konfigurāciju, lai beigās tajā iekļautos visas Kubernetes sniegtās iespējas, samazinot dīkstāves laiku.
Lai iegūtu pilnībā ieviestu un pārbaudītu Kubernetes klastera atjauninājumu versiju bez dīkstāves AWS un citos resursos, apmeklējiet .
Izlasiet arī citus rakstus mūsu emuārā:
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish