

Analītiskā DB ClickHouse apstrādā daudzveidīgas rindas, patērējot resursus. Lai paātrinātu sistēmas darbību, nepārtraukti tiek pievienotas jaunas optimizācijas. ClickHouse izstrādātājs Nikolajs Kočetovs stāsta par virknēšanas datu tipu, tostarp par jauno tipu LowCardinality, un skaidro, kā paātrināt darba procesu ar rindām.
— Sākumā izskatīsim, kā var uzglabāt rindas.
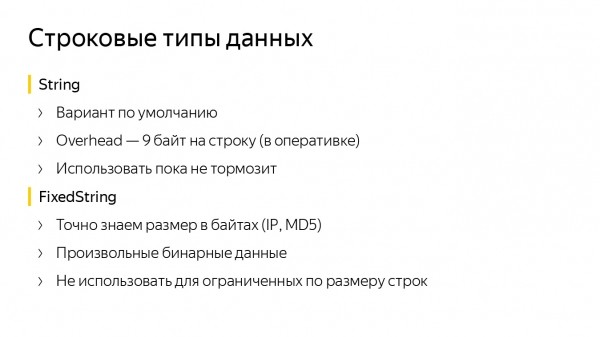
Mums ir virknēšanas datu tipi. String labi der kā noklusējuma variants, to vajadzētu izmantot gandrīz vienmēr. Tam ir neliels Overhead — 9 baiti vienai rindai. Ja vēlamies, lai rindu izmērs būtu fiksēts un zināms iepriekš, vislabāk izmantot FixedString. Tajā var noteikt nepieciešamo bajtu skaitu, tas ir ērti tādiem datiem kā IP adreses vai hashu funkcijas.
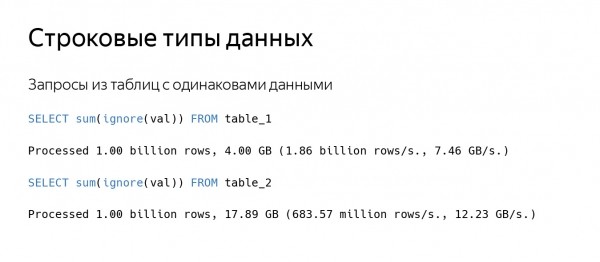
Protams, reizēm kaut kas palēninās. Pieņemsim, ka jūs veicat vaicājumu uz tabulu. ClickHouse lasa salīdzinoši lielu datu apjomu, sakot, ar ātrumu 100 GB/s, bet apstrādā maz rindu. Mums ir divas tabulas, kuras glabā gandrīz vienādus datus. Otrajā tabulā ClickHouse lasa datus lielākā ātrumā, taču rindu skaits sekundē tiek lasīts trīs reizes mazāk.
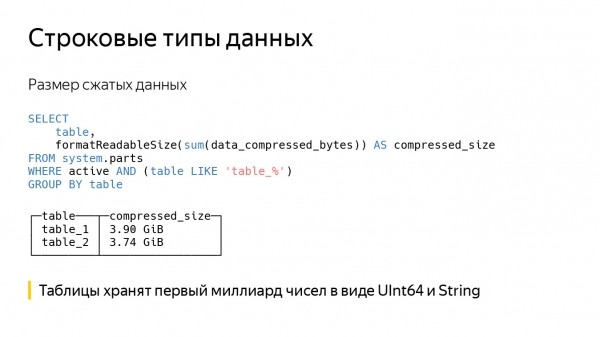
Ja mēs paskatāmies uz saspiesto datu izmēru, tas izrādīsies gandrīz vienāds. Patiesībā tabulās ir ierakstīti tie paši dati — pirmais miljards skaitļu — tikai pirmajā kolonnā tie ir ierakstīti kā UInt64, bet otrajā — kā String. Tāpēc otrais vaicājums ilgāk lasa datus no diska un tos atspiež.
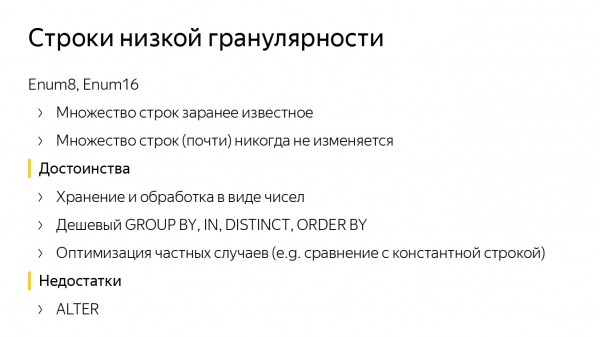
Šeit ir cits piemērs. Pieņemsim, ka ir iepriekš zināms rindas kopums, kas ir ierobežots ar konstantu 1000 vai 10 000 un praktiski nekad nemainās. Šajā gadījumā mums der datu tips Enum, ClickHouse ir divi — Enum8 un Enum16. Izmantojot Enum, mēs ātri apstrādājam vaicājumus.
ClickHouse ir paātrinājumi GROUP BY, IN, DISTINCT un optimizācijas dažām funkcijām, piemēram, salīdzināšanai ar konstantu virkni. Protams, skaitļi virknē netiek pārveidoti, bet, gluži pretēji, konstanta virkne tiek pārveidota uz Enum vērtību. Pēc tam viss ātri salīdzina.
Bet ir arī mīnusi. Pat ja mēs zinām precīzu rindu kopumu, dažkārt tas jāpapildina. Ja iestājas jauna rinda — mums jāveic ALTER.
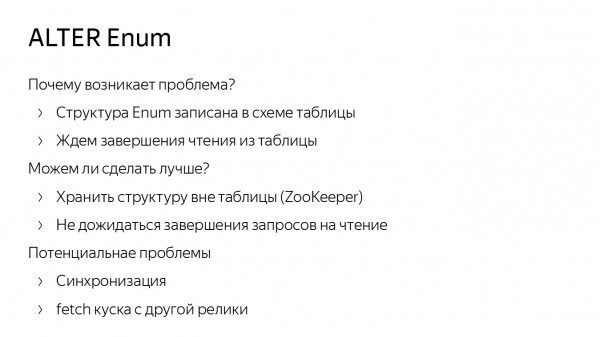
ALTER komanda Enum ClickHouse ir optimizēta. Mēs nepārrakstām datus diskā, bet ALTER var mazliet palēnināt izpildi, jo Enum struktūras tiek glabātas pašas tabulas shēmā. Tāpēc mums jāgaida lasīšanas pieprasījumi no tabulas, piemēram.
Rodās jautājums, vai ir iespējams labāk? Iespējams, jā. Enum struktūru var saglabāt nevis tabulas shēmā, bet gan ZooKeeper. Tomēr var rasties problēmas, kas saistītas ar sinhronizāciju. Piemēram, viena replika saņem datus, bet otra — nē, un, ja tai ir vecais Enum, tad kaut kas var sabojāties. (ClickHouse mēs gandrīz esam pabeiguši nebloķējošos ALTER pieprasījumus. Kad mēs tos pabeigsim pilnīgi, nebūs nepieciešams gaidīt lasīšanas pieprasījumus.)
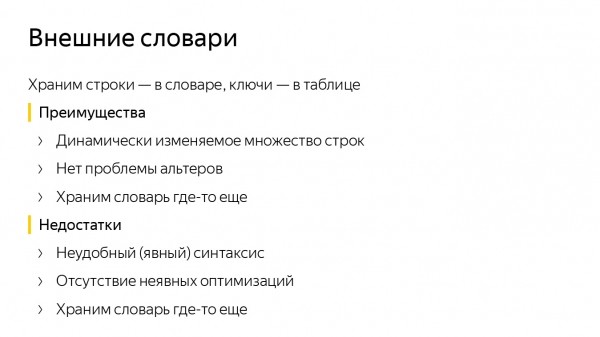
Lai nesaskartos ar ALTER Enum, var izmantot ClickHouse ārējos vārdus. Atgādinu, ka tas ir key-value datu struktūra ClickHouse, ar kuru var iegūt datus no ārējiem avotiem, piemēram, no MySQL tabulām.
ClickHouse vārdnīcā mēs uzglabājam daudz dažādu rindu, bet tabulā — viņu identifikatori ciparu formā. Ja mums ir nepieciešams iegūt rindu, mēs izsaucam funkciju dictGet un strādājam ar to. Pēc tam mums vairs nav jāveic ALTER. Lai ko pievienotu Enum, mēs to ievietojam tajā pašā MySQL tabulā.
Tomēr šeit rodas citas problēmas. Pirmkārt, neērta sintakse. Ja mēs vēlamies iegūt rindu, mums ir jāsauc dictGet. Otrkārt, trūkst dažu optimizāciju. Salīdzinājums ar konstanto rindu vārdnīcām nav tik ātrs.
Var būt arī problēmas ar atjaunināšanu. Pieņemsim, ka mēs pieprasījām rindu keš vārdnīcā, bet tā neiekļuva kešā. Tad mums jāgaida, kamēr dati tiks ielādēti no ārējā avota.
Abu metožu kopējais trūkums ir tas, ka mēs glabājam visus atslēgas vienā vietā un tos sinhronizējam. Tātad, kāpēc neglabāt vārdnīcas lokāli? Nav sinhronizācijas — nav problēmu. Vārdnīcu var glabāt lokāli diskā. Tas ir, mēs veicam Insert, ierakstām vārdnīcu. Ja mēs strādājam ar datiem atmiņā, tad varam ierakstīt vārdnīcu vai nu datu blokā, vai kolonnas gabalā, vai kādā kešā, lai paātrinātu aprēķinus.
Vārdu kodošana rindām
Tādējādi mēs nonācām pie jauna datu tipa izveides ClickHouse — LowCardinality. Tas ir datu uzglabāšanas formāts: kā tie tiek ierakstīti diskā un kā tie tiek nolasīti, kā tie tiek attēloti atmiņā un shēma viņu apstrādei.
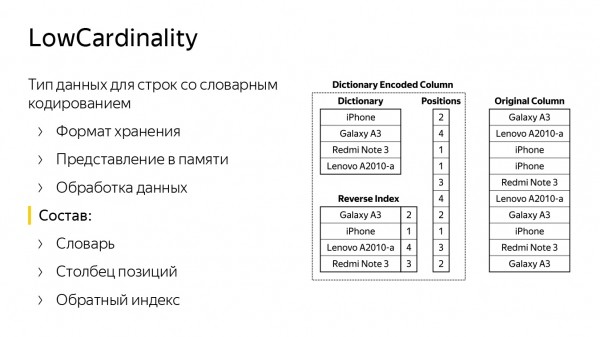
Slide satur contains two columns. On the right, the rows are stored in the standard type String. It is clear that these are some model of mobile phones. On the left, there is an identical column, but in the type LowCardinality. It consists of a dictionary with numerous different strings (strings from the column on the right) and a list of positions (row numbers).
With the help of these two structures, the original column can be restored. There is also a reverse mapping index — a hash table that helps find the position in the dictionary by the string. It is necessary to speed up certain queries. For example, if we want to compare, search for a string in our column, or merge them together.
LowCardinality is a parameterized data type. It can be either a number, or something stored as a number, or a string, or Nullable types of them.
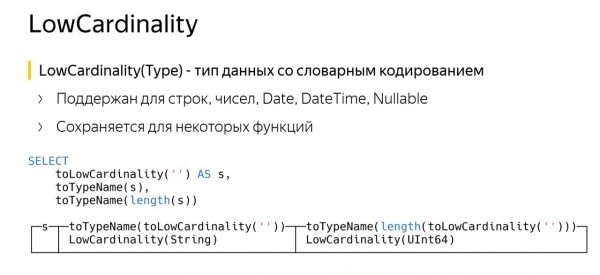
The feature of LowCardinality is that it can be saved for some functions. The slide shows an example of a query. In the first line, I created a column of type LowCardinality from String, naming it S. Then I asked for its name — ClickHouse said it is LowCardinality from String. That's correct.
The third line is almost the same, except we called the length function. In ClickHouse, the length function returns the data type UInt64. But now we have it as LowCardinality from UInt64. What is the point?
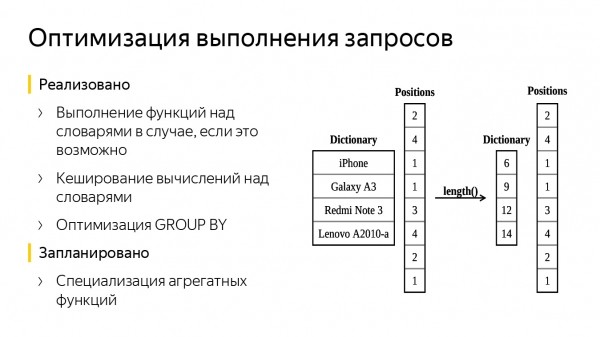
The dictionary stored the names of mobile phones; we applied the length function. Now we have an equivalent dictionary consisting only of numbers — these are the string lengths. The column with positions remained unchanged. As a result, we processed less data and saved on query time.
There can be other optimizations, such as adding a simple cache. When calculating the value of a function, it can be remembered and constructed without recalculating.
There may also be optimization for GROUP BY, because our column with a dictionary is already partially aggregated — it is possible to compute hash function values faster and roughly find the bucket to place the next string. Additionally, some aggregate functions can be specialized, for example uniq, since it can only receive the dictionary while leaving the positions untouched — this way everything will work faster. The first two optimizations have already been added to ClickHouse.
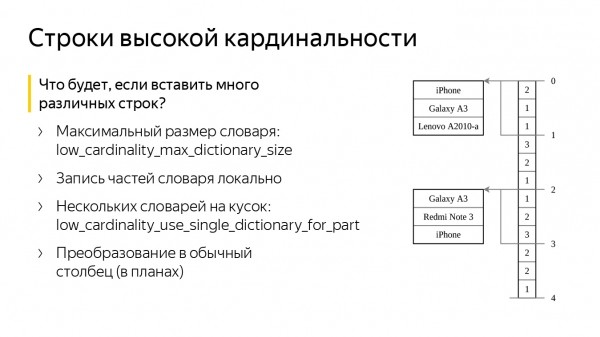
Un, ja mēs izveidosim kolonnu ar mūsu datu tipu un ievietosim tajā daudz sliktu dažādu rindu? Vai mūsu atmiņa nebūs pārpildīta? Nē, ClickHouse ir divi īpaši iestatījumi šim nolūkam. Pirmais ir low_cardinality_max_dictionary_size. Tas ir maksimālais vārdnīcas lielums, kas var tikt ierakstīts diskā. Ievietošana notiek šādi: kad mēs ievietojam datus, pie mums nonāk rindu plūsma, no kurām mēs veidojam lielu kopēju vārdnīcu. Ja vārdnīca kļūst lielāka par iestatījuma vērtību, mēs ierakstām pašreizējo vārdnīcu diskā, bet pārējās rindas — kaut kur "malā", blakus indeksiem. Tādējādi mēs nekad nepārskatīsim lielo vārdnīcu un nesaskarsimies ar atmiņas problēmām.
Otrais iestatījums saucas low_cardinality_use_single_dictionary_for_part. Iedomājieties, ka iepriekšējā shēmā, kad mēs ievietojām datus, mūsu vārdnīca pārpildījās, un mēs to ierakstījām diskā. Rodas jautājums, kāpēc šobrīd neizveidot vēl vienu tādu pašu vārdnīcu?
Kad tā pārpildīsies, mēs atkārtoti ierakstīsim to diskā un sāksim veidot trešo. Šis iestatījums tieši atspējo šādu iespēju pēc noklusējuma.
Patiesībā daudz vārdnīcu var būt noderīgas, ja mēs vēlamies ievietot kaut kādu virkni rindu, bet nejauši ievietojām "atkritumus". Teiksim, vispirms mēs ievietojām sliktas rindas, un tad ievietojām labas. Tādējādi vārdnīca tiks sadalīta daudzās mazās vārdnīcās. Daļa no tām būs ar "atkritumiem", bet pēdējās būs ar labām rindām. Un, ja mēs lasīsim, teiksim, tikai pēdējo graudu, viss arī darbosies ātri.
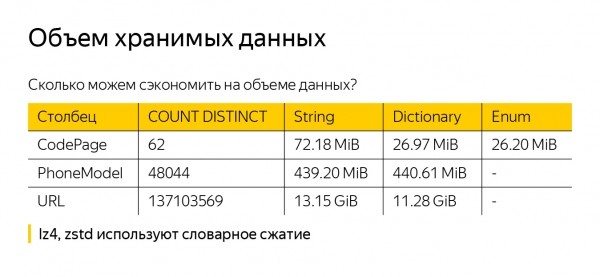
Pirms runājot par LowCardinality priekšrocībām, uzreiz teikšu, ka mēs, visticamāk, nesasniegsim datu samazinājumu diskā (lai gan tas var notikt), jo ClickHouse saspiesta datus. Ir noklusējuma opcija — LZ4. Tāpat var veikt kompresiju ar ZSTD. Bet abi algoritmi jau īsteno vārdnīcu kompresiju, tāpēc mūsu ārējā vārdnīca ClickHouse nevienai nepalīdzēs.
Lai nebūtu runāšana tukšā, es paņēmu dažus datus no metrikas — String, LowCardinality(String) un Enum — un saglabāju tos dažādās datu tipās. Sanāca trīs kolonnas, kurās ir ierakstīts viens miljards rindu. Pirmajā kolonnā, CodePage, ir tikai 62 vērtības. Un ir redzams, ka LowCardinality(String) mums tās ir saspiests labāk. String nedaudz sliktāk, taču tas, visticamāk, ir tāpēc, ka virknes ir īsas, mēs glabājam to garumus, un tās aizņem daudz vietas, slikti saspiežas.
Ja ņem vērā PhoneModel, to ir 48 tūkstoši — jau vairāk, un atšķirības starp String un LowCardinality(String) gandrīz nav. URL mēs arī ietaupījām tikai 2 GB — domāju, uz to nevajadzētu paļauties.
Darba ātruma novērtējums
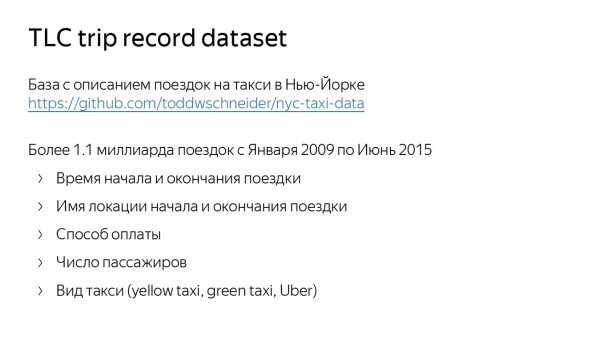
Tagad novērtēsim darba ātrumu. Lai to novērtētu, es izmantoju datu kopu ar taksometru braucienu aprakstu Ņujorkā. Tas ir GitHub. Tajā ir nedaudz vairāk par miljardu braucienu. Tur ir iekļauta lokalizācija, brauciena sākuma un beigšanas laiks, apmaksas veids, pasažieru skaits un pat taksometra veids — zaļais, dzeltenais un Uber.
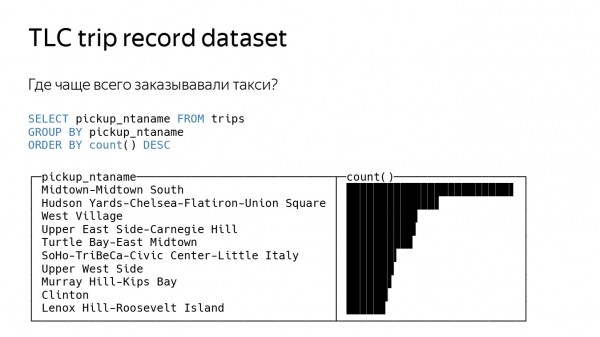
Pirmo jautājumu es veidoju diezgan vienkāršu — pajautāju, kur visbiežāk pasūta taksometru. Lai to izdarītu, ir jāņem lokalizācija, no kuras tika pasūtīts, jāizdara GROUP BY un jāpaskaita funkcija count. Šeit ClickHouse kaut ko izvada.
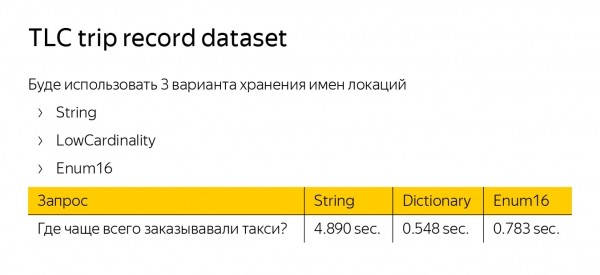
Lai izmērītu vaicājuma apstrādes ātrumu, es izveidoju trīs tabulas ar vienādiem datiem, bet izmantoju trīs dažādus datu tipus mūsu sākuma lokalizācijai — String, LowCardinality un Enum. LowCardinality un Enum izrādījās piecas reizes ātrāki par String. Enum ir ātrāks, jo darbojas ar skaitļiem. LowCardinality — tāpēc, ka ir ieviesta GROUP BY optimizācija.
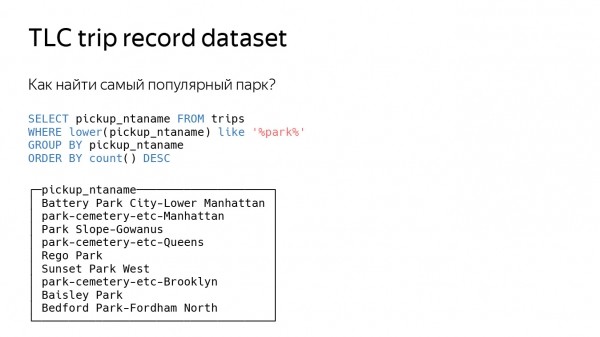
Pavisam nedaudz sarežģīsim vaicājumu — pajautāsim, kur atrodas populārākais parks Ņujorkā. Atkal mēs to mērīsim pēc tā, kur visbiežāk pasūta taksometru, bet filtrēsim tikai tās lokalizācijas, kurās ir vārds "parks". Arī pievienosim funkciju like.
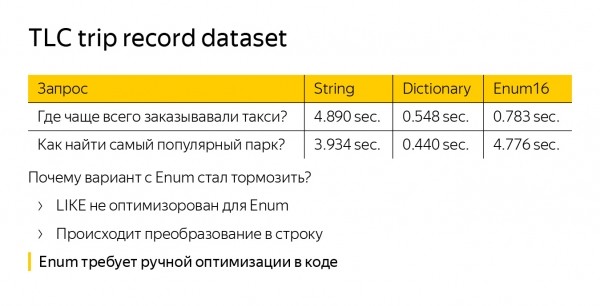
Skatāmies laiku — redzam, ka Enum pēkšņi sāka palēnināties. Turklāt tas darbojas pat lēnāk nekā standarta datu tips String. Tas notiek tāpēc, ka funkcija like nav vispār optimizēta Enum. Mums nākas konvertēt mūsu virknes no Enum uz parastām virkām — mēs veicam vairāk darba. LowCardinality(String) arī pēc noklusējuma nav optimizēts, taču tur like darbojās pār vārdnīcu, tāpēc vaicājums paātrinās salīdzinājumā ar String.
Strādājot ar Enum, ir viena globālāka problēma. Ja mēs vēlamies to optimizēt, tas jādara katrā koda vietā. Pieņemsim, ka mēs esam uzrakstījuši jaunu funkciju – noteikti ir jāizdomā optimizācija Enum. Bet LowCardinality ir optimizēts pēc noklusējuma.
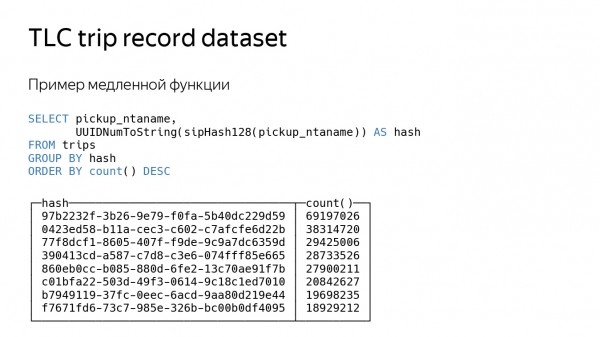
Paskatīsimies uz pēdējo pieprasījumu, kas ir mākslīgāks. Mēs vienkārši saskaitīsim mūsu atrašanās vietas heša funkciju. Heša funkcija ir diezgan lēns pieprasījums, tas prasa ilgu laiku, tāpēc viss palēninās apmēram trīs reizes.
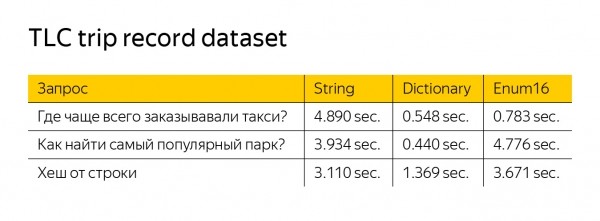
LowCardinality joprojām darbojas ātrāk, lai gan šeit nav filtrēšanas. Tas notiek tāpēc, ka mūsu funkcijas darbojas tikai ar vārdnīcu. Heša aprēķina funkcijai ir viens arguments – tā var apstrādāt mazāk datus un arī var atgriezt LowCardinality.
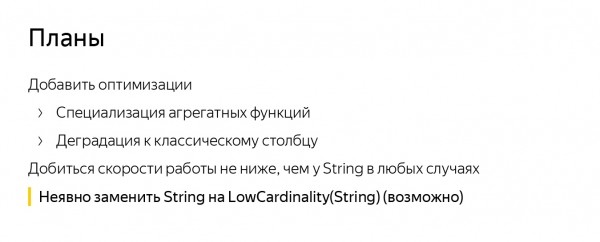
Mūsu globālais plāns ir panākt ātrumu, kas nav zemāks par String jebkuros gadījumos, un saglabāt paātrinājumu. Un, iespējams, mēs kādu dienu aizvietosim String ar LowCardinality, jūs atjaunināsiet ClickHouse, un jūsu darbs nedaudz paātrināsies.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish