

TL;DR: Pirms četriem gadiem es atstāju Google ar ideju par jaunu servera uzraudzības rīku. Ideja bija apvienot parasti izolētas funkcijas vienā pakalpojumā un žurnālu analīze, metrikas apkopošana, un informācijas paneļiem. Viens no principiem ir tāds, ka pakalpojumam ir jābūt patiesam ātri, nodrošinot devops vienkāršu, interaktīvu un patīkamu pieredzi. Šim nolūkam ir jāapstrādā vairāku gigabaitu datu kopas sekundes daļās, nepārsniedzot budžetu. Esošie žurnālu pārvaldības rīki bieži ir lēni un neveikli, tāpēc mēs saskārāmies ar labu izaicinājumu: gudri izstrādāt rīku, lai sniegtu lietotājiem jaunu pieredzi.
Šajā rakstā ir aprakstīts, kā mēs Scalyr atrisinājām šo problēmu, izmantojot vecās skolas metodes, brutālā spēka pieeju, novēršot nevajadzīgus slāņus un izvairoties no sarežģītām datu struktūrām. Šīs nodarbības varat izmantot savām inženiertehniskajām problēmām.
Vecās skolas spēks
Žurnāla analīze parasti sākas ar meklēšanu: atrodiet visus ziņojumus, kas atbilst noteiktam modelim. Programmā Scalyr tie ir desmitiem vai simtiem gigabaitu žurnālu no daudziem serveriem. Mūsdienu pieejas, kā likums, ietver sarežģītas datu struktūras izveidi, kas optimizēta meklēšanai. Es noteikti to esmu redzējis Google tīklā, kur viņi ir diezgan labi šajās lietās. Bet mēs izvēlējāmies daudz rupjāku pieeju: baļķu lineāro skenēšanu. Un tas darbojās — mēs nodrošinām meklējamu saskarni, kas ir vairākas reizes ātrāka nekā mūsu konkurenti (skatiet animāciju beigās).
Galvenais ieskats bija tāds, ka mūsdienu procesori patiešām ir ļoti ātri, veicot vienkāršas un vienkāršas darbības. To var viegli nepamanīt sarežģītās, daudzslāņu sistēmās, kas balstās uz I/O ātrumu un tīkla darbībām, un šādas sistēmas mūsdienās ir ļoti izplatītas. Tāpēc mēs izstrādājām dizainu, kas samazina slāņus un liekos gružus. Ja paralēli ir vairāki procesori un serveri, meklēšanas ātrums sasniedz 1 TB sekundē.
Galvenās atziņas no šī raksta:
- Brutāla meklēšana ir dzīvotspējīga pieeja reālu, liela mēroga problēmu risināšanai.
- Brutālais spēks ir dizaina tehnika, nevis risinājums bez darba. Tāpat kā jebkura tehnika, tā ir labāk piemērota dažām problēmām nekā citām, un to var īstenot slikti vai labi.
- Brutāls spēks ir īpaši labs, lai sasniegtu stabils produktivitāte.
- Lai efektīvi izmantotu brutālu spēku, ir nepieciešams optimizēt kodu un piemērot pietiekamus resursus īstajā laikā. Tas ir piemērots, ja jūsu serveri ir pakļauti lielai lietotāju slodzei un lietotāju darbības joprojām ir prioritāte.
- Veiktspēja ir atkarīga no visas sistēmas konstrukcijas, nevis tikai no iekšējās cilpas algoritma.
(Šajā rakstā ir aprakstīta datu meklēšana atmiņā. Vairumā gadījumu, kad lietotājs veic meklēšanu žurnālā, Scalyr serveri to jau ir saglabājuši kešatmiņā. Nākamajā rakstā tiks apspriesta nekešatmiņā saglabāto žurnālu meklēšana. Tiek piemēroti tie paši principi: efektīvs kods, brutāls spēks ar lieliem skaitļošanas resursiem).
Brutālā spēka metode
Tradicionāli liela datu kopa tiek meklēta, izmantojot atslēgvārdu indeksu. Lietojot servera žurnālos, tas nozīmē, ka žurnālā ir jāmeklē katrs unikālais vārds. Katram vārdam ir jāizveido visu ieslēgumu saraksts. Tādējādi ir viegli atrast visus ziņojumus ar šo vārdu, piemēram, 'error', 'firefox' vai "transaction_16851951" — vienkārši skatieties rādītājā.
Es izmantoju šo pieeju Google, un tā darbojās labi. Bet Scalyr mēs meklējam žurnālus pa baitam.
Kāpēc? No abstraktā algoritmiskā viedokļa atslēgvārdu indeksi ir daudz efektīvāki nekā meklēšana ar brutālu spēku. Tomēr mēs nepārdodam algoritmus, bet gan veiktspēju. Un veiktspēja ir saistīta ne tikai ar algoritmiem, bet arī par sistēmu inženieriju. Mums jāņem vērā viss: datu apjoms, meklēšanas veids, pieejamā aparatūra un programmatūras konteksts. Mēs nolēmām, ka mūsu konkrētajai problēmai kaut kas līdzīgs “grep” ir labāk piemērots nekā indekss.
Indeksi ir lieliski, taču tiem ir ierobežojumi. Vienu vārdu ir viegli atrast. Taču meklēt ziņojumus ar vairākiem vārdiem, piemēram, “googlebot” un “404”, ir daudz grūtāk. Lai meklētu tādu frāzi kā “nepieķerts izņēmums”, ir nepieciešams apgrūtinošāks rādītājs, kas reģistrē ne tikai visus ziņojumus ar šo vārdu, bet arī konkrētā vārda atrašanās vietu.
Īstās grūtības rodas, kad nemeklē vārdus. Pieņemsim, ka vēlaties redzēt, cik daudz trafika nāk no robotprogrammatūrām. Pirmā doma ir žurnālos meklēt vārdu 'bot'. Šādi jūs atradīsiet dažus robotus: Googlebot, Bingbot un daudzus citus. Bet šeit "bots" nav vārds, bet gan tā daļa. Ja indeksā meklēsim “bot”, mēs neatradīsim nevienu ziņu ar vārdu “Googlebot”. Ja pārbaudīsit katru vārdu rādītājā un pēc tam pārmeklēsiet indeksā atrastos atslēgvārdus, meklēšana ievērojami palēnināsies. Rezultātā dažas žurnālprogrammas neļauj meklēt vārdu daļu vai (labākajā gadījumā) atļauj īpašu sintaksi ar zemāku veiktspēju. Mēs vēlamies no tā izvairīties.
Vēl viena problēma ir pieturzīmes. Vai vēlaties atrast visus pieprasījumus no 50.168.29.7? Kas par atkļūdošanas žurnāliem, kas satur [error]? Apakšraksti parasti izlaiž pieturzīmes.
Visbeidzot, inženieri mīl spēcīgus rīkus, un dažreiz problēmu var atrisināt tikai ar regulāru izteiksmi. Atslēgvārdu rādītājs tam nav īpaši piemērots.
Turklāt indeksi komplekss. Katrs ziņojums ir jāpievieno vairākiem atslēgvārdu sarakstiem. Šie saraksti vienmēr ir jāsaglabā viegli meklējamā formātā. Vaicājumi ar frāzēm, vārdu fragmentiem vai regulārām izteiksmēm ir jāpārvērš vairāku sarakstu operācijās, un rezultāti jāskenē un jāapvieno, lai izveidotu rezultātu kopu. Liela mēroga, vairāku nomnieku pakalpojuma kontekstā šī sarežģītība rada veiktspējas problēmas, kas nav redzamas, analizējot algoritmus.
Atslēgvārdu indeksi arī aizņem daudz vietas, un uzglabāšana ir lielas izmaksas žurnālu pārvaldības sistēmā.
No otras puses, katra meklēšana var patērēt daudz skaitļošanas jaudas. Mūsu lietotāji novērtē ātrdarbīgu unikālu vaicājumu meklēšanu, taču šādi vaicājumi tiek veikti salīdzinoši reti. Tipiskiem meklēšanas vaicājumiem, piemēram, informācijas panelim, mēs izmantojam īpašus paņēmienus (mēs tos aprakstīsim nākamajā rakstā). Citi pieprasījumi ir pietiekami reti, tāpēc jums reti ir jāapstrādā vairāki pieprasījumi vienlaikus. Taču tas nenozīmē, ka mūsu serveri nav aizņemti: tie ir aizņemti ar jaunu ziņojumu saņemšanu, analīzi un saspiešanu, brīdinājumu izvērtēšanu, veco datu saspiešanu utt. Tādējādi mums ir diezgan ievērojams procesoru piedāvājums, ko var izmantot vaicājumu izpildei.
Brutālais spēks darbojas, ja jums ir rupja problēma (un daudz spēka)
Brutālais spēks vislabāk darbojas vienkāršām problēmām ar mazām iekšējām cilpām. Bieži vien jūs varat optimizēt iekšējo cilpu, lai tā darbotos ļoti lielā ātrumā. Ja kods ir sarežģīts, to optimizēt ir daudz grūtāk.
Mūsu meklēšanas kodam sākotnēji bija diezgan liela iekšējā cilpa. Mēs saglabājam ziņojumus lapās 4K; katrā lapā ir daži ziņojumi (UTF-8) un katra ziņojuma metadati. Metadati ir struktūra, kas kodē vērtības garumu, iekšējā ziņojuma ID un citus laukus. Meklēšanas cikls izskatījās šādi:
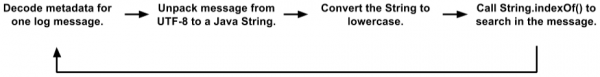
Šī ir faktiskā koda vienkāršota versija. Bet pat šeit ir redzami vairāki objektu izvietojumi, datu kopijas un funkciju izsaukumi. JVM diezgan labi spēj optimizēt funkciju izsaukumus un piešķirt īslaicīgus objektus, tāpēc šis kods darbojās labāk, nekā bijām pelnījuši. Testēšanas laikā klienti to diezgan veiksmīgi izmantoja. Bet galu galā mēs to pacēlām uz nākamo līmeni.
(Varat jautāt, kāpēc mēs glabājam ziņojumus šajā formātā ar 4K lapām, tekstu un metadatiem, nevis strādājam tieši ar žurnāliem. Ir daudz iemeslu, kas izriet no tā, ka iekšēji Scalyr dzinējs vairāk atgādina izkliedētu datu bāzi, nevis failu sistēma. Teksta meklēšana bieži tiek apvienota ar DBVS stila filtriem malās pēc žurnālu parsēšanas. Mēs varam vienlaikus meklēt daudzos tūkstošos žurnālu vienlaikus, un vienkārši teksta faili nav piemēroti mūsu darījumu, replicēto, izplatīto datu pārvaldībai).
Sākotnēji šķita, ka šāds kods nav īpaši piemērots brutālā spēka optimizācijai. "Īsts darbs". String.indexOf() pat nedominēja CPU profilā. Tas ir, šīs metodes optimizēšana vien nedotu būtisku efektu.
Gadās, ka mēs glabājam metadatus katras lapas sākumā, un visu UTF-8 ziņojumu teksts tiek iesaiņots otrā galā. Izmantojot šo iespēju, mēs pārrakstījām cilpu, lai meklētu visā lapā uzreiz:
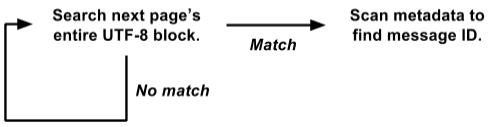
Šī versija darbojas tieši skatā raw byte[] un meklē visus ziņojumus vienlaikus visā 4K lapā.
To ir daudz vieglāk optimizēt brutālā spēka metodei. Iekšējā meklēšanas cilpa tiek izsaukta vienlaikus visai 4K lapai, nevis atsevišķi katrā ziņā. Nav datu kopēšanas, objektu piešķiršanas. Un sarežģītākas metadatu darbības tiek izsauktas tikai tad, ja rezultāts ir pozitīvs, nevis katram ziņojumam. Tādā veidā mēs esam likvidējuši tonnu pieskaitāmo izdevumu, un pārējā slodze ir koncentrēta nelielā iekšējā meklēšanas cilpā, kas ir labi piemērota turpmākai optimizācijai.
Mūsu faktiskais meklēšanas algoritms ir balstīts uz . Tas ir līdzīgs Boyer-Moore algoritmam, katrā solī izlaižot aptuveni meklēšanas virknes garumu. Galvenā atšķirība ir tā, ka tā vienlaikus pārbauda divus baitus, lai samazinātu viltus atbilstību.
Mūsu ieviešanai ir nepieciešams izveidot 64 1,25 uzmeklēšanas tabulu katram meklējumam, taču tas nav nekas, salīdzinot ar datu gigabaitiem, kurus mēs meklējam. Iekšējā cilpa apstrādā vairākus gigabaitus sekundē vienā kodolā. Praksē stabila veiktspēja ir aptuveni XNUMX GB sekundē katrā kodolā, un ir iespējas uzlabot. Ir iespējams novērst daļu no pieskaitāmajām izmaksām ārpus iekšējās cilpas, un mēs plānojam eksperimentēt ar iekšējo cilpu C valodā, nevis Java.
Mēs izmantojam spēku
Mēs esam apsprieduši, ka žurnālu meklēšanu var īstenot "aptuveni", bet cik daudz mums ir "jauda"? Diezgan daudz.
1 kodols: Pareizi lietojot, viens mūsdienu procesora kodols pats par sevi ir diezgan spēcīgs.
8 serdeņi: Pašlaik mēs strādājam Amazon hi1.4xlarge un i2.4xlarge SSD serveros, katrs ar 8 kodoliem (16 pavedieni). Kā minēts iepriekš, šie kodoli parasti ir aizņemti ar fona darbībām. Kad lietotājs veic meklēšanu, fona darbības tiek apturētas, tādējādi meklēšanai tiek atbrīvoti visi 8 kodoli. Meklēšana parasti tiek pabeigta sekundes daļā, pēc kuras tiek atsākts fona darbs (drosēšanas programma nodrošina, ka meklēšanas vaicājumu straume netraucē svarīgu fona darbu).
16 serdeņi: uzticamības labad mēs sakārtojam serverus galvenajās/slavenajās grupās. Katram meistaram ir viens SSD un viens EBS serveris. Ja galvenais serveris avarē, SSD serveris nekavējoties ieņem tā vietu. Gandrīz visu laiku galvenais un slavenais darbojas labi, tāpēc katrs datu bloks ir meklējams divos dažādos serveros (EBS vergu serverim ir vājš procesors, tāpēc mēs to neuzskatām). Mēs sadalām uzdevumus starp tiem, lai kopā būtu pieejami 16 kodoli.
Daudzi serdeņi: tuvākajā nākotnē mēs sadalīsim datus starp serveriem tā, lai tie visi piedalītos katra nenozīmīga pieprasījuma apstrādē. Katrs kodols darbosies. [Piezīme: īstenojām plānu un palielinājām meklēšanas ātrumu līdz 1 TB/s, skatiet piezīmi raksta beigās].
Vienkāršība nodrošina uzticamību
Vēl viena brutālā spēka metodes priekšrocība ir tās diezgan konsekventa veiktspēja. Parasti meklēšana nav īpaši jutīga pret problēmas un datu kopas detaļām (domāju, ka tāpēc to sauc par "rupju").
Atslēgvārdu rādītājs dažreiz sniedz neticami ātrus rezultātus, bet citreiz ne. Pieņemsim, ka jums ir 50 GB žurnālu, kuros vārds “customer_5987235982” tiek parādīts tieši trīs reizes. Meklējot šo vārdu, tiek uzskaitītas trīs atrašanās vietas tieši no rādītāja, un tā tiks pabeigta uzreiz. Taču sarežģīta aizstājējzīmju meklēšana var skenēt tūkstošiem atslēgvārdu un aizņemt ilgu laiku.
No otras puses, brutālā spēka meklēšana jebkuram vaicājumam veic vairāk vai mazāk tādu pašu ātrumu. Labāk ir meklēt garus vārdus, taču pat vienas rakstzīmes meklēšana ir diezgan ātra.
Brutālā spēka metodes vienkāršība nozīmē, ka tās veiktspēja ir tuvu tās teorētiskajam maksimumam. Ir mazāk iespēju neparedzētai diska pārslodzei, bloķēšanai, rādītāja dzīšanai un tūkstošiem citu kļūmes iemeslu. Es tikko paskatījos uz Scalyr lietotāju pieprasījumiem pagājušajā nedēļā mūsu noslogotākajā serverī. Bija 14 000 pieprasījumu. Tieši astoņiem no tiem vajadzēja vairāk nekā vienu sekundi; 99% pabeigti 111 milisekundēs (ja neesat izmantojis žurnālu analīzes rīkus, ticiet man: tas ir ātri).
Stabila, uzticama veiktspēja ir svarīga pakalpojuma ērtai lietošanai. Ja tas periodiski atpaliek, lietotāji to uztvers kā neuzticamu un nelabprāt to izmantos.
Žurnāla meklēšana darbībā
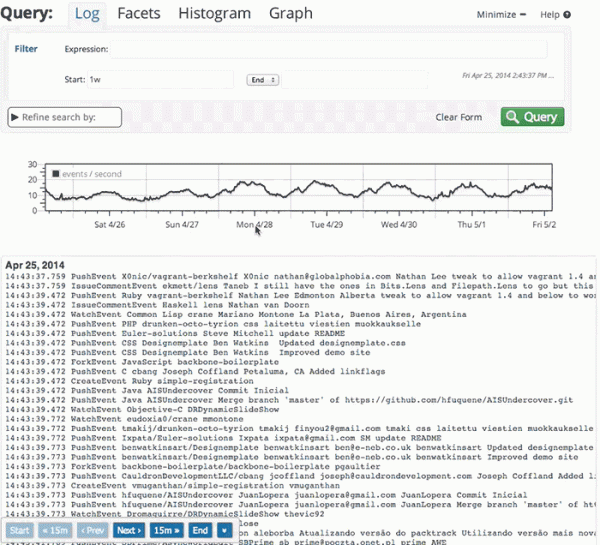
Šeit ir īsa animācija, kas parāda Scalyr meklēšanu darbībā. Mums ir demonstrācijas konts, kurā mēs importējam katru notikumu katrā publiskajā Github repozitorijā. Šajā demonstrācijā es pārbaudu nedēļas datus: aptuveni 600 MB neapstrādātu žurnālu.
Video tika ierakstīts tiešraidē, bez īpašas sagatavošanās, uz mana darbvirsmas (apmēram 5000 kilometrus no servera). Veiktspēja, ko redzēsit, lielā mērā ir saistīta ar , kā arī ātra un uzticama aizmugursistēma. Ikreiz, kad ir pauze bez “ielādes” indikatora, es apstājos, lai jūs varētu izlasīt, ko es gatavojos nospiest.
Noslēgumā
Apstrādājot lielu datu apjomu, ir svarīgi izvēlēties labu algoritmu, taču “labs” nenozīmē “iedomāts”. Padomājiet par to, kā jūsu kods darbosies praksē. Algoritmu teorētiskā analīze izslēdz dažus faktorus, kuriem var būt liela nozīme reālajā pasaulē. Vienkāršāki algoritmi ir vieglāk optimizējami un stabilāki malu situācijās.
Padomājiet arī par kontekstu, kurā kods tiks izpildīts. Mūsu gadījumā mums ir nepieciešami pietiekami jaudīgi serveri, lai pārvaldītu fona uzdevumus. Lietotāji sāk meklēšanu salīdzinoši reti, tāpēc mēs varam aizņemties veselu serveru grupu uz īsu laiku, kas nepieciešams katras meklēšanas pabeigšanai.
Izmantojot brutālā spēka metodi, mēs ieviesām ātru, uzticamu un elastīgu meklēšanu baļķu komplektā. Mēs ceram, ka šīs idejas noderēs jūsu projektiem.
Rediģēt: Virsraksts un teksts ir mainīts no “Meklēt ar ātrumu 20 GB sekundē” uz “Meklēt ar ātrumu 1 TB sekundē”, lai atspoguļotu veiktspējas pieaugumu dažu pēdējo gadu laikā. Šis ātruma pieaugums galvenokārt ir saistīts ar izmaiņām EC2 serveru tipā un skaitā, ko šodien ievietojam, lai apkalpotu mūsu palielināto klientu bāzi. Drīzumā gaidāmas izmaiņas, kas nodrošinās vēl vienu dramatisku darbības efektivitātes pieaugumu, un mēs nevaram vien sagaidīt, kad varēsim ar tām dalīties.
Avots: www.habr.com
