

Sava jomas dēļ bieži nākas saskarties ar situācijām, kad izstrādātājs raksta pieprasījumu un domā: "dati ir gudri, paši ar visu tiks galā!"«
Dažos gadījumos (daļēji no nezināšanas par DB iespējām, daļēji no pāragras optimizācijas) šāds pieejas veids noved pie "frankenšteiniem".
Vispirms piedāvāšu šādu pieprasījuma piemēru:
-- katrai atslēgas pāri atrodam saistītās lauku vērtības
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- atrodam min/max vērtības katram pirmajam atslēgum
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- saistām pēc pirmā atslēgas atslēgas pārus un min/max vērtības
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Lai konkretizētu pieprasījuma kvalitātes novērtējumu, izveidosim kaut kādu nejaušu datu kopu:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
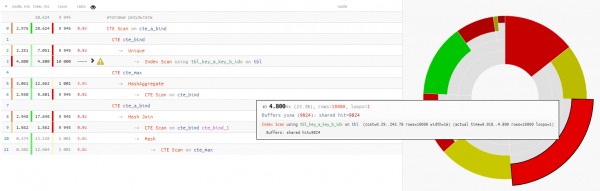
Izrādās, ka paša datu lasīšana aizņēma mazāk kā ceturto daļu no visa laika pieprasījuma izpildei:
Izpētām detaļas
Pievēršam uzmanību pieprasījumam un uzdodam jautājumu:
- Kāpēc šeit ir WITH RECURSIVE, ja nav nekādu rekursīvu CTE?
- Kāpēc grupēt min/max vērtības atsevišķā CTE, ja pēc tam tās tāpat tiek piesaistītas oriģinālajai atlasei?
+25% laika - Kāpēc izmantot beigās atkārtotu ielādi no iepriekšējā CTE caur beznosacījumu 'SELECT * FROM'?
+14% laika
Šajā gadījumā mums vēl ļoti paveicās, ka savienošanai tika izvēlēts Hash Join, nevis Nested Loop, jo tad mēs būtu ieguvuši nevis vienu vienīgu CTE Scan gājienu, bet 10K!
mazliet par CTE ScanŠeit jāatgādina, ka CTE Scan ir līdzvērtīgs Seq Scan — t.i., nekādas indeksācijas, tikai pilna pārbaude, kas prasītu 10K x 0.3ms = 3000ms ciklos pa cte_max vai 1K x 1.5ms = 1500ms ciklos pa cte_bind!
Patiesībā, ko mēs vēlējāmies iegūt rezultātā? Aha, parasti tieši tāds jautājums rodas apmēram piektajā minūtē, izpētot "trīsstāvu" pieprasījumus.
Mēs vēlējāmies katrai unikālai atslēgas pārī izvadīt min/max no grupas pēc key_a.
Tāpēc izmantojam :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 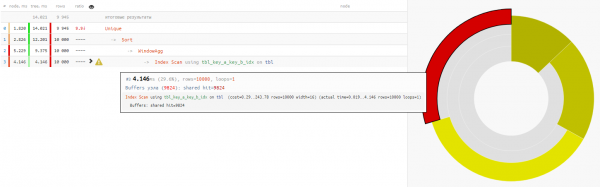
Tā kā datu lasīšana abos variantos aizņem aptuveni 4-5 ms, mūsu laika ieguvums -32% — tas ir tīrā veidā slodze, kas no CPU bāzes ir noņemta, ja šāds pieprasījums tiek izpildīts pietiekami bieži.
Kopumā nevajag bāzi piespiest „apaļu – nēsāt, kvadrātu – ripināt”.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish