

SQL val jūs aprakstāt, ko vēlaties iegūt, nevis kā tas tiks izpildīts. Tāpēc problēma ar SQL vaicājumu izstrādi „kā dzirdams, tā rakstīts” ieņem savu goda vietu līdzās .
Šodien paskatīsimies uz ļoti vienkāršiem piemēriem, uz ko tas var novest kontekstā par GROUP/DISTINCT un LIMIT kopā ar tiem.
Ja jūs vaicājumā esat uzrakstījis „vispirms savienojiet šos tabulas, un tad izmetiet visus dublikātus, jāpaliek tikai vienam eksemplāram katram atslēgai” — tieši tā tas darbosies, pat ja savienojums nemaz nebija nepieciešams.
Un dažreiz izdodas, un tas „vienkārši strādā”, dažreiz tas negatīvi ietekmē veiktspēju, bet dažreiz dod pilnīgi negaidītus efektus no izstrādātāja viedokļa.
Nu, varbūt ne tik iespaidīgi, bet...
„Saldā pāris”: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Šķiet, ka skaidrs, ko vēlējās izvēlēties tādus ierakstus X, kuriem Y ir saistīti ar izpildāmo nosacījumu.Uzrakstījuši vaicājumu caur JOIN — saņēmām dažus pk vērtības vairākas reizes (tieši tik reižu, cik attiecīgo ierakstu bija Y). Kā to novērst? Protams, DISTINCT!
Īpaši „priecē”, kad katram X ierakstam tiek atrasti vairāki simti saistītu Y ierakstu, un pēc tam varonīgi tiek izņemti dublikāti...
Kā to izlabot? Vispirms jāsaprot, ka uzdevums var tikt modificēts līdz „izvēlēties tādus ierakstus X, kuriem Y ir VISMAZ VIENA saistīta ar izpildāmo nosacījumu” — jo mums no paša Y ieraksta nekas nebija vajadzīgs.
Iekšējais EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Dažas PostgreSQL versijas saprot, ka EXISTS ir pietiekami atrast pirmo ierakstu, vecākas — nē. Tāpēc es dodu priekšroku vienmēr norādīt LIMIT 1 iekšpusē EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Šis variants ļauj, ja nepieciešams, vienlaicīgi atgriezt kādus datus no atrastā saistītā Y ieraksta. Līdzīgs variants apskatīts rakstā .
„Kāpēc maksāt vairāk”: DISTINCT [ON] + LIMIT 1
Papildu šādu pieprasījumu pārvēršanu priekšrocība ir iespēja viegli ierobežot ierakstu kategrācijas, ja nepieciešama tikai viena vai dažas no tām, kā norādīts nākamajā gadījumā:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Tagad mēs izpētām pieprasījumu un cenšamies saprast, ko piedāvā datu bāze:
- apvienojam tabulas
- un unikorizējam pēc X.pk
- no atlikušajiem ierakstiem izvēlamies kādu vienu
Tātad, ko mēs saņēmām? „Kādu vienu ierakstu” no unikorizētajiem — un, ja ņemam šo vienu no neunikorizētajiem, vai rezultāts kaut kā mainīsies?.. „Un, ja nav atšķirības, kāpēc maksāt vairāk?”
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- šeit var ievietot atbilstošas nosacījumus
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Un tieši tāda pati tēma ir ar GROUP BY + LIMIT 1.
„Man ir tikai jāpajautā”: netieša GROUP + LIMIT
Šādas lietas sastopamas dažādās pārbaudēs par to, vai tabula nav tukša vai CTE pieprasījuma izpildes gaitā:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Agregātu funkcijas (count/min/max/sum/...) veiksmīgi darbojas visā kopā, pat bez skaidra norādījuma GROUP BY. Tikai ar LIMIT viņi nesadarbojas pārāk labi.
Izstrādātājs var domāt „ja tur ir ieraksti, tad manam limitam nevajadzētu būt augstākam”. Bet tā nevajadzētu rīkoties! Jo datu bāzei tas ir:
- paskaitīt, ko viņi vēlas atdot tik daudz rindiņu, cik pieprasa
- Atkarībā no mērķa nosacījumiem šeit ir piemēroti veikt kādu no aizvietojumiem:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)uz(count + LIMIT 1) > 0EXISTS(LIMIT 1)uzcount >= N(SELECT count(*) FROM (... LIMIT N))uz„Cik svarā gramu”: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
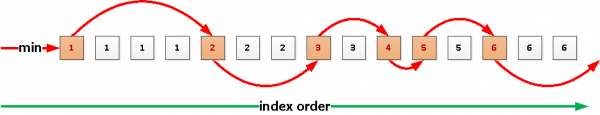
Naivs izstrādātājs var patiesi uzskatīt, ka pieprasījuma izpilde apstāsies,tā drīz vien mēs atradīsim $1 pirmos atšķirīgos vērtības Nākotnē tas varētu tā arī darboties pateicoties jaunajam mezglam.
Index Skip Scan , kura īstenošana pašlaik tiek apstrādāta, bet pagaidām — nē.Pagājuši būs vispirms
tiks izņemti visi ieraksti, unikorizēti, un tikai tad no tiem atgriezīsies tik daudz, cik tika pieprasīti. Īpaši skumji ir, ja mēs vēlējāmies kaut ko līdzīgu, bet tabulā ir simti tūkstoši... $1 = 4Lai nerunātu skumji veltīgi, izmantosim rekursīvo pieprasījumu
„DISTINCT nabadzīgajiem” no PostgreSQL Wiki :
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish