

Aicinu iepazīties ar Vladimira Sitnikova 2016. gada ziņojuma "PostgreSQL un JDBC: izspiežam visu iespējamo" atšifrējumu.
Labdien! Mani sauc Vladimirs Sitnikovs. Es strādāju uzņēmumā NetCracker jau 10 gadus. Galvenokārt nodarbojos ar veiktspēju. Viss, kas saistīts ar Java, viss, kas saistīts ar SQL – tas ir tas, kas man patīk.
Un šodien es pastāstīšu par to, ar ko mēs saskārāmies uzņēmumā, kad sākām izmantot PostgreSQL kā datu bāzes serveri. Un mēs galvenokārt strādājam ar Java. Taču tas, ko es šodien stāstīšu, ir saistīts ne tikai ar Java. Kā praksē parādījās, tas rodas arī citās valodās.
Mēs runāsim par:
- datu izvēli.
- Datu saglabāšanu.
- Kā arī par veiktspēju.
- Un par zemūdens akmeņiem, kas tur slēpjas.
Sāksim ar vienkāršu jautājumu. Mēs izvēlamies vienu rindu no tabulas pēc primārā atslēgu.
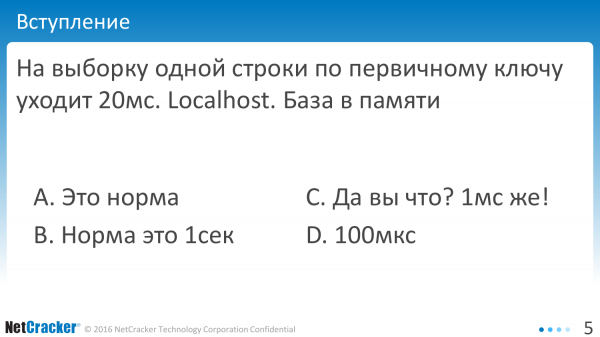
Datu bāze atrodas uz tā paša hosta. Un viss šis process aizņem 20 milisekundes.
Šīs 20 milisekundes ir ļoti daudz. Ja jums tādu ir 100 pieprasījumu, tad jūs tērējat laiku sekundēs, lai šos pieprasījumus izpildītu, t.i., tērējat laiku bezjēdzīgi.
Mēs to negribam darīt un skatāmies, ko mums piedāvā datu bāze. Datu bāze piedāvā mums divus pieprasījumu izpildes variantus.
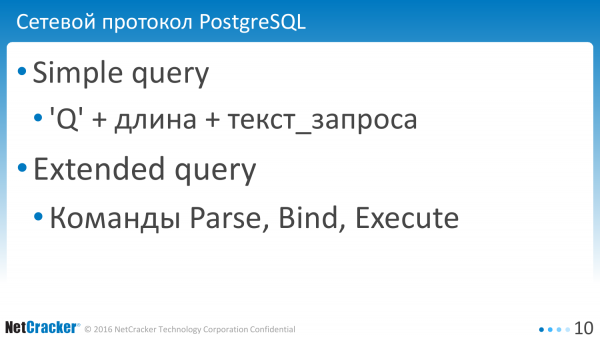
Pirmais variants – tas ir vienkāršs pieprasījums. Kas tajā ir labs? Tas, ka mēs to ņemam un nosūtām, un nekas vairāk.
Datu bāzei ir arī paplašināts pieprasījums, kas ir viltīgāks, taču funkcionālāks. Varat atsevišķi nosūtīt pieprasījumu par parsēšanu, izpildi, mainīgo saistīšanu utt.
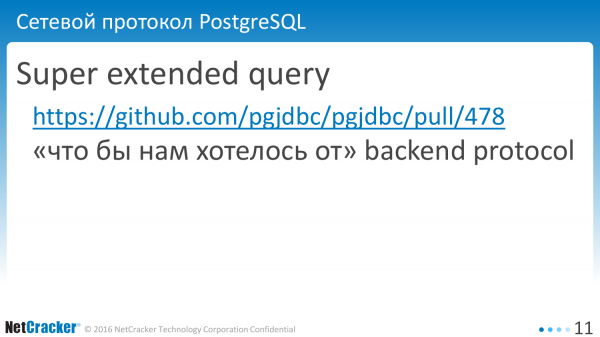
Super paplašināts pieprasījums – tas ir tas, ko mēs šajā ziņojumā neaptversim. Mēs, iespējams, gribam ko no datu bāzes, un ir tāds vēlmju saraksts, kas kādā formā ir izveidots, t.i., tas ir tas, ko mēs gribam, bet šobrīd un tuvākajā gadā tas nav iespējams. Tāpēc vienkārši pierakstījām un ejam tricināt galvenos cilvēkus.
Bet to, ko mēs varam izdarīt, ir – tas ir vienkāršais pieprasījums un paplašinātais pieprasījums.
Kādas ir katra pieejas īpatnības?
Vienkāršo pieprasījumu labi izmantot vienreizējai izpildei. Reiz izpildījām un aizmirsām. Un problēma ir tā, ka tas neatbalsta bināro datu formātu, t.i., augstas veiktspējas sistēmām tas nav piemērots.
Izcila vaicājuma funkcionalitāte ļauj ietaupīt laiku parsēšanā. Tieši to mēs izdarījām un sākām izmantot. Tas mums ir ārkārtīgi palīdzējis. Tur ir ne tikai ietaupījums parsēšanā. Ir arī ietaupījums datu pārsūtīšanas procesā. Datu pārsūtīšana binārā formātā ir daudz efektīvāka.
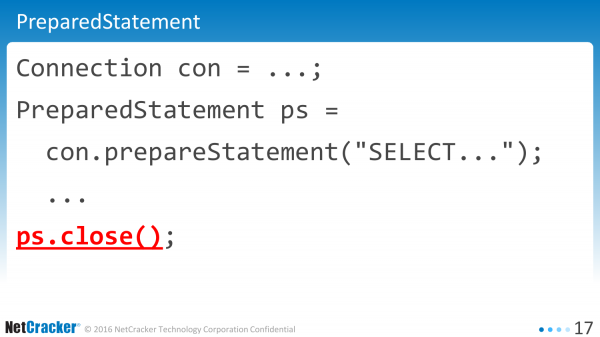
Pārslēgsimies pie praktiskās daļas. Tā izskatās tipiska lietojumprogramma. Tas var būt Java utt.
Mēs izveidojām statement. Izpildījām komandu. Izveidojām close. Kur ir šī kļūda? Kāda ir problēma? Nav problēmu. Tā ir rakstīts visās grāmatās. Tā ir jāraksta. Ja vēlaties maksimālu veiktspēju, rakstiet tā.
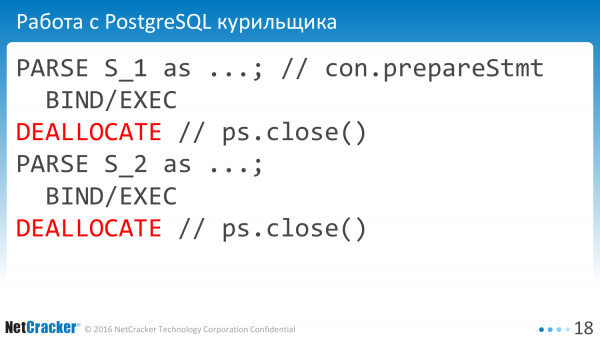
Taču prakse parādīja, ka tas nedarbojas. Kāpēc? Tāpēc, ka mums ir metode «close». Kad mēs to tā darām, no datu bāzes viedokļa tas ir tā, it kā smēķētājs strādātu ar datu bāzi. Mēs teicām «PARSE EXECUTE DEALLOCATE».
Kāpēc šie liekie statement un to slēgšana? Tie nevienam nav vajadzīgi. Bet parasti tas notiek PreparedStatement, kad mēs tos slēdzam, viņi slēdz visu datu bāzē. Tas nav tas, ko mēs vēlamies.
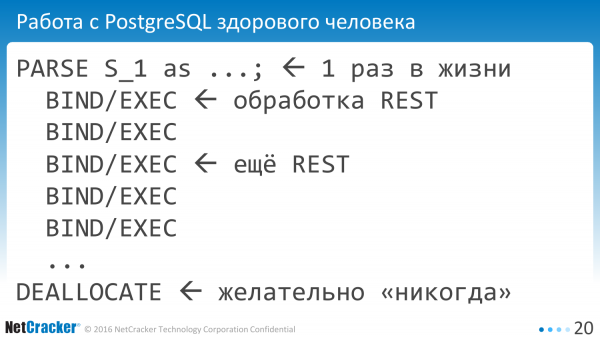
Mēs vēlamies, kā veseli cilvēki, strādāt ar datu bāzi. Vienu reizi sagatavojam mūsu statement, pēc tam to izpildām daudz reižu. Patiesībā daudz reižu – tas ir vienreiz visu dzīvi aplikācijas laikā pārsēti. Un dažādos REST izmantojam to pašu statement id. Tā ir mūsu mērķis.
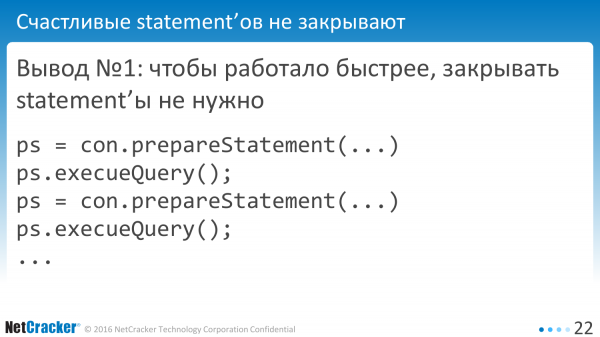
Kā mums to sasniegt?
Ļoti vienkārši – nav nepieciešams slēgt statements. Rakstām šādi: «prepare» «execute».
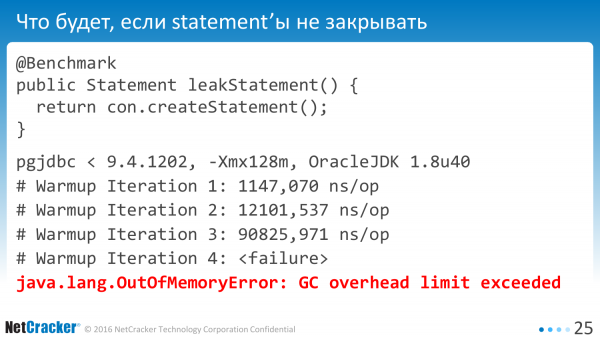
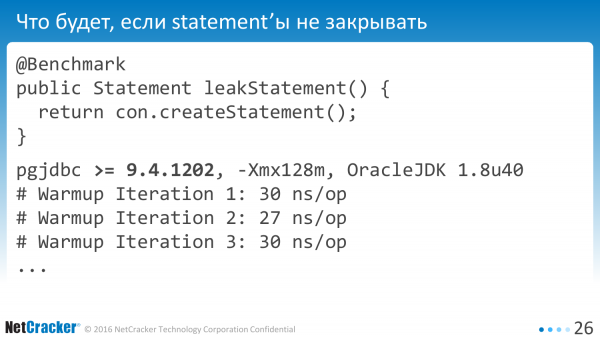
Ja mēs to palaidīsim, tad saprotams, ka kaut kur kaut kas pārsniegs robežu. Ja nesaprotat, to var izmērīt. Mēs ņemsim un uzrakstīsim benchmark, kurā būs šī vienkāršā metode. Izveidojam statement. Palaidīsim uz kādas versijas drivera un iegūstam, ka viņš diezgan ātri avarē, zaudējot visu atmiņu, kas mums bija.
Skaidrs, ka šādas kļūdas ir viegli labojamas. Es par tām nerunāšu. Bet es teikšu, ka jaunā versijā strādā daudz ātrāk. Metode ir neizdevīga, bet tomēr.
Kā strādāt pareizi? Ko mums tam darīt?
Realitātē lietojumprogrammas vienmēr slēdz statements. Visās grāmatās raksta, ka jāslēdz, pretējā gadījumā notiks atmiņas noplūde.
Un PostgreSQL nemāk kešot vaicājumus. Katram sessijai ir pašai jākonstruē šis kešs.
Un laiku tērēt parsēšanai mēs arī nevēlamies.
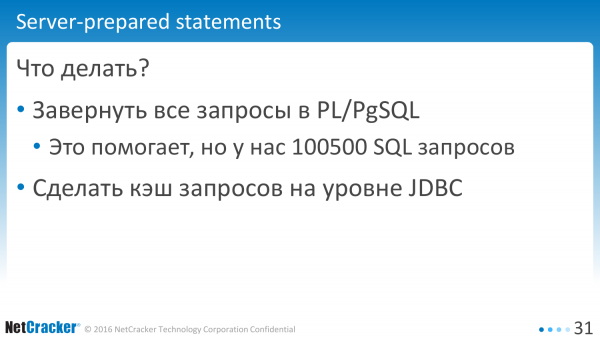
Un, kā parasti, mums ir divi varianti.
Pirmais variants – mēs ņemam un sakām, ka pārvērst visu PgSQL. Tur ir kešatmiņa. Tas visu kešē. Rezultāts būs lielisks. Mēs to esam apskatījuši. Mums ir 100500 pieprasījumu. Tas nestrādā. Mēs neesam apmierināti – pārveidot pieprasījumus manuāli procedūrās. Nē-nē.
Mums ir otrais variants – paņemt un pašiem uztaisīt. Atveram avota kodus, sākam strādāt. Strādājam-strādājam. Izrādījās, ka to izdarīt nemaz nav tik grūti.
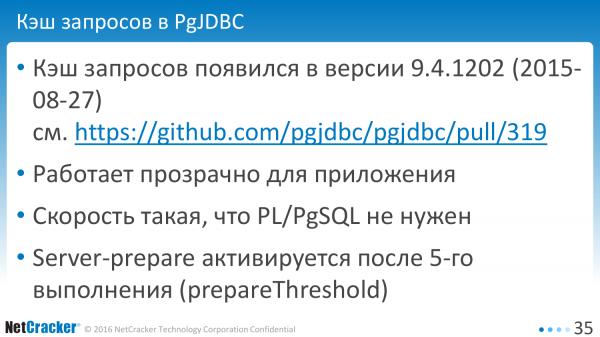
Tas parādījās 2015. gada augustā. Tagad ir jau mūsdienīgāka versija. Un viss ir lieliski. Tas strādā tik labi, ka mēs neko nemainām aplikācijā. Un mēs pat pārtraucām domāt par PgSQL, t.i., mums tā visa ir pietiekami, lai samazinātu visas izmaksas praktiski līdz nullei.
Attiecīgi Server-prepared statements tiek aktivizēts piektajā izpildē, lai netērētu atmiņu datu bāzē katram vienreizējam pieprasījumam.
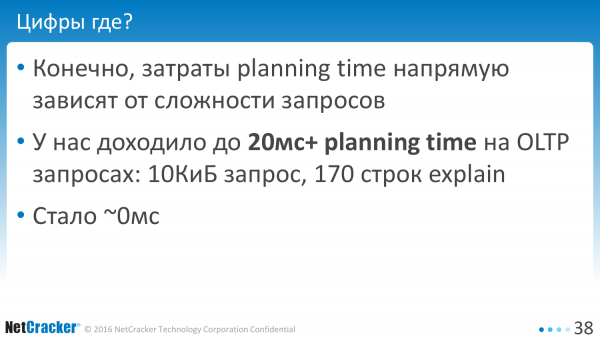
Var jautāt – kur ir skaitļi? Ko jūs iegūstat? Un šeit es skaitļus nedošu, jo katram pieprasījumam tie ir savi.
Mums bija tādi pieprasījumi, ka mēs OLTP pieprasījumos iztērējām apmēram 20 milisekundes parsēšanai. Tur bija 0,5 milisekundes izpildei, 20 milisekundes parsēšanai. Pieprasījums – 10 KiB teksta, 170 rindu plāna. Tas ir OLTP pieprasījums. Tas pieprasa 1, 5, 10 rindas, dažreiz vairāk.
Bet mēs nemaz negribējām tērēt 20 milisekundes. Mēs to samazinājām līdz 0. Viss ir lieliski.
Ko jūs varat secināt no tā? Ja jums ir Java, tad jūs ņemat mūsdienīgu draivera versiju un priecājaties.
Ja jums ir kāda cita valoda, tad padomājiet – varbūt jums tas arī ir nepieciešams? Jo, runājot par galveno valodu, piemēram, ja PL 8 vai jums ir LibPQ, tad jums nav acīmredzami skaidrs, ka jūs tērējat laiku nevis izpildei, bet parsēšanai, un to ir vērts pārbaudīt. Kā? Viss ir bez maksas.
Izņemot to, ka ir kļūdas, dažas īpatnības. Un par tām mēs tagad runāsim. Lielākā daļa būs par rūpniecisko arheoloģiju, par to, ko mēs atradām, uz ko uzgājām.
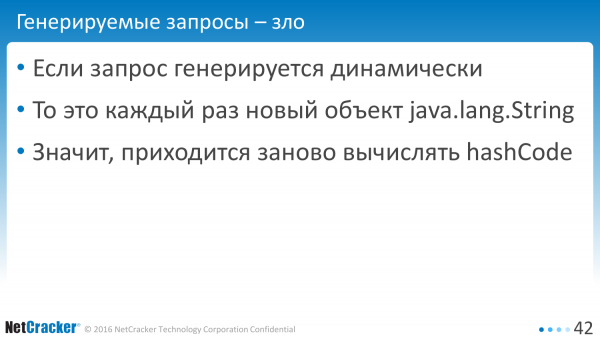
Ja pieprasījums tiek ģenerēts dinamiskā veidā. Tā notiek. Kāds saliek virknes, iznāk SQL pieprasījums.
Kāpēc tas ir slikti? Tas ir slikti, jo katru reizi mēs galu galā iegūstam atšķirīgu virkni.
Ar šiem dažādajiem datiem ir jāskaita hashCode no jauna. Tas patiešām ir CPU uzdevums – atrast garo pieprasījuma tekstu, pat ja mums ir hash, nav nemaz tik viegli. Tāpēc secinājums ir vienkāršs – neradiet pieprasījumus. Glabājiet tos kādā vienā mainīgajā. Un priecājieties.
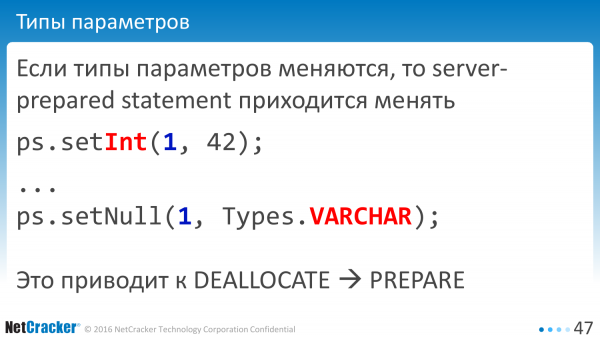
Nākamā problēma. Datentipi ir svarīgi. Ir ORM, kas saka, ka nav svarīgi, kāds ir NULL, lai būtu kaut kāds. Ja tas ir Int, mēs sakām setInt. Bet, ja tas ir NULL, tad lai vienmēr būtu VARCHAR. Un kāda jēga, galu galā, ir tur NULL? Datubāze pati to sapratīs. Un tāda aina nedarbojas.
Praksē datubāzēm pilnīgi nav vienaldzīgi. Ja jūs pirmajā reizē teicāt, ka tas jums ir skaitlis, bet otrajā reizē teicāt, ka tas ir VARCHAR, tad nav iespējams atkārtoti izmantot Server-prepared statements. Un tādā gadījumā mums ir jāizveido mūsu statements no jauna.
Ja jūs izpildāt vienu un to pašu pieprasījumu, jums ir jāpārliecinās, ka datentipi kolonnās nav sajaukti. Jāseko līdzi NULL. Tas ir bieža kļūda, kas mums radās pēc tam, kad sākām izmantot PreparedStatements.
Labi, ieslēdzām. Paņēmām, varbūt, draiveri. Un veiktspēja nokritās. Viss kļuva slikti.
Kā tas var notikt? Vai tā ir kļūda vai funkcija? Diemžēl man neizdevās saprast – vai tā ir kļūda vai funkcija. Bet ir diezgan vienkāršs scenārijs, kā reproducēt šo problēmu. Tā mūs negaidīti pieķēra. Un tā sastāv no izvēles burtiski no vienas tabulas. Mums, protams, tādu pieprasījumu bija vairāk. Tie parasti ietver divas-trīs tabulas, bet ir šāds reproducēšanas scenārijs. Ņemiet kādā jūsu datubāzes versijā un reproducējiet.
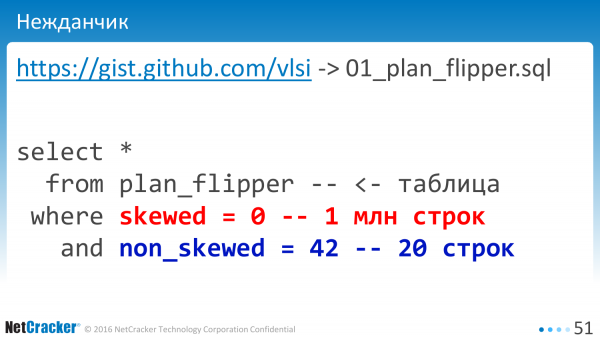
Jēga ir tāda, ka mums ir divas kolonnas, katra no kurām ir indeksēta. Vienā kolonnā pēc NULL vērtības ir miljonu rindu. Bet otrajā kolonnā ir tikai 20 rindu. Kad mēs izpildām bez saistītajiem mainīgajiem, viss darbojas labi.
Ja mēs sāksim izpildīt ar saistītajiem mainīgajiem, t. i., mēs izpildām zīmi «?» vai «$1» mūsu pieprasījumam, tad ko mēs beigās iegūstam?
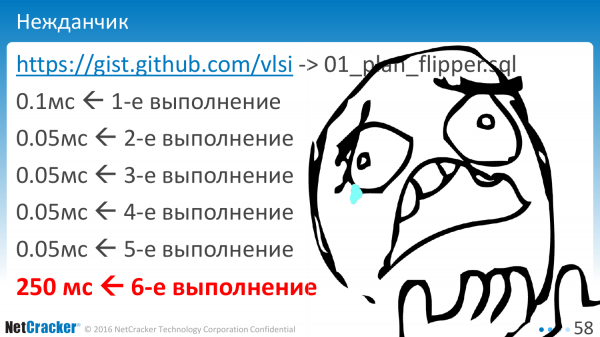
Pirmais izpildījums – kā pienākas. Otrais – nedaudz ātrāk. Daži dati ir kešoti. Trešais, ceturtais, piektais. Pēc tam – hop – un tā kā. Un sliktākā lieta ir, ka tas notiek sestajā izpildījumā. Kurš zināja, ka tieši seši izpildījumi ir nepieciešami, lai saprastu, kāds ir reālais izpildes plāns?
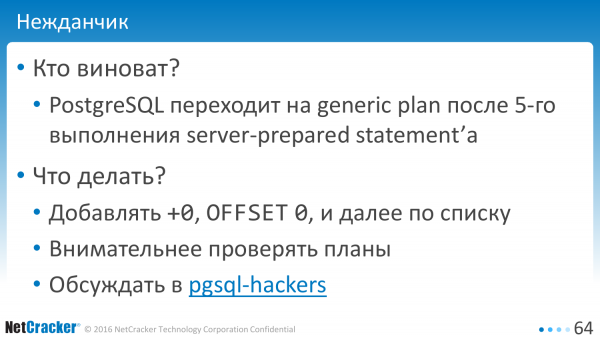
Kas pie vainas? Kas notika? Datu bāze satur optimizāciju. Un tā it kā ir optimizēta vispārīgajam gadījumam. Attiecīgi, sākot no kāda brīža, tā pāriet uz vispārīgu plānu, kas, diemžēl, var izrādīties cits. Tas var būt tāds pats, bet var būt arī cits. Un tur ir kaut kāda sliekšņa vērtība, kas noved pie šāda uzvedības modeļa.
Ko ar to var darīt? Šeit, protams, ir grūtāk kaut ko pieņēmēt. Ir vienkārša risinājuma, ko mēs izmantojam. Tas ir +0, OFFSET 0. Droši vien jums ir pazīstami šādi risinājumi. Mēs vienkārši ņemam un pieprasījumā pievienojam „+0”, un viss ir labi. Rādīšu vēlāk.
Un ir vēl viens variants – uzmanīgāk aplūkot plānus. Izstrādātājam jāspēj ne tikai uzrakstīt pieprasījumu, bet arī 6 reizes teikt „explain analyze”. Ja 5, tad nederēs.
Ir vēl trešais variants – uzrakstīt vēstuli pgsql-hackers. Es uzrakstīju, bet pagaidām nav skaidrs – vai tas ir bug vai feature.
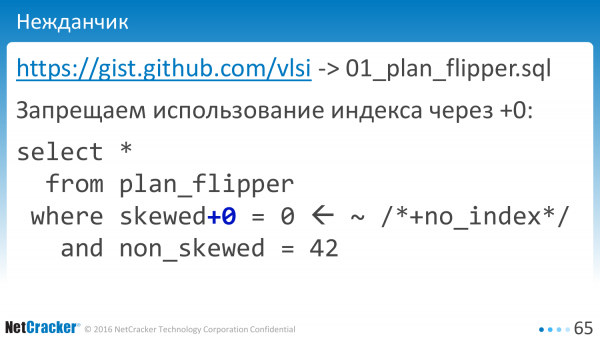
Kamēr mēs domājam – vai tas ir bug vai feature, lai to novērstu. Paņemsim mūsu pieprasījumu un pievienosim „+0”. Viss ir labi. Divi simboli un pat nav jādomā, kā tur ir. Ļoti vienkārši. Mēs vienkārši aizliedzam datu bāzei izmantot indeksu šajā kolonnā. Mums nav indeksa kolonnai „+0” un viss, datu bāze neizmanto indeksu, viss ir labi.
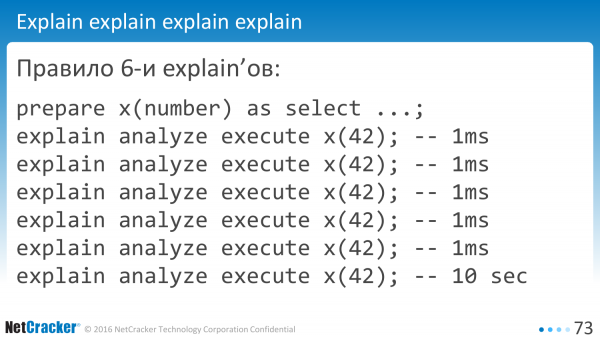
Šis ir 6 „explain” noteikums. Tagad pašreizējās versijās nepieciešams veikt 6 reizes, ja jums ir saistītās mainīgās. Ja nav saistīto mainīgo, tad mēs rīkojamies tā. Galā tieši šis pieprasījums sabrūk. Nekas sarežģīts.
Izklausās, cik ilgi var? Šeit ir bug, tur ir bug. Patiesībā bug ir visur.
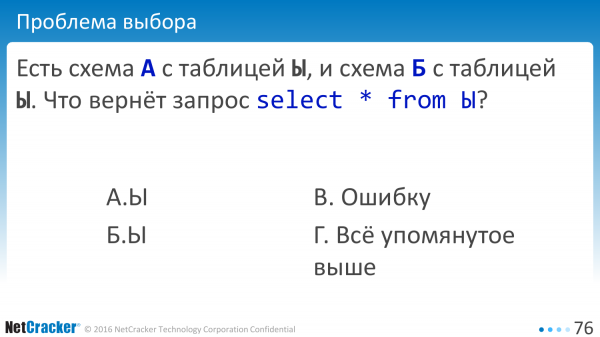
Paskatīsimies vēl. Piemēram, mums ir divas shēmas. Shēma A ar tabulu Y un shēma B ar tabulu Y. Pieprasījums – izvēlēties datus no tabulas. Ko mēs šajā gadījumā saņemsim? Mums būs kļūda. Mums būs viss iepriekš minētais. Noteikums ir tāds – bug visur, mums būs viss iepriekš minētais.
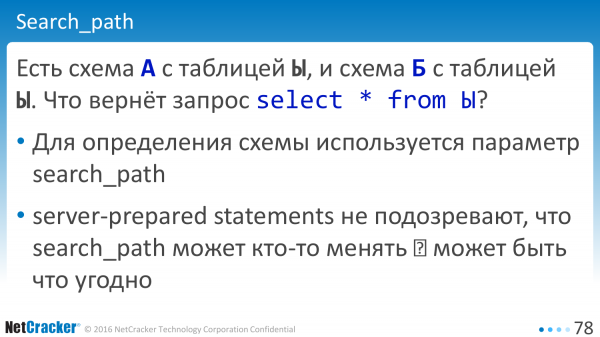
Tagad jautājums: „Kāpēc?”. Izskatās, ka ir dokumentācija, ka, ja mums ir shēma, tad ir mainīgais „search_path”, kas nosaka, kur jāmeklē tabula. Izskatās, ka mainīgais ir.
Kas ir problēma? Problēma ir tāda, ka servera sagatavotie pieprasījumi nepamana, ka search_path var kāds mainīt. Šī vērtība paliek it kā konstanta datu bāzei. Un dažas daļas var nenokļūt pie jaunām vērtībām.
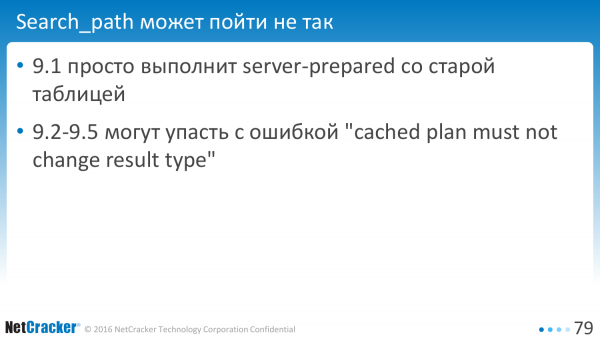
Protams, tas atkarīgs no versijas, kurā jūs veicat testus. Tas ir atkarīgs no tā, cik ļoti atšķiras jūsu tabulas. Versija 9.1 vienkārši izpildīs vecos pieprasījumus. Jaunākās versijas var pamanīt muļķības un teikt, ka jums ir kļūda.
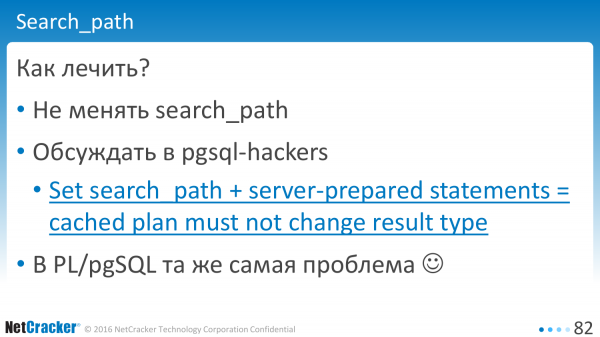
Kā šo atrisināt? Ir vienkārša recepte – nedariet tā. Nav jāmaina search_path lietojumprogrammas darbībā. Ja jūs to maināt, tad labāk izveidojiet jaunu savienojumu.
Varam par to parunāt, t.i., atvērt, apspriest, papildināt. Varbūt pārliecināsim datubāzes izstrādātājus, ka gadījumā, ja kāds maina vērtību, datubāzei par to jāziņo klientam: „Skatieties, jums te vērtība ir atjaunināta. Varbūt jums vajadzētu atiestatīt, pārveidot statements?“. Šobrīd datubāze sevi slēpti uzved un nekādā veidā neziņo, ka kaut kur iekšā statements ir mainījušās.
Un es atkal uzsvēršu – tas nav tipiski Java. Tāpat mēs redzēsim PL/pgSQL vienā un tajā pašā. Bet tur tas tiks atkārtots.
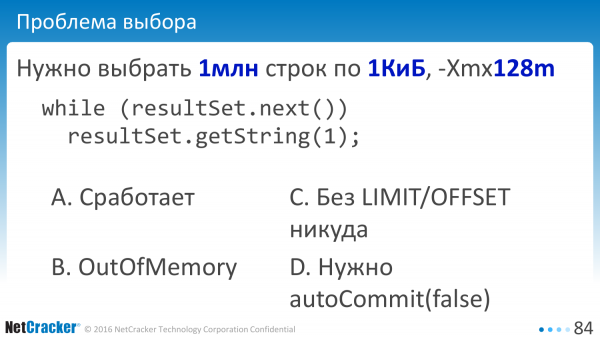
Ļaujiet mums mēģināt vēlreiz izvēlēties datus. Izvēlamies – izvēlamies. Mums ir tabula ar miljonu rindu. Katras rindiņas izmērs ir viens kilobaits. Aptuveni gigabaits datu. Un mums ir darba atmiņa Java mašīnai 128 megabaiti.
Mēs, kā ieteikts visās grāmatās, izmantojam plūsmu apstrādi. T.i., mēs atveram resultSet un pakāpeniski lasām datus no tā. Vai tas darbosies? Vai tas neizkritis no atmiņas? Vai tas lasīs pakāpeniski? Ļausimies ticēt datubāzei, ticēsim Postgres. Neticēsim. Izkritīs OutOFMemory? Kam ir bijusi OutOfMemory? Un kas spēja to salabot? Kāds spēja to salabot.
Ja jums ir miljons rindu, tad nevar vienkārši izvēlēties. Ir obligāti jāizmanto OFFSET/LIMIT. Kas ir par tādu variantu? Un kas par variantu, ka jāspēlējas ar autoCommit?
Šeit, kā parasti, visneparedzamākais variants izrādās pareizs. Un, ja jūs pēkšņi izslēgsiet autoCommit, tas palīdzēs. Kāpēc tā? Par to zinātne nav informēta.
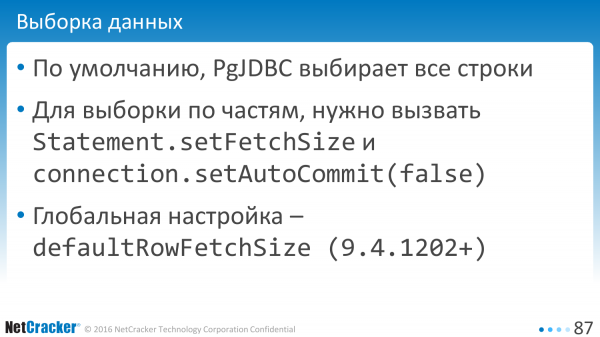
Bet pēc noklusējuma visi klienti, kas pieslēdzas Postgres datubāzei, izvēlas datus pilnībā. PgJDBC šajā ziņā nav izņēmums, izvēlas visas rindas.
Ir variācija par tēmu FetchSize, t.i., var uz atsevišķa statements līmeņa pateikt, ka šeit, lūdzu, izvēlieties datus pa 10, 50. Bet tas nedarbojas, līdz jūs neizslēdziet autoCommit. Nolikts autoCommit – sāk darboties.
Tomēr, staigāt pa kodu un visur iestatīt setFetchSize – tas ir neērti. Tāpēc mēs izveidojām iestatījumu, kas visai savienojumam norāda noklusējuma vērtību.
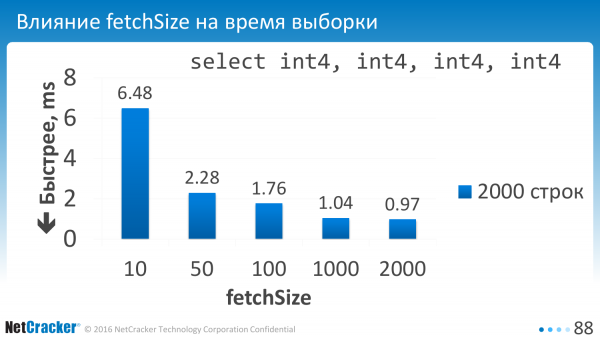
Mēs to esam izteikuši. Iestatījām parametru. Un ko mēs panācām? Ja izvēlamies maz, piemēram, pa 10 rindām, tad mums ir diezgan lielas izmaksas. Tāpēc šai vērtībai jābūt ap simtu.
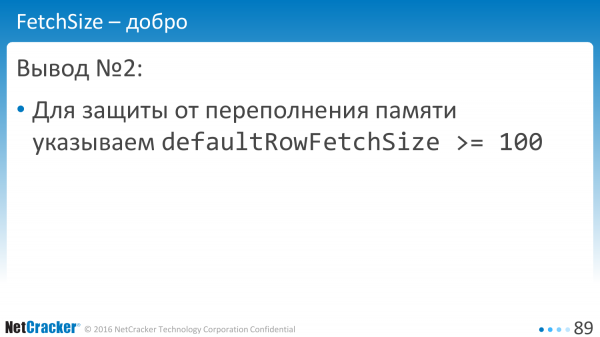
Ideālā gadījumā, protams, arī vajadzētu iemācīties ierobežot byte skaitā, bet recepte ir šāda: iestatām defaultRowFetchSize virs simta un priecājamies.
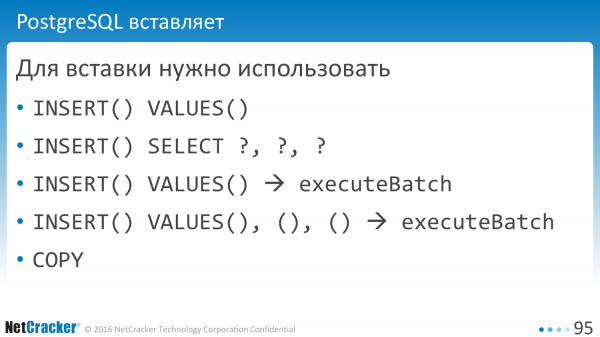
Pārlūkosim datu ievietošanu. Ievietošana ir viegla, tur ir dažādi varianti. Piemēram, INSERT, VALUES. Tas ir labs variants. Var teikt 'INSERT SELECT'. Praksē tas ir tas pats. Nav nekādas atšķirības veiktspējā.
Grāmatas saka, ka jāizpilda Batch statements, grāmatas saka, ka var izpildīt sarežģītākas komandas ar vairākām iekavām. Un Postgres ir lieliska funkcija – var veikt COPY, t. i., darīt to ātrāk.

Ja mēram, var atklāt dažas interesantas lietas. Kā mēs vēlamies, lai tas darbotos? Vēlamies neizpildīt liekas komandas un nepārlūkot.
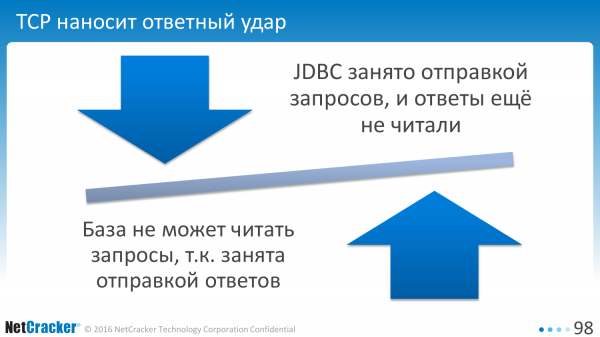
Praksē TCP mums to nedod. Ja klients ir aizņemts ar pieprasījuma sūtīšanu, datubāze, mēģinot nosūtīt mums atbildes, pieprasījumus nenolasīs. Rezultātā klients gaida, kamēr datubāze nolasīs pieprasījumu, un datubāze gaida klientu, kamēr viņš nolasīs atbildi.
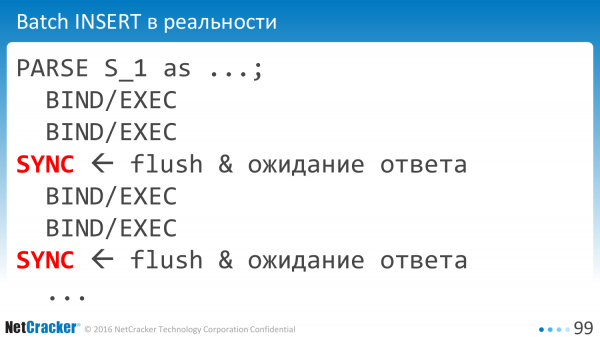
Tāpēc klients spiests regulāri sūtīt sinhronizācijas paketes. Liekas liekas tīkla mijiedarbības, lieka laika zaudēšana.
 Un jo vairāk mēs tās pievienojam, jo sliktāk tas kļūst. Draiveris ir diezgan pesimistisks un pievieno tās samērā bieži, apmēram reizi 200 rindās, atkarībā no rindu izmēra utt.
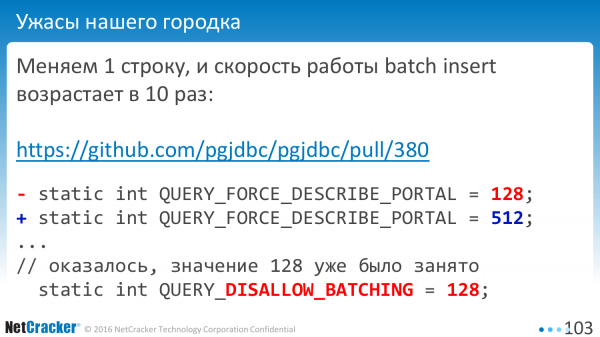
Gadās, ka izlabojat tikai vienu rindu un viss paātrinās desmitkārtīgi. Tas notiek. Kāpēc? Kā parasti, kāda konstante jau bija izmantota. Un vērtība '128' nozīmēja – neizmantot batching.
Labi, ka tas neiekļuva oficiālajā versijā. Mēs to atklājām pirms izlaides. Visas vērtības, ko es minēju, balstās uz mūsdienu versijām.
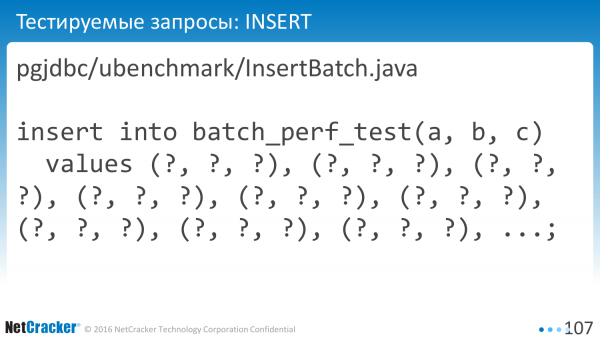
Pārmēram. Mēs mēram InsertBatch vienkārši. Mēs mēram InsertBatch vairākkārtēju, t. i., to pašu, bet vērtību ir daudz. Viltīgs gājiens. Ne visi tā prot, bet tas ir vienkāršs gājiens, krietni vieglāk nekā COPY.
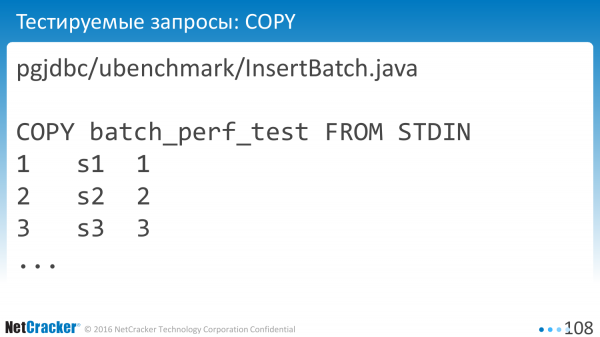
Var veikt COPY.
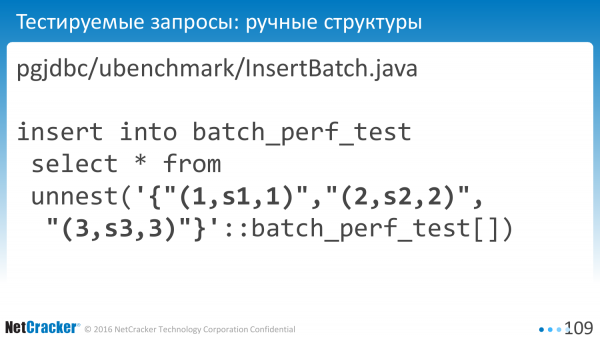
Un var to darīt struktūrās. Paziņojiet par User default type, nododiet masīvu un INSERT tieši tabulā.
Ja atvērsiet saiti: pgjdbc/ubenchmsrk/InsertBatch.java, šis kods ir pieejams GitHub. Varat apskatīt, kādi tieši vaicājumi tiek ģenerēti. Tas nav galvenais.
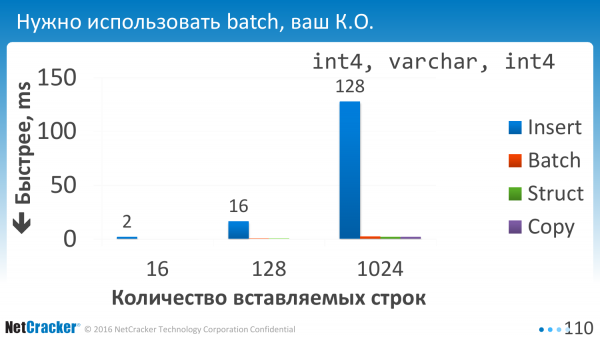
Mēs esam palaiduši. Un pirmais, ko sapratām, ir tas, ka nemitīga grupēšana – tas ir vienkārši nepieņemami. Visi grupēšanas varianti ir vienādi ar nulli, t. i., izpildes laiks praktiski ir vienāds ar nulli salīdzinājumā ar vienreizēju izpildi.
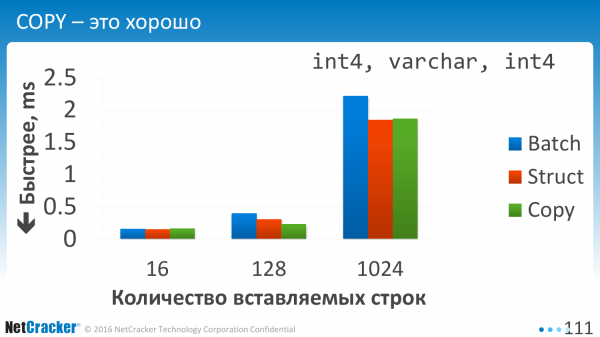
Mēs ievietojam datus. Tur ir ļoti vienkārša tabula. Trīs kolonnas. Un ko mēs šeit redzam? Mēs redzam, ka visi trīs varianti ir aptuveni salīdzināmi. Un COPY, protams, ir labāks.
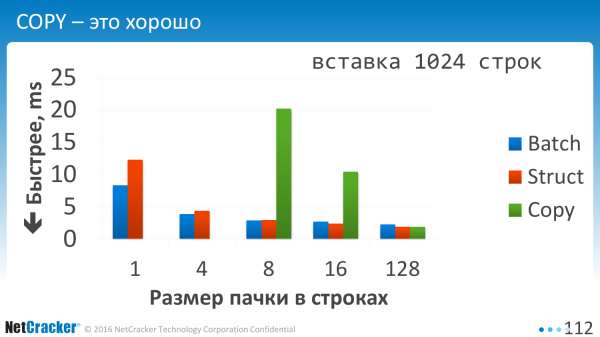
Tas ir tad, kad mēs ievietojam pa daļām. Kad mēs runājām, ka viena vērtība VALUES, divas vērtības VALUES, trīs vērtības VALUES, vai mēs tās 10 norādījām ar komatu. Tas ir tieši šobrīd pa horizontāli. 1, 2, 4, 128. Var redzēt, ka Batch Insert, kas ir attēlots zilajā krāsā, ļoti atvieglo šo uzdevumu. T. i., kad jūs ievietojat pa vienai vai pat kad ievietojat pa četriem, viss kļūst divas reizes labāk, tikai tāpēc, ka mēs VALUES iekļāvām nedaudz vairāk. Mazāk EXECUTE operāciju.
Izmantojot COPY mazajos apjomos – tas ir ārkārtīgi neefektīvi. Es pirmajos divos pat nenorakstīju. Tie iet debesīs, t. i., šie zaļie skaitļi COPY.
COPY jāizmanto, kad jums datu apjoms ir vismaz vairāk nekā simts rindas. Pārliecinošās izmaksas par savienojuma atvēršanu ir lielas. Un, godīgi sakot, šajā virzienā neesmu pētījis. Batch es esmu optimizējis, COPY – nē.
Ko mēs darām tālāk? Mēs izmērām. Saprotam, ka jāizmanto vai nu struktūras, vai arī viltīgs grupējums, kas apvieno vairākas vērtības.
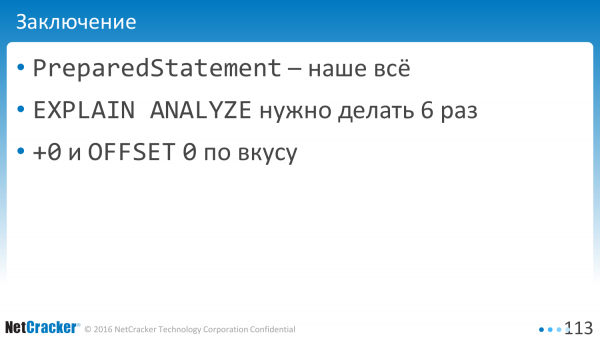
Ko jāizceļ no šodienas ziņojuma?
- PreparedStatement – tas ir viss. Tas sniedz ļoti daudz veiktspējai. Tas dod lielu sīkumainību.
- Un ir jādara EXPLAIN ANALYZE 6 reizes.
- Un ir jāatšķaida OFFSET 0 un triki, piemēram, +0, lai labotu atlikušo procentu no mūsu problemātiskajiem vaicājumiem.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish