

Cienījamie lasītāji, labdien!
Uzdevums veidot IT platformas datu uzkrāšanai un analīzei agrāk vai vēlāk rodas jebkurai uzņēmumam, kura pamatā ir intelektuāli prasīga pakalpojumu sniegšanas modeļa vai tehniski sarežģītu produktu izstrāde. Analītisko platformu veidošana ir sarežģīts un darbietilpīgs uzdevums. Tomēr jebkuru uzdevumu var vienkāršot. Šajā rakstā vēlos dalīties pieredzē par low-code rīku izmantošanu, kas palīdz analītisko risinājumu izveidošanā. Šī pieredze tika iegūta, īstenojot vairākus projektus Big Data Solutions virzienā uzņēmumā „Neoflex”. Big Data Solutions virziens uzņēmumā „Neoflex” kopš 2005. gada risina datu noliktavu un datu ezeru izveides jautājumus, optimizē informācijas apstrādes ātrumu un strādā pie datu kvalitātes vadības metodoloģijas.
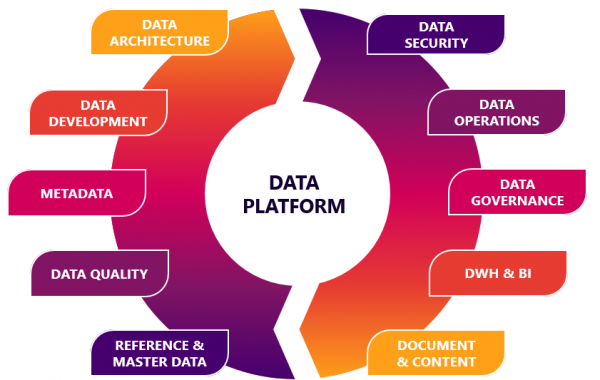
Novērst apzinātu vāji un/vai spēcīgi strukturētu datu uzkrāšanu nesekmēs neviens. Varbūt pat tad, ja runa ir par mazo biznesu. Galu galā, paplašinoties uzņēmumam, izdevīgs uzņēmējs saskarsies ar lojalitātes programmu izstrādes jautājumiem, vēlas analizēt tirdzniecības punktu efektivitāti, domās par mērķtiecīgo reklāmu un uztrauksies par pieprasījumu pēc blakusproduktiem. Pirmajā pieejā uzdevumu var risināt “uz ceļiem”. Bet uzņēmuma izaugsmes gadījumā pāreja uz analītisko platformu tomēr ir neizbēgama.
Bet kad analīzes uzdevumi var pārvērsties par tādiem, kas ir „Raķešu zinātne”? Varbūt tad, kad runa ir par patiešām lieliem datiem.
Lai vienkāršotu «Raķešu zinātnes» uzdevumu, var ēst ziloņus pa daļām.
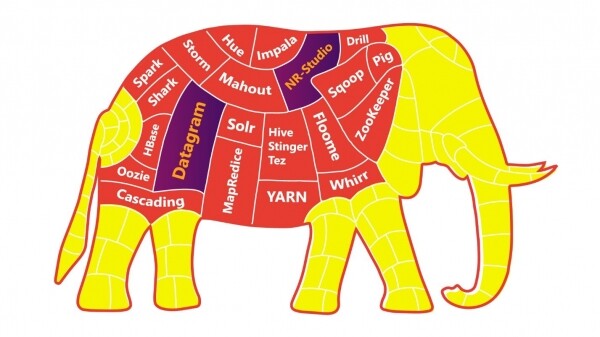
Jo lielāka būs jūsu lietojumprogrammu/pakalpojumu/mikropakalpojumu diskretizācija un autonomija, jo vieglāk būs jums, jūsu kolēģiem un visam biznesam pārstrādāt ziloņus.
Šādam postulatam piekrita praktiski visi mūsu klienti, pārveidojot ainavu, balstoties uz inženierijas prakses DevOps komandām.
Bet pat pie „šķirtas, ziloņu” diētas mums ir labi izredzes uz „pārslodzi” IT ainavā. Šajā brīdī ir vērts apstāties, izelpot un paskatīties virzienā uz low-code inženieru platforma.
Daudziem izstrādātājiem ir bail no perspektīvas iestigt karjerā, pārejot no tiešas kodēšanas uz «vilkšanas» saskarnēm zemu kodēšanas sistēmās. Tomēr mašīnu rašanās nenozīmēja inženieru izzušanu, bet gan izvirzīja viņu darbu jaunā līmenī!
Apskatīsim, kāpēc.
Datu analīze loģistikas jomā, telekomunikāciju nozarē, mediju pētījumos un finanšu sektorā vienmēr ir saistīta ar šādiem jautājumiem:
- Automatizētās analīzes ātrums;
- Eksperimentu veikšanas iespēja bez ietekmes uz datu pamatprodukcijas plūsmu;
- Sagatavoto datu uzticamība;
- Izmaiņu uzraudzība un versiju kontrole;
- Datu izcelsme, Datu izsekošana, CDC;
- Jaunu funkciju piegādes ātrums uz produkcijas vidi;
- Un slavenā: izstrādes un atbalsta izmaksas.
Tas nozīmē, ka inženieriem ir milzīgs skaits augstākā līmeņa uzdevumu, kurus efektīvi izpildīt var tikai attīrot prātu no zema līmeņa izstrādes uzdevumiem.
Jaunā līmeņa pārejai izstrādātājiem par iemeslu kalpoja biznesa evolūcija un digitalizācija. Izstrādātāja vērtība arī ir mainījusies: ir liels trūkums speciālistiem, kuri spēj iedziļināties automatizējamā biznesa būtībā.
Veiksim analoģiju starp zema un augsta līmeņa programmēšanas valodām. Pāreja no zemu līmeņu valodām uz augstu līmeņu valodām ir pāreja no ‘tiešām norādēm uz dzelžu valodu’ uz ‘norādēm cilvēku valodā’. Tātad, pievienojot noteiktu abstrakcijas slāni. Šādā gadījumā pāreja uz low-code platformām no augsta līmeņa programmēšanas valodām ir pāreja no ‘norādēm cilvēku valodā’ uz ‘norādēm biznesa valodā’. Ja atradīsies izstrādātāji, kurus šis fakts sarūgtinās, tad viņi, iespējams, ir sarūgtināti jau kopš brīža, kad radās Java Script, kurā tiek izmantotas masīvu šķirošanas funkcijas. Un šīs funkcijas, protams, satur citu augsta līmeņa programmēšanas līdzekļu programmatisko īstenojumu.
Tādējādi low-code ir tikai vēl viena abstrakcijas līmeņa parādīšanās.
Praktiskā pieredze low-code izmantošanā
Low-code tēma ir salīdzinoši plaša, taču šobrīd vēlētos pastāstīt par pielietojumu „mazkoda koncepcijām”, izmantojot vienu no mūsu projektiem kā piemēru.
Uzņēmuma «Neoflex» Big Data Solutions nodaļa galvenokārt specializējas finanšu sektora biznesā, veidojot datu noliktavas un datu ezerus, kā arī automatizējot dažādas atskaites. Šajā nišā low-code izmantošana jau sen ir kļuvusi par standartu. Starp citiem low-code rīkiem var pieminēt ETL procesu organizēšanas līdzekļus: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Vai arī Oracle Apex, kas darbojas kā ātrās izstrādes vide datu piekļuves un rediģēšanas saskarnēm. Tomēr mazkoda izstrādes rīku izmantošana ne vienmēr ir saistīta ar šauru komerciālā tehnoloģiju kaudzi balstītu lietojumprogrammu izstrādi ar acīmredzamu atkarību no piegādātāja.
Izmantojot low-code platformas, ir iespējams arī organizēt datu plūsmu orķestrāciju, izveidot datu zinātnes platformas vai, piemēram, moduļus datu kvalitātes pārbaudei.
Viena no praktiskām mazkoda izstrādes pieredzes lietošana ir sadarbība starp «Neoflex» un uzņēmumu Mediascope, kas ir viens no Krievijas mediju pētījumu tirgus līderiem. Šīs uzņēmuma biznesa uzdevums ir ražot datus, uz kuru pamata reklāmdevēji, interneta platformas, televīzijas kanāli, radio stacijas, reklāmas aģentūras un zīmoli pieņem lēmumus par reklāmas iegādi un plāno savas mārketinga komunikācijas.
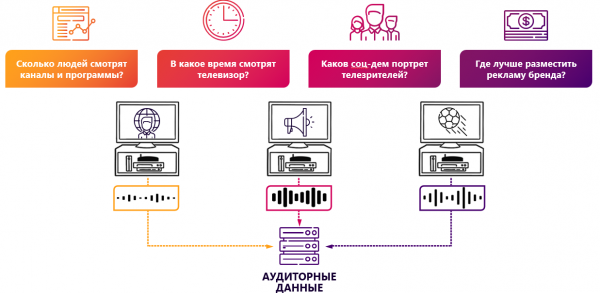
Mediapētniecība ir tehnoloģiski prasīga biznesa joma. Video atpazīšana, datu vākšana no ierīcēm, kas analizē skatījumu, aktivitātes mērīšana tīmekļa resursos — viss tas prasa uzņēmumam lielu IT komandu un milzīgu pieredzi analītisko risinājumu izstrādē. Tomēr eksponenciāls informācijas apjoma, avotu skaita un to dažādības pieaugums liek IT datu nozarei pastāvīgi attīstīties. Viegla pieeja esošās analītiskās platformas Mediascope paplašināšanai varētu būt IT darbinieku skaita palielināšana. Taču daudz efektīvāks risinājums ir izstrādes procesa paātrināšana. Viens no soļiem, kas ved šajā virzienā, varētu būt low-code platformu izmantošana.
Projekta sākumā uzņēmumam jau bija funkcionējošs produktu risinājums. Tomēr risinājuma īstenošana uz MSSQL nevarēja pilnībā atbilst gaidām par funkcionalitātes paplašināšanu, saglabājot pieņemamu izmaksu līmeni uzlabojumiem.
Uzdevums, kas mums bija izvirzīts, bija patiešām ambiciozs – Neoflex un Mediascope bija jākļūst par rūpniecisku risinājumu, ko izstrādāt mazāk nekā gada laikā, ar nosacījumu, ka MVP tiks izlaists jau pirmajā ceturksnī no darba sākuma datuma.
Jaunas datu platformas, balstītas uz low-code aprēķiniem, izveidei tika izvēlēts tehnoloģiju steks Hadoop. Datu glabāšanas standarts kļuva par HDFS, izmantojot parquet formāta failus. Pieejai datiem, kas atrodas platformā, tika izmantots Hive, kur visi pieejamie skati ir attēloti kā ārējās tabulas. Datu ielāde glabātavā tika realizēta ar Kafka un Apache NiFi palīdzību.
Low-code rīks šajā koncepcijā tika izmantots, lai optimizētu visdarba intensīvāko uzdevumu analītiskās platformas izveidē – datu aprēķinu uzdevumu.
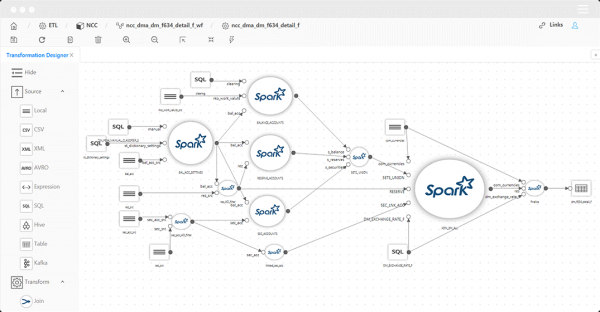
Galvenais mehānisms datu kartēšanai bija izvēlēts low-code rīks Datagram. Neoflex Datagram ir līdzeklis datu transformāciju un plūsmu izstrādei.
Izmantojot šo rīku, var iztikt bez manuālas Scala kodēšanas. Scala kods tiek automātiski ģenerēts, izmantojot Model Driven Architecture pieeju.
Acīmredzama šādas pieejas priekšrocība ir izstrādes procesa paātrināšana. Tomēr, papildus ātrumam, ir arī citas priekšrocības:
- Izvārīšanas un strukturēšanas avotu/saņēmēju skatīšana;
- Datu plūsmu objektu izcelsmes izsekošana līdz atsevišķiem laukiem (lineage);
- Daļēja transformāciju izpilde ar starpposma rezultātu skatīšanu;
- Apgūstot avota kodu un tā koriģēšanu pirms izpildes;
- Automātiska transformāciju validācija;
- Automātiska datu ielāde 1 pret 1.
Iekļūšanas slieksnis low-code risinājumos transformāciju ģenerēšanai ir pietiekami zems: izstrādātājam ir jāzina SQL un jābūt pieredzei darbā ar ETL rīkiem. Tomēr jānorāda, ka code-driven transformāciju ģeneratori nav ETL rīki plašākā šī vārda nozīmē. Low-code rīki var arī nepietiekt savu vidi koda izpildei. Tas nozīmē, ka ģenerētais kods tiks izpildīts tajā vidē, kas bija klasterī vēl pirms low-code risinājuma instalācijas. Un tas, iespējams, ir vēl viens pluss low-code. Tā kā paralēli low-code komandai var strādāt 'klasiskā' komanda, kas īsteno funkcionalitāti, piemēram, uz tīra Scala koda. Abu komandu izstrādājumu iekļaušana produkcijā būs vienkārša un 'bezšuvju'.
Iespējams, vērts pieminēt, ka papildus low-code risinājumiem ir arī no-code risinājumi. Un būtībā tās ir atšķirīgas lietas. Low-code vairāk ļauj izstrādātājam iejaukties ģenerētajā kodā. Datagram gadījumā ir iespējama ģenerētā Scala koda apskate un rediģēšana, savukārt no-code šādu iespēju var nepiedāvāt. Šī atšķirība ir ļoti būtiska ne tikai risinājuma fleksibilitātes ziņā, bet arī komforta un motivācijas ziņā datu inženieru darbā.
Risinājuma arhitektūra
Pamēģināsim noskaidrot, kā tieši low-code rīks palīdz risināt uzdevumu optimizēt datu aprēķina funkcionalitātes izstrādes ātrumu. Sāksim ar sistēmas funkcionālo arhitektūru. Šajā gadījumā piemērs ir datu ražošanas modelis mediju pētījumiem.
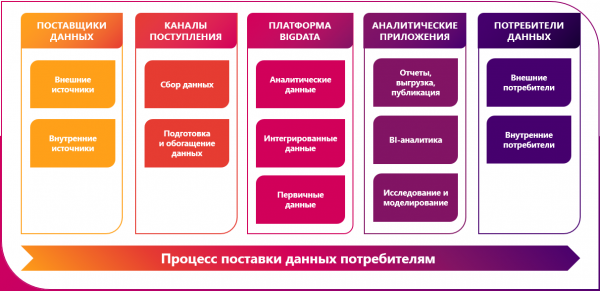
Datu avoti mūsu gadījumā ir ļoti dažādi un daudzveidīgi:
- Piplmetri (TV metri) ir programmatūru un aparatūru ierīces, kas lasa lietotāju uzvedību respondentiem televīzijas panelī – kurš, kad un kuru kanālu skatījās mājsaimniecībā, kas piedalās pētījumā. Nodrošinātā informācija ir skatīšanās intervālu plūsma, kas saistīta ar mediju paketi un mediju produktu. Dati ielādes posmā var tikt bagātināti ar demogrāfiskiem atribūtiem, ģeogrāfisko saistību, laika zonu un citu informāciju, kas nepieciešama televīzijas skatījuma analīzei par noteikto mediju produktu. Veiktie mērījumi var tikt izmantoti reklāmas kampaņu analīzei vai plānošanai, auditorijas aktivitātes un priekšroku novērtēšanai, kā arī ētera plāna sastādīšanai;
- Dati var tikt saņemti no tiešraides televīzijas monitoringa sistēmām un video resursu satura skatīšanās mērīšanas sistēmām internetā;
- Mērīšanas rīki tīmekļa vidē, tostarp gan site-centric, gan user-centric skaitītāji. Datu piegādātājs Data Lake var būt pārlūkprogrammas spraudnis research bar un mobilā lietotne ar iebūvētu VPN.
- Dati var arī nākt no platformām, kas konsolidē rezultātus no interneta anketu aizpildīšanas un telefona interviju rezultātiem uzņēmuma pētījumos;
- Papildu datu ezera bagātināšana var notikt, iekraujot informāciju no partneru uzņēmumu žurnāliem.
Implmentācija as is ielādēšanai no avota sistēmām primārajā staging neapstrādātos datos var tikt organizēta dažādos veidos. Ja šim mērķim izmanto low-code, iespējama automātiska ielādes scenāriju ģenerācija, pamatojoties uz metadatiem. Tajā pašā laikā nav nepieciešams iedziļināties source to target mapejumā. Lai īstenotu automātisko ielādi, mums ir nepieciešams izveidot savienojumu ar avotu, pēc tam noteikt ielādes interfeisā ielādējamo entitāšu sarakstu. Katalogu struktūras izveide HDFS notiks automātiski un atbilsts datu uzglabāšanas struktūrai avota sistēmā.
Tomēr šī projekta kontekstā mēs nolēmām neizmantot šo low-code platformas funkcionalitāti, jo uzņēmums Mediascope jau ir sācis darbu pie līdzīga pakalpojuma izstrādes, izmantojot Nifi + Kafka.
Jānorāda, ka šie rīki nav savstarpēji aizvietojami, bet drīzāk papildina viens otru. Nifi un Kafka spēj darboties gan tiešā (Nifi -> Kafka), gan pretējā (Kafka -> Nifi) savienojumā. Mediju pētījumu platformā tika izmantots pirmais savienojuma variants.
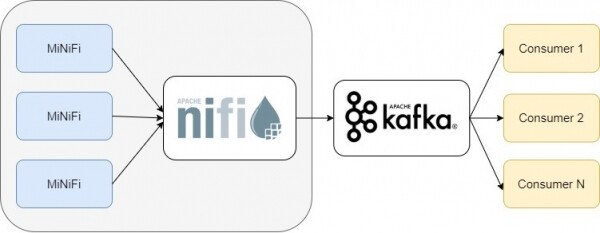
Mūsu gadījumā Nifi jāapstrādā dažāda veida dati no avota sistēmām un jāpārsūta tos Kafka brokerim. Šajā gadījumā ziņojumu virzīšana uz noteiktu Kafka tēmu notika, izmantojot Nifi procesorus PublishKafka. Šo pipeline'u orķestrācija un apkalpošana tiek veikta vizuālajā interfeisā. Rīks Nifi un Nifi + Kafka izmantošana arī tiek dēvēta par low-code pieeju izstrādei, kas nodrošina zemu piekļuves slieksni Big Data tehnoloģijām un paātrina lietojumprogrammu izstrādes procesu.
Nākamais posms projekta īstenošanā bija detalizēto datu formāta pārvēršana vienotajā semantiskajā slānī. Ja entitātei ir vēsturiskie atribūti, aprēķins tiek veikts attiecīgās partijas kontekstā. Ja entitāte nav vēsturiska, tad opcijas ir vai nu veikt visu objekta saturu pārrēķinus, vai arī pilnībā atteikties no pārrēķina (laikā, kad pārmaiņu nav). Šajā posmā tiek ģenerētas atslēgas visām entitātēm. Atslēgas tiek saglabātas atbilstošajos Hbase meistara objektu katalogos, kas satur atslēgu atbilstību analītiskajā platformā un avota sistēmu atslēgām. Atomāro entitāšu konsolidācija tiek papildināta ar iepriekšēju analītisko datu aprēķinu rezultātiem. Datu aprēķinu ietvars bija Spark. Aprakstītais funkcionalitāte datu pārvēršanai vienotā semantiskā slānī tika realizēta arī, balstoties uz low-code rīka Datagram mappingiem.
Mērķu arhitektūrā bija jānodrošina SQL piekļuve datiem biznesa lietotājiem. Šai opcijai tika izmantots Hive. Objekti Hive tiek reģistrēti automātiski, ieslēdzot opciju „Registr Hive Table” low-code rīkā.
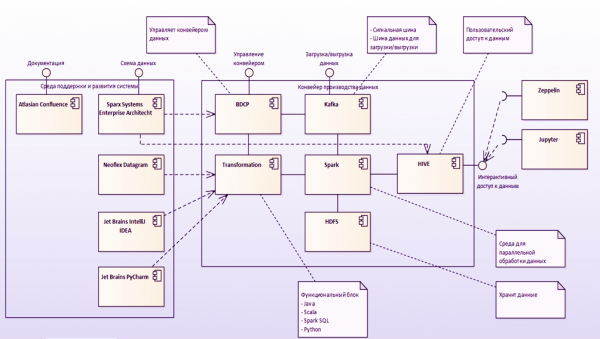
Aprēķinu plūsmas pārvaldība
Datagram ir saskarne, kas ļauj veidot workflow dizainu. Mapējumu izpildi var veikt, izmantojot Oozie plānotāju. Izstrādātāja saskarnē ir iespējams veidot shēmas paralēlai, secīgai vai nosacījumos atkarīgai datu transformāciju izpildei. Ir atbalsts shell skriptiem un Java programmām. Tāpat ir iespējams izmantot serveris Apache Livy. Apache Livy tiek izmantots, lai uzsāktu lietojumprogrammas tieši no izstrādes vides.
Ja uzņēmumam jau ir sava procesu orķestratora sistēma, ir iespējams izmantot REST API, lai integrētu mapējumus jau esošajā plūsmā. Piemēram, mums bija diezgan veiksmīga pieredze Scala mapējumu iekļaušanā orķestratoros, kas tika rakstīti PLSQL un Kotlin. REST API zema koda rīks ietver tādas operācijas kā izpildāmā gada ģenerēšana, pamatojoties uz mapējuma dizainu, mapējuma izsaukšana, mapējumu secības izsaukšana un, protams, parametru nodošana URL mapējumu izsaukšanai.
Vēl kopā ar Oozie ir iespējams organizēt aprēķinu plūsmu, izmantojot Airflow. Varbūt nesniegšu detalizētu salīdzinājumu starp Oozie un Airflow, bet teikšu, ka šī projekta mediju izpētes kontekstā izvēle krita uz Airflow. Galvenie argumenti šoreiz bija aktīvāka kopiena, kas attīsta produktu, un attīstītāka saskarne + API.
Airflow ir arī labs, jo procesus tajā apraksta daudziem mīļais Python. Un faktiskā, ar atvērtā koda workflow vadības platformu nav daudz. Procesu izpildes uzsākšana un uzraudzība (tai skaitā ar Ganta diagrammu) tikai piešķir papildu punktus Airflow karma.
Zema kodu risinājuma mapējumu palaišanas konfigurācijas faila formāts ir spark-submit. Tas notika divu iemeslu dēļ. Pirmais, spark-submit ļauj tieši palaist jar failu no konsoles. Otrkārt, tas var saturēt visu nepieciešamo informāciju, lai konfigurētu darba plūsmu (kas atvieglo DAG veidošanas skriptu rakstīšanu).
Visbiežāk sastopamais Airflow darba plūsmas elements mūsu gadījumā ir SparkSubmitOperator.
SparkSubmitOperator ļauj palaiž jar failus — iepakotus Datagram mapējumus ar iepriekš sagatavotiem izejas parametriem.
Jāatzīmē, ka katra Airflow uzdevums tiek izpildīts atsevišķā pavedienā un neko nezina par citiem uzdevumiem. Tādējādi mijiedarbība starp uzdevumiem notiek, izmantojot vadības operatorus, piemēram, DummyOperator vai BranchPythonOperator.
Kopumā low-code risinājuma Datagram izmantošana kopā ar konfigurācijas failu universālizāciju (kuri veido Dag) ir ievērojami paātrinājusi un vienkāršojusi datu ielādes plūsmu izstrādes procesu.
Vitrīnu aprēķins
Iespējams, visinteliģentākais posms analītisko datu ražošanā ir vitriņu izveidošanas solis. Konteksta ietvaros vienā no datu aprēķina plūsmām pētniecības uzņēmumā šajā posmā notiek pielāgošana uz etalona translāciju, ņemot vērā laikapstākļu labojumus saistībā ar raidīšanas režģi. Tāpat iespējama korekcija uz vietējo ēterisko režģi (vietējās ziņas un reklāma). Starp citu, šajā posmā tiek veikta nepārtrauktās skatīšanās pārrakstīšana, pamatojoties uz skatīšanās intervālu analīzi. Šeit arī notiek
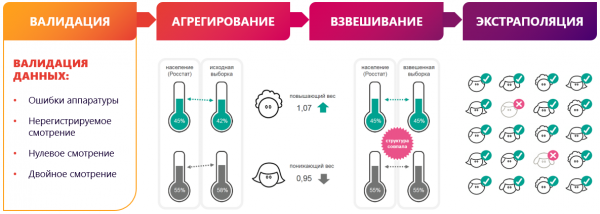
Vitrīnu sagatavošanas atsevišķais solis ir datu validācija. Validācijas algoritms saistīts ar virkni matemātisko zinātnes modeļu. Tomēr low-code platformas izmantošana ļauj sadalīt sarežģīto algoritmu vairākos atsevišķos vizuāli lasāmos mappilnos. Katrs no mappilno veic šauru uzdevumu. Tādējādi ir iespējama starpposma debagēšana, žurnālfailu izveide un sagatavošanas posmu vizualizācija.
Lēmums par validācijas algoritma diskrēti sadalīšanu šādās apakšposmās:
- Reģionā esošās televīzijas tīkla skatīšanās regresiju cēloņu būvēšana, pamatojoties uz visu tīklu reģionā skatīšanos pēdējo 60 dienu laikā.
- Skitizēto atlikumu (noviržu starp faktiskajām un regresijas modeļa prognozētajām vērtībām) aprēķins visām regresijas punktēm un aprēķinu dienai.
- Aizdomīgu reģiona-televīzijas tīkla pāru atlase, kur skitizētais atlikums aprēķinu dienā pārsniedz normu (kura noteikta operācijas konfigurācijā).
- Apskaičītais studentizētais atlikums par anomālajām pāru reģions-tīkla kombinācijām katram respondentu, kurš skatījās tīklu reģionā, nosakot šī respondenta ieguldījumu (izmaiņu apmērs studentizētajā atlikumā), izslēdzot šo respondentu no parauga.
- Kandidātu meklēšana, kuru izslēgšana normalizē apskaičīto dienas studentizēto atlikumu.
Iepriekš minētais piemērs apstiprina hipotēzi, ka datu inženieriem jau ir pārāk daudz, kas jāzina... Un, ja tas tiešām ir "inženieris", nevis "kodētājs", tad profesionālās degradācijas bailes, izmantojot zema koda rīkus, viņam būtu jāatzīst.
Ko vēl var darīt ar zema koda rīkiem?
Zema koda rīka pielietojuma joma partiju un straumēšanas datu apstrādei bez nepieciešamības roku rakstīt kodu uz Scala nebeidzas.
Zema koda izmantošana datu ezeru izstrādē ir kļuvusi par standartu. Var teikt, ka risinājumi uz Hadoop steka atkārto klasisko DWH attīstības ceļu, kas balstās uz RDBMS. Zema koda rīki uz Hadoop steka var risināt gan datu apstrādes, gan gala BI interfeisu izveides uzdevumus. Jāpiebilst, ka BI var ietvert ne tikai datu attēlošanu, bet arī to rediģēšanu, ko veic biznesa lietotāji. Mēs bieži izmantojam šo funkcionalitāti analītisko platformu izveidē finanšu sektoram.
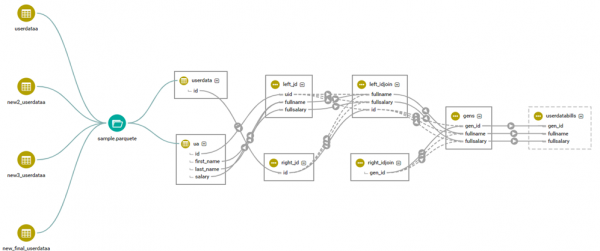
Starp citu, izmantojot low-code un, konkrēti, Datagram, ir iespējams risināt datu plūsmas objekta izcelsmes izsekošanas uzdevumu ar atomiskumu līdz atsevišķām laukiem (lineage). Lai to izdarītu, low-code rīkā ir ieviesta saistīšanās ar Apache Atlas un Cloudera Navigator. Patiesībā izstrādātājam ir jāreģistrē objektu komplekts Atlas vārdnīcās un jāsniedz atsauce uz reģistrētajiem objektiem, veidojot mapējumu. Datu izcelsmes izsekošanas mehānisms vai atkarību analīze palīdz ietaupīt daudz laika, veicot izmaiņas aprēķinu algoritmos. Piemēram, veidojot finanšu pārskatu, šī funkcija ļauj ērtāk izturēt likumdošanas izmaiņu periodus. Jo kvalitatīvāk mēs apzinām savstarpējās atkarības detaļu slānī, jo mazāk saskarsimies ar „pēkšņajām” defektēm un samazināsim pārrakstīšanas skaitu.
Datu kvalitāte un low-code
Vēl viens uzdevums, kas tika realizēts low-code rīkā Mediascope projektā, bija datu kvalitātes uzdevums. Iespēja veikt datu pārbaudes konveijeru bija tāda, ka tas neietekmēja galvenā datu aprēķina plūsmas darbību un ātrumu. Lai varētu organizēt neatkarīgas datu pārbaudes plūsmas, tika izmantots jau pazīstamais Apache Airflow. Katram datu ražošanas soļam gatavojoties, paralēli tika uzsākta atsevišķās DQ konveijera daļas palaišana.
Laba prakse tiek uzskatīta par datu kvalitātes uzraudzību kopš to rašanās brīža analītiskajā platformā. Iegūstot metadatu informāciju, jau sākotnējā slānī varam pārbaudīt pamata nosacījumu ievērošanu — not null, constraints, foreign keys. Šī funkcionalitāte tiek realizēta, pamatojoties uz automātiski ģenerētiem data quality mapējumiem Datagram. Kodu ģenerēšana šajā gadījumā arī balstās uz modeļa metadatiem. Mediascope projektā saistīšanās notika ar produktu Enterprise Architect metadatiem.
Pateicoties low-code rīka un Enterprise Architect saistīšanai, automātiski tika ģenerētas šādas pārbaudes:
- Pārbaude par null vērtību klātbūtni laukos ar not null modifikatoru;
- Pārbaude par primārā atslēgas dublikātu klātbūtni;
- Ārējo atslēgu pārbaude entitātē;
- Rinda unikāluma pārbaude pēc lauku komplekta.
Sarežģītāku datu pieejamības un uzticamības pārbaudei tika izveidots mape ar Scala izteiksmēm, kas pieņem ārējo Spark SQL pārbaudes kodu, ko sagatavojuši analītiķi programmatūrā Zeppelin.
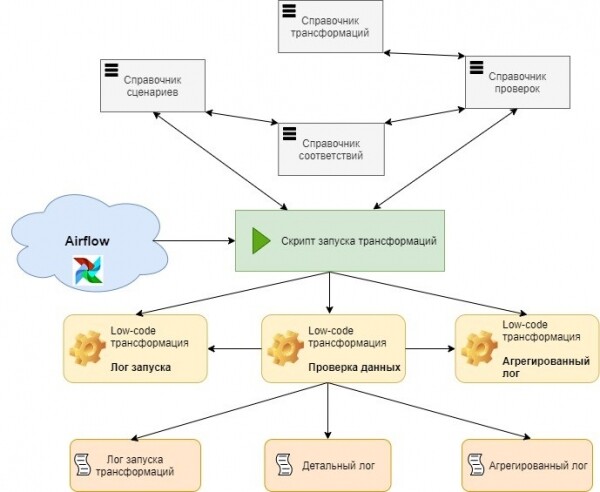
Protams, automātiskajai pārbaudei jānāk pakāpeniski. Šī projekta ietvaros tika veikti sekojoši soļi:
- DQ, kas realizēta Zeppelin bloknotos;
- DQ, kas iebūvēta mapē;
- DQ kā atsevišķi masīvi mape, kas satur veselu pārbaudes komplektu atsevišķai entitātei;
- Universāli parametrizētie DQ mape, kas pieņem metadatu un biznesa pārbaudes informāciju.
Galvenā priekšrocība, izveidojot parametrizētu pārbaudes pakalpojumu, ir laika ietaupījums funkcionalitātes piegādē ražošanas vidē. Jaunas kvalitātes pārbaudes var apiet klasisko koda piegādes modeli caur izstrādes un testēšanas vidēm:
- Visas metadatu pārbaudes tiek automātiski ģenerētas, mainoties modelim EA;
- Datu pieejamības pārbaudes (determinizējot, vai ir kādi dati konkrētā laikā) var tikt ģenerētas, pamatojoties uz katalogu, kas satur gaidāmo datu parādīšanās laiku pa objektiem;
- Biznesa datu uzticamības pārbaudes tiek veidotas analītiķu darbībā Zeppelin bloknotos. No turienes tās tiek nosūtītas tieši uz konfigurācijas tabulām DQ moduļa ražošanas vidē.
Tiešo skriptu nosūtīšanas risks ražošanā būtībā neeksistē. Pat ja ir sintaktiska kļūda, maksimāli, ar ko mēs varam saskarties, ir viena pārbaude, kas neizdodas, jo datu aprēķina plūsma un kvalitātes pārbaudes plūsma ir atdalītas.
Patiesībā DQ pakalpojums pastāvīgi darbojas ražošanas vidē un ir gatavs uzsākt darbu, kad parādās nākamā datu partija.
Noslēgumā
Zema koda izmantošanas priekšrocība ir acīmredzama. Izstrādātājiem nav nepieciešams izstrādāt lietotni "no nulles". Turklāt brīvie programmētāji sniedz rezultātus ātrāk. Ātrums savukārt atbrīvo papildu laika resursus optimizācijas jautājumu risināšanai. Tādējādi šajā gadījumā varam cerēt uz kvalitatīvāku un ātrāku risinājumu.
Protams, zema koda risinājumi nav panaceja, un burvība pati par sevi nenotiks:
- Zema koda industrija iet cauri "stiprināšanās" posmam, un pagaidām tajā nav vienveidīgu nozares standartu;
- Daudzi zema koda risinājumi nav bezmaksas, un to iegāde ir apzināts solis, kuru jāveic pārliecinoties par finansiālo labumu no to lietošanas;
- Daudzi zema koda risinājumi ne vienmēr labi sadarbojas ar GIT / SVN. Vai arī nav ērti lietojami, ja slēpj ģenerēto kodu;
- Paplašinot arhitektūru, var būt nepieciešama zema koda risinājuma uzlabošana – kas, savukārt, izraisa efektu "piesaistes un atkarības" no zema koda risinājuma piegādātāja.
- Pienācīgs drošības līmenis ir iespējams, bet tas ir diezgan darbu ietilpīgs un sarežģīts, lai to īstenotu zema koda sistēmu dzinējos. Zema koda platformas jāizvēlas ne tikai, balstoties uz to izmantošanas ieguvumu meklējumiem. Izvēloties, jājautā par piekļuves pārvaldības funkcionalitāti un identifikācijas datu deleģēšanu / eskalāciju visā organizācijas IT ainavā.
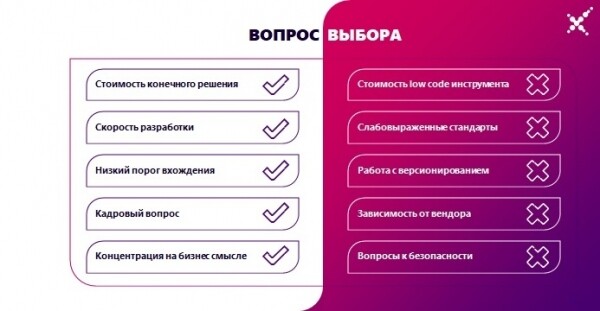
Tomēr, ja visi izvēlētās sistēmas trūkumi jums ir zināmi, un tomēr tās izmantošanas priekšrocības ir dominējošā skaitā, tad pārejiet uz zema koda risinājumu bez bailēm. Jo īpaši tāpēc, ka pāreja uz to ir neizbēgama – tāpat kā jebkura evolūcija.
Ja gad ir viens izstrādātājs ar low-code platformu, kurš savu darbu paveiks ātrāk nekā divi izstrādātāji bez low-code, tas dod uzņēmumam priekšrocību visās jomās. Ienākšanas slieksnis low-code risinājumos ir zemāks nekā "tradicionālajās" tehnoloģijās, un tas pozitīvi ietekmē darbinieku trūkuma jautājumu. Lietojot mazāk kodējamus rīkus, iespējams paātrināt sadarbību starp funkciju komandām un ātrāk pieņemt lēmumus par izvēlētās datu zinātnes izpētes pareizību. Zema līmeņa platformas var kļūt par digitālās transformācijas iemeslu organizācijā, jo iegūtie risinājumi var būt saprotami nestandarta speciālistiem (īpaši biznesa lietotājiem).
Ja jums ir saspringti termiņi, liela biznesa loģika, tehnoloģiju ekspertīzes trūkums un jums ir vajadzīgs paātrināt time to market, tad low-code ir viens no veidiem, kā apmierināt jūsu vajadzības.
Nav jēgas noliegt tradicionālo izstrādes rīku nozīmīgumu, tomēr daudzas reizes mazāk kodējamās risinājumu izmantošana ir labākais veids, kā paaugstināt risināmo uzdevumu efektivitāti.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish