

Piem. tulk.: Šis pārtulkojums ir no publiskā postmortema, kas publicēts uzņēmuma inženiertehniskajā emuārā . Tajā aprakstīta problēma ar conntrack Kubernetes klasterī, kas izraisīja daļēju dažādu ražošanas pakalpojumu dīkstāvi.
Šis raksts var būt noderīgs tiem, kuri vēlas uzzināt nedaudz vairāk par postmortemiem vai novērst dažas potenciālas problēmas ar DNS nākotnē.
Tas nav DNS
Neticami, ka tas varētu būt DNS
Tas bija DNS
Nedaudz par postmortemiem un procesiem Preply
Postmortemā tiek aprakstīta kļūme darbībā vai notikums ražošanā. Postmortems ietver notikumu hronoloģiju, ietekmes aprakstu uz lietotājiem, pamatcēloņus, rīcību un gūtās mācības.
Nedēļas sanāksmēs ar picu, tehniskās komandas lokā, mēs dalāmies ar dažādu informāciju. Viens no šādu sanāksmju svarīgākajiem aspektiem ir postmortemi, kas visbiežāk tiek pavadīti ar prezentācijām un padziļinātu notikušā incidenta analīzi. Neskatoties uz to, ka mēs pēc postmortemiem ne 'aplaujam' rokas, mēs cenšamies attīstīt 'bez vainošanas' kultūru (). Mēs ticam, ka postmortemu rakstīšana un prezentēšana ir svarīga, lai novērstu līdzīgus incidentus nākotnē, tāpēc mēs ar tiem dalāmies.
Personām, kas iesaistītas incidentā, ir jājūtas drošām, lai varētu sīki aprakstīt to, nebaidoties no soda vai atriebības. Nekāda nosodīšana! Postmortema rakstīšana nav sods, bet mācīšanās iespēja visai kompānijai.
DNS problēmas Kubernetes. Postmortem
Datums: 28.02.2020
Autori: Amet U., Andrey S., Igo K., Aleksey P.
Statuss: Pabeigts
Īsi: Daļēja DNS nepieejamība (26 min) daži pakalpojumi Kubernetes klasterī
Ietekme: 15000 notikumu zaudēti pakalpojumiem A, B un C
Pamatcēlonis: Kube-proxy neizdevās pareizi izdzēst veco ierakstu no conntrack tabulas, tāpēc daži pakalpojumi joprojām mēģināja savienoties ar neeksistējošiem podiem.
E0228 20:13:53.795782 1 proxier.go:610] Neizdevās izdzēst kube-system/kube-dns:dns galapunktu savienojumus, kļūda: kļūda dzēšot conntrack ierakstus UDP partnerim {100.64.0.10, 100.110.33.231}, kļūda: conntrack komanda atgriezusi: ...Trigeris: Zema slodze Kubernetes klasterī, CoreDNS-autoscaler samazināja podu skaitu izvietošanā no trīs līdz diviem.
Risinājums: Vēl viena lietojumprogrammas izvietošana izsauca jaunu mezglu izveidi, CoreDNS-autoscaler pievienoja vairāk podu, lai apkalpotu klasteri, kas izraisīja conntrack tabulas pārrakstīšanu
Atklāšana: Prometheus uzraudzība atklāja lielu skaitu 5xx kļūdu servisos A, B un C un izsauca dežūrējošo inženieru zvanu
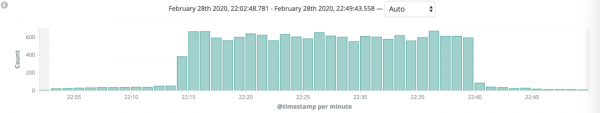
5xx kļūdas Kibana
Darbības
Darbība
Tips
Atbildīgais
Uzdevums
Atspējot CoreDNS automātiskā mērogošana
novērst
Amet U.
DEVOPS-695
Uzstādīt kešēšanas DNS serveri
samazināt
Maks V.
DEVOPS-665
Konfigurēt conntrack uzraudzību
novērst
Amet U.
DEVOPS-674
Gūtās mācības
Kas gāja labi:
- Uzraudzība darbojās precīzi. Reakcija bija ātra un organizēta
- Mēs nesaskārāmies ne ar kādiem ierobežojumiem mezglos
Kas nebija kārtībā:
- Joprojām nezināmā reālā cēloņsakarība, izskatās pēc conntrack
- Visas darbības novērš tikai sekas, nevis cēloni (kļūdu)
- Mēs zinājām, ka agri vai vēlu varētu būt problēmas ar DNS, bet neprioritizējām uzdevumus
Kur mums paveicās:
- Vēl viena izvietošana izraisīja CoreDNS-autoscaler, kas pārrakstīja conntrack tabulu
- Šī kļūda skāra tikai daļu no servisēm
Hronoloģija (EET)
Laiks
Darbība
22:13
CoreDNS-autoscaler samazināja podu skaitu no trīs līdz diviem
22:18
Dežūrējošie inženieri sākumā saņēma zvanus no uzraudzības sistēmas
22:21
Dežūrējošie inženieri sāka noskaidrot kļūdu cēloni
22:39
Dežūrējošie inženieri sāka atgriezt vienu no pēdējiem servisiem uz iepriekšējo versiju
22:40
5xx kļūdas pārstāja parādīties, situācija stabilizējās
- Laiks līdz atklāšanai: 4 min
- Laiks līdz darbību izpildei: 21 min
- Laiks līdz labojumam: 1 min
Papildu informācija
- [INFO] 10.1.28.1:52495 - 2606 "A IN mrkaran.hello.svc.cluster.local. udp 49 false 512" NXDOMAIN qr,aa,rd 142 0.000524939s [INFO] 10.1.28.1:59287 - 57522 "A IN mrkaran.svc.cluster.local. udp 43 false 512" NXDOMAIN qr,aa,rd 136 0.000368277s [INFO] 10.1.28.1:53086 - 4863 "A IN mrkaran.cluster.local. udp 39 false 512" NXDOMAIN qr,aa,rd 132 0.000355344s [INFO] 10.1.28.1:56863 - 41678 "A IN mrkaran. udp 25 false 512" NXDOMAIN qr,rd,ra 100 0.034629206s
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Samazināta replika set coredns-6cbb6646c9 līdz 2 - Saite uz Kibana (izgriezta), Grafana (izgriezta)
Lai samazinātu procesora izmantošanu, Linux kodols izmanto tādu lietu kā conntrack. Ja īsi sakot, tā ir utilīta, kas satur NAT ierakstu sarakstu, kas tiek glabāts īpašā tabulā. Kad nākamais pakete nāk no tā paša poda tajā pašā podā kā agrāk, galīgais IP adrese netiks aprēķināta no jauna, bet tiek ņemta no conntrack tabulas.
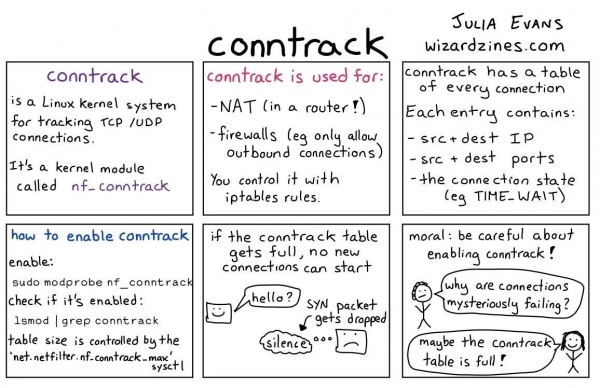
Kā darbojas conntrack
Secinājumi
Šis bija piemērs no mūsu postmortem sastāvdaļām ar dažām noderīgām saitēm. Konkrēti šajā rakstā mēs dalāmies ar informāciju, kas varētu būt noderīga citām kompānijām. Tieši tāpēc mēs nebaidāmies kļūdīties un tieši tāpēc esam publiskojuši vienu no mūsu postmortem.
- GitLab:
- Dropbox:
- Spotify:
- Vairāki citi no un repozitorija
- Tāpat publiskais postmortems ar SRE grāmatu
Avots: habr.com
