

Mums bija 2 maisi zāles, 75 meskalīna tabletes, Unix vide, docker repozitorijs un uzdevums īstenot komandas docker pull un docker push bez docker klienta.
UPD:
Jautājums: Kāpēc tas viss?
Atbilde: Produkta slodzes testēšana (NE izmantojot bash, skripti sniegti izglītojošiem mērķiem). Tika nolemts neizmantot docker klientu, lai samazinātu papildu slāņus (saprātīgās robežās) un līdz ar to emulētu augstāku slodzi. Rezultātā tika novērstas visas sistēmas kavēšanās no docker klienta. Iguļās salīdzinoši tīra slodze tieši uz produktu.
Rakstā tika izmantoti GNU rīki.
Sāksim ar to, ko dara šīs komandas.
Tātad, kāpēc tiek izmantots docker pull? Saskaņā ar :
"Pavelc attēlu vai repozitoriju no reģistra".
Turpat atrodam saiti uz .
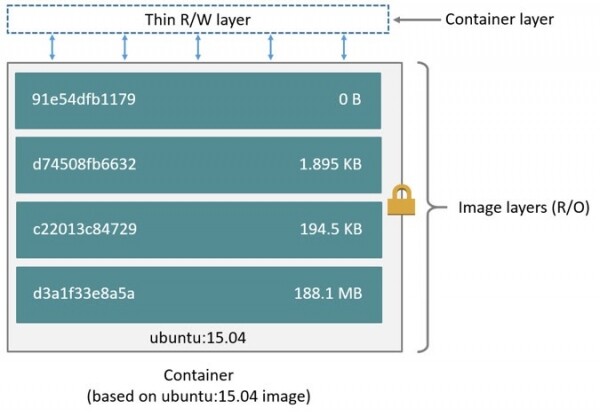
No tā mēs varam saprast, ka docker attēls ir slāņu kopums, kas satur informāciju par pēdējām izmaiņām attēlā, kas acīmredzami mums ir vajadzīga. Tālāk skatāmies uz .
Šeit teikts sekojošais:
"Attēls" ir JSON manifestācijas un individuālo slāņu failu kombinācija. Attēla pavelkšanas process centrējas ap šo divu komponentu iegūšanu."
Tātad, pirmais solis saskaņā ar dokumentāciju ir “Pavelkot attēla manifestu”.
Mēs to, protams, nepavelkam, bet dati no tā mums ir nepieciešami. Tālāk ir sniegts pieprasījuma piemērs: GET /v2/{name}/manifests/{reference}
"Nosaukuma un atsauces parametrs identificē attēlu un ir nepieciešams. Atsauce var iekļaut tagu vai digest."
Mūsu docker repozitorijs ir izvietots lokāli, mēģināsim veikt pieprasījumu:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
Atbildē saņemam JSON, no kura mums interesē tikai slāņi, precīzāk, to hash. Iegūstot tos, varam pa katram iziet un veikt nākamo pieprasījumu: "GET /v2/{name}/blobs/{digest}"
“Piekļuve slānim tiks ierobežota ar repozitorija nosaukumu, bet reģistrā tiek identificēta unikāli pēc digest.”
digest šajā gadījumā ir hash, ko mēs saņēmām.
Mēģinām
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
Apskatīsim, kas par failu mēs beigu beigās saņēmām kā pirmo slāni.
file firstLayer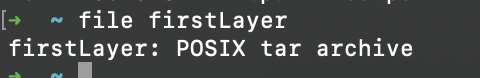
t.i., slāņi ir tar arhīvi, kurus, izpakojot atbilstošā secībā, mēs iegūsim attēla saturu.
Uzrakstīsim nelielu bash skriptu, lai visu to varētu automatizēt.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Tagad mēs varam to palaist ar vēlamajiem parametriem un iegūt nepieciešamā attēla saturu
.\/script.sh dirName "http:\/\/localhost:8081\/link\/to\/docker\/registry" myAwesomeImage 1.02. daļa — docker push
Šeit būs nedaudz sarežģītāk.
Sāksim atkal ar . Tātad mums jāielādē katrs slānis, jāsavāc attiecīgais manifests un jāielādē tas arī. Izskatās vienkārši.
Izpētot dokumentāciju, mēs varam sadalīt ielādes procesu vairākos soļos:
- Procesa inicializācija — "POST \/v2\/{repoName}\/blobs\/uploads\/
- Slāņa ielāde (mēs izmantosim monolītu ielādi, t.i., katru slāni sūtām pilnībā) — "PUT \/v2\/{repoName}\/blobs\/uploads\/{uuid}?digest={digest}"
Content-Length: {slāņa lielums}
Content-Type: application\/octet-stream
Slāņa binārie dati". - Manifesta ielāde — "PUT \/v2\/{repoName}\/manifests\/{reference}".
Bet dokumentācijā ir izlaists viens solis, bez kura nekas neizdosies. Monolītai ielādei, tāpat kā daļējai (chunked), pirms slāņa ielādes ir jāveic PATCH pieprasījums:
"PATCH \/v2\/{repoName}\/blobs\/uploads\/{uuid}
Content-Length: {chunk lielums}
Content-Type: application\/octet-stream
{Slāņa fragmenta binārie dati}".
Pretējā gadījumā jūs nevarēsiet virzīties tālāk par pirmo punktu, jo tā vietā, lai saņemtu sagaidīto atbildes kodu 202, jūs saņemsiet 4xx.
Tagad algoritms izskatās šādi:
- Inicializācija
- Slāņa patch
- Slāņa ielāde
- Manifesta ielāde
Punkti 2 un 3 attiecīgi tiks atkārtoti tik reižu, cik slāņu jāielādē.
Vispirms mums būs nepieciešams jebkurš attēls. Es izmantošu archlinux:latest
docker pull archlinux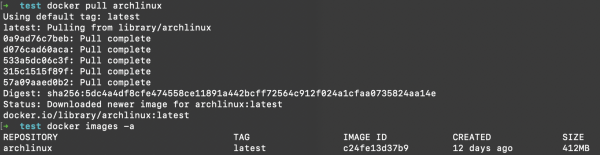
Tagad saglabāsim to lokāli turpmākai izpētei
docker save c24fe13d37b9 -o savedArch
Izsaiņosim saņemto arhīvu pašreizējā direktorijā
tar xvf savedArch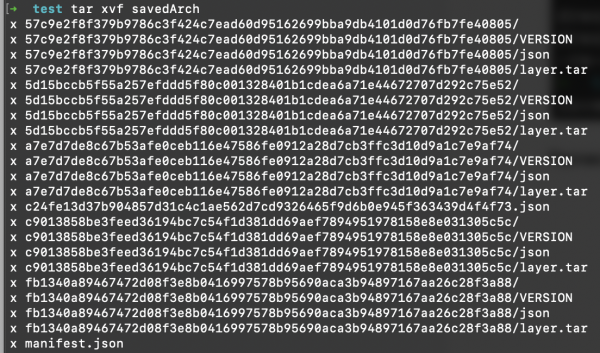
Kā redzam, katrs slānis atrodas atsevišķā mapē. Tagad aplūkosim manifesta struktūru, kuru mēs saņēmām
cat manifest.json | json_pp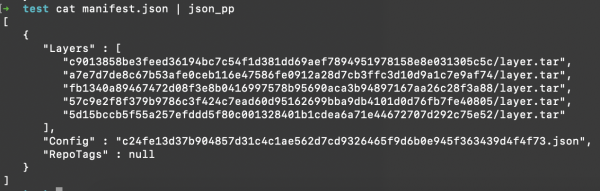
Nav daudz. Apskatīsim, kāds manifests ir nepieciešams ielādei, saskaņā ar .
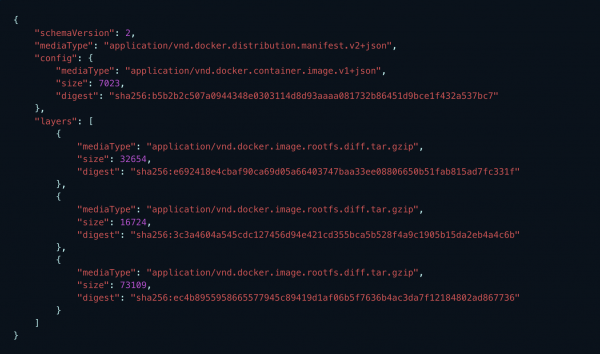
Acīmredzot esošais manifests mums neder, tāpēc izveidosim savu ar melnām kārtīm un kurtizānām slāņiem un konfigurācijām.
Mums vienmēr būs vismaz viens config fails un slāņu masīvs. Shēmas versija 2 (aktuāla raksta rakstīšanas brīdī), mediaType atstāsim nemainīgu:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Pēc pamata manifesta izveides, tam jāpievieno derīgi dati. Šim nolūkam izmantosim slāņa JSON objekta veidni:
{
         "mediaType": "application\/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      },
to mēs pievienosim manifestam katram slānim.
Tālāk mums jānosaka konfigurācijas faila lielums un jāaizstāj vietturis manifestā ar reālām datām
sed -i "s/config_size/[0m$configSize/g; s/config_hash/[0m$configName/g" $manifestFileTagad varam uzsākt ielādes procesu un saglabāt sev uuid, kas jāseko visiem turpmākajiem pieprasījumiem.
Pilns skripts izskatās apmēram tā:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
varam izmantot gatavu skriptu:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
Ko mēs ieguvām rezultātā?
Pirmkārt, reālus datus analīzei, jo testi tiek veikti blazemeter, un datus par pieprasījumiem docker klienta sniedz ļoti maz informācijas atšķirībā no tīriem HTTP pieprasījumiem.
Otrkārt, pāreja ļāva mums palielināt virtuālo lietotāju skaitu docker augšupielādē aptuveni par 150%, un vidējais atbildes laiks bija par 20-25% ātrāks. Docker lejupielādē izdevās palielināt lietotāju skaitu par 500%, vidējais atbildes laiks samazinājās par aptuveni 60%.
Paldies par uzmanību.
Avots: habr.com
