

Mani sauc Sergejs, esmu no ITSumma, un es vēlos jums pastāstīt, kā mēs pieejam rezerves kopēšanai Kubernetes. Pēdējā laikā es daudz strādāju konsultāciju jomā, ieviešot dažādus devops risinājumus dažādām komandām, un, jo īpaši, strādāju pie projektiem, kuros tiek izmantots K8s. Uptime day 4 konferencē, kas bija veltīta rezerves kopēšanai sarežģītās arhitektūrās, es sniedzu prezentāciju par „kubika” rezervēšanu, un šeit ir tās brīva interpretācija. Tūlīt gribu brīdināt, ka tas nav tiešs rīkojuma ceļvedis, bet drīzāk kopums pārdomu par norādīto tēmu.
Principā monitorings un rezerves kopēšana ir divi galvenie rīki, lai palielinātu jebkura projekta noturību. Bet, jūs teiksiet, ka Kubernetes viss tiek automatizēts, viss tiek pielāgots, un, ja kaut kas notiks — tas pats uzkāps... Tātad, veicot virspusēju izpēti par šo tēmu, uz jautājumu, kā ikviens pieiet K8s rezerves kopēšanai, internets man atbildēja „kāpēc?” Daudzi domā, ka Kubernetes ir kaut kas maģisks, kas atbrīvo no visām infrastruktūras problēmām un nodrošina, ka projekts nekad nenokritīs. Bet… pasaule nav tāda, kā šķiet.
Kā mēs pieejām rezerves kopēšanas procesam iepriekš? Mums bija identiskas vietas izvietošanai — vai nu virtuālas mašīnas, vai arī fiziskas. serverus, kur mēs izmantojām trīs pamata prakses:
- koda un statiskās informācijas sinhronizācija
- konfigurāciju sinhronizācija
- datubāzes replikācija
Un voila: jebkurā brīdī mēs pārslēdzamies uz rezerves izvietojumu, visi ir apmierināti, mēs pieceļamies un izklīstam.
Ko mums piedāvā, lai palielinātu mūsu Kubernetes lietojuma pieejamību? Pirmais, par ko runā neoficiālā dokumentācija, ir daudz mašīnu izvietošana un daudz meistaru izveide — to skaitam jābūt atbilstošam kvoruma sasniegšanai iekšējiem klasterī, un katram meistaram jābūt uzstādītam etcd, API, MC, scheduler… Un šķiet, ka viss ir fantastiski: ja daudzas darba mezgls vai meistari iziet no ierindas, mūsu klasteris pārbalancejas, un lietojums turpinās darboties. Atkal izskatās pēc burvības! Taču bieži mūsu klasteris atrodas vienā datu centrā, un tas var radīt noteiktus jautājumus. Ko darīt, ja ierodas ekskavators un izrok kabeli, ja zibens trāpa, ja notiek vispārējs plūds? Viss ir sabojāts, mūsu klastera vairs nav. Kā pievērsties rezervēm, ņemot vērā šo problēmas aspektu?
Pirmkārt, jums jābūt vēl vienam klasterim karstajā rezerves stāvoklī, tātad klasterim, uz kuru varat pārslēgties jebkurā brīdī. Turklāt no Kuberna viedokļa infrastruktūrai jābūt pilnīgi identiskai. Tas nozīmē, ka, ja ir kādi nestandarta spraudņi failu sistēmas darbībai vai pielāgotas iekļaušanas risinājumi, tie jābūt pilnīgi identiskiem jūsu divos (vai trijos, vai desmit, cik nu pietiek naudas un administratoru spēka) klasteros. Ir nepieciešams skaidri noteikt divus lietojumu komplektus (deployment, statefulset, daemonset, cronjob u.tml.): kuri no tiem var darboties rezerves režīmā pastāvīgi un kuri ir labāk nesākt līdz tiešai pārslēgšanai.
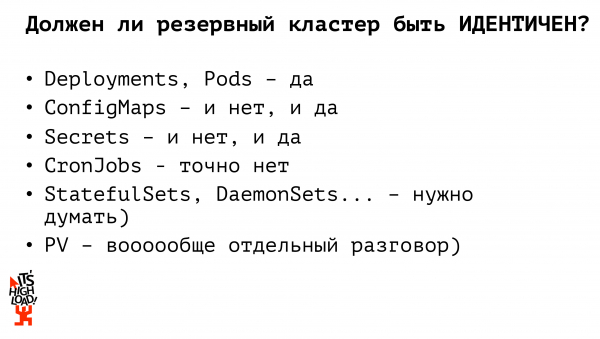
Vai mūsu rezerves klasterim jābūt pilnīgi identiskam mūsu ražošanas klasterim? Nē. Ja agrāk, strādājot ar monolīta projektiem un aparatūras infrastruktūru, mēs uzturējām praktiski pilnīgi identisku vidi, tad, strādājot ar Kubernetiem, es uzskatu, ka tam tā nedrīkst būt. Apskatīsim, kāpēc.
Piemēram, sāksim ar pamata Kubernetes entītijām — deployments — tām jābūt identiskām. Jābūt palaistām lietotnēm, kas jebkurā brīdī var pārņemt trafika apstrādi un ļaut mūsu projektam turpināt dzīvot. Ja runājam par konfigurācijas failiem, tad šeit jāpievērš uzmanība tam, vai tiem jābūt identiskiem vai nē. Tas nozīmē, ja mēs, gudrie cilvēki, neizmantojam nekādus aizliegtus līdzekļus un neglabājam datu bāzi K8s, tad mūsu configmaps jābūt piekļuves iestatījumiem uz ražošanas datu bāzi (rezervēšanas process, kas celts atsevišķi). Attiecīgi, lai nodrošinātu piekļuvi rezervētajai datu bāzes instancei, mums jābūt atsevišķam konfigurācijas failam (configmap). Tieši tāpat mēs strādājam arī ar secretiem: parolēm, lai piekļūtu datu bāzei, api atslēgām; jebkurā laikā var darboties vai nu ražošanas secrets, vai rezervētais. Tātad, mums jau ir divas Kubernetes entītijas, kuru rezervētajām versijām nevajadzētu būt identiskām ražošanas versijām. Nākamā entītija, uz kuru ir vērts apstāties, ir cronjob. Cronjob'i rezervē nedrīkst būt identiski ražošanas klastera cronjob'iem! Ja mēs uzsākam rezervētu klasteri un izveidojam to pilnībā ar visiem ieslēgtajiem cronjob'iem — tad, piemēram, cilvēki saņems divus e-pastus vienlaikus vietā, lai saņemtu vienu. Vai arī kāda datu sinhronizācija ar ārējiem avotiem notiks divas reizes, attiecīgi mēs sākam ciest, raudāt, kliegt un lamāties.
Un kā mums piedāvā organizēt rezervējošo klasteri cilvēki no interneta? Otra populārākā atbilde pēc "kāpēc?" — Kubernetes Federation izmantošana.
Kas tas ir? Tas, teiksim tā, ir liels meta-kleris. Ja mēs iedomājamies kuberu arhitektūru — kur mums ir māsteris un vairāki mezgli — tad no federācijas viedokļa mums arī ir māsteris un vairāki mezgli, tikai katrs mezgls ir atsevišķs klasteris. Tātad, mēs strādājam ar tām pašām vienībām un tajām pašām primitivam, kā ar vienu kuberu, tikai mēs neizmantojam tagad mūsu fiziskās mašīnas, bet veselas klasterus. Federācijas ietvaros mums ir pilnīga federācijas resursu sinhronizācija no vecākiem uz pēcnācējiem. Piemēram, ja mēs izsāksim kādu izvietojumu caur federāciju — tas tiks izsviests uz katru mūsu bērnu klasteri. Ja mēs ņemam kādu configmap, noslēpumu, un izplatām to federācijā — tas izplatīsies visos mūsu bērnu klasteros; un, šajā laikā federācija ļauj pielāgot mūsu resursus bērniem. Tātad mēs paņēmām kādu configmap, izplatījām to caur federāciju un tad, ja mums kaut kas jālabo konkrētos klasteros, mēs dodamies labot uz atsevišķu klasteri, un šis labojums vairs nekādā veidā nesinhronizēsies.
Kubernetes Federation — nesen pat K8s nākamais rīks, un tas neatbalsta visu resursu kopumu, ko piedāvā pats K8s: dokumentācijas pirmajās versijās bija minēta tikai config maps, deployment zem replica set un ingress. Secrets netika atbalstīti, un arī darbs ar volume netika atbalstīts. Pārāk ierobežots klāsts. Īpaši, ja mums patīk eksperimentēt — piemēram, caur custom resource definition nodot savus resursus Kubernetes — federācijā tos mēs vairs nevaram iekļaut. Tātad, tā teikt… ļoti līdzīgs patiesībai risinājums, bet periodiski liek mums pašiem sevi ievainot. No otras puses, federācija ļauj elastīgi pārvaldīt mūsu replicaset. Piemēram, mēs vēlamies, lai tiktu palaistas 10 mūsu lietojuma replika, pēc noklusējuma federācija šo skaitu sadalīs proporcionāli starp klasteru skaitu. Un to visu var arī konfigurēt! Tātad var norādīt, ka ražošanas klasterī jāuztur 6 mūsu lietojuma replika, bet rezerves klasterī, lai ietaupītu resursus vai vienkārši mūsu pašu izklaidei — tikai 4 mūsu lietojuma replika. Kas arī ir diezgan ērti. Bet ar federāciju mums jāmācās izmantot dažādus jaunus risinājumus, dažreiz kaut ko instalēt ceļā, likt sev mazliet vairāk domāt…
Vai ir iespējams pieiet Kubernetes rezerves izveidošanas procesam krietni vienkāršāk? Kādi rīki mums vispār ir pieejami?
Pirmkārt, mums vienmēr ir kāda ci/cd sistēma, tātad mēs neejam uz serveriem un neizpildam create/apply manuāli. Sistēma ģenerē yaml failus mūsu konteineriem.
Otrkārt, ir vairāki klasteri, mums ir vai nu viens, vai vairāki (ja mēs esi gudri) registry, kas arī tiek rezervēti. Un ir brīnišķīga utilīta kubectl, kas var darboties ar vairākiem klasteriem vienlaikus.
Proti, mana skatījumā, visvienkāršākais un pareizākais risinājums rezerves klastera izveidei ir primitīvā paralēlā izvietošana. Ir kāds pipelines ci/cd sistēmā; vispirms būvējam savus konteinerus, testējam un izvietojam lietojumprogrammas caur kubectl uz vairākiem neatkarīgiem klasteriem. Mēs varam veidot vienlaicīgas izvietojumus uz vairākiem klasteriem. Attiecīgi, konfigurāciju piegādi mēs arī risinām šajā posmā. Varam iepriekš noteikt konfigurāciju komplektu mūsu ražošanas klasterim, komplektu konfigurāciju rezerves klasterim un ci/cd sistēmas līmenī izvietot ražošanas vidi ražošanas klasterī, bet rezerves vidi - rezerves klasterī. Salīdzinājumā ar federāciju, nav nepieciešams pēc federatīvā resursa definēšanas apmeklēt katru apakšklasteri un kaut ko pārrakstīt. Mēs to izdarījām iepriekš. Mēs esam tādi varoņi.
Bet... ir... kā jau es rakstīju, ir «visu ļaunumu sakne», bet patiesībā tās ir divas. Pirmkārt, failu sistēma. Ir kāds PV vai mēs izmantojam ārējo krātuvi. Ja mēs uzglabājam failus iekšā klasterī, tad šeit jādarbojas pēc vecajām praksēm, kas palikušas no dzelžu infrastruktūrām: piemēram, sinhronizēt ar lsync. Vai jebkuru citu personīgi jums iecienītu risinājumu. Izvietojam visu citās ierīcēs un dzīvojam.
Otrkārt, un, patiesībā, pat svarīgākais šķērslis — datubāze. Ja mēs esam inteliģenti cilvēki un neuzglabājam datubāzi kuberā, tad datu rezerves saglabāšanas process notiek pēc tās pašas vecās shēmas — master-slave replikācija, pēc tam pārslēgšana, replikāciju panāksim un dzīvosim labi. Bet, ja mēs turēsim mūsu DB iekšā klasterī, tad principā ir daudz gatavu risinājumu šādas master-slave replikācijas organizēšanai, daudz risinājumu datubāzes uzstādīšanai iekšā kuberā.
Par datubāzu rezerves saglabāšanu jau ir izlasīti miljons ziņojumu, uzrakstīti miljons rakstu, šeit patiesībā nekas jauns nav nepieciešams. Kopumā, sekojiet savai sapņiem, dzīvojiet kā vēlaties, izdomājiet arī savus sarežģītus risinājumus, bet noteikti apsveriet, kā jūs visu to rezervēsiet.
Tagad runāsim par to, kā mūsu gadījumā notiks pārejas process uz rezerves vietni ugunsgrēka gadījumā. Pirmkārt, mēs paralēli izvietojam stateless lietojumprogrammas. Tās neietekmē mūsu lietojumprogrammu biznesa loģiku, mūsu projektu, mēs varam pastāvīgi turēt divus palaišanas lietojumprogrammu komplektus, un tie var sākt saņemt trafiku. Ļoti svarīgi pārejas procesā uz rezerves vietni ir obligāti pārbaudīt — vai ir nepieciešams pārrakstīt konfigurācijas? Piemēram, mums ir ražošanas Kubernetes klasters, ir rezerves Kubernetes klasters, ir ārējā datu bāze master, ir rezerves datu bāze master. Mums ir četri varianti, kā šie lietojumi ražošanā var sākt savstarpēji sadarboties. Mums var pāriet datu bāze, un izrādīsies, ka ražošanas klasterī ir jāpārslēdz trafiks uz jauno datu bāzi, vai nu mūsu klasteris var sabrukt — un mēs pārgājām uz rezerves ilgi, bet turpinām strādāt ar ražošanas datu bāzi, un trešais variants, kad mums ir sabrukušas šīs, sabrukušas tās, un mēs pārslēdzam abus lietojumus, pārrakstām mūsu konfigurāciju, lai jauni lietojumi jau strādātu ar jauno datu bāzi.
Nu, kas attiecīgi varētu būt secinājumi no visa tā?
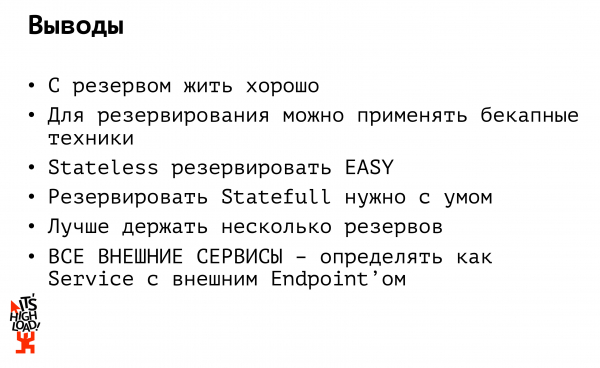
Pirmais secinājums: ar rezervi dzīvot ir labi. Bet dārgi. Ideālā gadījumā nedzīvot tikai ar vienu rezerves kopiju. Ideālā gadījumā vajadzētu dzīvot ar vairākiem rezervēm. Pirmkārt, rezerves jābūt vismaz, ne vienā datu centrā, un, otrkārt, vismaz pie cita hostinga nodrošinātāja. Bija daudz gadījumu — un manā praksē tas ir bijis. Es diemžēl nevaru nosaukt projektus, kad tieši notika ugunsgrēks datu centrā… Es saku: pārejam uz rezerves! Bet rezerves serveri bija tajā pašā stendā...
Vai iedomājieties, ka Amazon ir aizliegts Krievijā (un tas ir noticis). Un viss: kas no tā, ka citā Amazon atrodas mūsu rezerve? Tas arī nav pieejams. Tādēļ atkārtoju: turam rezervi vismaz citā datu centrā, bet vēlams — pie cita hostinga nodrošinātāja.
Otrā piezīme: ja jums ir Kubernetes lietotne, kas sazinās ar kādiem ārējiem avotiem (tas var būt gan datubāze, gan kāds ārējs API), noteikti definējiet to kā pakalpojumu ar ārēju endpoint, lai pārslēgšanas brīdī jums nebūtu jāpārsūta 15 jūsu lietotnes, kas izsauc to pašu datubāzi. Definējiet datubāzi kā atsevišķu pakalpojumu, piekļūstiet tai, it kā tā būtu jūsu klasterī: ja jums kaut kas notiks ar datubāzi, jūs vienā vietā maināt IP adresi un turpināt dzīvot laimīgi.
Un visbeidzot: es mīlu 'kubiku', tāpat kā eksperimentus ar to. Un vēl mīlu dalīties ar šo eksperimentu rezultātiem un vispār ar savu personīgo pieredzi. Tāpēc es esmu ierakstījis vebināru sēriju par K8s, laipni lūdzam pie šķiet, detalizētai informācijai.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish